120 бесплатных минут, в которые не помещается одно интервью: что на самом деле даёт бесплатная ИИ-транскрипция на индонезийском
Сравните бесплатные варианты ИИ-транскрибации на индонезийском: ограничение длительности записи в Notta, дневное число файлов в TurboScribe, вариант с API Google и обновление пакетной модели Deepgram. Практическое руководство поможет выбрать подходящий процесс расшифровки интервью.
У вас в телефоне лежит интервью на 47 минут. Источник в Сурабае, запись сделана сегодня утром, почти всё на индонезийском с обычной россыпью английского — deadline, stakeholder, follow up. Расшифровка нужна сегодня, и платить за неё вам крайне не хочется.
Вы ищете, попадаете на сервис, который рекламирует 120 бесплатных минут транскрипции в месяц, и регистрируетесь. Ваш файл на 47 минут спокойно укладывается в 120. Потом загрузка падает, а в таблице сравнения тарифов обнаруживается второе число, которое никто не выносит в заголовок: максимум транскрипции на одну запись — 3 минуты.
Так устроена вся эта категория. Бесплатные тарифы рекламируются по числу, которое звучит щедрее всего, и ограничиваются другим числом тремя строками ниже. Эта статья — то сравнение, которого нам не хватало: что каждый бесплатный тариф реально даёт интервью на индонезийском, в чём он молча отказывает и как проверить любой из них за пять минут, прежде чем на него подписываться.
Коротко
- У бесплатных тарифов три независимых потолка — минуты в месяц, минуты на файл и файлы в день — и интервью ломает почти всегда лимит на файл, а не месячная сумма.
- Распознавание индонезийской речи в этом месяце действительно стало лучше: 7 августа 2026 года Deepgram выпустила обновлённую индонезийскую модель Nova-3, но только на пакетном пути, не в потоковом. Загрузка записи от этого выигрывает, живые субтитры — нет.
- Публичный рейтинг не заменит проверку на реальном образце интервью. Возьмите пятиминутный фрагмент на индонезийском с теми акцентами, условиями записи и переключением языков, которые ожидаете услышать. Оценки на корпусах дают контекст, но не гарантируют результат для этих собеседников.
Бесплатные тарифы рядом друг с другом
Каждая цифра ниже взята из опубликованного самим поставщиком прайса или документации, по состоянию на 31 августа 2026 года. Эталонная задача — одно интервью на 47 минут с двумя участниками, потому что именно такой файл у людей и лежит.
| Сервис | Бесплатный тариф | Самый длинный одиночный файл, бесплатно | Индонезийский | Точка входа в платное |
|---|---|---|---|---|
| Notta | 120 мин/мес, 50 загрузок/мес, 10 ИИ-резюме/мес, 1 рабочее место | 3 минуты | Да (официальный список языков) | Pro 8,17 $/мес при годовой оплате — 1800 мин/мес, файлы до 5 часов |
| TurboScribe | 3 расшифровки в день, пониженный приоритет в очереди | 30 минут | Да | Unlimited 10 $/мес, 120 $ при годовой оплате — файлы до 10 часов |
| Transkriptor | Бесплатные месячные минуты не заявлены | — | Да | Lite 9,99 $/мес — 300 мин/мес |
| Maestra | Бесплатные месячные минуты не заявлены | — | Да | Оплата по факту 12 $ за 60 минут; Lite 23 $/мес — 180 мин/мес |
| Google Cloud Speech-to-Text | 60 мин/мес, далее 0,016 $/мин | Практического потолка нет | Да, id-ID | 0,016 $/мин с логированием данных, 0,024 $/мин без него |
| API транскрипции OpenAI | Нет | Практического потолка нет | Да | 0,006 $/мин (gpt-4o-transcribe), 0,003 $/мин (mini) |
| Whisper, self-hosted | Без ограничений, лицензия MIT | Ваше железо | Да | Бесплатное ПО, ваше собственное время GPU |
| Telli.sh | 60 мин/мес | В пределах доступного лимита | Да | Платные тарифы начинаются с 300 мин/мес |
Источники: страницы цен поставщиков по состоянию на 31 августа 2026 года; документация Google по поддерживаемым языкам для id-ID; опубликованные цены API OpenAI; а также список поддерживаемых языков Notta, в котором указан индонезийский для одноязычной транскрибации и перевода после расшифровки. Цены TurboScribe основаны на снимке страницы в Internet Archive; текущие тарифы могут отличаться.
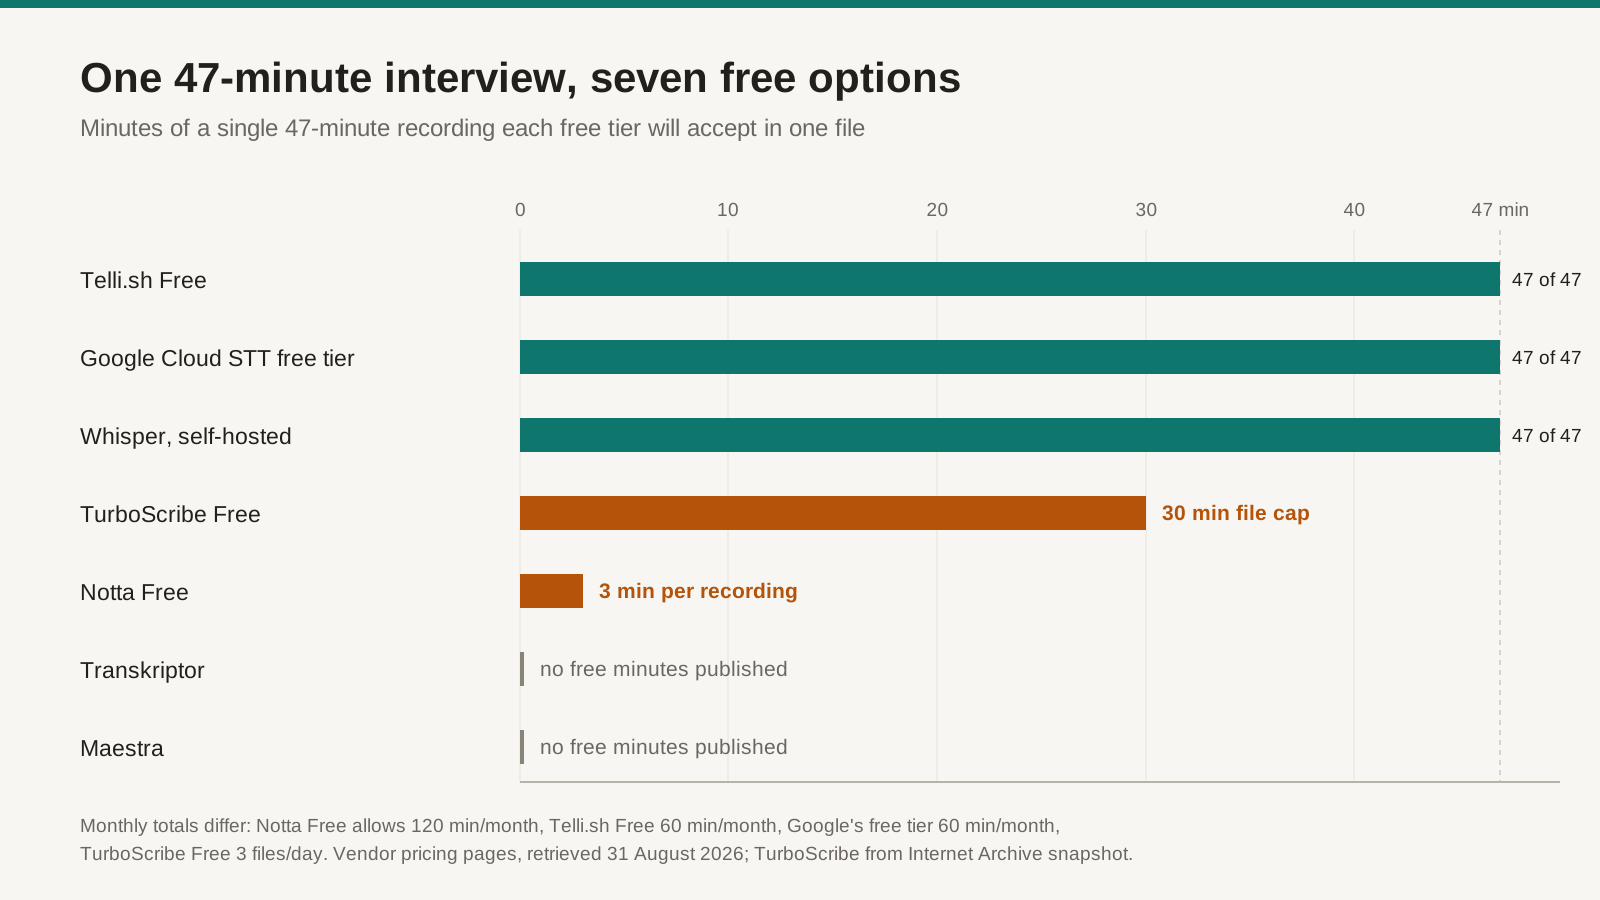
Одна единица на одной оси: минуты 47-минутного интервью, принимаемые одним файлом. Месячные лимиты различаются и указаны под графиком.
120 минут у Notta настоящие. Интервью ломает потолок в три минуты.
Прочитайте бесплатный тариф Notta внимательно — он вовсе не скупой: 120 минут транскрипции в месяц, 50 загрузок файлов, 10 ИИ-резюме, 1000 ИИ-кредитов, без карты. Для голосовых заметок и коротких звонков это действительно полезный объём, и месячных минут тут больше, чем раздаёт большинство конкурентов.
Теперь прочитайте строкой ниже в той же таблице сравнения: максимум транскрипции на одну запись — 3 минуты на Free против 5 часов на Pro. Ваши 120 минут — это 40 отдельных трёхминутных обрывков. Интервью на 47 минут вообще не может попасть в систему.
Суть вот в чём, и она выходит далеко за рамки одного поставщика: бесплатный тариф — это не одно число, а три потолка, и маркетинг называет самый высокий из них. Минуты в месяц — это заголовок. Минуты на файл — то, что решает, поддаётся ли ваше интервью расшифровке вообще. Файлы в день — то, что решает, сможете ли вы за одно воскресенье обработать неделю полевой работы.
TurboScribe переворачивает тот же размен. Его бесплатный тариф вообще не заявляет месячного запаса минут — три расшифровки в день, каждая до 30 минут, по одному файлу за раз, с пониженным приоритетом в очереди. Три файла по 30 минут в день — это 90 минут аудио, то есть за два дня вы обгоняете месячные 120 у Notta. Но интервью на 47 минут по-прежнему не влезает, потому что связывающее ограничение снова лимит на файл. Запись придётся резать, и каждый разрез стоит вам непрерывности говорящих через место склейки.
Transkriptor и Maestra снимают это напряжение иначе: бесплатного тарифа у них по большей части просто нет. Опубликованные планы Transkriptor начинаются с Lite — 9,99 $ в месяц за 300 минут транскрипции — и доходят до Pro за 19,99 $ за 2400 минут (8,33 $ в месяц, если заплатить 99,99 $ за год). Maestra продаёт кредиты по факту использования по 12 $ за 60 минут, а Lite стоит 23 $ в месяц за 180 минут. Оба перечисляют индонезийский; языковая таблица Maestra отмечает индонезийский как поддерживаемый одинаково для транскрипции, перевода, озвучки и режима реального времени. Ни один из двух не публикует регулярный бесплатный объём — и это своего рода честность.
Индонезийский измеримо улучшился 7 августа — ровно на одном пути
С распознаванием индонезийской речи в этом месяце произошло кое-что настоящее, и почти никто из пишущих про «ИИ-инструменты транскрипции» об этом не упомянул.
7 августа 2026 года Deepgram выпустила улучшенные одноязычные модели Nova-3 и добавила армянский. Список изменений конкретен так, как объявления вендоров бывают редко. В разделе Batch models: тамильский и индонезийский. В разделе Streaming models: тамильский и белорусский.
Индонезийский есть в одном списке и отсутствует в другом.
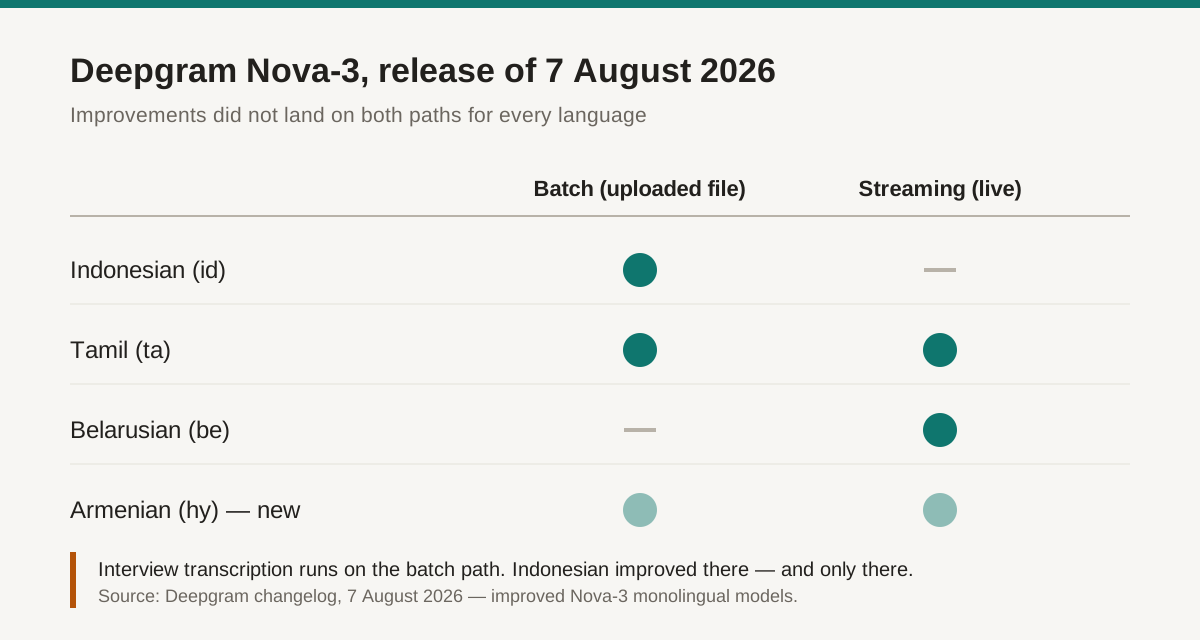
Один и тот же релиз улучшил индонезийский в пакетном режиме и белорусский в потоковом. «Улучшенная поддержка индонезийского» — это не один факт. Источник: список изменений Deepgram, 7 августа 2026 года.
Это различие ложится прямо на работу с интервью. Пакетный режим — путь загруженного файла: движок видит всю запись целиком, может использовать контекст в обе стороны и не гонится за живым аудиобуфером. Потоковый режим — путь живых субтитров. Если вы записали интервью и загрузили его потом, вы на пакетном пути — том самом, который в этом месяце стал лучше. Если же вы рассчитывали на точные живые индонезийские субтитры прямо во время интервью, эта конкретная модель 7 августа не менялась.
Развёрнутую версию этого рассуждения мы написали в материале что на самом деле скрывает слово «поддерживается» в языковом покрытии распознавания речи, потому что схема повторяется по всей отрасли: язык не «поддерживается» или «не поддерживается» — он поддерживается на определённом пути, в определённом режиме, на определённом уровне качества, на определённую дату. Конкретно для расшифровки интервью хорошая новость в том, что нужный вам путь и есть тот, который улучшился.
Бенчмарка точности для индонезийского никто не публикует — значит, бенчмарком придётся стать вам
Надёжный общедоступный бенчмарк WER для индонезийского найти трудно, поэтому опубликованные рейтинги не покажут, как инструмент справится именно с вашим аудио.
Open ASR Leaderboard — самое близкое к нейтральному табло, что есть в области, — держал многоязычную вкладку только с европейскими языками до 28 августа 2026 года, когда Hugging Face и Voice Arena добавили хинди как первый язык Глобального Юга. Индонезийского, с примерно 280 миллионами человек на домашнем рынке, там всё ещё нет. Вендоры публикуют заявления о точности для английского и молчат обо всём остальном.
Устройство самого Whisper намекает на ту же асимметрию. Токенизатор OpenAI объявляет 100 языковых токенов, и индонезийский стоит в этой таблице на 17-й позиции — достойно, заметно впереди большей части списка и нигде рядом с объёмом данных за английским, китайским или испанским. Объявленный токен не гарантия качества; это заявление, что модель попробует справиться с языком.
Поэтому честный операционный вывод таков: для индонезийского бенчмарк — это ваше собственное аудио. Не демо-файл вендора, не рейтинг, не звёздочки на сайте отзывов. Ваш диктофон, ваша комната, региональный акцент вашего собеседника, лексика вашей отрасли. Звучит как отговорка ровно до момента, когда вы замечаете, что сделать это как следует занимает минут двадцать.
Пятиминутный тест: проведите его, прежде чем кому-то платить
Возьмите пятиминутный отрезок настоящего интервью — лучше с двумя голосами, фоновым шумом и хотя бы тремя именами собственными. Прогоните его через всех кандидатов. Потом проверьте пять вещей, именно в таком порядке.
- Посчитайте ошибки в именах собственных. Имена людей, названия компаний, мест и продуктовых терминов. Именно здесь индонезийское ASR стабильно ошибается и именно здесь ошибка наносит наибольший ущерб дальше по цепочке, потому что неверное имя молча расходится в каждое резюме и каждую цитату, которые вы сгенерируете потом. Пять ошибок за пять минут — это примерно 47 в вашем интервью.
- Отдельно проверьте строки со смешением языков. Найдите фразу, где английское слово стоит внутри индонезийской конструкции, и прочитайте, что выдал сервис. Это самая предсказательная одиночная проверка для профессионального индонезийского аудио — и ровно та, которой не касается ни одна страница вендора.
- Проверяйте метки говорящих на пятой минуте, а не на первой. В первые секунды диаризация почти всегда выглядит безупречно. Важно другое: остался ли Говорящий A Говорящим A после первого перебивания, наложения реплик или долгой паузы.
- Ищите тайм-коды, с которыми можно работать. Если вам когда-нибудь понадобится сверить цитату с аудио, тайм-коды нужны построчно в экспорте, а не только в веб-плеере. Журналистам и качественным исследователям стоит считать это обязательным.
- Выгрузите файл и откройте его в другом месте. TXT, DOCX, SRT, VTT — что нужно вашему рабочему процессу. Именно здесь бесплатные тарифы чаще всего заканчиваются, а расшифровка, которую нельзя вынести из сервиса, — это демонстрация, а не документ.
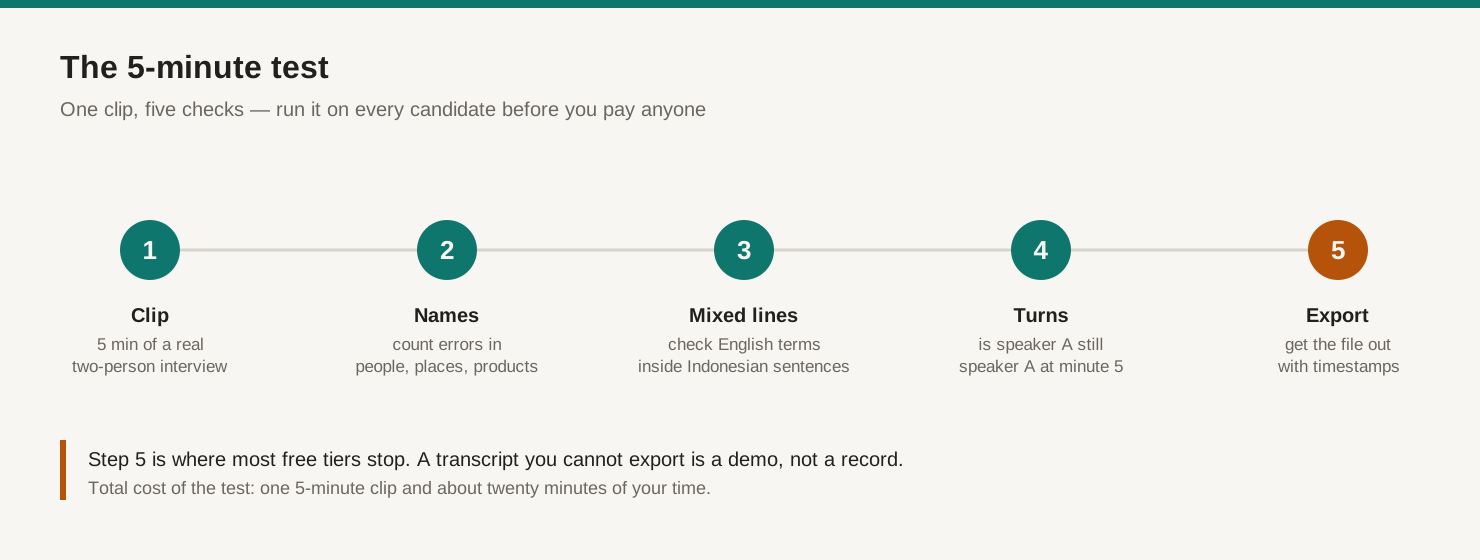
Пять проверок в том порядке, в каком с ними сталкивается реальная оценка.
Если вам нужен рабочий процесс, который начинается после выбора инструмента, — вычитать расшифровку до того, как довериться резюме, удерживать цитаты привязанными к исходному аудио, — мы разобрали это отдельно в материале как превратить аудио интервью в проверяемую расшифровку и резюме.
Где индонезийские интервью действительно ломаются: английское слово посреди фразы
Профессиональный индонезийский не одноязычен. «Nanti kita follow up setelah meeting dengan tim product» — это не ломаный индонезийский; так говорит продакт-менеджер в Джакарте, и примерно так же говорят рекрутер, консультант и основатель стартапа. Любая расшифровка, искажающая английские фрагменты, исказила ровно те термины, на которых держатся ваши заметки.
Это самое сложное в категории, и стоит понять почему. Большинство речевых движков запускает одну одноязычную модель на запрос. Вы ставите язык «индонезийский» — и модель сильнее всего в индонезийской фонетике и индонезийском словаре, а значит, английское слово, приходящее в середине фразы, либо транслитерируется во что-то индонезийское по форме, либо теряется. Переключение языка на английский просто разворачивает ущерб в другую сторону. Многоязычные режимы и режимы code-switching существуют, но они уже одноязычных списков: по состоянию на август 2026 года Nova-3 от Deepgram документирует 58 языков по одному за раз и code-switching ровно в 10.
Две практические меры, обе дешёвые. Первая: явно задайте исходный язык «индонезийский», а не оставляйте автоопределение — автоопределение вынуждено сделать ставку по наименее контекстным секундам всего файла, и неверная догадка одним махом ухудшает всё, что идёт дальше. Вторая: если сервис предлагает пользовательский словарь или список ключевых слов, внесите туда свои повторяющиеся английские термины и имена собственные до обработки, а не после.
Назовём это проблемой гадо-гадо — по индонезийскому блюду, где разные ингредиенты подаются перемешанными под одним соусом: аудио смешано по замыслу, а каждый движок хочет подать его как одно блюдо.
Если вы умеете писать код, расшифровка стоит дешевле чашки кофе
Сравнение бесплатных тарифов полностью меняет форму, если вы готовы прикоснуться к API, и эти цифры полезно знать, даже если вы решите так не делать.
OpenAI берёт 0,006 $ за минуту за gpt-4o-transcribe и 0,003 $ за минуту за вариант mini. Ваше 47-минутное интервью стоит 28 центов или 14 центов на mini. Google Cloud Speech-to-Text даёт первые 60 минут в месяц бесплатно, дальше 0,016 $ за минуту с включённым логированием данных и 0,024 $ без него, и указывает id-ID и для модели chirp, и для chirp_2 в регионе asia-southeast1. Whisper лицензирован под MIT и не стоит ничего, кроме вашего собственного железа.
При таких ценах само распознавание почти бесплатно. У любого потребительского продукта вы на самом деле покупаете всё, что вокруг него: интерфейс загрузки, метки говорящих, тайм-коды, редактор, поиск по старым интервью, резюме, экспорт и место, где эта запись будет жить и через полгода.
Это и есть честная формулировка выбора «сделать или купить». Если у вас три интервью в год и вы умеете запустить скрипт на Python — запускайте скрипт. Если у вас три интервью в неделю и вам нужно найти цитату из марта, вы покупаете не распознавание — вы покупаете картотеку, к которой прикручено распознавание.
Четыре проверки помимо бесплатного лимита минут
Минуты и ограничения на размер файла — лишь часть выбора рабочего процесса для интервью. Перед тем как полагаться на любой тариф, бесплатный или платный, проверьте четыре пункта.
Проверьте разделение говорящих на собственном примере с двумя участниками. Таблица выше не показывает, в какие тарифы входит эта функция и насколько надёжно она разделяет перекрывающиеся голоса. Уточните наличие функции и ограничения тарифа, затем проверьте метки говорящих: сама пометка «бесплатный тариф» на эти вопросы не отвечает.
Проверьте правила хранения и экспорта. Лимит на транскрибацию не говорит, как долго доступны аудио или текст, а правила могут меняться. Экспортируйте важные записи и расшифровки и храните собственную копию, не полагаясь на аккаунт в сервисе как на единственный архив.
Проверьте распознаватель и его качество на ваших собеседниках. На результат влияют региональные акценты, качество записи и переключение языков. Платный тариф может дать другую модель или дополнительную обработку, но более высокая цена не доказывает более высокую точность; повторите тест на том же фрагменте, если меняется модель или процесс.
И ни один сервис, бесплатный или платный, не отменяет проверку текста. ИИ-резюме, созданное по непроверенной расшифровке, унаследует все её ошибки.
Итог: сравнивать нужно не минуты, а интервью
Каждый бесплатный тариф в этой категории рекламирует количество времени. Для работы с интервью это неправильная единица, потому что время имеет значение, только если оно приходит одним непрерывным куском. Сто двадцать минут, нарезанные трёхминутными ломтями, стоят для журналиста меньше, чем тридцать непрерывных, а обе величины стоят меньше, чем шестьдесят минут, вмещающих целый разговор с сохранными метками говорящих.
Поэтому, сравнивая сервисы, переводите каждый бесплатный тариф в единственную валюту, которая для вас что-то значит: сколько моих настоящих интервью это расшифрует целиком, от начала до конца, без разрезания файла? Для нескольких хорошо известных бесплатных планов честный ответ — ноль, и на странице цен вам этого не скажут.
Слой распознавания превращается в массовый товар, идущий к трети цента за минуту. Для индонезийского дефицитной остаётся запись, которую можно просмотреть, исправить, процитировать и всё ещё найти в следующем квартале.
Где здесь Telli.sh: мы один из вариантов, перечисленных выше, и скажем об этом конкретно. Бесплатный план Telli.sh — это 60 минут в месяц: меньше «заголовочных» минут, чем 120 у Notta, и намеренно не нарезанных трёхминутным лимитом на запись, так что целое интервью заходит одним файлом. Вы получаете индонезийскую расшифровку, перевод на любой из 44 целевых языков, ИИ-резюме, сгенерированное на основе расшифровки, и интерфейс, доступный на 15 языках, включая индонезийский. Сверх 60 минут в месяц это платный продукт, и если объём у вас небольшой, а скрипт вы запустить умеете, путь через API действительно дешевле. Проведите пятиминутный тест на нас ровно так же, как провели бы его на ком угодно другом.
Источники
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", список изменений от 7 августа 2026 года — улучшенные пакетные модели для тамильского и индонезийского, улучшенные потоковые модели для тамильского и белорусского, армянский (
hy) добавлен в оба режима. - Hugging Face и Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 августа 2026 года — хинди как первый язык Глобального Юга в рейтинге.
- Цены Notta, просмотрено 31 августа 2026 года — план Free: 120 минут в месяц, максимум 3 минуты на запись, 50 загрузок файлов в месяц, 10 ИИ-резюме в месяц; Pro за 8,17 $/мес при годовой оплате с 1800 минутами в месяц.
- Цены Transkriptor, просмотрено 31 августа 2026 года — Lite 9,99 $/мес (300 минут), Pro 19,99 $/мес (2400 минут, 99,99 $ при годовой оплате), Team 30 $ за место в месяц (3000 минут на место).
- Цены Maestra и поддерживаемые языки Maestra, просмотрено 31 августа 2026 года — оплата по факту 12 $ за 60 кредитов, Lite 23 $/мес за 180 минут; индонезийский указан для транскрипции, перевода, озвучки и режима реального времени.
- Цены TurboScribe по снимку Internet Archive — бесплатный план на 3 расшифровки в день с потолком 30 минут на файл и загрузкой по одному файлу; Unlimited за 10 $/мес, 120 $ при годовой оплате, файлы до 10 часов. Живая страница отвечает HTTP 403 на автоматическое чтение; считайте эти цифры ориентировочными и подтвердите на сайте.
- Цены Google Cloud Speech-to-Text и поддерживаемые языки, просмотрено 31 августа 2026 года — первые 60 минут в месяц бесплатно, 0,016 $/мин с логированием данных и 0,024 $/мин без него;
id-IDнаchirpиchirp_2в регионеasia-southeast1. - Цены API OpenAI, просмотрено 31 августа 2026 года —
gpt-4o-transcribeза 0,006 $ в минуту,gpt-4o-mini-transcribeза 0,003 $ в минуту. - OpenAI Whisper, лицензия MIT; таблица
LANGUAGESтокенизатора объявляет 100 языков, индонезийский (id) на 17-й позиции, просмотрено 31 августа 2026 года.