Eleven Realtime leva a disputa da IA de voz para além da voz
A ElevenLabs apresentou os modelos em tempo real Mini e Max. A mudança interessante é uma estrutura de conversação mais simples — e uma distinção mais clara entre soar natural e concluir uma tarefa.
Prévia oficial do componente de conversa por voz do ElevenLabs UI para atendimento. Fonte: elevenlabs/ui; copyright 2025 Eleven Labs Inc., licença MIT. Ilustra uma interface de voz, não um teste do modelo Realtime.

O momento constrangedor de uma conversa por voz costuma chegar antes da resposta. Você faz uma pausa para lembrar uma data, e o assistente começa a falar. Corrige um nome, e ele termina a frase que já havia preparado. A voz pode ser excelente enquanto a interação parece estranhamente pouco cooperativa. Para quem desenvolve um assistente telefônico, um tutor ou um personagem interativo, essas pequenas falhas podem importar tanto quanto a qualidade da fala gerada.
Em 20 de outubro, a ElevenLabs apresentou Eleven Realtime v1 Mini e v1 Max, posicionados como modelos completos para agentes de voz, em vez de mais um componente para o desenvolvedor montar. O Mini busca conversas cotidianas com menor custo; o Max, instruções complexas e tarefas com várias etapas. O lançamento importa porque reúne mais partes da conversa em uma única decisão de produto. Também torna mais difícil evitar uma pergunta antiga: quando uma voz parece competente, como sabemos que a tarefa realmente foi concluída? Anúncio oficial.
Nossa avaliação: a promessa está em gastar menos tempo ajustando as conexões entre componentes. A prova dessa promessa é uma conversa que resiste a correções e chega ao resultado correto. Uma demonstração bem produzida pode mostrar a primeira impressão. Uma solicitação comum e confusa de um cliente é onde o produto demonstra seu valor.
A ElevenLabs amplia uma competência conhecida para uma tarefa maior
Para quem conhece a ElevenLabs principalmente pelas vozes sintéticas, a empresa agora descreve três plataformas: ElevenCreative para criação de conteúdo, ElevenAgents para agentes conversacionais em operação e ElevenAPI para desenvolvedores. O Realtime faz parte desse esforço mais amplo de tornar o áudio útil dentro de um aplicativo, além de ser um arquivo de áudio pronto. Esse contexto explica a combinação entre qualidade da voz e mecanismos de interação. Apresentação da ElevenLabs para a imprensa.
Um clipe de áudio tem limites claros. O texto é escrito, a fala é gerada e alguém escuta o resultado. Um agente ao vivo trabalha em uma situação que muda continuamente. O ouvinte pode interromper, mudar a pergunta, fornecer informações ausentes ou descobrir que a solicitação original estava errada. O software precisa decidir se uma pausa significa “sua vez” ou “ainda estou pensando”. Deve manter sua interpretação alinhada à pessoa e, ao mesmo tempo, lidar com os sistemas por trás da conversa.
Esse problema de produto difere de fazer uma frase isolada soar convincente. Pense em um assistente de reservas. Ele pode pronunciar perfeitamente o nome do cliente e ainda reservar o dia errado porque perdeu uma correção. Um produto de voz bem-sucedido precisa que tanto o ritmo social quanto o registro da transação façam sentido. Melhorar um e ignorar o outro cria uma maneira agradável de fazer a coisa errada.
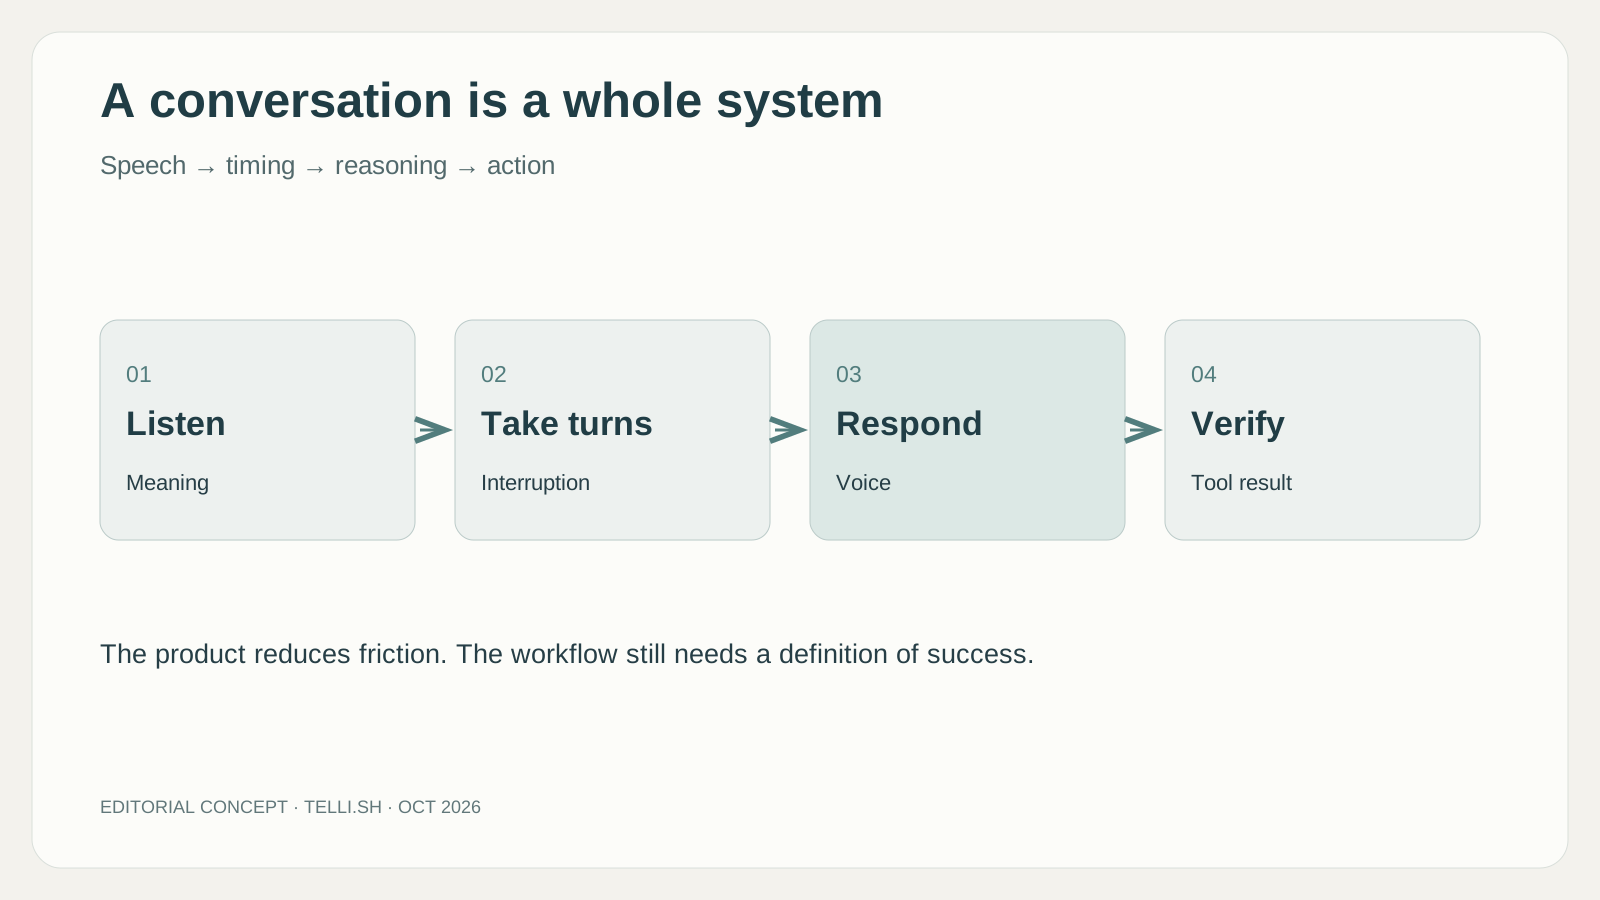
Infográfico editorial original. Descreve a experiência do usuário, não a arquitetura interna do modelo.
Uma estrutura gerenciada reduz a configuração e muda o que você controla
A distinção na documentação é prática. No modo Custom, quem desenvolve escolhe o modelo de linguagem, o modelo de fala e as configurações de reconhecimento. O modo Realtime entrega essas escolhas à ElevenLabs, preservando instruções do agente, voz, ferramentas e outras configurações de conversa compatíveis. O acesso está sendo liberado gradualmente, portanto a opção pode ainda não aparecer em todos os espaços de trabalho. O Realtime também tem restrições de compatibilidade e de região que um agente existente precisa atender. Documentação dos modelos Realtime.
Essa troca pode valer a pena. Uma equipe pequena talvez se preocupe muito mais com a capacidade do assistente de lidar com interrupções do que em escolher cada componente subjacente. Uma configuração gerenciada oferece um ponto de partida coerente e menos combinações para investigar. A equipe pode dedicar tempo às perguntas dos clientes, às informações que a empresa realmente tem e ao momento em que uma pessoa deve assumir.
Mas menos configurações também significam menos substituições independentes. Se uma parte do comportamento for inadequada, a equipe precisa saber se pode ajustá-la, trocar os modelos ou voltar a uma configuração personalizada. A comparação correta é o trabalho total para manter um agente utilizável. Uma estrutura configurável pode ser trabalhosa; uma integrada pode ser restritiva. O custo mais relevante depende da tarefa e de quem operará o sistema depois da demonstração.
Isso é especialmente importante quando um protótipo vira um serviço compartilhado. Quem montou o protótipo pode conhecer suas particularidades. A equipe de atendimento, o cliente e o próximo desenvolvedor experimentarão o comportamento sem esse contexto. Um produto que faz escolhas comuns de maneira consistente pode ser valioso mesmo oferecendo menos opções. A consistência ajuda quando é visível, testável e compatível com as responsabilidades do serviço.
Outras estruturas de voz colocam o controle em lugares diferentes
A abordagem da ElevenLabs fica mais clara ao lado das alternativas. O guia de agentes de voz da OpenAI diferencia interação de fala em tempo real de um fluxo encadeado que transcreve a fala, executa um agente de texto e depois gera a fala. A discussão sobre sistemas encadeados destaca a inspeção do texto intermediário e a substituição de componentes individuais. É uma comparação arquitetural, e não evidência sobre o funcionamento interno não divulgado do Eleven Realtime. A mesma interação com o cliente pode ser montada com diferentes pontos de observação e intervenção.
Uma etapa de texto pode ser útil quando a organização precisa de um ponto de controle definido. Um serviço de ensino pode revisar como um agente interpreta a resposta do aluno; um atendimento especializado pode tratar a terminologia antes de a resposta ser falada. O registro intermediário oferece algo específico para inspecionar. Também introduz outra fronteira entre componentes para manter. Para um personagem animado ou uma conversa exploratória, quem desenvolve pode preferir uma interação mais integrada e aceitar outro conjunto de controles.
| Abordagem | O que atrai quem desenvolve | O que ainda exige uma decisão |
|---|---|---|
| Modo gerenciado em tempo real | Menos escolhas de componentes e uma configuração conversacional compatível | Se as configurações disponíveis atendem ao serviço |
| Fala e texto encadeados | Texto intermediário inspecionável e substituição independente de componentes | Como as etapas montadas preservam o ritmo e as correções |
| Orquestração baseada em framework | Comportamento explícito do aplicativo para turnos, ferramentas e transferências | Quem mantém esse comportamento quando os fornecedores mudam |
O fator decisivo é onde a equipe precisa de um ponto de controle confiável: na transcrição intermediária, em um evento da conversa ou na ação concluída. Isso ajuda a explicar por que uma equipe pode razoavelmente manter um sistema personalizado mesmo depois de um lançamento integrado promissor. A oportunidade comercial da ElevenLabs é tornar a opção gerenciada boa o bastante para mais tarefas, de modo que a montagem detalhada vire uma escolha, em vez do preço de entrada para criar um serviço de voz.
Uma hesitação e uma interrupção merecem respostas diferentes
A perspectiva dos frameworks acrescenta outra dimensão. A documentação de tratamento de turnos do LiveKit trata falsas interrupções como um comportamento explícito: a atividade de voz pode interromper um agente sem produzir uma transcrição do usuário, e a fala pode ser retomada após um intervalo configurado. Isso não demonstra que a ElevenLabs usa o mesmo mecanismo. Mostra por que a aparente educação de um produto de voz depende do comportamento do aplicativo e também do modelo que fornece suas palavras.
Imagine a diferença entre alguém dizer “espere, é o outro endereço” e alguém tossir enquanto escuta. Ambos podem produzir som durante a vez do assistente. Só um necessariamente muda a solicitação. Um serviço que reinicia a explicação a cada ruído de fundo cansa; um que ignora uma correção real deixa de ser confiável. A comparação útil é se a conversa se recupera com o contexto correto, em vez de apenas verificar se o canal de áudio detectou atividade rapidamente.
Essa distinção também amplia quem deve participar de um piloto. Pessoas procurando uma palavra desconhecida, usando um segundo idioma ou falando em ritmo mais lento podem precisar de diferentes tempos de silêncio. São grupos propostos para avaliação, não afirmações sobre acessibilidade medida ou cobertura de idiomas. As equipes devem observar se os usuários têm espaço para terminar e se a recuperação exige repetir a solicitação inteira. Uma média de tempo de resposta pode esconder esse esforço.
A possibilidade animadora é que um modelo de conversa gerenciado melhore essa experiência sem exigir que cada cliente implemente sua própria lógica de tempo. A questão restante é quanto um aplicativo específico pode ajustar quando o ritmo padrão não serve. É uma pergunta concreta para uma demonstração: deixe a pessoa hesitar, corrigir um detalhe e retomar; depois inspecione o que o agente entendeu e o que a ferramenta conectada realmente recebeu. Isso conecta o conforto da conversa a um resultado verificável pela equipe.
Mini e Max separam a conversa da execução exigente
Os dois nomes devem incentivar uma decisão por carga de trabalho, não a compra automática do modelo maior. Um personagem para praticar idiomas e um agente que segue um processo de reembolso enfrentam problemas diferentes. O primeiro precisa manter a conversa e reagir adequadamente aos erros. O segundo talvez tenha de consultar uma política, identificar um pedido, verificar a elegibilidade e relatar o resultado de uma ação externa.
Um modelo maior pode ser desnecessário para uma interação leve, enquanto o mais barato pode sair caro se encaminhar repetidamente casos não resolvidos à equipe. Custo por minuto ajuda a estimar a conta. Custo por interação concluída corretamente é mais útil para decidir se o sistema cabe no fluxo de trabalho. Esse segundo número inclui recuperação, chamadas repetidas e o trabalho de corrigir erros plausíveis.
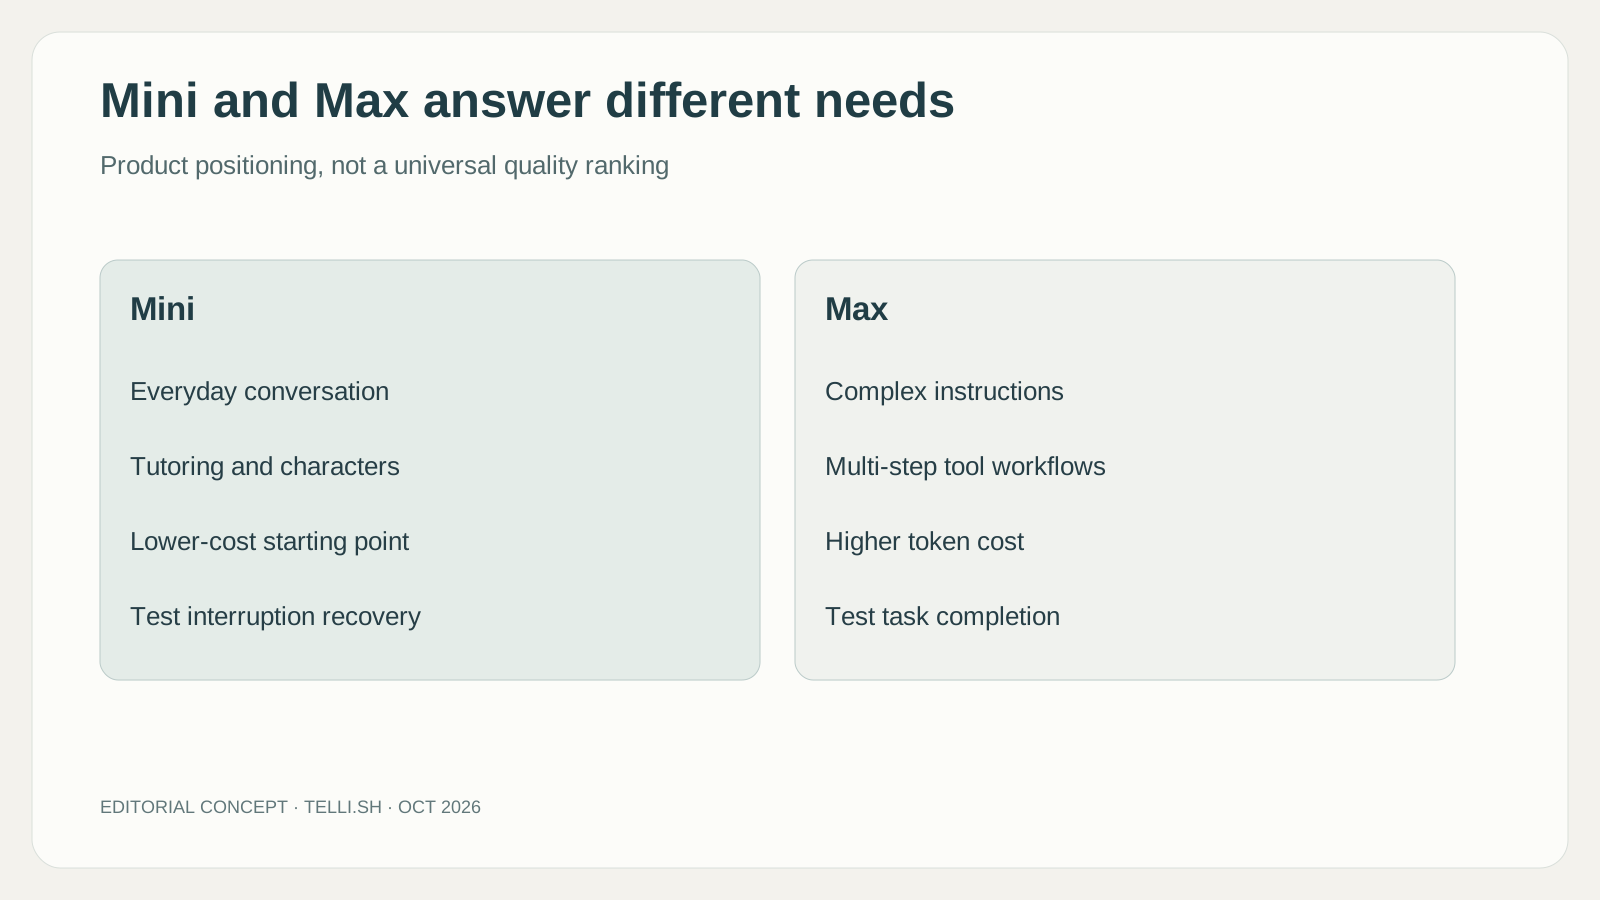
Infográfico original baseado no posicionamento do fornecedor. Não é uma classificação medida em todos os idiomas ou tarefas.
O anúncio publica resultados de benchmarks atribuídos à Artificial Analysis. Os números de uso de ferramentas são 87.1% de conclusão para o Max e 60.3% para o Mini, enquanto as pontuações divulgadas de dinâmica conversacional favorecem ligeiramente o Mini. São resultados de benchmarks publicados pelo fornecedor, não medições de nossa implantação. A mensagem útil é que fluência conversacional e conclusão com ferramentas podem divergir; eles não estabelecem a taxa de sucesso nas chamadas de uma empresa específica. Anúncio e contexto dos benchmarks.
Uma equipe deve, portanto, evitar reduzir toda a qualidade a uma posição em ranking. Se o agente explica principalmente uma exposição de museu, o ritmo da conversa pode dominar. Se altera uma reserva, o estado final exato importa mais. O lançamento oferece dois pontos de partida, mas a tarefa continua definindo o que significa qualidade.
Três situações comuns revelam diferentes pontos fortes
Imagine alguém praticando uma conversa de restaurante em outro idioma. A pessoa para no meio do pedido, procura uma palavra e começa novamente. Um tutor útil dá espaço a essa hesitação e oferece ajuda sem assumir o controle. O benefício é a confiança para continuar praticando. A falha é um assistente que interpreta toda pausa como permissão para dar uma aula. Esse caso ilustrativo trata principalmente de cooperação na conversa; a qualidade do ensino ainda precisa de revisão própria.
Agora pense em um serviço de agendamento. A pessoa primeiro pede sexta-feira e depois diz: “Na verdade, segunda que vem, depois do almoço”. O assistente deve levar a correção para o agendamento proposto e confirmar os detalhes relevantes antes da etapa com consequências. Quando o sistema de reservas responder, a confirmação falada deve refletir essa resposta. Um simpático “tudo certo” antes de o sistema aceitar a alteração seria uma falha, mesmo que cada frase soasse natural.
Um personagem interativo cria um terceiro equilíbrio. Ele pode tolerar uma resposta imaginativa no universo fictício, mas o jogador ainda espera que lembre a cena atual e pare quando interrompido. Aqui, o resultado comercial pode ser uma interação envolvente, em vez de uma transação concluída. O mesmo comportamento que parece animado em um personagem pode soar evasivo no atendimento. São razões para avaliar tarefas distintas, em vez de tratar “agente de voz” como uma categoria uniforme.
A compatibilidade reduz o custo de experimentar, com limites que merecem leitura
A ElevenLabs oferece acesso pelo ElevenAgents e por uma API Realtime compatível com a da OpenAI. O exemplo do anúncio troca o destino e o modelo em um cliente existente, mas também especifica uma conexão apenas por WebSocket e distingue essa API da plataforma gerenciada. Uma integração WebRTC, portanto, exige mais que trocar o nome do modelo, e canais gerenciados ou recursos de base de conhecimento não devem ser presumidos como parte automática da API. Acesso à API e notas de migração.
O valor da compatibilidade é facilitar a comparação. O desenvolvedor consegue preservar mais do aplicativo existente ao experimentar outro fornecedor. Isso torna mais viável comparar a mesma tarefa, os mesmos prompts e as mesmas ferramentas, em vez de demonstrações sem relação entre si. Não elimina a necessidade de inspecionar eventos, reconexões, respostas das ferramentas e como o aplicativo apresenta uma falha.
Esses detalhes menos chamativos moldam a experiência do cliente. Se a conexão cair depois de uma solicitação de reserva, o aplicativo precisa saber se a reserva aconteceu antes de pedir que a pessoa repita. Se uma ferramenta atingir o tempo limite, repetir sua chamada pode ter consequências diferentes de repetir a pergunta falada. A migração de modelo funciona quando o aplicativo completo se comporta corretamente nessas situações, não apenas quando a primeira resposta de áudio toca.
Uma voz natural pode fazer uma ação incompleta parecer concluída
Mantenha a comparação estável ao decidir entre modelos. Se o maior recebe uma base de conhecimento mais limpa, um prompt melhor e ferramentas mais confiáveis, o teste não explica qual mudança ajudou. Comece com as mesmas solicitações representativas e examine as falhas antes de mudar o fluxo ao redor. Uma falha de tempo pode exigir ajuste na conversa; uma resposta errada sobre política, fontes melhores; uma reserva incompleta, atenção à integração da ferramenta. Comprar um modelo mais capaz pode ajudar em alguns desses problemas, mas não deve esconder uma conexão defeituosa que permaneceria assim em ambas as opções.
A maior vantagem do produto também pode dificultar perceber erros. Pessoas usam tom, ritmo e confiança como sinais na conversa. Um assistente fluente pode soar como se tivesse verificado algo quando apenas formulou uma resposta plausível. Em texto, o usuário talvez tenha mais oportunidade de inspecionar a resposta. Durante uma chamada, a conversa avança e o detalhe em disputa pode desaparecer no fluxo.
A resposta de design deve ser concreta, sem teatralidade. Diferencie explicação, ação proposta e resultado confirmado. Permita que o agente diga que está verificando, que uma solicitação continua pendente ou que uma pessoa precisa ajudar. Faça esses estados corresponderem ao aplicativo, para não serem apenas palavras tranquilizadoras no prompt. Uma pausa verdadeira costuma ser uma experiência melhor do que uma resposta imediata que cria retrabalho.
O encaminhamento humano também precisa de continuidade. Quem chega à equipe depois de vários minutos não deveria reconstruir todos os detalhes de memória. Uma transferência útil contém a solicitação atual, as correções relevantes e a etapa não resolvida. Deve preservar a incerteza onde o agente não tinha certeza. Caso contrário, a automação economiza tempo no início e transfere o mesmo esforço para quem terá de resolver.
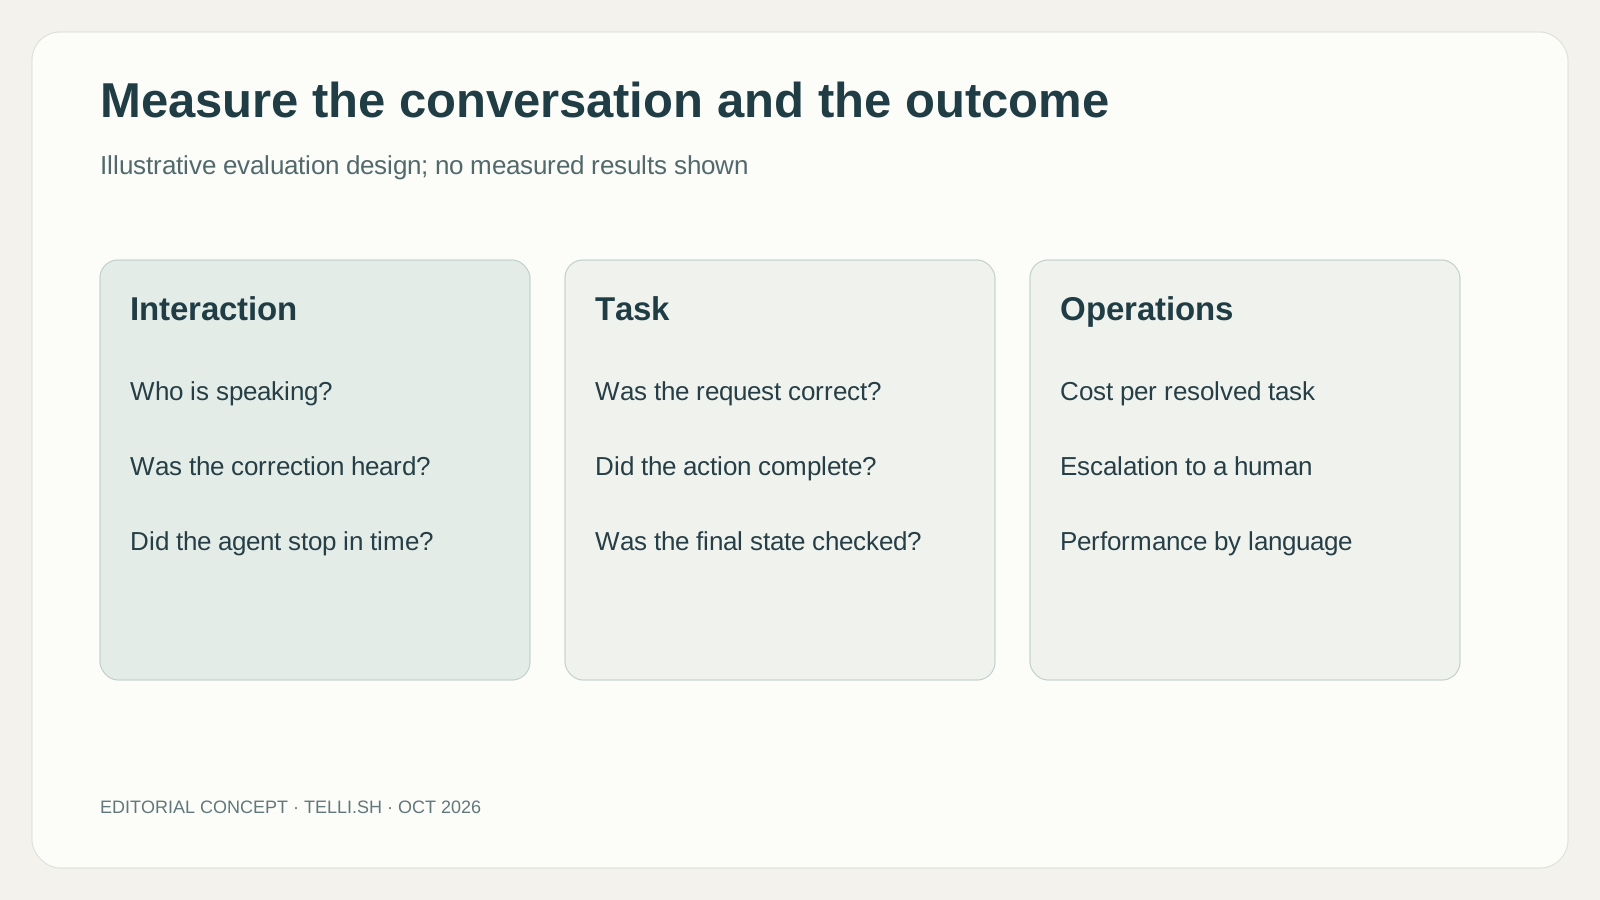
Estrutura editorial original de avaliação. Não representa resultados de testes.
O próximo benchmark é uma conversa resolvida
Um piloto sensato usaria conversas representativas com permissão: solicitações curtas e longas, interrupções, correções, idiomas diferentes e casos que exigem encaminhamento. Avalie se a ação pretendida ocorreu, com que frequência pessoas precisaram intervir e quanto custou a interação concluída. Mantenha a rapidez do primeiro áudio como uma medida, mas conte também respostas rápidas que depois precisaram de correção. São propostas de avaliação, não testes que realizamos com o Realtime.
O resultado mais promissor é um agente que faz menos perguntas desnecessárias e continua disposto a fazer a necessária. Um tutor deve deixar o aluno terminar de pensar. Um assistente de reservas deve verificar a data corrigida. Um agente de atendimento deve levar o contexto para a transferência. São melhorias modestas de descrever e significativas de vivenciar, porque eliminam os pequenos atritos que tornam exaustivas as conversas automatizadas.
O Eleven Realtime dá a essa direção uma forma concreta de produto. Pode permitir que mais equipes construam interações de voz úteis sem se especializar em cada componente da estrutura de áudio. Seu significado de longo prazo dependerá de o comportamento conversacional integrado também gerar trabalho concluído com confiabilidade. A voz leva o usuário para a conversa. O resultado determina se ele desejará ter a próxima.
Fontes
-
Anúncio do Eleven Realtime e contexto dos benchmarks, 20 de outubro de 2026.
-
Modos dos modelos Realtime, liberação e limitações, consultado em 21 de outubro de 2026.
-
Contexto das plataformas ElevenLabs, consultado em 21 de outubro de 2026.
-
Arquiteturas de agentes de voz da OpenAI, consultado em 21 de outubro de 2026.
-
Tratamento de turnos do LiveKit, consultado em 21 de outubro de 2026.
Mantenha a conversa disponível para revisão
Se você quer um lugar separado para guardar gravações autorizadas e suas anotações revisadas, o Telli.sh é uma opção. Comece com uma nota de áudio.