Eleven Realtime verlagert den Wettbewerb bei Sprach-KI über die Stimme hinaus
ElevenLabs stellt die Echtzeitmodelle Mini und Max vor. Interessant sind eine einfachere Gesprächsarchitektur und die deutlichere Trennung zwischen natürlichem Klang und erfolgreich erledigten Aufgaben.
Offizielle Vorschau einer ElevenLabs-UI-Komponente für Sprachgespräche im Kundenservice. Quelle: elevenlabs/ui; Copyright 2025 Eleven Labs Inc., MIT-Lizenz. Sie illustriert eine Sprachoberfläche und keinen Test des Realtime-Modells.

Der unangenehme Moment in einem Sprachgespräch kommt oft schon vor der Antwort. Sie überlegen kurz, um sich an ein Datum zu erinnern, und der Assistent beginnt zu reden. Sie korrigieren einen Namen, während er den bereits vorbereiteten Satz zu Ende spricht. Die Stimme kann hervorragend klingen, obwohl das Gespräch erstaunlich wenig entgegenkommend wirkt. Wer einen Telefonassistenten, einen Tutor oder eine interaktive Figur entwickelt, muss solche kleinen Fehler ebenso ernst nehmen wie die Qualität der erzeugten Sprache.
Am 20. Oktober stellte ElevenLabs Eleven Realtime v1 Mini und v1 Max vor. Das Unternehmen positioniert sie als vollständige Sprachagentenmodelle statt als weitere Einzelkomponente, die Entwickler zusammenbauen müssen. Mini zielt auf alltägliche Gespräche zu geringeren Kosten, Max auf komplexe Anweisungen und mehrstufige Aufgaben. Die Veröffentlichung ist relevant, weil sie mehr Teile eines Gesprächs in einer Produktentscheidung bündelt. Gleichzeitig verschärft sie eine bekannte Frage: Woran erkennen wir, ob eine Aufgabe tatsächlich erledigt wurde, wenn die Stimme kompetent klingt? Offizielle Ankündigung.
Unsere Einschätzung: Vielversprechend ist vor allem, weniger Zeit mit den Übergängen zwischen Komponenten zu verbringen. Bewähren muss sich das in Gesprächen, die Korrekturen verkraften und ein richtiges Ergebnis liefern. Eine ausgefeilte Demonstration vermittelt den ersten Eindruck. Ob das Produkt seinen Platz verdient, zeigt eine gewöhnliche, unordentliche Kundenanfrage.
ElevenLabs erweitert eine bekannte Stärke um eine größere Aufgabe
Wer ElevenLabs vor allem mit synthetischen Stimmen verbindet, findet inzwischen drei vom Unternehmen beschriebene Plattformen: ElevenCreative für die Inhaltserstellung, ElevenAgents für eingesetzte Gesprächsagenten und ElevenAPI für Entwickler. Realtime gehört zu diesem breiteren Vorhaben, Audio innerhalb einer Anwendung nutzbar zu machen, statt lediglich fertige Audiodateien zu erzeugen. Dieser Hintergrund erklärt, warum die Veröffentlichung Sprachqualität mit den Abläufen einer Interaktion verbindet. Presseinformationen zu ElevenLabs.
Ein Audioclip hat eine klare Grenze. Der Text wird geschrieben, Sprache erzeugt und das Ergebnis angehört. Ein Live-Agent arbeitet in einer veränderlichen Situation. Sein Gegenüber kann unterbrechen, die Frage ändern, Informationen ergänzen oder feststellen, dass die ursprüngliche Anfrage falsch war. Die Software muss entscheiden, ob eine Pause „Sie sind dran“ oder „Ich denke noch nach“ bedeutet. Dabei muss ihr Verständnis mit dem Menschen Schritt halten und zugleich die Systeme hinter dem Gespräch berücksichtigen.
Das ist eine andere Produktaufgabe, als einen einzelnen Satz überzeugend klingen zu lassen. Ein Buchungsassistent kann den Kundennamen perfekt aussprechen und trotzdem den falschen Tag reservieren, weil ihm eine Korrektur entgangen ist. Ein erfolgreiches Sprachprodukt braucht sowohl einen passenden sozialen Rhythmus als auch einen korrekten Transaktionsverlauf. Wer nur einen dieser Bereiche verbessert, schafft einen angenehmen Weg zum falschen Ergebnis.
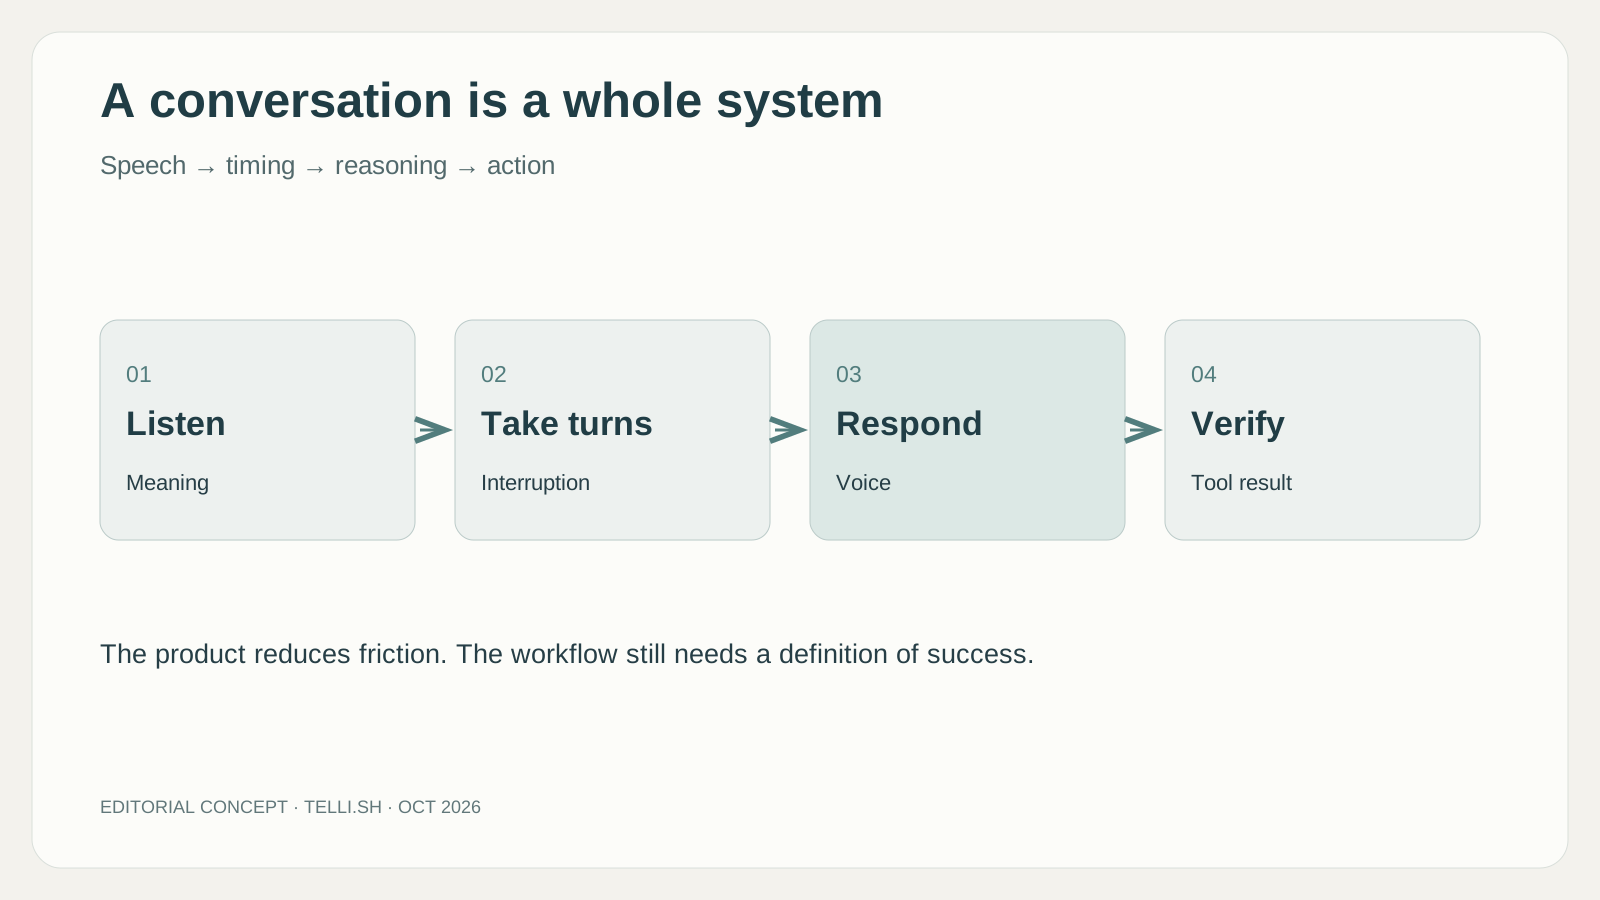
Eigene redaktionelle Infografik. Sie beschreibt die Nutzererfahrung und nicht die interne Architektur des Modells.
Ein verwalteter Aufbau reduziert Einstellungen und verändert die Kontrolle
Die Dokumentation macht einen praktischen Unterschied deutlich. Im Custom-Modus wählen Entwickler Sprachmodell, Sprachausgabemodell und Erkennungseinstellungen selbst. Der Realtime-Modus überlässt diese Entscheidungen ElevenLabs, behält aber die Anweisungen, Stimme, Werkzeuge und weitere unterstützte Gesprächseinstellungen des Agenten bei. Der Zugang wird schrittweise eingeführt, weshalb die Einstellung noch nicht in jedem Arbeitsbereich erscheinen muss. Bestehende Agenten müssen außerdem die Kompatibilitäts- und Regionsvorgaben erfüllen. Dokumentation der Realtime-Modelle.
Dieser Tausch kann sinnvoll sein. Für ein kleines Team ist möglicherweise viel wichtiger, ob sein Assistent eine Unterbrechung richtig behandelt, als jede zugrunde liegende Komponente auszuwählen. Eine verwaltete Konfiguration bietet einen zusammenhängenden Ausgangspunkt und weniger Kombinationen für die Fehlersuche. Das Team kann sich auf Kundenfragen, tatsächlich vorhandene Geschäftsinformationen und den Zeitpunkt konzentrieren, an dem ein Mensch übernehmen soll.
Weniger Einstellungen bedeuten allerdings auch weniger unabhängige Austauschmöglichkeiten. Passt ein Verhalten nicht, muss das Team wissen, ob es dieses anpassen, das Modell wechseln oder zu einer individuellen Konfiguration zurückkehren kann. Entscheidend ist der Gesamtaufwand für einen brauchbaren Agenten. Ein konfigurierbarer Aufbau kann aufwendig, ein integrierter einschränkend sein. Welche Kosten stärker wiegen, hängt von der Aufgabe und den Menschen ab, die das System nach der Demonstration betreiben.
Besonders deutlich wird das, wenn aus einem Prototyp ein gemeinsam genutzter Dienst wird. Die Person, die ihn gebaut hat, kennt seine Eigenheiten vielleicht. Supportteam, Kunden und nachfolgende Entwickler erleben das Verhalten ohne diesen Hintergrund. Ein Produkt, das häufige Entscheidungen konsistent trifft, kann auch mit weniger Auswahlmöglichkeiten wertvoll sein. Konsistenz hilft, wenn sie sichtbar, prüfbar und mit den Pflichten des Dienstes vereinbar ist.
Andere Spracharchitekturen verorten die Kontrolle an anderen Stellen
Der Ansatz von ElevenLabs wird im Vergleich mit Alternativen deutlicher. OpenAIs Leitfaden für Sprachagenten unterscheidet Echtzeit-Sprachinteraktionen von einer verketteten Verarbeitung, die Sprache transkribiert, einen Textagenten ausführt und anschließend Sprache erzeugt. Bei verketteten Systemen betont der Leitfaden die Prüfung von Zwischentexten und den Austausch einzelner Komponenten. Das ist ein Architekturvergleich und keine Aussage über die nicht offengelegten Interna von Eleven Realtime. Dieselbe Kundeninteraktion lässt sich um unterschiedliche Beobachtungs- und Eingriffspunkte herum aufbauen.
Eine Textstufe ist wertvoll, wenn eine Organisation einen klar benannten Kontrollpunkt braucht. Ein Lernangebot könnte prüfen, wie ein Agent eine Schülerantwort versteht; ein spezialisierter Support könnte Fachbegriffe behandeln, bevor eine Antwort gesprochen wird. Der Zwischenstand gibt dem Team etwas Konkretes zur Prüfung. Zugleich entsteht eine weitere zu wartende Komponentengrenze. Für eine lebendige Figur oder ein offenes Gespräch bevorzugt der Entwickler womöglich eine stärker integrierte Interaktion und akzeptiert andere Kontrollmöglichkeiten.
| Ansatz | Was Entwickler daran anspricht | Was noch entschieden werden muss |
|---|---|---|
| Verwalteter Echtzeitmodus | Weniger Komponentenauswahl und eine unterstützte Gesprächskonfiguration | Ob die unterstützten Einstellungen zum Dienst passen |
| Verkettete Sprach- und Textverarbeitung | Prüffähiger Zwischentext und unabhängiger Austausch von Komponenten | Wie die verbundenen Stufen Timing und Korrekturen erhalten |
| Frameworkgestützte Orchestrierung | Explizites Anwendungsverhalten für Sprecherwechsel, Werkzeuge und Übergaben | Wer dieses Verhalten bei Anbieterwechseln pflegt |
Entscheidend ist, wo das Team einen verlässlichen Kontrollpunkt benötigt: in einem Zwischentranskript, einem Gesprächsereignis oder der abgeschlossenen Aktion. Das erklärt, warum ein Team auch nach einer vielversprechenden integrierten Veröffentlichung vernünftigerweise sein eigenes System behalten kann. Die geschäftliche Chance für ElevenLabs besteht darin, die verwaltete Option für mehr Aufgaben ausreichend gut zu machen. Dann wird der detaillierte Zusammenbau zur Wahlmöglichkeit statt zur Eintrittsbedingung für einen Sprachdienst.
Zögern und Unterbrechen verlangen unterschiedliche Antworten
Die Frameworkperspektive fügt eine weitere Dimension hinzu. LiveKits Dokumentation zur Gesprächssteuerung behandelt falsche Unterbrechungen als ausdrücklich zu berücksichtigendes Verhalten: Sprachaktivität kann einen Agenten unterbrechen, obwohl daraus kein Nutzertranskript entsteht; nach einer konfigurierten Wartezeit kann die Ausgabe fortgesetzt werden. Das belegt nicht, dass ElevenLabs denselben Mechanismus nutzt. Es zeigt, warum die wahrgenommene Höflichkeit eines Sprachprodukts außer vom formulierenden Modell auch vom Anwendungsverhalten abhängt.
Stellen Sie sich den Unterschied zwischen „Moment, die andere Adresse“ und einem Husten beim Zuhören vor. Beides erzeugt während des Assistentenbeitrags ein Geräusch. Nur eines verändert zwangsläufig die Anfrage. Ein Dienst, der nach jedem Hintergrundgeräusch neu beginnt, wird anstrengend; einer, der echte Korrekturen ignoriert, verliert Vertrauen. Sinnvoll ist deshalb der Vergleich, ob das Gespräch mit dem richtigen Kontext weitergeht, statt nur zu messen, wie schnell der Audiokanal Aktivität erkennt.
Diese Unterscheidung erweitert auch den Teilnehmerkreis eines Pilotversuchs. Wer ein ungewohntes Wort sucht, eine Zweitsprache verwendet oder langsamer spricht, benötigt möglicherweise mehr Stille. Das sind vorgeschlagene Evaluationsgruppen und keine Aussagen über gemessene Barrierefreiheit oder Sprachabdeckung. Teams sollten darauf achten, ob Menschen ausreden können und ob sie zur Wiederaufnahme ihre gesamte Anfrage wiederholen müssen. Ein durchschnittlicher Antwortzeitwert kann diese Belastung verdecken.
Ermutigend ist die Möglichkeit, dass ein verwaltetes Gesprächsmodell diese Erfahrung verbessert, ohne dass jeder Kunde eine eigene Zeitsteuerung entwickeln muss. Offen bleibt, wie stark eine konkrete Anwendung eingreifen kann, wenn der Standardrhythmus nicht passt. Das liefert eine konkrete Frage für eine Demonstration: Lassen Sie jemanden zögern, ein Detail korrigieren und fortfahren. Prüfen Sie anschließend, was der Agent verstanden und was das angeschlossene Werkzeug tatsächlich erhalten hat. So verbinden sich angenehme Gesprächsführung und ein überprüfbares Ergebnis.
Mini und Max trennen Unterhaltung von anspruchsvoller Ausführung
Die beiden Namen sollten zu einer Entscheidung über die Arbeitslast führen, statt automatisch zum größeren Modell zu greifen. Eine Figur für Sprachübungen und ein Serviceagent, der einen Erstattungsprozess befolgt, lösen unterschiedliche Probleme. Die eine muss das Gespräch in Gang halten und angemessen auf Fehler reagieren. Der andere muss womöglich eine Richtlinie abrufen, eine Bestellung identifizieren, Voraussetzungen prüfen und das Ergebnis einer externen Aktion mitteilen.
Für einen einfachen Austausch könnte ein größeres Modell unnötig sein. Umgekehrt kann das günstigere teuer werden, wenn es ständig ungelöste Fälle an Mitarbeitende weitergibt. Kosten pro Minute helfen bei der Rechnungsplanung. Kosten pro korrekt abgeschlossener Interaktion helfen eher bei der Entscheidung, ob das System in einen Arbeitsablauf gehört. Diese zweite Zahl schließt Wiederherstellung, wiederholte Anrufe und menschliche Nacharbeit plausibler Fehler ein.
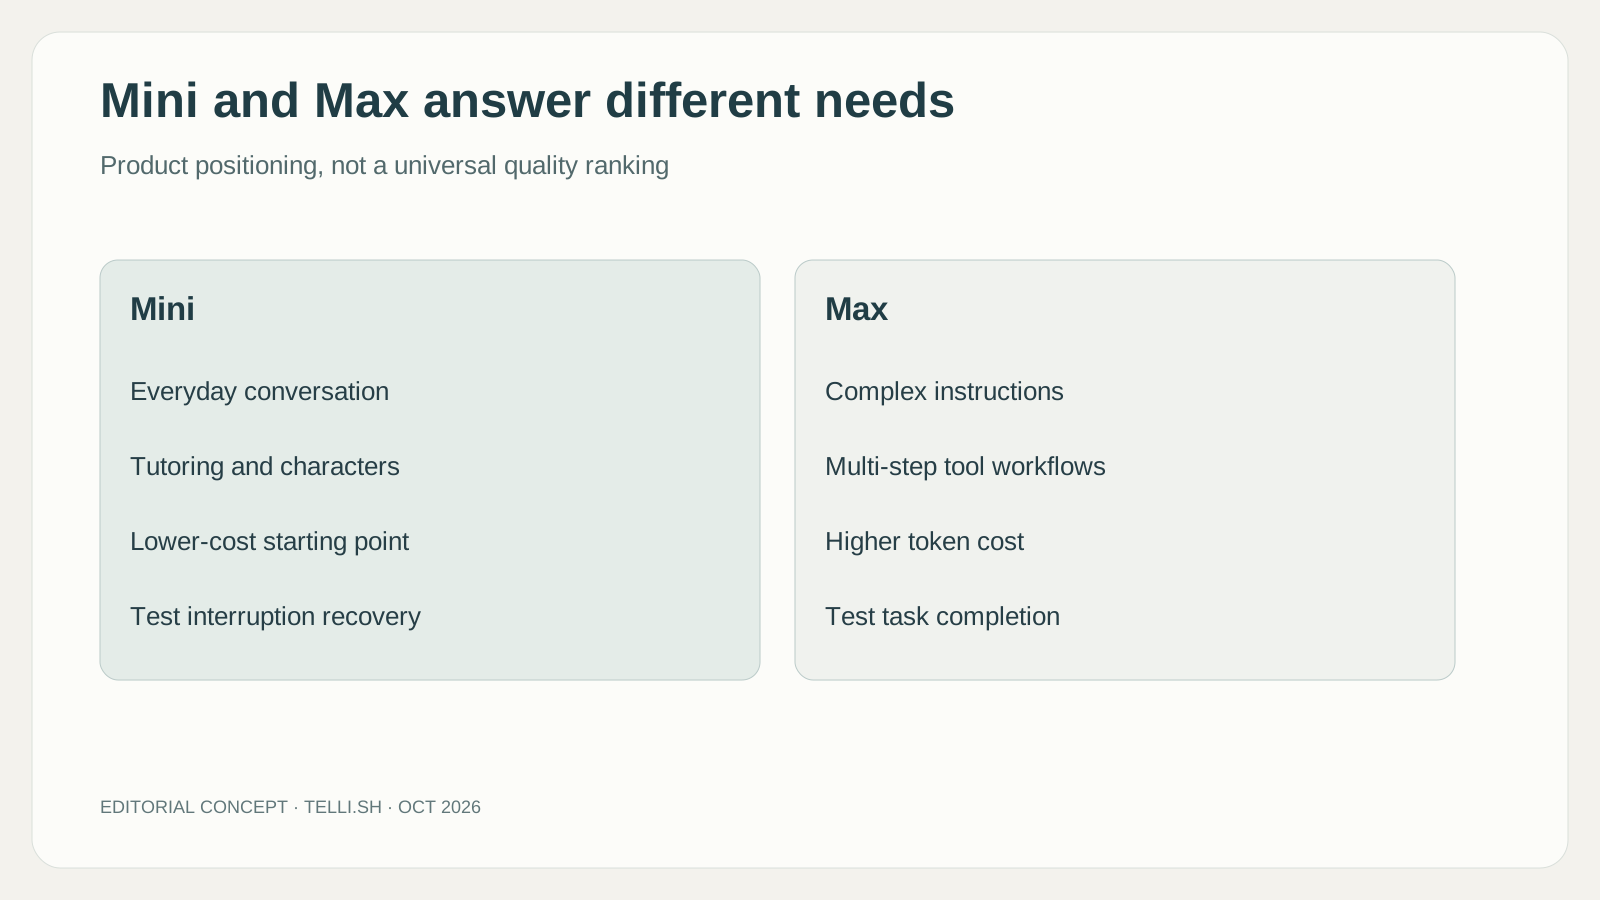
Eigene Infografik auf Grundlage der Anbieterpositionierung. Sie ist keine gemessene Rangfolge für sämtliche Sprachen oder Aufgaben.
Die Ankündigung veröffentlicht Benchmarkwerte, die Artificial Analysis zugeschrieben werden. Bei Werkzeugaufgaben nennt sie 87.1% Abschlussquote für Max und 60.3% für Mini, während die berichteten Werte zur Gesprächsdynamik Mini leicht bevorzugen. Das sind vom Anbieter veröffentlichte Benchmarkergebnisse und keine Messungen unseres Einsatzes. Ihr nützlicher Hinweis ist, dass Gesprächsflüssigkeit und Werkzeugabschluss auseinanderliegen können. Sie bestimmen keine Erfolgsquote für die Anrufe eines konkreten Unternehmens. Ankündigung und Benchmarkkontext.
Teams sollten deshalb nicht sämtliche Qualität auf einen Ranglistenplatz reduzieren. Erklärt der Agent hauptsächlich eine Museumsausstellung, dürfte das Gesprächstiming besonders wichtig sein. Aktualisiert er eine Reservierung, zählt der exakte Endzustand stärker. Die Veröffentlichung liefert zwei Ausgangspunkte; was Qualität bedeutet, bestimmt weiterhin die Aufgabe.
Drei alltägliche Situationen zeigen verschiedene Stärken
Stellen Sie sich jemanden vor, der ein Restaurantgespräch in einer anderen Sprache übt. Die Person stoppt mitten in der Bestellung, sucht ein Wort und beginnt erneut. Ein hilfreicher Tutor lässt Raum für dieses Zögern und bietet Unterstützung, ohne das Gespräch an sich zu ziehen. Der Gewinn ist das Zutrauen, weiterzuüben. Der Fehler wäre ein Assistent, der jede Pause als Erlaubnis für einen Vortrag versteht. Dieses illustrative Beispiel betrifft vor allem die Zusammenarbeit im Gespräch; die Unterrichtsqualität benötigt eine eigene Prüfung.
Betrachten wir nun einen Termindienst. Ein Anrufer fragt zunächst nach Freitag und sagt dann: „Eigentlich nächsten Montag, nach dem Mittagessen.“ Der Assistent sollte diese Korrektur in den Buchungsvorschlag übernehmen und relevante Angaben vor dem folgenreichen Schritt bestätigen. Sobald das Buchungssystem antwortet, muss die gesprochene Bestätigung dieses Ergebnis widerspiegeln. Ein freundliches „Alles erledigt“, bevor das System die Änderung akzeptiert, wäre auch bei natürlich klingender Sprache ein Fehler.
Eine interaktive Figur verlangt eine dritte Balance. Innerhalb ihrer fiktionalen Welt darf sie fantasievoll antworten. Trotzdem erwartet der Spieler, dass sie die aktuelle Szene behält und sich unterbrechen lässt. Das geschäftliche Ergebnis kann hier ein fesselnder Austausch statt einer Transaktion sein. Was bei einer Figur lebendig wirkt, könnte im Kundendienst ausweichend erscheinen. Das spricht dafür, unterschiedliche Aufgaben zu bewerten, statt „Sprachagent“ als einheitliche Kategorie zu behandeln.
Kompatibilität senkt den Testaufwand, ihre Grenzen sollte man kennen
ElevenLabs bietet Zugang über ElevenAgents und eine OpenAI-kompatible Realtime-API. Im API-Beispiel der Ankündigung werden Zieladresse und Modell eines bestehenden Clients geändert. Es nennt aber auch eine ausschließlich auf WebSocket basierende Verbindung und trennt diese API von der verwalteten Plattform. Bei einer WebRTC-Integration reicht deshalb das Austauschen des Modellnamens nicht. Verwaltete Kanäle oder Wissensdatenbankfunktionen kommen mit der API ebenfalls nicht automatisch hinzu. API-Zugang und Migrationshinweise.
Kompatibilität erleichtert den Vergleich. Entwickler können größere Teile ihrer bestehenden Anwendung behalten, während sie einen anderen Anbieter testen. Dadurch lassen sich dieselbe Aufgabe, dieselben Prompts und Werkzeuge realistischer vergleichen als unterschiedliche Demonstrationen. Ereignisverhalten, Wiederverbindungen, Werkzeugantworten und die Darstellung von Fehlern müssen dennoch geprüft werden.
Diese weniger spektakulären Details prägen die Kundenerfahrung. Bricht eine Verbindung nach einer Buchungsanfrage ab, muss die Anwendung wissen, ob die Buchung bereits erfolgt ist, bevor sie zur Wiederholung auffordert. Bei einer Zeitüberschreitung kann das Wiederholen eines Werkzeugaufrufs andere Folgen haben als das Wiederholen der gesprochenen Frage. Eine Modellmigration ist erfolgreich, wenn sich die gesamte Anwendung durch diese Situationen korrekt bewegt, nicht allein dann, wenn die erste Audioantwort abgespielt wird.
Eine natürliche Stimme kann eine offene Aktion abgeschlossen wirken lassen
Halten Sie den Vergleich bei der Modellauswahl stabil. Bekommt das größere Modell zugleich eine aufgeräumte Wissensdatenbank, einen besseren Prompt und zuverlässigere Werkzeuge, erklärt der Versuch nicht, welche Änderung geholfen hat. Beginnen Sie mit denselben repräsentativen Anfragen und untersuchen Sie Fehler, bevor Sie den umgebenden Ablauf verändern. Timingprobleme verlangen womöglich eine Gesprächsanpassung, falsche Richtlinienantworten bessere Quellen und unvollständige Buchungen eine korrigierte Werkzeugintegration. Ein stärkeres Modell kann manche Probleme lösen, darf aber keine defekte Verbindung verdecken, die bei beiden Modellen bestehen bliebe.
Die stärkste Produkteigenschaft kann Fehler auch schwerer erkennbar machen. Menschen deuten Ton, Tempo und Selbstsicherheit als Gesprächssignale. Ein flüssiger Assistent kann klingen, als habe er etwas geprüft, obwohl er nur eine plausible Antwort formuliert hat. In einer Textoberfläche bleibt womöglich mehr Gelegenheit zur Kontrolle. Im Telefonat geht es weiter, und das strittige Detail verschwindet im Gesprächsfluss.
Die gestalterische Antwort sollte konkret sein. Unterscheiden Sie zwischen Erklärung, vorgeschlagener Aktion und bestätigtem Ergebnis. Lassen Sie den Agenten mitteilen, dass er prüft, eine Anfrage noch offen ist oder ein Mensch helfen muss. Diese Zustände müssen dem Anwendungszustand entsprechen und dürfen nicht nur beruhigende Formulierungen im Prompt sein. Eine ehrliche Pause bietet oft den besseren Service als eine sofortige Antwort, die später Nacharbeit erzeugt.
Auch die Übergabe an Menschen benötigt Kontinuität. Wer nach mehreren Minuten Mitarbeitende erreicht, sollte nicht jedes Detail aus dem Gedächtnis rekonstruieren müssen. Eine brauchbare Übergabe enthält die aktuelle Anfrage, relevante Korrekturen und den ungelösten Schritt. Unsicherheit des Agenten sollte erhalten bleiben. Sonst spart die Automatisierung am Gesprächsanfang Zeit und verlagert dieselbe Last auf die Person, die den Fall lösen muss.
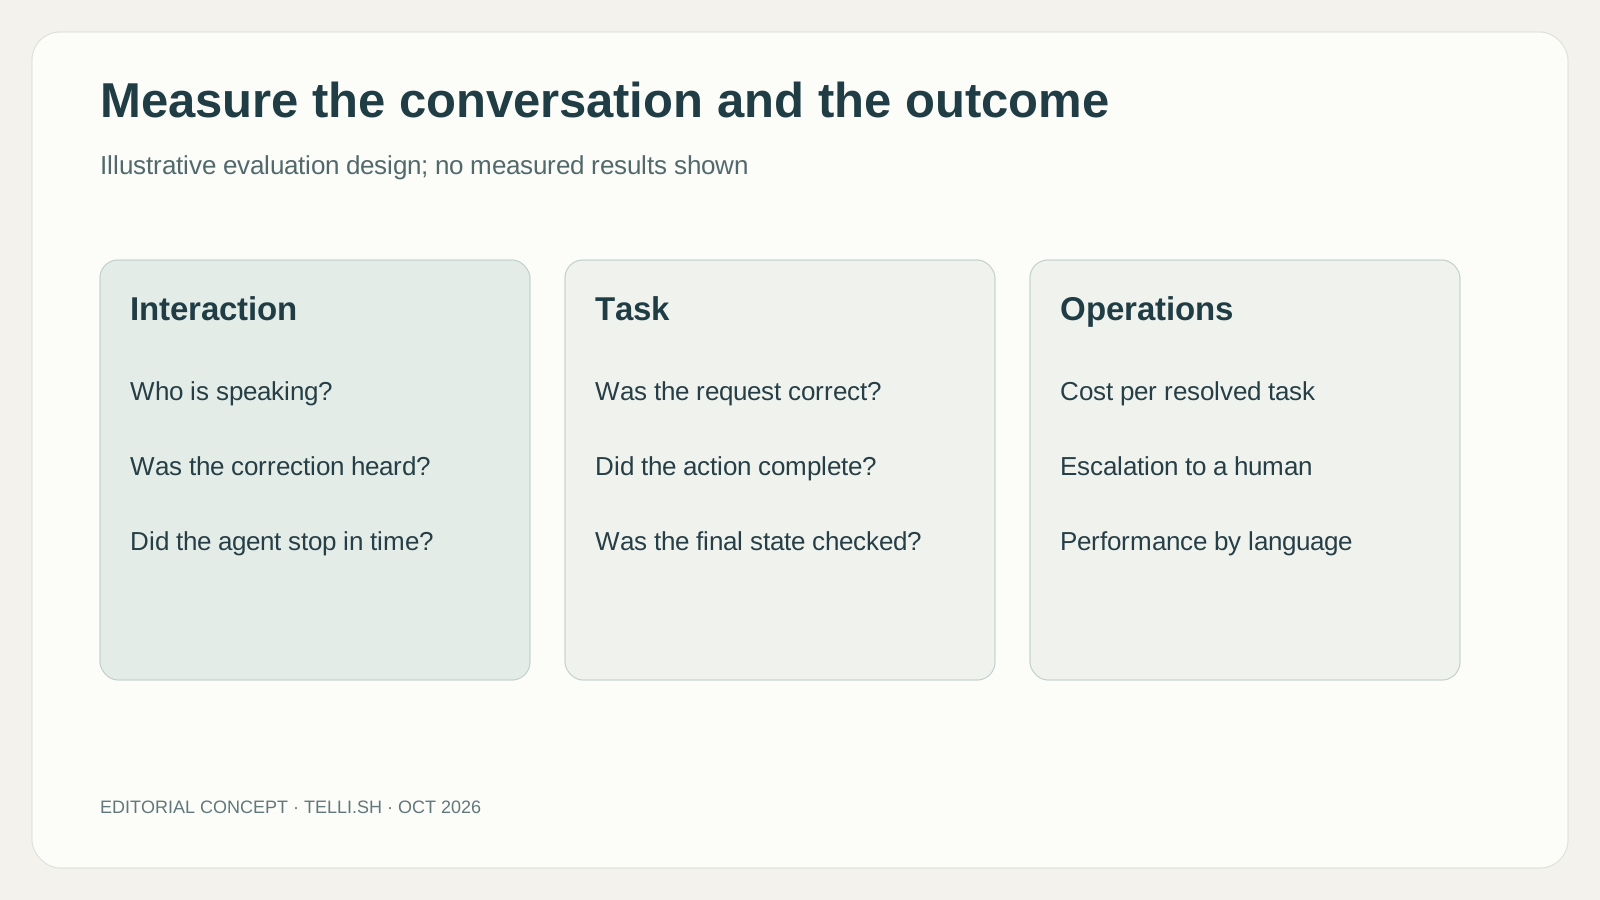
Eigenes redaktionelles Bewertungsmodell. Es werden keine Testergebnisse dargestellt.
Der nächste Benchmark ist ein gelöstes Gespräch
Ein sinnvoller Pilot würde mit Erlaubnis repräsentative Gespräche verwenden: kurze und lange Anfragen, Unterbrechungen, Korrekturen, verschiedene Sprachen und Eskalationsfälle. Prüfen Sie, ob die beabsichtigte Aktion erfolgt ist, wie oft Menschen eingreifen mussten und was die abgeschlossene Interaktion gekostet hat. Die Zeit bis zum ersten Ton bleibt ein Messwert; zählen Sie aber auch schnelle Antworten, die später korrigiert werden mussten. Das beschreibt eine vorgeschlagene Bewertung und keine von uns durchgeführten Realtime-Tests.
Am vielversprechendsten wäre ein Agent, der weniger unnötige Fragen stellt und trotzdem die notwendige Frage stellt. Ein Tutor sollte Lernende ausdenken lassen. Ein Buchungsassistent sollte das korrigierte Datum prüfen. Ein Supportagent sollte den Kontext übergeben. Diese Verbesserungen klingen bescheiden, verändern die Erfahrung aber erheblich: Sie beseitigen die kleinen Reibungen, die automatisierte Gespräche anstrengend machen.
Eleven Realtime gibt dieser Richtung eine konkrete Produktform. Mehr Teams könnten nützliche Sprachinteraktionen entwickeln, ohne jede Komponente der Audioarchitektur beherrschen zu müssen. Langfristig entscheidet, ob integriertes Gesprächsverhalten auch zuverlässig abgeschlossene Arbeit liefert. Die Stimme bringt den Menschen ins Gespräch. Das Ergebnis entscheidet, ob er das nächste führen möchte.
Quellen
-
Ankündigung von Eleven Realtime und Benchmarkkontext, 20. Oktober 2026.
-
Realtime-Modellmodi, Einführung und Einschränkungen, geprüft am 21. Oktober 2026.
-
Hintergrund zu den ElevenLabs-Plattformen, geprüft am 21. Oktober 2026.
-
OpenAI-Architekturen für Sprachagenten, geprüft am 21. Oktober 2026.
-
LiveKit-Gesprächssteuerung, geprüft am 21. Oktober 2026.
Bewahren Sie das Gespräch für die spätere Prüfung auf
Wenn Sie autorisierte Aufnahmen und Ihre geprüften Notizen an einem eigenen Ort aufbewahren möchten, ist Telli.sh eine Möglichkeit. Mit einer Audionotiz beginnen.