Blocks Dessa fragt, was ein Sprachmodell lernen kann, bevor es liest
Dessa ist Blocks ausschließlich mit Sprache trainierte Forschungsvorschau. Die Vollduplex-Demos werfen Fragen zu Gesprächszeitpunkt, Genauigkeit und Aussagekraft auf.
Sagen Sie „Das ist in Ordnung“ erleichtert und anschließend mit einer langen Pause und flacher Stimme. Die Wörter bleiben gleich. Das Gespräch verändert sich.
Block stellte Dessa am 23. Oktober 2026 als Modell vor, das aus menschlichen Gesprächen ohne Text und ohne vortrainiertes Modell gelernt habe. Das Unternehmen hinter Square und Cash App beschreibt ein Vollduplex-Sprachsystem: Es kann während des Sprechens zuhören. Die Veröffentlichung ist eine Forschungsvorschau mit öffentlichen Aufnahmen und begrenztem Zugang für Sicherheitsforscher, keine allgemein verfügbare Sprach-API.
Interessant ist, was geschieht, wenn zeitlicher Verlauf und stimmlicher Ausdruck von Anfang an zum Lernmaterial gehören. Dieser Beitrag erklärt die Unterscheidung, schlägt eine konkrete Art vor, die Demos anzuhören, und betrachtet drei Aufgabenfelder, in denen Gesprächsverhalten zählt. Unsere Einschätzung: Das nächste nützliche Sprachsystem muss den Raum zwischen den Wörtern ebenso sorgfältig behandeln wie die Wörter selbst.
Titelbild: eine eigene redaktionelle Illustration von Sprache und Gesprächszeitpunkt. Sie zeigt weder eine Dessa-Installation noch eine gemessene Audiospur.
Sprache enthält Informationen, die ein sauberes Transkript verlieren kann
Ein Transkript macht ein Gespräch durchsuchbar, zitierbar und überprüfbar. Es gibt der lesenden Person aber meist eine schmalere Darstellung als die Originalaufnahme. Betonung, Pausen, Überlappungen und nichtsprachliche Laute können beeinflussen, wie ein Satz zu verstehen ist.
Betrachten wir eine beispielhafte Terminabsprache. Jemand sagt „Donnerstag passt“ und ergänzt sofort „Moment, nach dem Mittagessen“. Ein hilfreicher Assistent muss die Korrektur bewahren und darf den ersten Teilsatz nicht als abgeschlossenen Auftrag behandeln. Ihr Zeitpunkt zählt, weil das System möglicherweise bereits eine Antwort vorbereitet.
Ein kurzes Signal wie „Mhm“ kann „Ich höre noch zu“ bedeuten, nicht „Jetzt möchte ich sprechen“. Ein System, das jeden Laut als vollständigen neuen Gesprächsbeitrag behandelt, macht den Austausch anstrengend. Ignoriert es jede kurze Unterbrechung, kann es eine echte Korrektur übersehen.
Das ist das Problem des Gesprächsrhythmus: Wann soll man fortfahren, warten, bestätigen oder das Wort abgeben? Eine ausdrucksvollere synthetische Stimme löst es allein nicht. Das System muss auch über den Verlauf des Austauschs entscheiden.
Die Forscher hinter Moshi, veröffentlicht 2024, behandelten überlappende Sprache und Einwürfe ausdrücklich als Grenzen segmentierter Abläufe mit abwechselnden Sprecherbeiträgen. Das ist wichtiger Kontext, denn Vollduplex-Dialoge gab es vor Dessa. Das besondere Versprechen in Blocks Ankündigung ist der ausschließlich sprachbasierte Lernansatz. Er sollte getrennt von der allgemeinen Fähigkeit zum gleichzeitigen Hören und Sprechen bewertet werden.
Drei Fragen verhindern die Verwechslung unterschiedlicher Fähigkeiten
„Sprachnativ“ kann verschiedene Dinge bezeichnen: Trainingsdaten, die zwischen Komponenten verarbeitete Information oder den zeitlichen Ablauf einer Interaktion. Fortschritt in einer Dimension löst nicht automatisch die anderen.
Die Tabelle trennt diese Dimensionen. Sie ist eine begriffliche Hilfe zum Lesen von Produktankündigungen, keine Benchmarkrangliste und keine vollständige Darstellung einer Modellimplementierung.
| Frage | Was sie untersucht | Was sie allein nicht belegt |
|---|---|---|
| Womit wurde das Modell trainiert? | Ob Sprache, Text oder beides zum Lernen dienten | Genauigkeit bei einer bestimmten Aufgabe oder Sprache |
| Was wird zur Laufzeit verarbeitet? | Ob Audio direkt zum Modell gelangt oder andere Darstellungen durchläuft | Wie gut Unterbrechungen gehandhabt werden |
| Können Ein- und Ausgabe überlappen? | Ob das System während der Sprachausgabe zuhören kann | Ob es Emotionen oder Absichten richtig versteht |
Blocks Dessa-Seite, geprüft am 27. Oktober 2026, erhebt Ansprüche in allen drei Dimensionen: Lernen nur aus Sprache, Audio-zu-Audio-Interaktion und Vollduplex-Verhalten. Das sind Beschreibungen des Entwicklungsteams. Sie liefern keinen veröffentlichten Qualitätswert für jedes mögliche Nutzergespräch.
Moshi verdeutlicht den Nutzen der Trennung. Das Papier beschreibt ein Vollduplex-System für Sprache und Text auf Basis eines Textsprachmodells. Es verfolgt also einen anderen Lernweg als der für Dessa beschriebene und behandelt dennoch überlappende gesprochene Dialoge. Wer jedes Sprachsystem als Transkriptionspipeline bezeichnet, verwischt diesen Unterschied.
Für Produktteams lautet die praktische Frage, welche Dimension für die Aufgabe zählt. Ein durchsuchbares Archiv braucht eine verlässliche Textaufzeichnung. Ein interaktiver Tutor benötigt hilfreiches Feedback und angemessenes Gesprächstempo. Ein Kundenagent braucht zusätzlich Wissen und Berechtigungen, um die Geschäftsaufgabe zu erledigen.
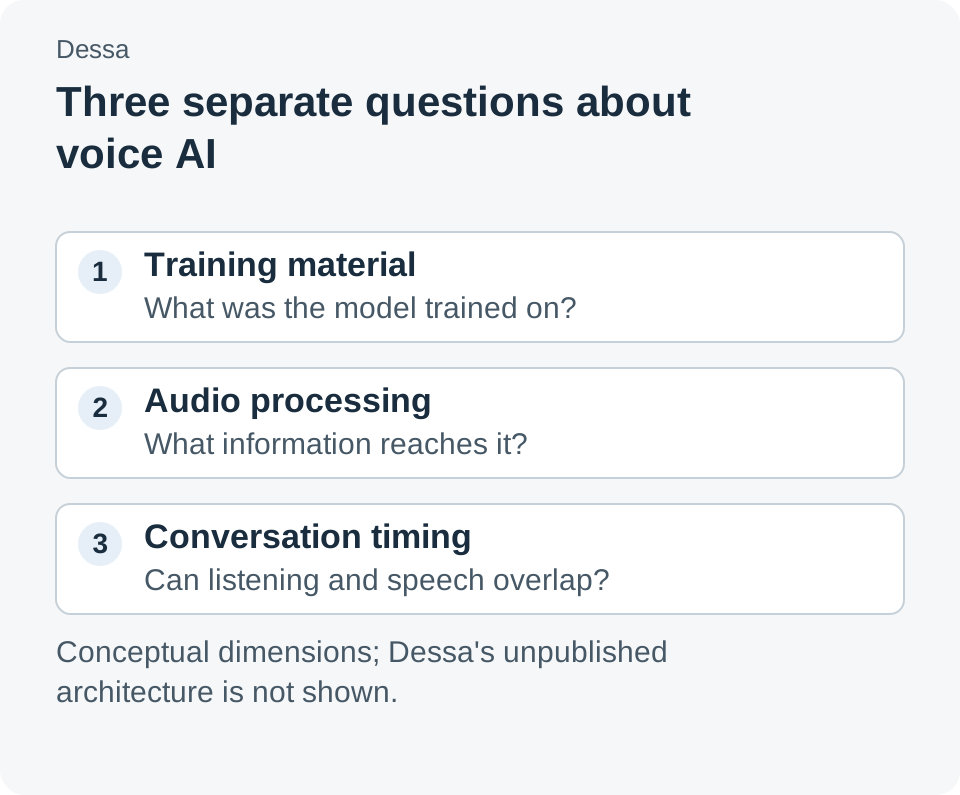
Eigene Erklärungsgrafik. Sie trennt drei Fragen zu Sprachsystemen und behauptet nicht, Dessas unveröffentlichte Architektur offenzulegen. Quellen: Blocks Dessa-Seite und das Moshi-Papier von 2024.
Eine überzeugende Stimme und eine korrekte Antwort brauchen getrennte Tests
Einer ausdrucksvollen Antwort lässt sich leicht folgen. Sie kann aber auch eine unbelegte Aussage überzeugender klingen lassen. Wer sich vom System verstanden fühlt, hält womöglich seltener inne, um ein Detail zu prüfen.
Deshalb brauchen empfundene Empathie, sachliche Genauigkeit und Aufgabenerfüllung eigene Kriterien. Eine freundliche Bestätigung kann passen, obwohl Informationen für eine Antwort fehlen. Besser ist dann häufig eine klare Frage zum richtigen Zeitpunkt als eine emotional geschliffene Vermutung.
Stellen Sie sich ein beispielhaftes Supportgespräch über ein verspätetes Paket vor. Der Anrufer klingt verärgert und unterbricht, um eine Bestellnummer zu korrigieren. Ein nützliches System lässt die Korrektur zu, behält die richtige Kennung und erklärt die nächste mögliche Handlung. Ein warmer Ton repariert weder eine falsche Abfrage noch ein unbefugtes Versprechen.
Dasselbe gilt bei Unsicherheit. Eine Pause kann Zögern, Wortsuche, eine Ablenkung im Raum oder das Ende eines Beitrags bedeuten. Audio liefert Hinweise, ihre Bedeutung bleibt kontextabhängig. Eine sinnvolle Bewertung sollte Rückfragen belohnen, wenn das Signal mehrdeutig ist.
Block lädt eine begrenzte Gruppe von Sicherheitsforschern ein, Dessas Verhalten zu untersuchen. Das beschreibt den gegenwärtigen Entwicklungsstand hilfreich. Es belegt nicht, dass das System bereits die Zuverlässigkeitsanforderungen von Kundenservice, Bildung oder anderen Einsatzfeldern erfüllt.
Die offiziellen Demos sind eine Hörübung, keine Ergebnistabelle
Die öffentliche Dessa-Seite enthält ausgewählte Gesprächsaufnahmen, unter anderem zur Veröffentlichung und zu Filmerinnerungen. Nach Unternehmensangaben wählt das Modell seine Antworten selbst; Untertitel wurden nachträglich ergänzt. Die Aufnahmen zeigen Verhaltensbeispiele, aber nicht deren Häufigkeit in einer breiten Testsammlung.
Hören Sie zuerst auf den zeitlichen Verlauf, bevor Sie die Untertitel lesen. Wann beginnt die Antwort? Unterstützt eine Bestätigung den menschlichen Beitrag oder konkurriert sie damit? Gibt das System der Person Raum, sich zu korrigieren?
Prüfen Sie danach den Inhalt. Sachbehauptungen müssen unabhängig von der Qualität des Vortrags beurteilt werden. Eine Antwort kann hervorragend getaktet sein und dennoch eine Korrektur benötigen. Getrennte Urteile verhindern, dass eine angenehme Demo Belege für eine Aufgabe ersetzt.
Achten Sie zuletzt auf die Erholung nach Missverständnissen. Eine Korrektur durch den Sprecher ist besonders aufschlussreich. Klärt der Austausch das Problem, oder hält das System an der ursprünglichen Deutung fest? Ein einzelner Erfolg belegt keine Quote, hilft aber beim Entwurf einer späteren Evaluation.
Die Übung hat eine klare Grenze: Eine ausgewählte Aufnahme gibt Ihnen keine Kontrolle über Prompt, Umgebung oder Wiederholungen. Nutzen Sie sie, um Fragen für einen Versuch zu formulieren, nicht um sämtliche Einführungsfragen vorab zu beantworten.
Drei mögliche Anwendungen zeigen, warum der Zeitpunkt zählt
Die folgenden Szenarien illustrieren mögliche Anwendungen von Gesprächsfähigkeiten. Sie sind weder angekündigte Dessa-Kundeneinsätze noch Aussagen darüber, dass die Vorschau benötigte Integrationen unterstützt. Jedes trennt interessantes Verhalten von der Arbeit, die es verlässlich machen müsste.
Ein Partner für Sprachübungen könnte davon profitieren, während des Zögerns eines Lernenden zu warten und gelungene Selbstkorrekturen zu bestätigen. Die Bewertung muss hilfreiche Ermutigung von störenden Unterbrechungen unterscheiden. Ein Versuch braucht außerdem klare Belege für die Zielsprache, Korrekturqualität und den Umgang mit wiederholten Fehlern. Eine natürlich klingende englische Demo beantwortet das nicht.
Ein Assistent für mündliche Proben könnte Präsentationen oder schwierige Gespräche üben helfen. Er sollte Gedanken zu Ende sprechen lassen, nachfragen und geänderte Anweisungen aufnehmen. Das Produktteam muss festlegen, ob Übung, Feedback oder sachliche Anleitung das Ziel ist, denn dafür gelten unterschiedliche Bewertungsmaßstäbe.
Eine Oberfläche zur Service-Vorsortierung könnte die Schilderung eines Anrufers hören, klären und Korrekturen bewahren, ohne den Austausch neu zu starten. Schwierig ist die Verbindung zum richtigen Fall und zur passenden nächsten Handlung. Wissenszugriff, Authentifizierung, Eskalation und Transaktionsrechte bleiben eigene Systemverantwortlichkeiten.
Die Beispiele teilen ein Muster: Flüssigere Gespräche können den Weg zur nächsten Entscheidung erleichtern. Der Nutzen hängt davon ab, ob diese Entscheidung hilft und korrigierbar bleibt. Unterbrechungsbehandlung und Erholung sind damit praktische Produktanforderungen, keine Nebensachen einer Sprachdemo.
Lokale Ausführung ist eine Hardwareaussage mit Zugangsbedingung
Block zufolge läuft Dessa lokal auf einem MacBook Pro M4 Max oder besser; trainiert wurde mit einem NVIDIA GB200 NVL72. Beide Angaben stammen von der offiziellen Projektseite, abgerufen am 27. Oktober 2026. Es sind Entwicklerangaben, keine Messungen unserer eigenen Installation.
Training und Inferenz sind hier zu unterscheiden. Eine Trainingsmaschine und ein Rechner, der ein fertiges Modell ausführt, beantworten verschiedene Fragen. Die Trainingshardware ist keine Verbraucheranforderung, und die Laptopaussage ist keine veröffentlichte Tabelle zu Speicherbedarf und Latenz.
Der Zugang ist nochmals ein eigener Punkt. Die öffentliche Seite kennzeichnet Startlinks weiterhin als demnächst verfügbar und beschreibt frühen Zugang für ausgewählte Sicherheitsforscher. Allgemeine API-Preise, herunterladbare Modellgewichte oder eine unterstützte Sprachliste für Produktionsplanung fehlen dort.
Für künftige Entwicklung reicht das, um relevante Fragen zu verfolgen. Für den Terminplan einer Migration vom bestehenden Sprachstack reicht es nicht. Dafür wären nutzbare Artefakte, Integrationsdetails, Messungen auf der vorgesehenen Hardware und eine klare Unterstützung nötig.
Eine Evaluation muss auch Stille und Korrekturen enthalten
Wenn ein breiterer Versuch möglich wird, beginnen Sie mit Aufgaben, deren richtige Ergebnisse sich leicht prüfen lassen. Nutzen Sie dieselben Szenarien für verschiedene Systeme und bewahren Sie mit Einverständnis der Beteiligten das Audio auf, das strittige Urteile verständlich macht. Das folgende Verfahren ist ein Evaluationsvorschlag, kein für diesen Beitrag durchgeführtes Experiment.
- Das gewünschte Ergebnis definieren. Notieren Sie bei Terminabsprachen Datum und Uhrzeit, bei Proben das verlangte Feedback. „Klingt menschlich“ sollte nicht das einzige Gesamtziel sein.
- Szenariopaare schreiben. Halten Sie die Kernanfrage ähnlich und verändern Sie nur ein Ereignis: Pause, Bestätigung, Unterbrechung oder ausdrückliche Korrektur. Fehlerursachen lassen sich so besser besprechen.
- Eine Korrekturanweisung einbauen. Lassen Sie ein früheres Detail ändern. Prüfen Sie, ob die Endantwort die Korrektur enthält und der Verlauf die Änderung deutlich macht.
- Timing und Inhalt getrennt bewerten. Erfassen Sie unpassende Unterbrechungen, übersehene Korrekturen und unbelegte Fakten getrennt. Ein Gesamtwert kann wichtige Schwächen verdecken.
- Die vorgesehene Umgebung testen. Wiederholen Sie repräsentative Aufgaben auf den tatsächlichen Geräten und mit dem geplanten Audioaufbau, sobald der Zugang es erlaubt. Ein ruhiger Mikrofontest gilt für diesen Aufbau, nicht für jeden Raum und jedes Headset.
- Uneinigkeit anhand der Aufnahme prüfen. Spielen Sie bei abweichenden Urteilen den Moment erneut ab und präzisieren Sie die Kriterien. Die Uneinigkeit kann eine unklare Aufgabenbeschreibung statt eines einfachen Modellfehlers offenlegen.
Eine beispielhafte erste Sammlung könnte zwölf Szenarien enthalten: vier mit Pausen, vier mit Korrekturen und vier mit kurzen Bestätigungen. Diese Zahlen sind ein Startvorschlag, keine Aussage über wissenschaftliche Ausreichendheit und kein veröffentlichter Dessa-Benchmark. Vor einer Vergrößerung sollen unterschiedliche Gesprächsanforderungen sichtbar werden.
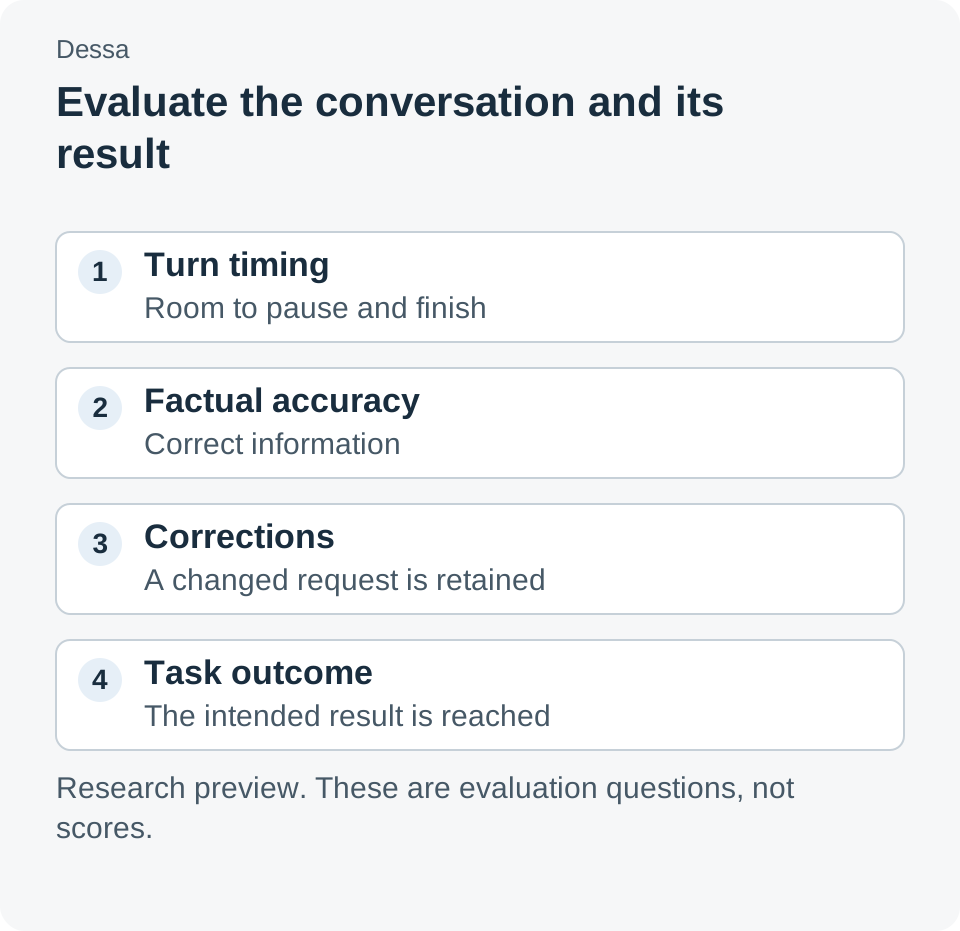
Eigener Evaluationsleitfaden. Er impliziert weder Erfolgsquote noch Latenzmessung oder vergleichenden Modellwert.
Eine Sprachoberfläche sollte Korrekturen selbstverständlich machen
Die nützlichste Aussicht dieser Forschungsrichtung besteht nicht darin, jeden Assistenten ununterscheidbar menschlich zu machen. Menschen könnten weniger Mühe darauf verwenden müssen, ihre Sprache an eine starre Oberfläche anzupassen. Pausen, Unterbrechungen und unvollendete Gedanken gehören zum normalen Sprechen.
Dessa gibt dieser Möglichkeit einen konkreten Forschungsgegenstand: ein Modell, das nach Angaben seiner Entwickler allein durch Sprache gelernt hat. Als Nächstes ist zu fragen, ob das Verhalten in tatsächlich benötigten Situationen trägt. Eine gute Sprachoberfläche erleichtert Fortsetzen, Klären und Korrigieren und hält gleichzeitig die Aufgabe verständlich.
Quellen
- Block: Dessa — offizielle Forschungsbeschreibung, Demos, Hardwareangaben und Zugangsstatus; geprüft am 27. Oktober 2026.
- Block-Nachrichten — Ankündigung vom 23. Oktober 2026.
- Défossez und Kollegen: Moshi, a speech-text foundation model for real-time dialogue — Primärforschung von 2024 zu Vollduplex-Dialogen mit Sprache und Text.
Quellenstand: 27. Oktober 2026. Produktdetails werden den jeweiligen Herausgebern zugeschrieben. Szenarien und Prüfschritte sind Beispiele; wir haben Dessa weder installiert noch seine Leistung gemessen. Die offiziellen Aufnahmen finden Sie auf der verlinkten Projektseite.
Eine Empfehlung von Telli.sh
Sie möchten Aufnahmen, Referenznotizen und die Entscheidungen nach einem Gespräch durchsuchbar ablegen? Bündeln Sie Ihre Referenzunterlagen in Telli.sh und halten Sie Übergaben nachvollziehbar.