DeepSeek V4.1 Flash 1017: crie seu primeiro projeto e depois conecte a API
Comece com um projeto funcional no navegador, conecte o DeepSeek Flash no Windows, Mac ou Linux e entenda a atualização de 17 de outubro, raciocínio, visão, custos e limites.
Um modelo de programação se torna útil quando aquilo que ele escreve realmente funciona. Comece por aí: um aplicativo pequeno que você possa abrir, inspecionar e aprimorar, em vez de um prompt gigantesco pedindo uma empresa inteira.
A DeepSeek lançou o V4.1 Flash em 10 de setembro de 2026; em 17 de outubro veio a atualização 1017, não o primeiro lançamento do V4.1. A atualização está disponível no site, aplicativo e API da DeepSeek, e o ID do modelo na API continua sendo deepseek-flash. Registro de atualizações datadas da DeepSeek
Este guia leva você de um primeiro projeto no navegador a um fluxo de desenvolvimento repetível e, depois, à configuração da API no Windows, macOS e Linux. Em seguida, explicaremos a arquitetura, os benchmarks do fornecedor, o custo dos tokens e os limites práticos que importam antes de dar uma tarefa maior a um agente.
Imagem de abertura: ilustração explicativa original que mostra especificação, construção, inspeção e revisão. Ela representa um fluxo de trabalho, não uma captura de tela do produto DeepSeek.
Tenha um primeiro resultado antes de instalar qualquer coisa
Abra o chat web da DeepSeek ou o aplicativo oficial e inicie uma conversa. Neste primeiro exercício, use informações inventadas. Um serviço público de IA não é o lugar para descobrir que seu arquivo de exemplo contém uma lista de clientes ou um token de acesso.
Nosso primeiro projeto é uma fila de leitura: uma página pequena com artigos que você quer ler. Ela não precisa de conta, banco de dados na nuvem nem chave de API. O exemplo a seguir é um exercício ilustrativo, não o relato de uma execução concluída do modelo.
-
Peça o menor artefato completo com este prompt:
Texto simplesBuild a reading queue as one self-contained index.html file. Use plain HTML, CSS and JavaScript, with no libraries or network calls. Include three fictional example articles, a title filter, and a read/unread toggle. Keep state in memory; reloading should reset it. Use accessible labels and make the layout work at 360px wide. Return the complete file, followed by five manual acceptance checks. Do not add login, analytics, remote fonts or a backend. -
Coloque o arquivo gerado em uma pasta nova e vazia e abra
index.htmlno navegador. Antes de abrir código gerado desconhecido, verifique se há requisições de rede ou scripts inesperados. Este exercício não deve exigir comando de terminal, dependência baixada nem pedido de permissão. -
Confira o comportamento você mesmo: filtre por parte de um título, alterne um artigo, remova o filtro, reduza a largura da janela e recarregue. A alternância deve sobreviver ao filtro, mas voltar ao estado inicial após recarregar, pois esse era o escopo solicitado.
-
Envie um relato de falha concreto: “O filtro esconde todas as linhas quando a busca termina com espaços. Remova os espaços excedentes da busca, preserve os outros comportamentos e devolva o arquivo revisado.” Execute as mesmas verificações novamente.
Esse é um primeiro sucesso que você consegue reconhecer. “Parece bom” é subjetivo; “a alternância ainda funciona depois do filtro” é um critério de aceitação. Manter o primeiro projeto deliberadamente pequeno também facilita saber se uma revisão corrigiu o problema ou apenas mudou a aparência.
A atualização de outubro é sobre concluir projetos, não apenas escrever trechos de código
A DeepSeek afirma que a versão 1017 usa aprendizado por reforço com autorreflexão para melhorar o desenvolvimento de projetos de ponta a ponta. O anúncio mostra quatro exemplos: modelagem 3D da Cidade Proibida, um jogo de corrida na web, uma recriação em Godot inspirada em Portal 2 e Valley of Ages, uma cena 3D que atravessa eras históricas. Consulte as demonstrações oficiais de projetos para ver esses exemplos; são demonstrações do fornecedor, não resultados garantidos para qualquer prompt.
Eis a distinção importante: treinar com autorreflexão é uma afirmação sobre o desenvolvimento do modelo, enquanto o feedback do seu projeto vem da execução do software. Uma resposta no chat não executa seu navegador, inspeciona seu repositório nem verifica a compilação de um jogo só porque o modelo aprendeu com feedback durante o treinamento. Essas ações exigem um ambiente e ferramentas.
Pense no processo como um ciclo do projeto: especificar, implementar, verificar, revisar. Na nossa opinião, esse ciclo importa mais do que o tamanho da primeira resposta gerada. Uma alteração compacta que passa por uma verificação de aceitação é mais útil do que um repositório impressionante que ninguém iniciou.
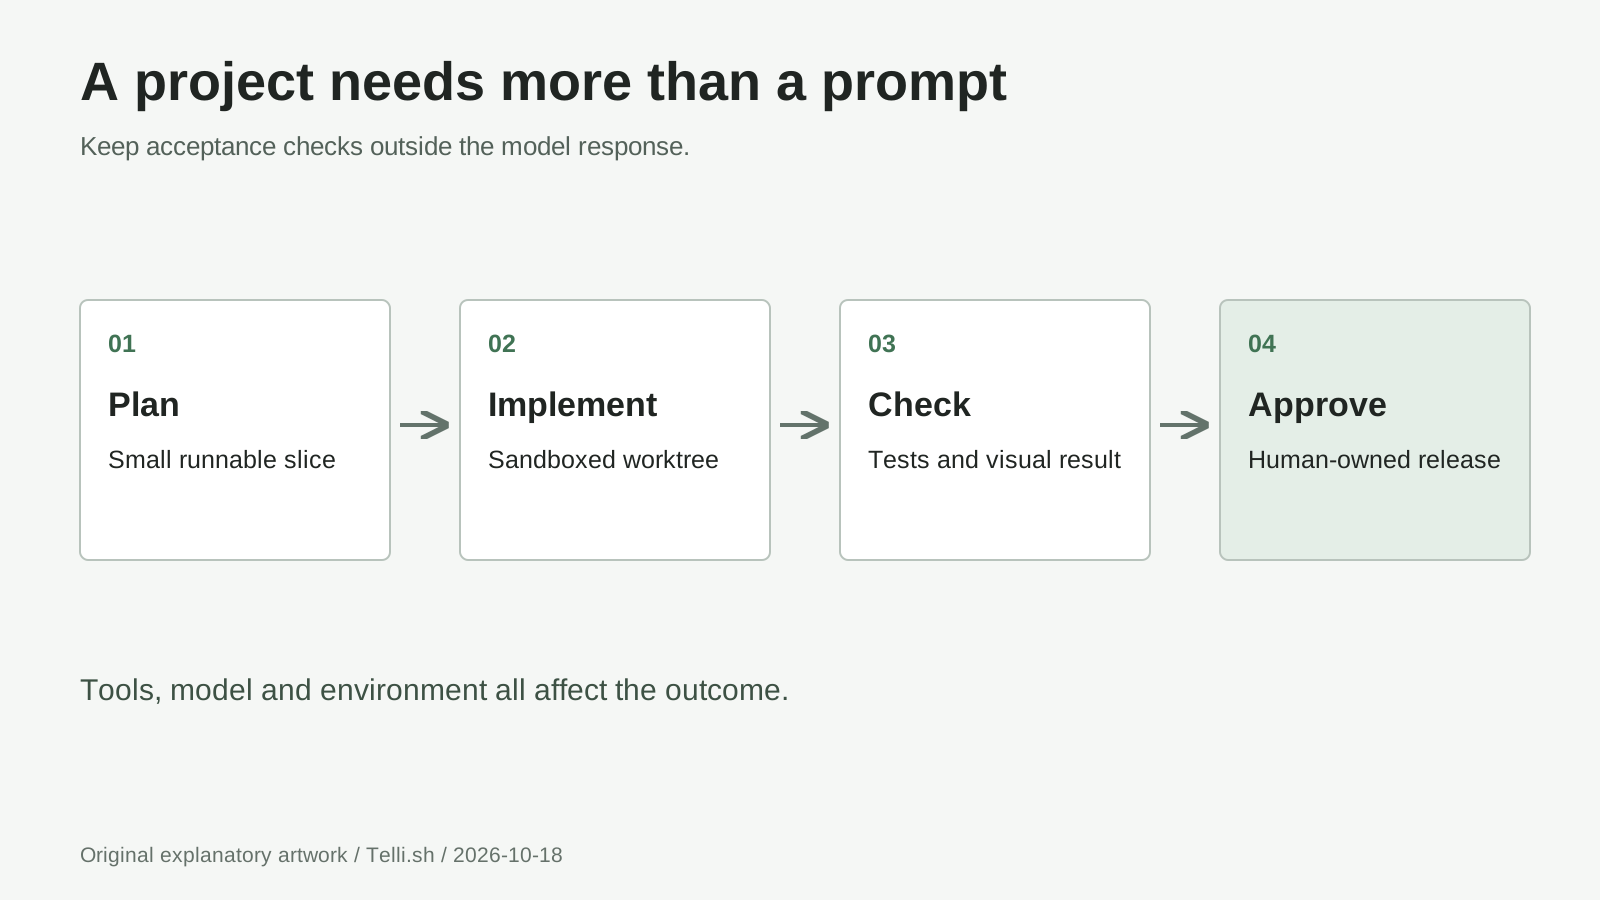
Diagrama original: as verificações de aceitação e a aprovação de lançamento continuam fora da resposta do modelo. As ferramentas e o ambiente de execução determinam o que realmente pode ser verificado.
Transforme a fila de leitura em um projeto com objetivo definido
Na segunda iteração, imagine uma fila de leitura para um pequeno grupo de estudos. Os participantes precisam adicionar links, marcar artigos como lidos e exportar a fila. Mantenha esta versão para uma pessoa e restrita ao navegador; colaboração e sincronização são projetos separados.
-
Escreva o contrato. Exija título, URL e estado de leitura; rejeite links inválidos; preserve os itens após recarregar; exporte um arquivo JSON. Especifique o que deve acontecer quando não houver itens, quando o título for longo e quando um arquivo importado estiver malformado. Deixe autenticação e armazenamento em servidor de fora.
-
Peça um plano antes das alterações. Solicite que o modelo identifique os arquivos necessários, a abordagem de armazenamento e os testes propostos. Forneça uma pasta limpa ou uma worktree isolada. Não comece entregando seu diretório pessoal, credenciais de produção ou permissão para instalar qualquer software.
-
Implemente uma fatia vertical por vez. Adicione um artigo, persista-o e recarregue. Depois, acrescente filtragem, seguida de exportação e importação. Cada incremento deve continuar executável, para que uma função de exportação quebrada não se misture a uma migração de armazenamento e a uma reformulação sem relação.
-
Forneça evidências como feedback. Informe o erro exato, a entrada e o comportamento esperado. Para um problema de layout, anexe uma captura recortada sem informações privadas. Peça uma correção restrita e repita as mesmas verificações, em vez de aceitar uma reescrita completa a cada tentativa.
-
Aprove uma versão candidata. Teste a navegação pelo teclado, a fila vazia, links duplicados e um título longo. Exporte, limpe a fila de teste, importe e confirme que os campos sobreviveram à ida e volta. Guarde uma cópia conhecida como funcional antes de aceitar outra revisão.
O modelo também pode ajudar a escrever um plano de testes antes da implementação. Por exemplo, peça que descreva a estrutura JSON esperada e identifique quais campos o importador deve validar. Depois, compare a implementação com esse plano. Assim, a promessa fica separada do código e as divergências ficam visíveis.
Um harness de projeto oferece edição de arquivos, execução de comandos e outras ferramentas em torno do modelo. Para a versão 1017, a DeepSeek recomenda Harness v0.2.1-rc.1 ou posterior no anúncio de lançamento. Siga o guia oficial do Harness para instalar; não presuma que fazer uma requisição à API de chat crie um agente de programação.
Conecte a API sem colocar um segredo na sua página web
Use a API quando seu próprio programa precisar de respostas do modelo. A fila de leitura pode continuar sendo um aplicativo local no navegador; o script a seguir é um auxiliar de desenvolvimento separado, executado no terminal. Nunca incorpore sua chave DeepSeek em index.html, no JavaScript do navegador nem em um repositório público.
1. Crie uma chave de API e escolha uma tarefa pequena
Crie uma chave na plataforma da API DeepSeek e confira o saldo da conta. O guia da primeira chamada documenta a URL base compatível com OpenAI https://api.deepseek.com e o modelo deepseek-flash. Uma conta do chat web não torna ilimitado o uso pago da API.
Na primeira solicitação, peça critérios de aceitação em vez de um repositório inteiro. Assim, a saída fica fácil de inspecionar e a quantidade gerada é limitada caso haja um erro de configuração.
2. Prepare o Python no seu sistema operacional
Instale Python 3, caso ainda não esteja disponível. Em uma pasta de projeto nova, crie um ambiente isolado e instale o SDK. Estes comandos invocam diretamente o interpretador do ambiente, portanto não é preciso ativar scripts nem alterar a política de execução do PowerShell. O procedimento segue a documentação de ambientes virtuais do Python.
Windows, PowerShell:
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade openai
Se py não estiver disponível, mas python --version identificar sua instalação Python 3, use python -m venv .venv no primeiro comando.
macOS, Terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Linux, terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Algumas distribuições Linux empacotam venv separadamente. Se a criação do ambiente informar que ele está ausente, instale o pacote de ambiente virtual Python documentado pela sua distribuição e tente novamente. Não resolva um problema de ambiente isolado com sudo pip install em todo o sistema.
3. Crie um auxiliar para o terminal
Crie first_request.py ao lado de .venv com o exemplo a seguir. Ele usa uma solicitação oculta de chave por meio do módulo getpass do Python, em vez de gravar o segredo no código-fonte ou no histórico do shell. Execute-o em um terminal normal que aceite entrada oculta.
from getpass import getpass

from openai import OpenAI

client = OpenAI(
    api_key=getpass("DeepSeek API key: "),
    base_url="https://api.deepseek.com",
    timeout=120.0,
    max_retries=0,
)

reply = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": (
            "Propose five manual acceptance checks for a browser-only "
            "reading queue with filtering, read status and JSON export. "
            "Return checks only; do not claim to have executed them."
        ),
    }],
    max_tokens=2048,
    stream=False,
    extra_body={"thinking": {"type": "disabled"}},
)

print(reply.choices[0].message.content)
print("Finish reason:", reply.choices[0].finish_reason)
print("Usage:", reply.usage)
4. Execute e inspecione a resposta
No Windows, execute \.venv\Scripts\python.exe first_request.py. No macOS ou Linux, execute ./.venv/bin/python first_request.py. Cole a chave quando solicitado; o resultado esperado é uma lista de verificações, um motivo de conclusão e informações de uso, não arquivos de projeto criados.
Se a solicitação falhar, examine o status antes de tentar novamente. Um 401 diz respeito à autenticação, 402 a saldo insuficiente e 429 a um limite; a DeepSeek documenta esses casos no guia de códigos de erro. Um motivo de conclusão length significa que a resposta atingiu um limite, portanto não comprova que esteja completa. Faça novas tentativas deliberadamente enquanto aprende a usar a API.
Raciocínio, visão e ferramentas web têm funções diferentes
O modo de raciocínio vem ativado por padrão, com esforço high. Para uma pergunta de depuração mais difícil, substitua o extra_body do exemplo por {"thinking": {"type": "enabled"}} e acrescente reasoning_effort="high". As opções de esforço documentadas são low, high e max; o modo de raciocínio ignora temperature, portanto reduzi-la não é um atalho para obter raciocínio mais confiável. Guia do modo de raciocínio, consultado em 18 de outubro
O raciocínio também consome o orçamento de geração. Aumente deliberadamente um limite de saída pequeno ao passar de respostas curtas sem raciocínio para raciocínios complexos. Se implementar chamadas de ferramentas no modo de raciocínio, preserve reasoning_content do assistente nas solicitações seguintes que incluírem ferramentas, conforme exige o guia. Não monte a conversa de ferramentas mantendo apenas a resposta final visível.
A visão aceita imagens junto com texto; não é um endpoint de geração de imagens. Em Chat Completions, coloque o conteúdo da imagem em uma mensagem user usando um bloco image_url, uma URL de dados base64 ou o formato documentado da Files API. Há suporte a JPEG, PNG, GIF e WebP. O limite do corpo inline da solicitação é 48 MiB, e cada imagem individual inline ou vinculada externamente tem limite de 32 MiB. Guia de visão
Para a fila de leitura, envie uma captura de tela sem dados pessoais e pergunte quais rótulos se sobrepõem em uma largura estreita. Trate isso como um diagnóstico para conferir no navegador, não como prova de que o layout foi corrigido. Entender imagens também não dá à API permissão para mover seu mouse ou modificar arquivos.
Search encontra páginas; Fetch recupera uma página como Markdown. Os endpoints independentes são POST /v1/tools/search e POST /v1/tools/fetch, autenticados com a mesma chave bearer. Uma solicitação Search pode usar {"query":"browser storage documentation","count":3}; Fetch usa {"url":"https://developer.mozilla.org/en-US/docs/Web/API/Storage"}. Seu aplicativo precisa chamar esses endpoints explicitamente ou usar uma integração que os forneça. Apenas mencionar uma URL em uma solicitação básica de chat não equivale a esse fluxo. Guia Search e Fetch
Mantenha o conteúdo recuperado separado das instruções. Uma página obtida é evidência, não autorização para executar um comando, revelar uma chave ou alterar um requisito do projeto. Fetch também continua sujeito às políticas de acesso do site de destino; não concede acesso a material privado ou protegido por paywall.
Uma arquitetura ampla pode ativar menos parâmetros sem caber em um laptop
O cartão do modelo V4.1 de setembro descreve uma arquitetura MoE com 552 bilhões de parâmetros, ativando aproximadamente 8 bilhões de parâmetros por token de entrada durante o prefill e 16 bilhões por token de saída durante a decodificação. Seu Causal Encoder-Decoder separa um codificador causal de 20 camadas de um decodificador de 20 camadas. Esses detalhes arquiteturais pertencem ao lançamento-base do V4.1, não a uma arquitetura anunciada em 17 de outubro. Arquitetura do modelo-base e link para o relatório técnico
Em termos simples, prefill processa o prompt existente; decodificação produz a resposta. O roteamento Mixture-of-Experts usa especialistas selecionados, em vez de ativar todos os parâmetros da arquitetura para cada token. A atenção comprimida e o cache compartilhado do modelo tratam do custo de memória de prompts longos. No entanto, menos parâmetros ativos descrevem a computação, não todo o armazenamento e a memória necessários para hospedar o checkpoint.
O contexto anunciado é de um milhão de tokens. Isso é capacidade, não uma exigência de colar um repositório inteiro em toda solicitação nem uma garantia de lembrança perfeita. Comece pela tarefa, pelos arquivos relevantes e pelos erros concretos; amplie o contexto quando uma dependência ou contrato ausente justificar.
Para hospedagem própria, use as instruções oficiais de inferência 1017, que descrevem a conversão do checkpoint e a execução tensor-paralela. O launcher genérico do vLLM na página do Hugging Face não é uma receita de implantação específica para o modelo. Confira hardware, kernels compatíveis e compatibilidade do serviço antes de baixar os pesos. O deepseek-recipe lida com conversão de prompts/protocolos; não fornece inferência nem executa ferramentas. Usuários comuns de laptop devem começar pelo acesso hospedado.
Estime a tarefa inteira, não apenas o token mais barato
Em 18 de outubro de 2026, a DeepSeek lista estes preços do Flash em dólares americanos por um milhão de tokens. Preços oficiais
| Categoria de token | Horário de pico | Fora de pico |
|---|---|---|
| Entrada, falha de cache | $0.30 | $0.15 |
| Entrada, acerto de cache | $0.006 | $0.003 |
| Saída | $1.20 | $0.60 |
Os períodos de pico são 01:00-04:00 e 06:00-10:00 UTC, de segunda a sexta-feira, exceto feriados públicos chineses; todos os demais períodos são fora de pico. Conforme essa programação, os fins de semana são totalmente fora de pico. Use UTC ao agendar, em vez de presumir que o horário diurno local seja caro.
Para uma tarefa ilustrativa com 100.000 tokens de entrada em falha de cache, 200.000 tokens de entrada em acerto de cache e 20.000 tokens de saída, o cálculo no pico é:
(0.1 x $0.30) + (0.2 x $0.006) + (0.02 x $1.20)
= $0.0300 + $0.0012 + $0.0240
= $0.0552
Nas tarifas fora de pico, essas quantidades presumidas custam $0.0276. É um cálculo, não uma fatura de projeto medida. Use o uso real de acertos e falhas de cache, em vez de presumir que o contexto repetido sempre recebe a tarifa menor.
Search e Fetch custam $0.75 por 1.000 solicitações bem-sucedidas que produzam resultados. Assim, 40 buscas faturáveis e 60 consultas Fetch faturáveis acrescentam $0.075, sem contar os tokens do modelo usados para ler os resultados. O período gratuito temporário se aplica a chamadas no lado do servidor pelas integrações DeepSeek nomeadas; a cobrança delas começa em 31 de outubro de 2026, às 16:00 UTC. Não é um período gratuito geral para uso direto dos endpoints. Regras de cobrança das ferramentas
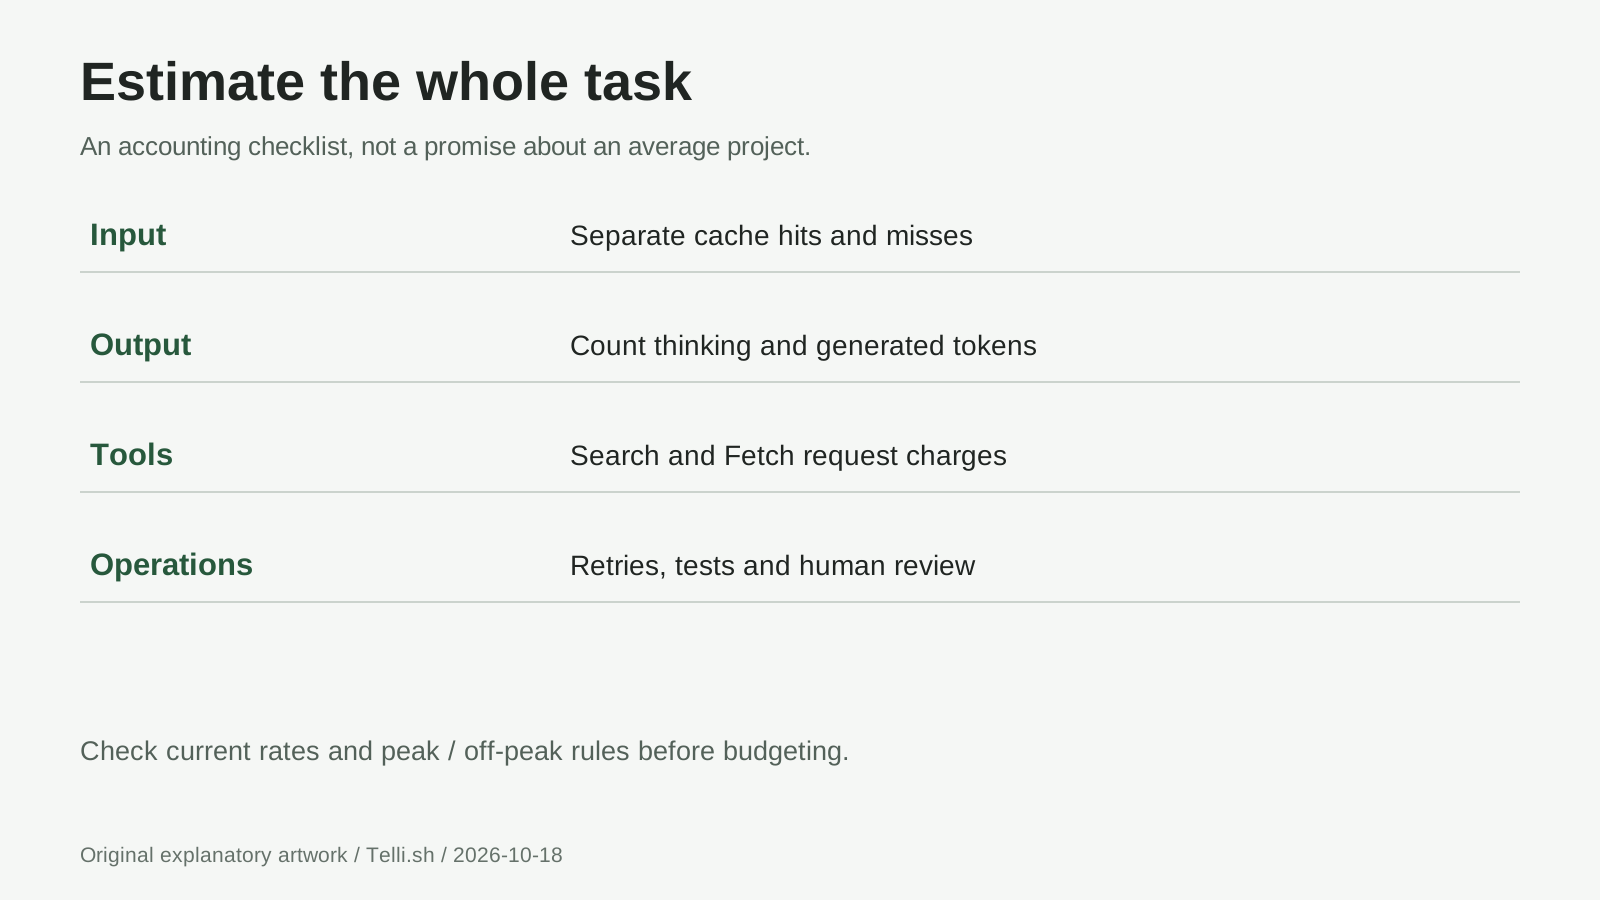
Diagrama original de custos: inclua raciocínio gerado, novas tentativas, chamadas a ferramentas e trabalho de revisão no orçamento. Não implica custo médio de projeto.
Leia os ganhos de benchmark considerando o harness
A DeepSeek relata as seguintes mudanças do V4.1 Flash base para a versão 1017. Estes são resultados informados pelo fornecedor, não resultados independentes deste guia. Comparação no cartão do modelo 1017
| Benchmark | V4.1 Flash | 1017 | Variação |
|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 pontos |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 pontos |
| ProgramBench | 20.3 | 29.1 | +8.8 pontos |
O cartão da versão 1017 especifica Claude Code para Terminal-Bench 4.0 e Mini-SWE-V2 para DeepSWE v1.1. Um harness fornece ferramentas, gerenciamento de contexto e política de execução; mudá-lo altera o experimento. Não trate a diferença entre pontuações em configurações distintas como uma medição pura da capacidade do modelo.
Para fazer sua própria comparação, mantenha fixos o repositório, os critérios de aceitação, as permissões e o orçamento. Registre se o projeto funciona, quantas correções foram necessárias, o uso total e o tempo decorrido. Uma pontuação pública maior ajuda a selecionar um candidato; uma tarefa repetível no seu ambiente decide se ele merece o trabalho.
Perguntas para esclarecer antes de lhe dar uma tarefa maior
1017 é um nome de modelo separado na API?
Não. Use deepseek-flash. O nome datado do checkpoint identifica a atualização, enquanto a API hospedada da DeepSeek mantém o identificador existente. Registre a data e as informações de modelo retornadas quando a reprodutibilidade importar. Documentação da primeira chamada
Pesos MIT tornam a API gratuita?
Não. O cartão do modelo 1017 licencia o repositório e os pesos sob MIT. O uso hospedado tem cobranças separadas. A licença dos pesos também não concede direitos sobre entradas privadas, materiais de terceiros ou mídia de uma demonstração.
Ele consegue criar um jogo completo com um único prompt?
Use as demonstrações oficiais como exemplos de resultados do fornecedor, não como garantias de entrega. Defina movimento, colisão, reinício e condição de conclusão antes de pedir refinamento visual. Um jogo que você consegue inspecionar e jogar novamente é um marco melhor do que uma grande base de código gerada.
Devo sempre usar o raciocínio máximo e todo o contexto?
Não. Comece com uma solicitação delimitada e aumente o esforço ou o contexto quando uma falha específica exigir. Mais raciocínio gerado e prompts maiores consomem recursos; nenhum dos dois substitui critérios de aceitação ou permissões cuidadosas para ferramentas.
Posso publicar imediatamente o trabalho gerado?
Revise primeiro funcionalidade, segurança, licenças de dependências e procedência dos materiais. Remova credenciais de exemplo e inspecione quaisquer requisições remotas. Mantenha a aprovação de implantação separada da permissão para editar um projeto local.
Em resumo: concluir significa que alguém conferiu o resultado
A promessa útil da versão 1017 é concluir projetos com mais qualidade, não deixar de revisá-los. Dê ao modelo um objetivo pequeno, um ambiente delimitado e verificações observáveis. Depois, amplie o projeto somente quando o comportamento atual merecer sua aprovação.
Fontes
Documentação do produto e preços consultados em 18 de outubro de 2026. Afirmações sobre benchmarks e treinamento são atribuídas à DeepSeek; os exercícios são exemplos didáticos, não resultados de uso prático alegados. Os três diagramas são ilustrações explicativas originais. A mídia de demonstrações do fornecedor é referenciada por links, não reproduzida.
- Atualização de 17 de outubro e demonstrações de projetos
- Lançamento-base de 10 de setembro
- Registro de atualizações datadas
- Cartão do modelo 1017, benchmarks e licença MIT
- Arquitetura V4.1 base e relatório técnico
- Primeira chamada à API, raciocínio, visão, Search e Fetch e preços
- Referência oficial de inferência e deepseek-recipe
Deixe o próximo projeto mais fácil de retomar
Recomendação do Telli.sh: mantenha juntos os links das fontes, o resumo do projeto, os prompts e as notas de revisão para que a próxima sessão comece com decisões, não com suposições. O Telli.sh pode organizar esse conhecimento do projeto; não é uma integração com agente de programação da DeepSeek. Crie uma conta no Telli.sh