DeepSeek V4.1 Flash 1017: Erst ein Projekt bauen, dann die API anbinden
Starte mit einem funktionierenden Browserprojekt, verbinde DeepSeek Flash unter Windows, Mac oder Linux und erfahre, was das Update vom 17. Oktober, Thinking, Vision, Kosten und Grenzen bedeuten.
Ein Coding-Modell ist dann nützlich, wenn das Geschriebene tatsächlich funktioniert. Beginne damit: mit einer kleinen Anwendung, die du öffnen, prüfen und verbessern kannst, statt mit einem riesigen Prompt, der gleich ein ganzes Unternehmen verlangt.
DeepSeek hat V4.1 Flash am 10. September 2026 veröffentlicht; am 17. Oktober kam das Update 1017, nicht die erste V4.1-Version. Das Update ist auf DeepSeeks Website, in der App und über die API verfügbar; die API-Modellkennung lautet weiterhin deepseek-flash. Datumsbezogenes DeepSeek-Änderungsprotokoll
Dieser Leitfaden begleitet dich vom ersten Browserprojekt zu einem wiederholbaren Entwicklungsablauf und anschließend durch die API-Einrichtung unter Windows, macOS und Linux. Danach betrachten wir Architektur, Anbieter-Benchmarks, Tokenkosten und praktische Grenzen, die wichtig sind, bevor du einem Agenten einen größeren Auftrag gibst.
Titelgrafik: eigene Erläuterungsgrafik zu Spezifikation, Umsetzung, Prüfung und Überarbeitung. Sie zeigt einen Arbeitsablauf, keinen DeepSeek-Produktscreenshot.
Erziele einen ersten Erfolg, bevor du etwas installierst
Öffne den DeepSeek-Webchat oder die offizielle App und beginne ein neues Gespräch. Verwende für diese erste Übung erfundene Angaben. Ein öffentlicher KI-Dienst ist nicht der richtige Ort, um herauszufinden, ob eine Beispieldatei eine Kundenliste oder einen Zugangsschlüssel enthält.
Unser erstes Projekt ist eine Leseliste: eine kleine Seite mit Artikeln, die du lesen möchtest. Sie braucht weder Konto noch Cloud-Datenbank oder API-Schlüssel. Die folgende Übung ist ein Beispiel, kein Bericht über einen tatsächlich ausgeführten Modelllauf.
-
Bitte mit diesem Prompt um das kleinstmögliche vollständige Ergebnis:
KlartextBuild a reading queue as one self-contained index.html file. Use plain HTML, CSS and JavaScript, with no libraries or network calls. Include three fictional example articles, a title filter, and a read/unread toggle. Keep state in memory; reloading should reset it. Use accessible labels and make the layout work at 360px wide. Return the complete file, followed by five manual acceptance checks. Do not add login, analytics, remote fonts or a backend. -
Lege die generierte Datei in einen neuen, ansonsten leeren Ordner und öffne
index.htmlim Browser. Prüfe unbekannten generierten Code vor dem Öffnen auf unerwartete Netzwerkanfragen oder Skripte. Diese Übung sollte weder Terminalbefehl noch heruntergeladene Abhängigkeit oder Berechtigungsabfrage benötigen. -
Prüfe das Verhalten selbst: Filtere nach einem Teil des Titels, markiere einen Artikel als gelesen, entferne den Filter, verkleinere das Fenster und lade die Seite neu. Der Status sollte den Filtervorgang überstehen, aber beim Neuladen zurückgesetzt werden, wie verlangt.
-
Melde einen konkreten Fehler zurück: „Bei einem Leerzeichen am Ende der Suchanfrage verschwinden alle Zeilen. Entferne Leerzeichen am Anfang und Ende, erhalte das übrige Verhalten bei und gib die überarbeitete Datei zurück.“ Führe dieselben Prüfungen erneut aus.
Das ist ein erster Erfolg, den du erkennen kannst. „Sieht gut aus“ ist subjektiv; „der Schalter funktioniert nach dem Filtern noch“ ist ein Abnahmekriterium. Das bewusst kleine erste Projekt macht es außerdem einfacher zu erkennen, ob eine Überarbeitung den Fehler behoben oder nur das Aussehen verändert hat.
Beim Oktober-Update geht es darum, Projekte abzuschließen, nicht nur Snippets zu schreiben
DeepSeek zufolge nutzt 1017 Reinforcement Learning mit Selbstfeedback, um die durchgängige Projektentwicklung zu verbessern. Die Ankündigung zeigt vier Beispiele: 3D-Modellierung der Verbotenen Stadt, ein Web-Rennspiel, eine von Portal 2 inspirierte Godot-Neuimplementierung und Valley of Ages, eine 3D-Szene durch verschiedene Geschichtsepochen. Sieh dir die offiziellen Projektbeispiele an. Es sind Demos des Anbieters, keine zugesicherten Ergebnisse für beliebige Prompts.
Wichtig ist die Unterscheidung: Selbstfeedback beim Training ist eine Aussage über die Modellentwicklung; Feedback zu deinem Projekt entsteht durch das Ausführen der Software. Eine Chatantwort führt nicht deinen Browser aus, prüft nicht dein Repository und bestätigt keinen Spiel-Build, nur weil das Modell während des Trainings Feedback erhalten hat. Dafür braucht es eine Umgebung und Werkzeuge.
Denk an einen Projektkreislauf: spezifizieren, umsetzen, prüfen, überarbeiten. Unser Fazit: Dieser Kreislauf ist wichtiger als die Länge der ersten generierten Antwort. Eine kleine Änderung mit bestandener Abnahmeprüfung ist nützlicher als ein beeindruckendes Repository, das niemand gestartet hat.
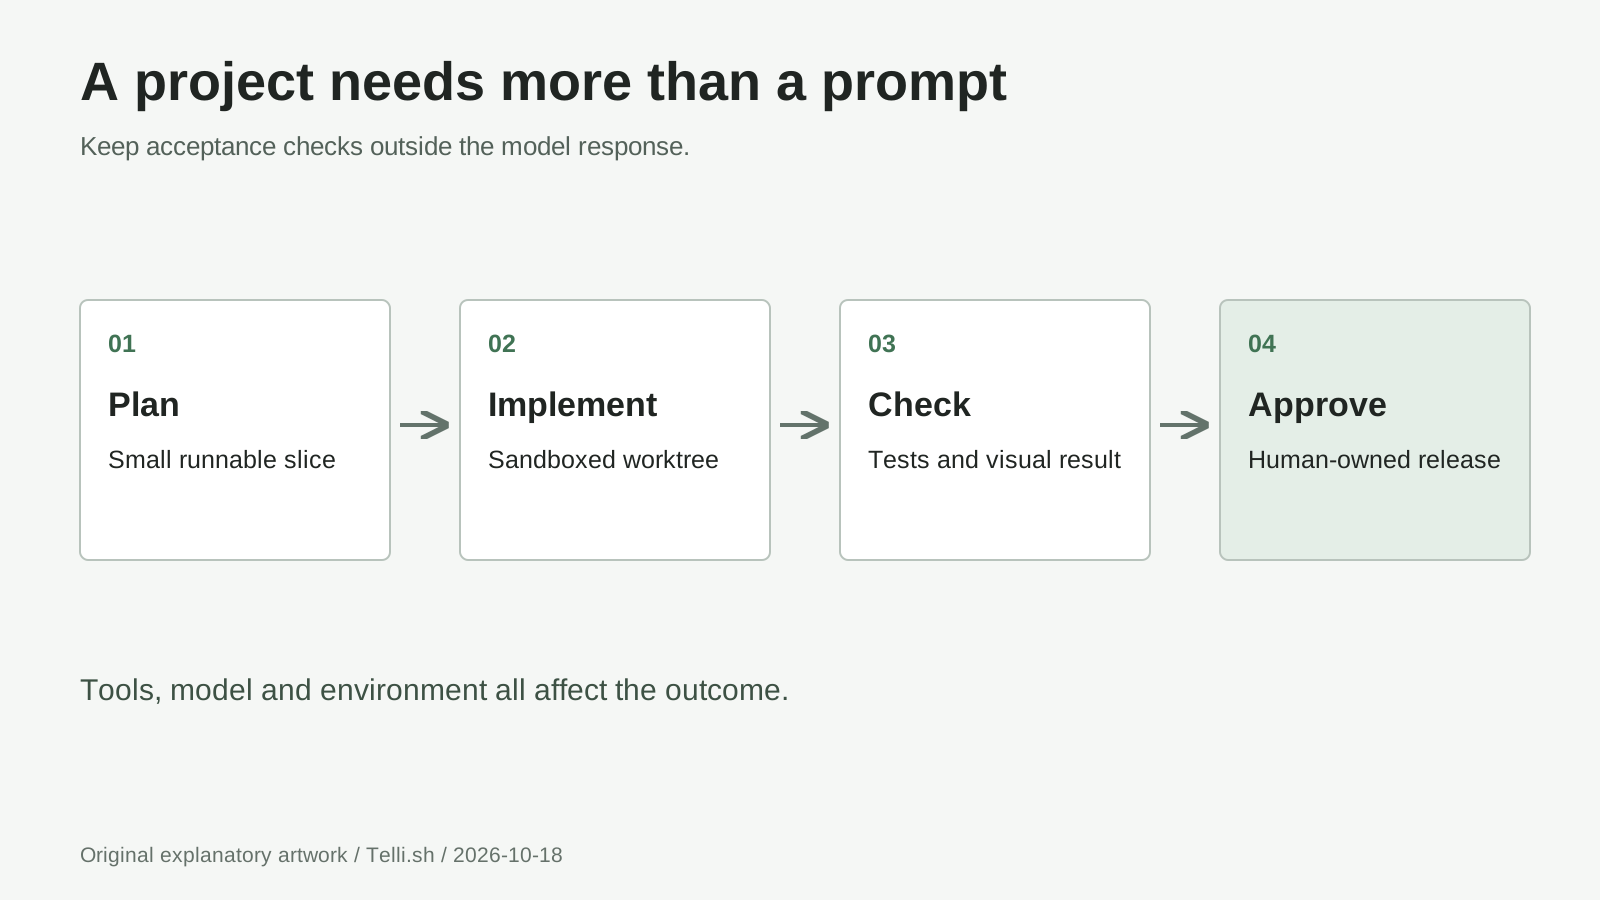
Originalgrafik: Abnahmeprüfungen und Veröffentlichungsfreigabe bleiben außerhalb der Modellantwort. Werkzeuge und Ausführungsumgebung bestimmen, was tatsächlich verifiziert werden kann.
Gib der Leseliste ein klares Ziel für den Projektabschluss
Stell dir für die zweite Iteration eine Leseliste für eine kleine Lerngruppe vor. Mitglieder sollen Links hinzufügen, Artikel als gelesen markieren und die Liste exportieren können. Behalte diese Version als Einzelbenutzer-Anwendung im Browser; Zusammenarbeit und Synchronisierung sind eigene Projekte.
-
Formuliere den Vertrag. Verlange Titel, URL und Lesestatus; weise ungültige Links zurück; erhalte Einträge nach dem Neuladen; exportiere eine JSON-Datei. Lege fest, was bei einer leeren Liste, langem Titel oder fehlerhafter Importdatei geschieht. Lass Authentifizierung und serverseitige Speicherung weg.
-
Bitte vor Änderungen um einen Plan. Lass das Modell angeben, welche Dateien es braucht, welche Speicherlösung es vorschlägt und welche Tests es plant. Gib ihm einen sauberen Ordner oder isolierten Worktree. Übergib nicht gleich dein Home-Verzeichnis, Zugangsdaten für die Produktion oder die Erlaubnis, beliebige Software zu installieren.
-
Setze einen vertikalen Ausschnitt um. Füge einen Artikel hinzu, speichere ihn und lade die Seite neu. Ergänze danach Filterung, dann Export und Import. Jeder Zwischenschritt sollte lauffähig bleiben, damit sich ein fehlerhafter Export nicht mit einer Speichermigration und einer unabhängigen Neugestaltung verheddert.
-
Liefere konkrete Belege zurück. Gib den exakten Fehler, die Eingabe und das erwartete Verhalten an. Hänge bei einem Layoutproblem einen zugeschnittenen Screenshot ohne private Angaben an. Bitte um einen eng begrenzten Fix und wiederhole dieselben Prüfungen, statt jedes Mal eine vollständige Neufassung anzunehmen.
-
Gib einen Release-Kandidaten frei. Teste Tastaturnavigation, leere Liste, doppelte Links und lange Titel. Exportiere die Liste, leere die Testdaten, importiere sie wieder und bestätige, dass alle Felder den Rundlauf überstehen. Bewahre eine bekannte funktionierende Version auf, bevor du eine weitere Überarbeitung annimmst.
Das Modell kann auch vor der Implementierung einen Testplan entwerfen. Bitte es beispielsweise, die erwartete JSON-Struktur zu beschreiben und die Felder zu benennen, die ein Importer validieren muss. Vergleiche die Implementierung anschließend mit diesem Plan. So bleiben Erwartung und Code getrennt und Abweichungen werden sichtbar.
Ein Projekt-Harness stellt dem Modell Dateiänderungen, Befehlsausführung und weitere Werkzeuge bereit. DeepSeek empfiehlt für 1017 Harness v0.2.1-rc.1 oder neuer in seiner Veröffentlichungsankündigung. Folge zur Installation der offiziellen Harness-Anleitung; eine Chat-API-Anfrage allein erzeugt keinen Coding-Agenten.
Verbinde die API, ohne ein Geheimnis in deine Webseite zu schreiben
Verwende die API, wenn dein eigenes Programm Modellantworten braucht. Die Leseliste kann eine lokale Browseranwendung bleiben; das folgende Skript ist ein separater Entwicklungshelfer fürs Terminal. Bette deinen DeepSeek-Schlüssel niemals in index.html, Browser-JavaScript oder ein öffentliches Repository ein.
1. Erstelle einen API-Schlüssel und wähle eine kleine Aufgabe
Erstelle einen Schlüssel auf der DeepSeek-API-Plattform und prüfe dein Kontoguthaben. DeepSeeks Anleitung für den ersten Aufruf dokumentiert die OpenAI-kompatible Basis-URL https://api.deepseek.com und das Modell deepseek-flash. Ein Webchat-Konto macht die kostenpflichtige API-Nutzung nicht unbegrenzt.
Bitte bei der ersten Anfrage lieber um Abnahmekriterien als um ein ganzes Repository. So bleibt die Ausgabe leicht zu prüfen und die erzeugte Datenmenge überschaubar, falls etwas falsch konfiguriert ist.
2. Richte Python auf deinem Betriebssystem ein
Installiere Python 3, falls es noch nicht vorhanden ist. Erstelle in einem neuen Projektordner eine isolierte Umgebung und installiere das SDK. Diese Befehle rufen den Interpreter direkt auf; weder Aktivierungsskript noch Änderung der PowerShell-Ausführungsrichtlinie sind erforderlich. Die Anleitung folgt Pythons Dokumentation zu virtuellen Umgebungen.
Windows, PowerShell:
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade openai
Ist py nicht verfügbar, aber python --version weist Python 3 aus, verwende für den ersten Befehl python -m venv .venv.
macOS, Terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Linux, Terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Einige Linux-Distributionen paketieren venv separat. Fehlt es beim Erstellen der Umgebung, installiere das von deiner Distribution dokumentierte Python-Paket für virtuelle Umgebungen und wiederhole den Schritt. Behebe kein Problem mit einer isolierten Umgebung durch ein systemweites sudo pip install.
3. Erstelle einen Helfer für das Terminal
Lege first_request.py neben .venv an und füge das folgende Beispiel ein. Der Schlüssel wird mit einer verdeckten Eingabe über Pythons getpass-Modul abgefragt, statt ihn im Quellcode oder in einem Shell-Verlauf zu hinterlegen. Führe das Skript in einem normalen Terminal aus, das verdeckte Eingabe unterstützt.
from getpass import getpass

from openai import OpenAI

client = OpenAI(
    api_key=getpass("DeepSeek API key: "),
    base_url="https://api.deepseek.com",
    timeout=120.0,
    max_retries=0,
)

reply = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": (
            "Propose five manual acceptance checks for a browser-only "
            "reading queue with filtering, read status and JSON export. "
            "Return checks only; do not claim to have executed them."
        ),
    }],
    max_tokens=2048,
    stream=False,
    extra_body={"thinking": {"type": "disabled"}},
)

print(reply.choices[0].message.content)
print("Finish reason:", reply.choices[0].finish_reason)
print("Usage:", reply.usage)
4. Führe das Skript aus und prüfe die Antwort
Unter Windows führst du \.venv\Scripts\python.exe first_request.py aus. Unter macOS oder Linux verwendest du ./.venv/bin/python first_request.py. Gib deinen Schlüssel an der Eingabeaufforderung ein. Das erwartete Ergebnis sind Prüfpunkte, ein Beendigungsgrund und Nutzungsinformationen, nicht neu angelegte Projektdateien.
Prüfe bei einem Fehler zuerst den Status, bevor du es erneut versuchst. 401 betrifft die Authentifizierung, 402 ein unzureichendes Guthaben und 429 ein Limit. DeepSeek dokumentiert diese Codes im Leitfaden zu Fehlercodes. Ein Beendigungsgrund length bedeutet, dass die Antwort an ein Limit gestoßen ist; das belegt keine Vollständigkeit. Halte Wiederholungen beim Kennenlernen der API bewusst begrenzt.
Thinking, Vision und Webwerkzeuge haben unterschiedliche Aufgaben
Thinking ist standardmäßig aktiviert und verwendet den Aufwand high. Bei einer anspruchsvolleren Debuggingfrage ersetzt du extra_body im Beispiel durch {"thinking": {"type": "enabled"}} und ergänzt reasoning_effort="high". Die dokumentierten Stufen sind low, high und max; im Thinking-Modus wird temperature ignoriert. Ein niedrigerer Wert ist also keine Abkürzung zu verlässlicherem Schlussfolgern. Anleitung zum Thinking-Modus, geprüft am 18. Oktober
Thinking verbraucht ebenfalls das Generierungsbudget. Erhöhe eine kleine Ausgabengrenze bewusst, wenn du von kurzen Antworten ohne Thinking zu komplexem Schlussfolgern wechselst. Implementierst du Tool-Aufrufe im Thinking-Modus, musst du reasoning_content des Assistenten gemäß Anleitung in nachfolgenden Anfragen mit Tools beibehalten. Baue den Tool-Dialog nicht so auf, dass nur die sichtbare Endantwort erhalten bleibt.
Vision nimmt neben Text auch Bilder an; es ist kein Bildgenerierungsendpunkt. In Chat Completions kommt Bildinhalt in einer user-Nachricht als image_url-Block, Base64-Data-URL oder im dokumentierten Files-API-Format. Unterstützt werden JPEG, PNG, GIF und WebP. Die Grenze für den eingebetteten Anfragekörper beträgt 48 MiB; ein einzelnes eingebettetes oder extern verlinktes Bild darf 32 MiB groß sein. Vision-Anleitung
Für die Leseliste könntest du einen bereinigten Screenshot senden und fragen, welche Beschriftungen bei geringer Breite überlappen. Betrachte das als zu prüfende Diagnose, nicht als Beweis, dass das Layout repariert wurde. Bilderkennung erteilt der API auch nicht die Erlaubnis, deine Maus zu bewegen oder Dateien zu ändern.
Search findet Seiten; Fetch ruft eine Seite als Markdown ab. Die eigenständigen Endpunkte heißen POST /v1/tools/search und POST /v1/tools/fetch und verwenden denselben Bearer-Schlüssel. Eine Search-Anfrage kann {"query":"browser storage documentation","count":3} verwenden; Fetch nimmt {"url":"https://developer.mozilla.org/en-US/docs/Web/API/Storage"} entgegen. Deine Anwendung muss diese Endpunkte ausdrücklich aufrufen oder eine Integration nutzen, die sie bereitstellt. Eine URL in einer normalen Chat-Anfrage zu erwähnen, ist nicht derselbe Ablauf. Anleitung zu Search und Fetch
Halte abgerufene Inhalte von Anweisungen getrennt. Eine gefundene Seite ist ein Beleg, keine Befugnis, einen Befehl auszuführen, einen Schlüssel offenzulegen oder eine Projektanforderung zu ändern. Fetch unterliegt weiterhin den Zugriffsrichtlinien der Zielseite; es verschafft keinen Zugang zu privaten oder kostenpflichtigen Inhalten.
Ein großes Grundmodell kann weniger Parameter aktivieren und trotzdem nicht auf einen Laptop passen
Die Modellkarte der September-Version V4.1 beschreibt ein MoE-Grundmodell mit 552 Milliarden Parametern. Bei der Verarbeitung von Eingabetokens werden ungefähr 8 Milliarden Parameter aktiviert, beim Dekodieren von Ausgabetokens etwa 16 Milliarden. Der Causal Encoder-Decoder trennt einen kausalen Encoder mit 20 Schichten von einem Decoder mit 20 Schichten. Diese Architekturangaben gehören zur Basisversion V4.1, nicht zu einer am 17. Oktober neu angekündigten Architektur. Architektur des Basismodells und Link zum technischen Bericht
Einfach gesagt: Prefill verarbeitet deinen bestehenden Prompt; Decoding erzeugt die Antwort. Mixture-of-Experts-Routing nutzt ausgewählte Experten, statt bei jedem Token alle Parameter des Grundmodells zu aktivieren. Komprimierte Aufmerksamkeit und ein gemeinsames Cache-Design sollen den Speicherbedarf langer Prompts verringern. Weniger aktive Parameter beschreiben jedoch den Rechenaufwand, nicht den gesamten Speicherbedarf für das gehostete Modell.
Der angegebene Kontext umfasst eine Million Tokens. Das ist eine Kapazitätsangabe, keine Aufforderung, bei jeder Anfrage ein ganzes Repository einzufügen, und keine Garantie für perfekte Erinnerung. Beginne mit Aufgabe, relevanten Dateien und konkreten Fehlern; erweitere den Kontext, wenn eine fehlende Abhängigkeit oder ein Vertrag es erfordert.
Für selbst gehosteten Betrieb verwende die offiziellen Inferenzanweisungen für 1017. Sie beschreiben Checkpoint-Konvertierung und Tensor-parallele Ausführung. Der allgemeine vLLM-Launcher auf der Hugging-Face-Seite ist kein modellspezifisches Bereitstellungsrezept. Prüfe Hardware, unterstützte Kernel und Serving-Kompatibilität, bevor du Gewichte herunterlädst. deepseek-recipe übernimmt Prompt- und Protokollkonvertierung; es stellt weder Inferenz bereit noch führt es Werkzeuge aus. Für gewöhnliche Laptop-Nutzung ist ein gehosteter Zugang der bessere Einstieg.
Kalkuliere eine ganze Aufgabe statt des günstigsten Tokens
Am 18. Oktober 2026 listet DeepSeek für Flash folgende Preise in US-Dollar je eine Million Tokens. Offizielle Preisliste
| Tokenkategorie | Hauptzeit | Nebenzeit |
|---|---|---|
| Eingabe, Cache-Fehltreffer | $0.30 | $0.15 |
| Eingabe, Cache-Treffer | $0.006 | $0.003 |
| Ausgabe | $1.20 | $0.60 |
Hauptzeiten sind 01:00-04:00 und 06:00-10:00 UTC von Montag bis Freitag, ausgenommen chinesische Feiertage; alle anderen Zeiten gelten als Nebenzeit. Nach diesem Zeitplan sind Wochenenden vollständig Nebenzeit. Verwende für die Planung UTC, statt anzunehmen, dass deine lokale Tageszeit teuer ist.
Für eine beispielhafte Aufgabe mit 100.000 Eingabetokens ohne Cache-Treffer, 200.000 Eingabetokens mit Cache-Treffer und 20.000 Ausgabetokens lautet die Berechnung zur Hauptzeit:
(0.1 x $0.30) + (0.2 x $0.006) + (0.02 x $1.20)
= $0.0300 + $0.0012 + $0.0240
= $0.0552
Zu Nebenzeittarifen kosten dieselben angenommenen Mengen $0.0276. Das ist eine Rechnung, keine gemessene Projektabrechnung. Verwende tatsächliche Cache-Treffer und Cache-Fehltreffer, statt anzunehmen, dass wiederholter Kontext immer den günstigeren Tarif erhält.
Search und Fetch kosten jeweils $0.75 pro 1.000 erfolgreiche Anfragen mit Ergebnissen. 40 kostenpflichtige Suchanfragen und 60 kostenpflichtige Abrufe summieren sich also auf $0.075, ohne die Modell-Tokens für die Verarbeitung ihrer Ergebnisse. Die vorübergehende Gratisphase gilt für serverseitige Aufrufe über die benannten DeepSeek-API-Integrationen; deren Abrechnung beginnt am 31. Oktober 2026 um 16:00 UTC. Sie ist keine allgemeine Gratisphase für direkte Endpunktaufrufe. Abrechnungsregeln für Werkzeuge
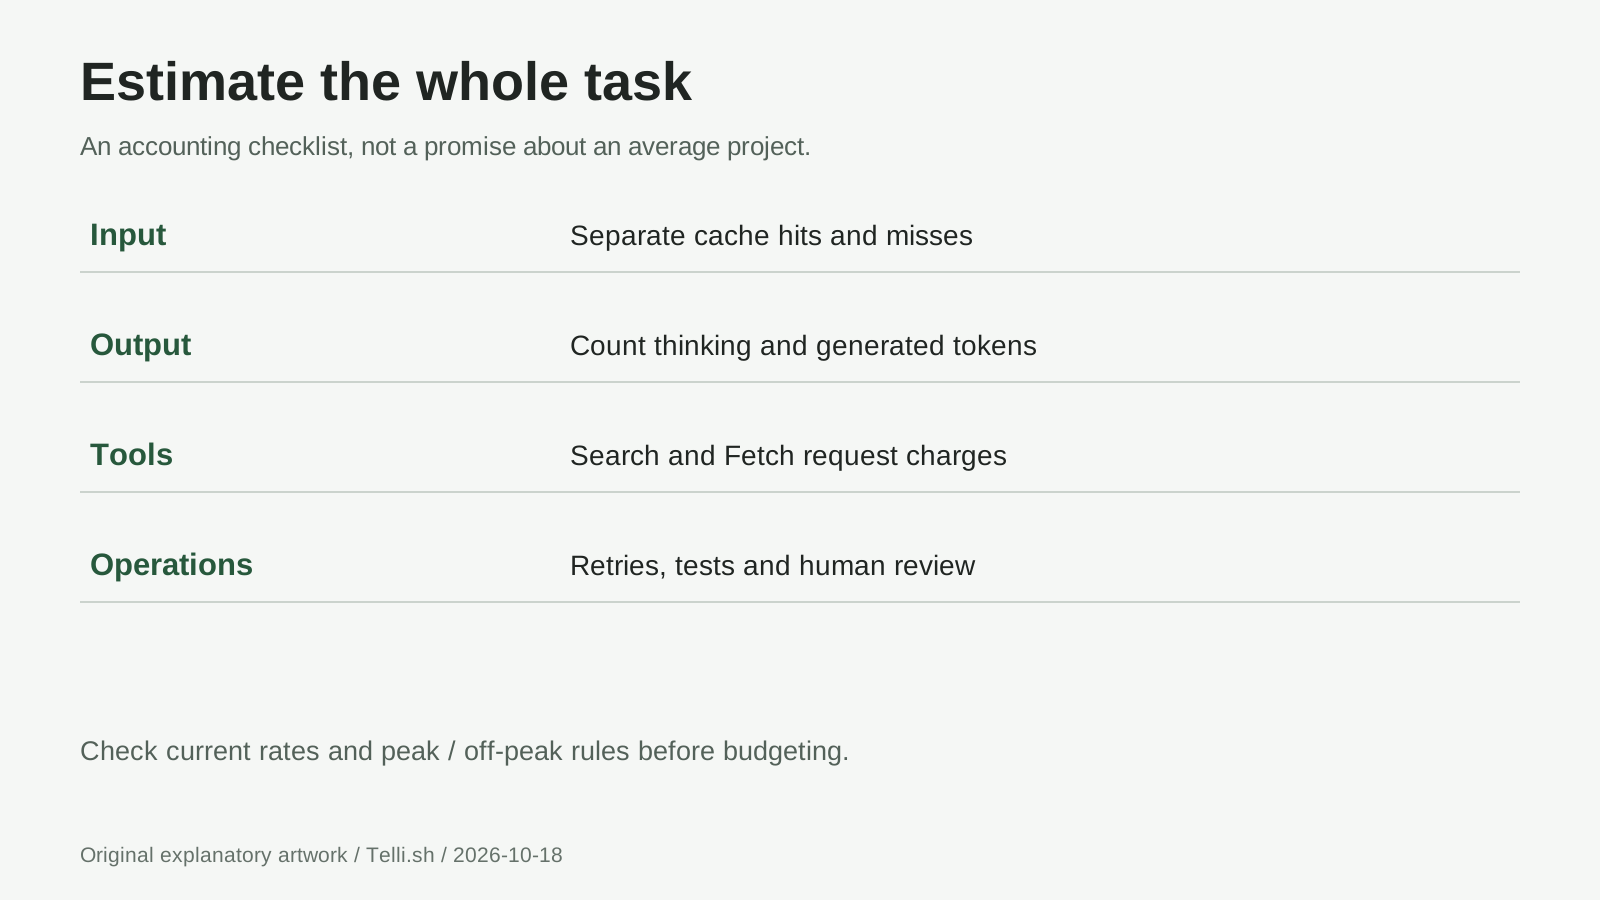
Eigene Kalkulationsgrafik: Berücksichtige Thinking-Ausgabe, Wiederholungen, Tool-Aufrufe und Prüfaufwand im Budget. Es wird kein durchschnittlicher Projektpreis behauptet.
Bewerte Benchmarkgewinne zusammen mit dem Harness
DeepSeek meldet für 1017 gegenüber V4.1 Flash folgende Veränderungen. Das sind vom Anbieter berichtete Werte, keine unabhängigen Resultate dieses Leitfadens. Vergleich auf der 1017-Modellkarte
| Benchmark | V4.1 Flash | 1017 | Veränderung |
|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 Punkte |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 Punkte |
| ProgramBench | 20.3 | 29.1 | +8.8 Punkte |
Die 1017-Modellkarte nennt Claude Code für Terminal-Bench 4.0 und Mini-SWE-V2 für DeepSWE v1.1. Ein Harness stellt Werkzeuge, Kontextverwaltung und Ausführungsrichtlinien bereit; ein anderes Harness verändert das Experiment. Werte aus unterschiedlichen Setups sind keine reine Messung der Modellfähigkeit.
Halte für einen eigenen Vergleich Repository, Abnahmekriterien, Berechtigungen und Budget konstant. Notiere, ob das Projekt funktioniert, wie viele Korrekturen nötig waren, den Gesamtverbrauch und die verstrichene Zeit. Ein besserer öffentlicher Score hilft bei der Auswahl eines Kandidaten; ob er die Aufgabe verdient, entscheidet ein wiederholbarer Test in deiner Umgebung.
Diese Fragen solltest du klären, bevor du ihm eine größere Aufgabe gibst
Ist 1017 ein eigener API-Modellname?
Nein. Verwende deepseek-flash. Der datierte Checkpoint-Name bezeichnet das Update; DeepSeeks gehostete API behält die bestehende Kennung bei. Wenn Reproduzierbarkeit wichtig ist, notiere Datum und zurückgegebene Modellinformationen. Dokumentation zum ersten API-Aufruf
Machen MIT-lizenzierte Gewichte die API kostenlos?
Nein. Die 1017-Modellkarte lizenziert Repository und Gewichte unter MIT. Die gehostete Nutzung wird separat abgerechnet. Die Lizenz der Gewichte gewährt zudem keine Rechte an privaten Eingaben, fremden Assets oder Medien in einer Demo.
Kann das Modell mit einem Prompt ein vollständiges Spiel bauen?
Betrachte die offiziellen Demos als Beispiele des Herausgebers, nicht als Liefergarantie. Lege Bewegung, Kollision, Neustartverhalten und ein Abschlusskriterium fest, bevor du nach visueller Verfeinerung fragst. Ein Spiel, das du prüfen und erneut spielen kannst, ist ein besserer Meilenstein als eine große Codebasis.
Sollte ich immer das maximale Thinking und den gesamten Kontext verwenden?
Nein. Beginne mit einer begrenzten Anfrage und erhöhe Aufwand oder Kontext, wenn ein bestimmter Fehler es erfordert. Mehr erzeugte Überlegungen und größere Prompts verbrauchen Ressourcen; keines von beidem ersetzt Abnahmeprüfungen oder sorgfältige Werkzeugberechtigungen.
Kann ich generierte Arbeit sofort veröffentlichen?
Prüfe zuerst Funktion, Sicherheit, Abhängigkeitslizenzen und Herkunft der Assets. Entferne Beispielzugangsdaten und kontrolliere externe Anfragen. Die Freigabe zur Bereitstellung ist unabhängig von der Erlaubnis, ein lokales Projekt zu bearbeiten.
Fazit: Fertig ist es erst, wenn jemand das Ergebnis geprüft hat
Das nützliche Versprechen von 1017 ist ein besserer Projektabschluss, kein Grund, mit der Prüfung aufzuhören. Gib dem Modell ein kleines Ziel, eine begrenzte Umgebung und beobachtbare Prüfkriterien. Erweitere das Projekt erst, wenn sein aktuelles Verhalten deine Freigabe verdient.
Quellen
Produktdokumentation und Preise geprüft am 18. Oktober 2026. Benchmark- und Trainingsaussagen sind DeepSeek zugeschrieben; die Übungen sind Lernbeispiele und keine behaupteten Praxistests. Alle drei Diagramme sind eigens erstellte Erläuterungsgrafiken. Medien aus Anbieter-Demos sind verlinkt, nicht reproduziert.
- Update vom 17. Oktober und Projektbeispiele
- Basisveröffentlichung vom 10. September
- Datumsbezogenes Änderungsprotokoll
- 1017-Modellkarte, Benchmarks und MIT-Lizenz
- Architektur von V4.1 und technischer Bericht
- Erster API-Aufruf, Thinking, Vision, Search und Fetch und Preise
- Offizielle Inferenzreferenz und deepseek-recipe
Mach es leichter, das nächste Projekt wieder aufzunehmen
Empfehlung von Telli.sh: Bewahre Quelllinks, Projektbeschreibung, Prompts und Prüfnotizen gemeinsam auf, damit du in der nächsten Sitzung bei den getroffenen Entscheidungen anknüpfen kannst. Telli.sh hilft, Projektwissen zu organisieren; es ist keine DeepSeek-Coding-Agent-Integration. Erstelle ein Telli.sh-Konto