A DDR4 antiga pode dar mais folga a um servidor de IA?
Netlist e Marvell levam à SC26 projetos CXL com DDR4. Veja onde mais memória do host pode ajudar e o que medir antes da compra.
Um serviço de busca interno parece rápido até o pico da manhã. Ele precisa recuperar trechos de milhares de documentos antes de enviar à GPU o pedido de resposta. Os trechos mais usados cabem na memória, mas buscas repetidas no restante do acervo voltam ao armazenamento. Quem usa o serviço espera mais, mesmo com capacidade de sobra no acelerador. Para a equipe que mantém o serviço, um cache maior no servidor pode ajudar mais do que outra GPU.
Duas prévias da SC26 apontam mais uma forma de montar esse cache. Em um anúncio de 10 de novembro, o CXL Consortium informou que a especialista em memória Netlist planejava mostrar uma prova de conceito chamada NVvault-D4, que reaproveita DDR4 como memória adicional do host via Compute Express Link, ou CXL. Em 13 de novembro, a fabricante de chips Marvell anunciou que seus parceiros exibiriam sistemas com controladores de expansão de memória Structera X e DDR4 ou DDR5. Os anúncios descrevem equipamentos previstos para exposição. Preços, datas de entrega e resultados das demonstrações previstas seguem em aberto. A SC26 acontece em Chicago de 15 a 20 de novembro, com exposição regular de 17 a 19 de novembro, no horário local. Prévia da Netlist pelo CXL Consortium · Anúncio da Marvell para a SC26 · Datas oficiais da SC26
Para quem vai comprar, a questão é se a capacidade adicional mantém na memória uma parte útil da carga sem tornar as solicitações mais lentas demoradas demais. Para uma equipe que já tem DDR4 em estoque, o reaproveitamento pode reduzir custos se os módulos forem qualificados e o sistema conseguir colocar neles os dados certos. O ganho depende do que hoje fica esperando e em que parte do sistema.
Onde fica a memória adicional
A CPU consegue acessar a DRAM local diretamente pelo próprio controlador de memória. Com um servidor compatível e um dispositivo de expansão CXL, também pode acessar a memória ligada a esse dispositivo por um enlace CXL. A expansão abre espaço para dados do lado do host. O caminho, a largura de banda e a latência diferem dos canais locais de DRAM. O firmware e o sistema operacional precisam disponibilizar essa capacidade, e a aplicação ou o sistema operacional precisa adotar uma política de alocação de páginas adequada à carga.
Isso importa ao avaliar o uso de DDR4 em estoque em um servidor mais novo. O servidor pode manter a DDR5 local e acessar a DDR4 por meio de um dispositivo de expansão compatível. O controlador do dispositivo, a qualificação dos módulos e a compatibilidade do host continuam importantes. Uma prova de conceito com DDR4 já existente dá um motivo para investigar o reaproveitamento. Ainda é preciso saber quais módulos seriam aceitos em uma configuração com suporte e em quais sistemas conseguiriam operar com estabilidade.
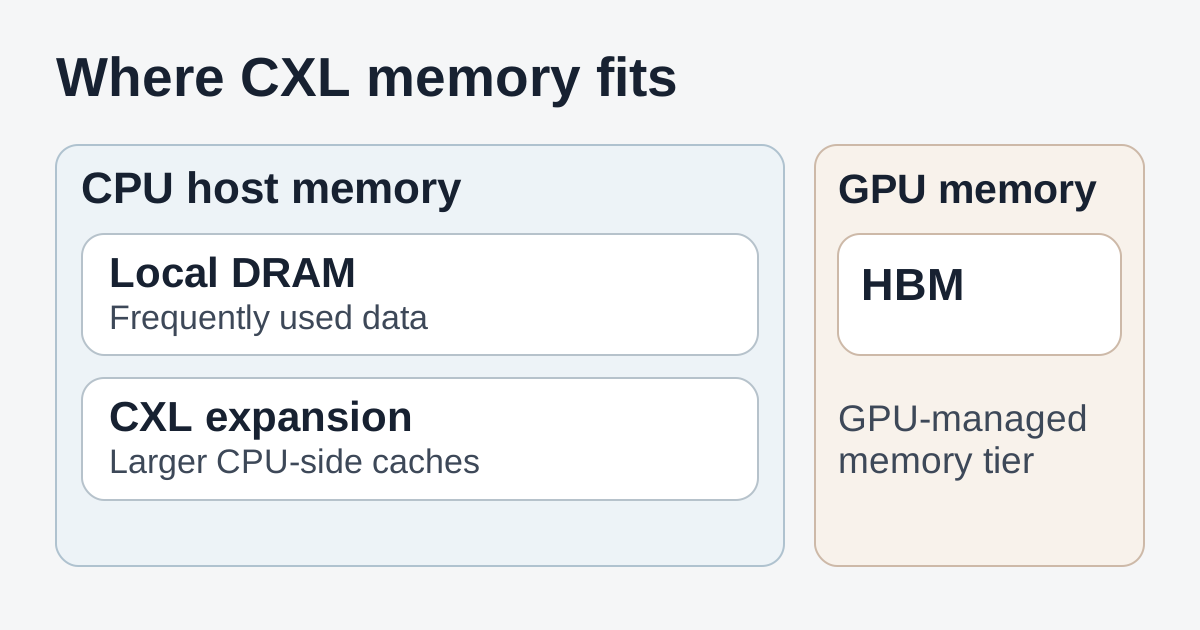
A DRAM local pode manter páginas consultadas com frequência, enquanto a camada de expansão pode guardar caches maiores do lado da CPU. A memória de alta largura de banda do acelerador tem limites próprios de capacidade e vazão.
No exemplo da busca, a equipe poderia manter na DDR5 local os dados do índice lidos com frequência e mover para a camada CXL um cache maior de trechos ou resultados consultados mais raramente. Quando acha os trechos certos, o serviço de inferência os passa para o modelo na GPU. Os pesos do modelo e os dados de que um kernel do acelerador precisa ainda têm de caber onde o motor de inferência espera acessá-los. A expansão CXL desses anúncios amplia a capacidade de memória do host. A memória de alta largura de banda da GPU, conhecida como HBM, continua sendo um recurso separado.
Comece por rastrear onde as solicitações gastam tempo. Se a CPU espera com frequência por dados removidos do cache, mais memória do host pode evitar leituras no armazenamento. Se o modelo passa a maior parte do tempo lendo pesos da memória da GPU e o host raramente fica esperando, a mesma compra pode mudar pouco o tempo de resposta. Recuperar dados mais rápido pode fazer diferença mesmo quando o modelo roda na mesma velocidade. Meça as duas etapas antes de atribuir a uma delas as mudanças no serviço como um todo.
Os três protótipos da Netlist têm funções diferentes
O NVvault-D4 é o projeto da Netlist a acompanhar para reaproveitar DDR4. O consórcio aponta máquinas virtuais, bancos de dados em memória, computação de alto desempenho e cargas corporativas como aplicações-alvo. Um host de virtualização dá um exemplo concreto. As máquinas virtuais mais movimentadas podem ficar na memória local enquanto a equipe testa se as páginas das menos ativas podem ficar na expansão. Uma equipe de banco de dados pode testar a mesma ideia com partes de um cache de leitura. O banco precisaria de uma política de alocação que mantenha perto da CPU as páginas usadas pelas consultas sensíveis à latência. São pilotos possíveis para avaliar a capacidade. A prévia não traz resultados de cargas de trabalho. Prévia da Netlist pelo CXL Consortium
Os outros dois projetos mostram por que vale prestar atenção aos nomes. O NVvault-HM usa DRAM como cache à frente da capacidade em NAND. O anúncio aborda movimentação de dados e telemetria, além de aplicações como caches chave-valor para IA e análises. O NVvault-PM é outro projeto CXL Type 3, descrito com DRAM, backup em NAND e uma fonte de energia integrada para lidar com quedas de alimentação. A prévia apresenta o PM para retenção de cache chave-valor, pontos de restauração e recuperação. Equipes que avaliam backup ou persistência precisam saber como aquele modelo específico se comporta nas condições de falha previstas. O anúncio do D4 não atribui a ele os recursos de armazenamento ou recuperação dos outros modelos. Prévia da Netlist pelo CXL Consortium
O cache chave-valor de um modelo de linguagem dá outro exemplo de teste de IA. Ele guarda dados de atenção de tokens anteriores para o modelo reaproveitá-los. Um motor de inferência que permite transferir dados para o host pode mover páginas de cache de sessões inativas para fora da memória da GPU e recarregá-las quando as sessões voltarem. A equipe pode testar se mais capacidade no host permite manter mais sessões e quanto as transferências acrescentam à demora de uma solicitação retomada. A alocação e a cópia dependem do motor e do servidor. Esse é um experimento possível para memória do host em camadas. Na prévia da Netlist, o uso de cache KV é associado expressamente ao HM e ao PM.
O anúncio da Marvell dá aos compradores uma segunda implementação para acompanhar. Seus parceiros planejam apresentar sistemas construídos com controladores da família Structera X e DDR4 e DDR5. O programa e o kit de imprensa explicam a exposição e a família. Os compradores ainda terão de conferir quais configurações de servidor são qualificadas pelo fornecedor, que memórias aceitam e como funciona o suporte ao conjunto. As imagens dos chips no kit são material de referência sobre a família de produtos. Programação do espaço do CXL Consortium na SC26 · Anúncio da Marvell para a SC26 · Kit de imprensa da Marvell Structera
Meça primeiro as solicitações mais lentas
Uma média pode esconder as solicitações que fazem a aplicação parecer lenta. Em um serviço de busca, documentos populares podem devolver respostas rápidas o dia todo, enquanto documentos menos comuns levam os mesmos processos a consultar repetidamente a expansão. Um aumento no tempo das solicitações mais lentas pode ser aceitável para um lote noturno de indexação. Para uma pessoa à espera do resultado da busca, a demora pode ser perceptível na hora. Avalie o arranjo de memória diante da meta real do serviço na hora do pico.
Os pesquisadores independentes do estudo MELODY deram um exemplo concreto em 2025. Eles estudaram 265 cargas em quatro dispositivos de memória CXL reais, cinco plataformas de CPU e sete níveis de latência. Examinaram a sensibilidade na faixa de 140 a 410 nanossegundos, abaixo de um microssegundo, e observaram que a carga, a latência nos percentis mais altos e o comportamento da CPU influenciavam a forma como os sistemas lidavam com memória CXL. O artigo identifica os expansores testados como CXL-A a CXL-D. Os resultados não estimam o desempenho dos sistemas anunciados para a SC26. Para quem compra, eles ajudam a entender por que uma latência média ou um teste favorável não basta para saber como um servidor vai se comportar. Estudo MELODY da ASPLOS 2025 · Artigo completo
Planeje três comparações se a plataforma permitir. Primeiro reproduza o serviço atual com a DRAM local existente. Depois teste mais capacidade com a memória do host em camadas. Por fim, use uma configuração apenas local com a mesma capacidade total para ter uma referência útil. Como exercício meramente ilustrativo, compare 256 GiB de DRAM local e 256 GiB de expansão utilizável com 512 GiB de DRAM local. Use aplicações, conjuntos de dados, configurações de software e cargas oferecidas comparáveis. Registre qualquer diferença de plataforma ou de canais locais que as configurações obriguem a adotar. Se a alternativa em produção for recorrer ao armazenamento quando faltar memória ou distribuir dados por outro host, meça o tempo e o custo dessa opção também.
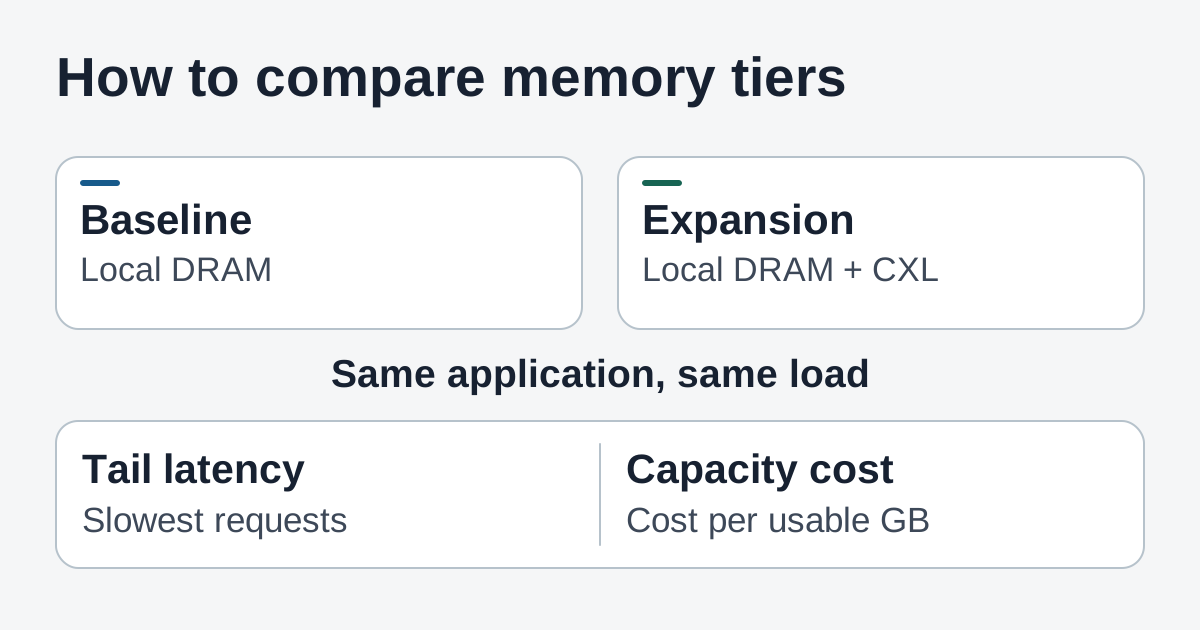
Compare a mesma carga e o mesmo tráfego nas duas configurações. Verifique as solicitações mais lentas e calcule o custo por unidade de capacidade utilizável.
- Reproduza o tráfego que enche o cache. Use uma combinação realista de solicitações, com documentos consultados repetidamente e outros acessados raramente. Rode com partida a frio e depois de aquecer os caches. Na mesma concorrência, observe a mediana, o p95 e o p99 da latência, a taxa de erros e o volume de solicitações atendidas por unidade de tempo. Em uma busca com IA, acompanhe separadamente recuperação e inferência para que um cache mais rápido não mascare uma piora no serviço do modelo e vice-versa.
- Confira quais dados realmente mudaram de lugar. Inspecione a alocação de memória por camada e por nó NUMA da CPU, a migração e a recuperação de páginas quando disponíveis e os contadores de enlace ou dispositivo oferecidos pela plataforma. Um teste aparentemente bom pode ter atendido quase tudo na DRAM local. Um aparentemente ruim pode ter colocado por padrão as páginas mais consultadas do índice na camada remota. Registre a política de alocação com cada conjunto de medições.
- Simule uma tarde de pico. Rode um segundo trabalho enquanto a aplicação interativa está ocupada, deixe o cache aquecer após reiniciar e observe o que acontece quando o serviço se aproxima dos limites de memória. Confira como o sistema operacional informa falhas do dispositivo ou da memória, como a equipe identifica o host afetado e como o serviço volta à política de alocação anterior. Testar a recuperação faz parte do piloto de qualquer configuração que a equipe vá manter.
- Defina os critérios antes de olhar os gráficos. Use as metas atuais da equipe para p99 e erros como ponto de partida. Registre quanta capacidade adicional precisa ser utilizável dentro dessa meta e quais casos toleram recuperação mais lenta. Se a configuração só atinge as metas quando o cache atende uma parcela muito alta das solicitações, use registros de dias especialmente movimentados para ver se a taxa se mantém no tráfego de produção.
Calcule o custo completo do reaproveitamento
Os DIMMs já disponíveis podem fazer o item de memória de uma proposta parecer vantajoso. A compra ainda exige um dispositivo de expansão, um host ou uma atualização com suporte, módulos qualificados e equipe para implantação e manutenção. O dispositivo também precisa de um slot ou de uma conexão com a plataforma adequada. Confira a distribuição prevista das pistas PCIe considerando armazenamento, rede e aceleradores. Uma expansão de memória faz menos sentido se tirar os recursos que a própria carga usa para movimentar dados.
Calcule o custo por GiB utilizável no nível de serviço exigido. Inclua qualquer capacidade reservada pela plataforma ou cedida para manter páginas suficientes localmente, além de energia, refrigeração, qualificação da frota, peças de reposição e suporte durante a vida útil prevista. Confira quem entrega atualizações de firmware e como o sistema expõe os indicadores de saúde e os erros de memória. Se a camada permite ao host fazer o mesmo trabalho que de outra forma recorreria ao armazenamento ou exigiria mais uma máquina, meça o trabalho poupado e considere os custos indiretos das duas opções. Um experimento simples ajuda. Rode o serviço no pico de solicitações em ambas as arquiteturas e compare o custo de manter a resposta dentro da meta.
Depois da SC26, acompanhe as configurações qualificadas, o suporte documentado a módulos, a compatibilidade de software e medições de cargas reais. Um sistema lançado pode dar a equipes com um grande volume de dados usados com menos frequência outra forma de expandir um servidor existente. Um bom exemplo seria um serviço que mantém mais documentos na memória do host, evita leituras repetidas do armazenamento e permanece dentro da meta original de p99 com custo menor. Uma equipe com esse resultado tem um critério de compra que pode aplicar no próximo servidor.
Fontes
- Prévia da Netlist para a SC26 pelo CXL Consortium, 10 de novembro de 2026
- Anúncio da Marvell sobre parceiros e conectividade na SC26, 13 de novembro de 2026
- Programação do espaço do CXL Consortium na SC26 e materiais gráficos do evento
- Kit de imprensa da família Marvell Structera
- Programação oficial da SC26 e datas da exposição
- Artigo MELODY e dados de publicação, ASPLOS 2025 · Artigo completo
Para manter notas do piloto, registros das cargas e decisões de compra juntos, crie sua conta na Telli.sh.