Kann altes DDR4 einem KI-Server mehr Luft verschaffen?
Netlist und Marvell bringen CXL-Entwürfe mit DDR4 zur SC26. Wo zusätzlicher Hostspeicher hilft und welche Messwerte vor dem Kauf zählen.
Eine interne Suche wirkt schnell, bis morgens viele Anfragen auf einmal eintreffen. Vor jeder Anfrage an die GPU muss der Dienst passende Textstellen aus Tausenden Dokumenten abrufen. Häufig gelesene Passagen passen in den Arbeitsspeicher. Wiederholte Suchen im übrigen Bestand greifen erneut auf den Datenträger zu. Die Nutzer warten länger, obwohl der Beschleuniger noch Kapazität frei hat. Für das Team, das den Dienst betreibt, könnte ein größerer Cache im Server mehr bringen als eine weitere GPU.
Zwei Ankündigungen im Vorfeld der SC26 zeigen, wie sich so ein Cache zusätzlich aufbauen ließe. Am 10. November gab das CXL Consortium bekannt, dass der Speicherspezialist Netlist einen Machbarkeitsnachweis namens NVvault-D4 zeigen will. Er bindet vorhandenes DDR4 als zusätzlichen Hostspeicher über Compute Express Link (CXL) ein. Am 13. November kündigte der Chiphersteller Marvell Vorführungen seiner Partner mit Speichererweiterungscontrollern der Structera-X-Familie und DDR4 sowie DDR5 an. Die Ankündigungen beschreiben für die Messe vorgesehene Hardware. Preise, Liefertermine und Ergebnisse der geplanten Vorführungen bleiben offen. Die SC26 findet vom 15. bis 20. November in Chicago statt. Die reguläre Ausstellung läuft vom 17. bis 19. November Ortszeit. Vorschau des CXL Consortium zu Netlist · Marvells Ankündigung zur SC26 · Offizielle Termine der SC26
Für den Einkauf zählt, ob genug relevante Daten im Arbeitsspeicher bleiben und zugleich die langsamsten Anfragen innerhalb der tolerierbaren Antwortzeit bleiben. Hat ein Team DDR4 übrig, kann sich die Wiederverwendung rechnen, sofern sich die Module qualifizieren lassen und das System die richtigen Daten dort ablegt. Entscheidend ist, wo und worauf der Dienst heute wartet.
Wo der zusätzliche Speicher sitzt
Eine CPU greift über ihren Speichercontroller direkt auf lokal angeschlossenes DRAM zu. Mit einem kompatiblen Server und einem CXL-Speichererweiterungsgerät kann sie über eine CXL-Verbindung zusätzlich auf Speicher hinter dem Erweiterungsgerät zugreifen. Hostseitig entsteht damit ein weiterer Ort für Daten. Zugriffsweg, Bandbreite und Latenz unterscheiden sich von denen der lokalen DRAM-Kanäle. Firmware und Betriebssystem müssen die Kapazität bereitstellen. Die Anwendung oder das Betriebssystem braucht zudem eine zur Arbeitslast passende Strategie für die Platzierung der Speicherseiten.
Das ist wichtig, wenn vorhandene DDR4-Bestände in einem neueren Server weitergenutzt werden sollen. Der Server kann sein lokal angeschlossenes DDR5 behalten und das DDR4 über ein unterstütztes Erweiterungsgerät erreichen. Der Gerätecontroller, die Qualifizierung der Module und die Kompatibilität des Hosts spielen weiterhin eine Rolle. Ein Machbarkeitsnachweis mit vorhandenem DDR4 liefert einen Anlass, die Wiederverwendung zu untersuchen. Offen bleibt, welche Module eine unterstützte Konfiguration aufnehmen kann und in welchen Systemen sie zuverlässig laufen.
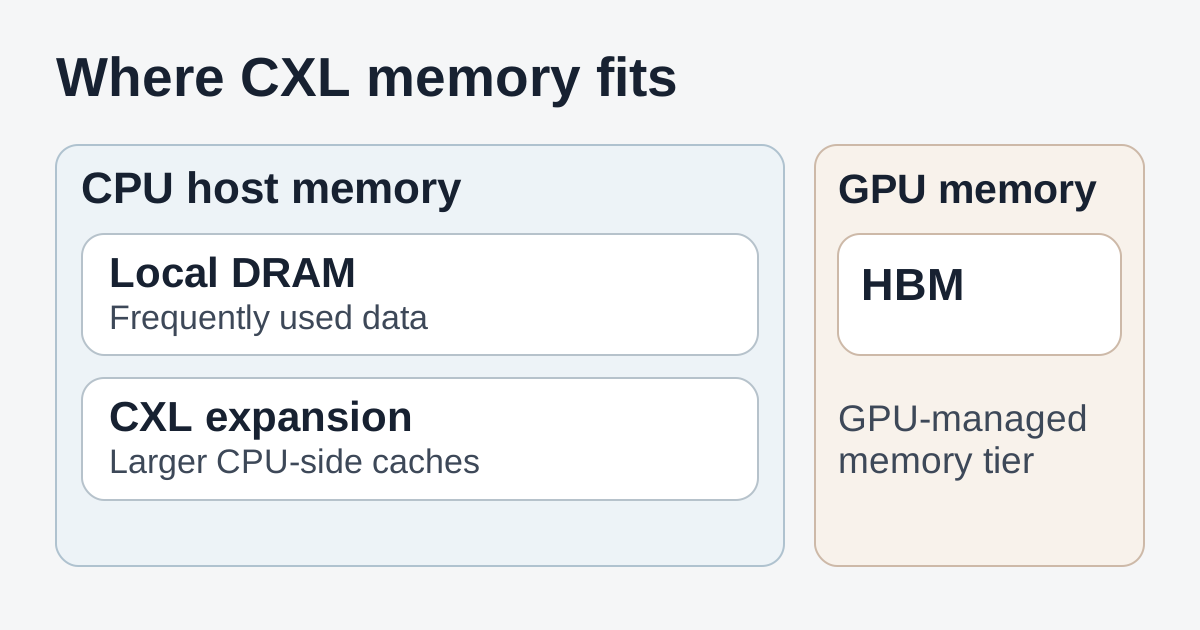
Häufig genutzte Seiten können im lokalen DRAM bleiben, größere CPU-seitige Caches auf der Erweiterungsebene liegen. Der Hochbandbreitenspeicher des Beschleunigers hat eigene Kapazitäts- und Bandbreitengrenzen.
Im Suchbeispiel könnte das Team oft gelesene Indexdaten im lokalen DDR5 halten und einen größeren, seltener gelesenen Cache mit Passagen oder Suchergebnissen auf die CXL-Ebene legen. Hat der Dienst die passenden Stellen gefunden, übergibt das Inferenz-Backend sie an ein Modell auf der GPU. Modellgewichte und Daten, die ein Beschleuniger-Kernel benötigt, müssen weiterhin dort Platz finden, wo die Inferenz-Engine auf sie zugreift. Die CXL-Erweiterung in diesen Ankündigungen vergrößert den Hostspeicher. Der Hochbandbreitenspeicher der GPU, kurz HBM, bleibt eine separate Ressource.
Zeichnen Sie zunächst auf, in welchen Phasen die Anfragen Zeit verbringen. Wartet die CPU wiederholt auf Daten, die aus ihrem Cache verdrängt wurden, kann mehr Hostspeicher solche Zugriffe vom Datenträger fernhalten. Verbringt das Modell die meiste Zeit mit dem Lesen von Gewichten aus dem GPU-Speicher und wartet der Host selten, dürfte sich derselbe Kauf kaum auf die Antwortzeit auswirken. Eine schnellere Suche kann auch bei gleicher Modellgeschwindigkeit spürbar sein. Messen Sie beide Abschnitte, bevor Sie Änderungen im Gesamtdienst einem davon zuschreiben.
Netlists drei Prototypen erfüllen unterschiedliche Aufgaben
Für die Wiederverwendung von DDR4 ist Netlists NVvault-D4 der interessante Entwurf. Das Consortium nennt virtuelle Maschinen, In-Memory-Datenbanken, Hochleistungsrechnen und Unternehmensanwendungen als Zielbereiche. Ein Virtualisierungshost liefert ein konkretes Beispiel. Seine aktivsten Gastsysteme könnten im lokalen Speicher bleiben, während das Team testet, ob seltener genutzte Gastseiten auf der Erweiterungsebene liegen können. Ein Datenbankteam könnte Teile eines Lesecaches nach demselben Prinzip verteilen. Die Datenbank müsste Seiten für latenzempfindliche Abfragen möglichst nah an der CPU halten. Solche Pilotversuche bieten sich für die zusätzliche Kapazität an. Die Vorschau enthält keine Ergebnisse für konkrete Arbeitslasten. Vorschau des CXL Consortium zu Netlist
Die beiden anderen Netlist-Entwürfe zeigen, weshalb die genaue Bezeichnung wichtig ist. NVvault-HM nutzt DRAM als Cache vor NAND-gestützter Speicherkapazität. Die Ankündigung nennt Datentransfers und Telemetrie sowie Anwendungen wie KI-Key-Value-Caches und Analytik. NVvault-PM ist ein eigener CXL-Type-3-Entwurf mit DRAM, NAND-Sicherung und einer integrierten Energiequelle für den Umgang mit Stromausfall. Die Vorschau sieht PM unter anderem für den Erhalt von Key-Value-Caches, Checkpoints und die Wiederherstellung vor. Teams, die Sicherung oder Persistenz prüfen, brauchen Angaben dazu, wie sich das jeweilige Design unter ihren Fehlerbedingungen verhält. Die Ankündigung liefert keinen Hinweis darauf, dass D4 die Speicher- oder Wiederherstellungsfunktionen der anderen Entwürfe übernimmt. Vorschau des CXL Consortium zu Netlist
Der Key-Value-Cache eines Sprachmodells bietet einen separaten KI-Test. Darin liegen Attention-Daten früherer Tokens, damit das Modell sie wiederverwenden kann. Unterstützt eine Inferenz-Engine die Auslagerung in den Hostspeicher, könnte sie Cache-Seiten inaktiver Sitzungen aus dem GPU-Speicher verschieben und bei Wiederaufnahme zurückladen. Ein Team kann messen, ob der zusätzliche Hostspeicher mehr Sitzungen vorhält und wie viel Zeit die Übertragung bei einer fortgesetzten Anfrage kostet. Platzierung und Datenkopien hängen von Engine und Server ab. Der Versuch illustriert, was sich mit einem mehrstufigen Hostspeicher untersuchen lässt. In Netlists Vorschau werden HM und PM ausdrücklich für KV-Caches genannt.
Marvells Ankündigung zeigt eine zweite Umsetzung, die der Einkauf verfolgen kann. Die Partner wollen Systeme mit DDR4 und DDR5 auf Basis der Structera-X-Controllerfamilie zeigen. Das Ausstellungsprogramm und das Pressematerial geben Kontext zur Messe und zur Produktfamilie. Zu klären bleibt, welche Serverkonfigurationen ein Anbieter qualifiziert, welche Speichermodule sie aufnehmen und wie der Anbieter das Gesamtsystem betreut. Die Chipbilder im Pressepaket sind Referenzmaterial für die Produktfamilie. Programm des CXL Consortium für den SC26-Pavillon · Marvells Ankündigung zur SC26 · Pressepaket zur Marvell-Structera-Familie
Zuerst die langsamen Anfragen messen
Ein Durchschnittswert kann die Anfragen verbergen, die eine Anwendung träge wirken lassen. In der Suche sorgen beliebte Dokumente womöglich den ganzen Tag für schnelle Treffer. Seltenere Dokumente können dieselben Worker dagegen wiederholt auf die Erweiterungsebene schicken. Für eine nächtliche Indexierung im Batch ist eine höhere Latenz bei den langsamsten Anfragen womöglich vertretbar. Wer auf ein Suchergebnis wartet, kann sie sofort bemerken. Die Speicherlösung muss bei Spitzenlast an den tatsächlichen Zielwerten des Dienstes gemessen werden.
Das unabhängige Forschungsteam hinter der MELODY-Studie machte diesen Punkt 2025 greifbar. Es untersuchte 265 Arbeitslasten mit vier realen CXL-Speichergeräten, fünf CPU-Plattformen und sieben Latenzstufen. Getestet wurde die Empfindlichkeit in einem Submikrosekundenbereich von 140 bis 410 Nanosekunden. Arbeitslast, Latenz am oberen Ende der Verteilung und CPU-Verhalten beeinflussten, wie die Systeme mit CXL-Speicher umgingen. Die Arbeit bezeichnet die getesteten Geräte als CXL-A bis CXL-D. Aus den Resultaten lässt sich keine Leistungsprognose für die zur SC26 angekündigten Systeme ableiten. Die Studie zeigt dem Einkauf, weshalb eine durchschnittliche Latenz oder ein gutes Benchmark-Ergebnis allein keine Aussage über das Verhalten eines konkreten Servers erlaubt. MELODY-Studie auf der ASPLOS 2025 · Vollständige Studie
Wenn die Plattform es zulässt, planen Sie drei Vergleichsmessungen. Reproduzieren Sie zuerst den aktuellen Dienst auf dem vorhandenen lokalen DRAM. Testen Sie danach zusätzliche Kapazität mit Hostspeicher auf zwei Ebenen. Nutzen Sie schließlich dieselbe Gesamtkapazität ausschließlich als lokalen Speicher, um die Ergebnisse mit CXL einordnen zu können. Ein reines Rechenbeispiel für die Auslegung wären 256 GiB lokales DRAM plus 256 GiB nutzbare Erweiterung im Vergleich mit 512 GiB lokalem DRAM. Halten Sie Anwendung, Datensatz, Softwareeinstellungen und angebotene Last vergleichbar. Protokollieren Sie Unterschiede bei Plattform oder lokalen Speicherkanälen, die sich technisch nicht vermeiden lassen. Wenn Ihre betriebliche Alternative darin besteht, auf den Datenträger auszulagern oder die Daten auf einen weiteren Host zu verteilen, messen Sie auch deren Dauer und Kosten.
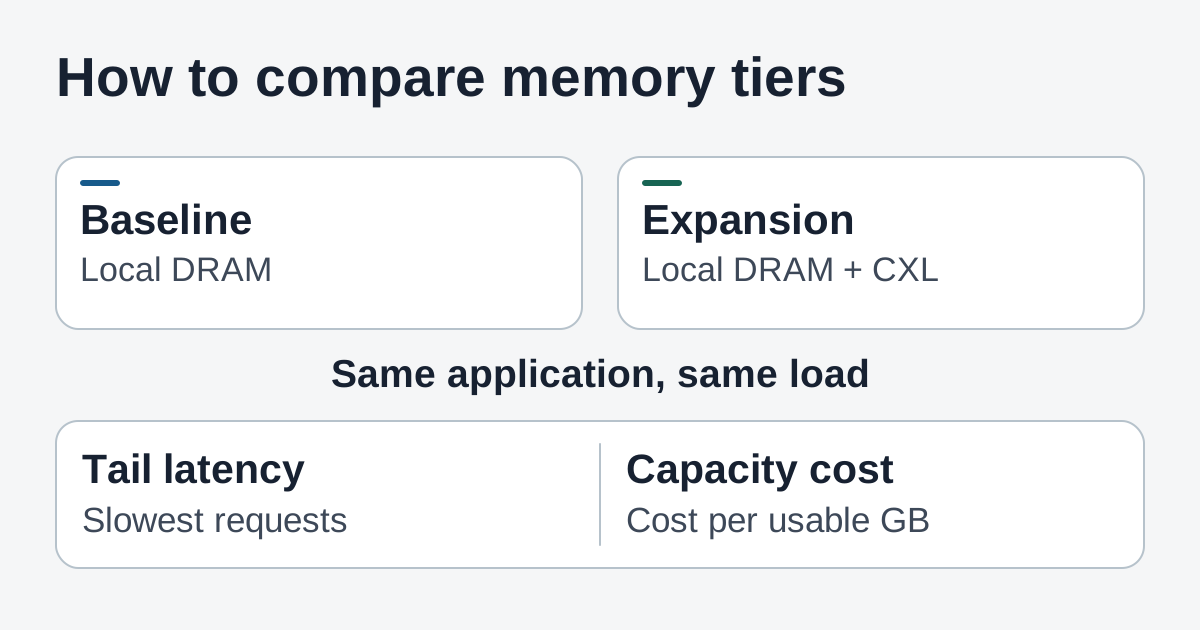
Vergleichen Sie dieselbe Arbeitslast und denselben Verkehr. Prüfen Sie die langsamsten Anfragen und die Kosten je nutzbarer Kapazitätseinheit.
- Verkehr wiedergeben, der den Cache füllt. Verwenden Sie eine realistische Mischung aus Anfragen auf oft und selten genutzte Dokumente. Messen Sie aus einem Kaltstart und erneut mit aufgewärmtem Cache. Beobachten Sie bei gleicher Parallelität Median, p95 und p99 der Antwortzeiten, Fehlerrate und Durchsatz. Bei einer KI-Suche sollten Abruf und Inferenz getrennt erfasst werden, damit eine schnellere Stufe eine langsamere nicht verdeckt.
- Prüfen, welche Daten tatsächlich verschoben wurden. Untersuchen Sie die Speicherbelegung nach Ebene und CPU-NUMA-Knoten, soweit verfügbar auch die Migration und Rückgewinnung von Speicherseiten sowie die Verbindungs- und Gerätezähler der Plattform. In einem scheinbar guten Lauf könnten fast alle Anfragen im lokalen DRAM geblieben sein. Bei einem scheinbar schlechten Lauf könnten häufig gelesene Indexseiten standardmäßig auf der entfernten Ebene gelandet sein. Notieren Sie die Platzierungsstrategie zu jeder Messreihe.
- Einen Nachmittag mit hoher Last nachstellen. Starten Sie einen zweiten Job, während der interaktive Dienst stark ausgelastet ist. Wärmen Sie den Cache nach einem Neustart auf und beobachten Sie den Dienst beim Erreichen seiner Speichergrenzen. Prüfen Sie, wie das Betriebssystem Geräte- und Speicherfehler meldet, wie der Betrieb den betroffenen Host findet und wie der Dienst zur bisherigen Zuteilungsstrategie zurückkehrt. Die Wiederherstellung gehört bei jeder Konfiguration in den Pilotversuch, die das Team später betreuen müsste.
- Abnahmekriterien vor dem Blick auf die Diagramme festlegen. Beginnen Sie mit den aktuellen p99- und Fehlerzielen. Halten Sie fest, wie viel zusätzliche Kapazität bei diesen Zielen nutzbar sein muss und in welchen Fällen eine langsamere Wiederherstellung akzeptabel ist. Wenn ein System die Ziele nur mit einer hohen Cache-Trefferrate erreicht, prüfen Sie anhand von Traces besonders stark ausgelasteter Tage, ob diese Quote im Betrieb hält.
Die Gesamtkosten der Wiederverwendung berechnen
Vorhandene DIMMs können die Position für Speicher im Angebot günstiger aussehen lassen. Hinzu kommen jedoch Erweiterungsgerät, ein unterstützter Host oder dessen Aufrüstung, qualifizierte Module sowie Personalaufwand für Einführung und Betrieb. Das Gerät braucht auch einen passenden Steckplatz oder eine geeignete Plattformanbindung. Prüfen Sie, wie die geplante Verteilung der PCIe-Lanes zu Datenträgern, Netzwerk und Beschleunigern passt. Eine Speichererweiterung ist weniger attraktiv, wenn dadurch Ressourcen wegfallen, die dieselbe Arbeitslast zum Datentransport benötigt.
Berechnen Sie die Kosten je nutzbarem GiB beim geforderten Serviceniveau. Berücksichtigen Sie jede von der Plattform reservierte Kapazität und Platz, den Sie freihalten müssen, damit genug Seiten lokal bleiben. Rechnen Sie Strom, Kühlung, Qualifizierung der Serverflotte, Ersatzteile und Support über die geplante Nutzungsdauer ein. Klären Sie, wer die Firmware aktualisiert und wie das System Zustandsdaten und Speicherfehler meldet. Erledigt der Host damit Arbeit, für die sonst Daten ausgelagert oder ein zusätzlicher Rechner benötigt würden, quantifizieren Sie diese Einsparung und den Aufwand beider Optionen. Ein einfacher Versuch macht den Vergleich konkret. Betreiben Sie den Dienst auf beiden Architekturen bei seiner höchsten Anfragerate und vergleichen Sie die Kosten, um das Antwortzeitziel einzuhalten.
Nach der SC26 sind qualifizierte Konfigurationen, dokumentierte Modulfreigaben, Softwarekompatibilität und Traces aus realen Arbeitslasten interessant. Ein verfügbares System könnte Teams mit einem großen sekundären Arbeitssatz eine weitere Möglichkeit geben, einen bestehenden Server auszubauen. Das überzeugendste Beispiel wäre ein Dienst, der mehr Dokumentdaten im Hostspeicher hält, wiederholte Datenträgerzugriffe vermeidet und zu geringeren Kosten seine bisherige p99-Grenze einhält. Ein solches Ergebnis liefert eine Grundlage, um die Kaufentscheidung beim nächsten Server zu wiederholen.
Quellen
- Vorschau des CXL Consortium zu Netlist auf der SC26 vom 10. November 2026
- Marvells Ankündigung zu Partnern und Konnektivität auf der SC26 vom 13. November 2026
- Programm und Veranstaltungsgrafiken des CXL Consortium zur SC26
- Pressepaket zur Produktfamilie Marvell Structera
- Offizielles Programm und Ausstellungstermine der SC26
- MELODY-Studie und Publikationsangaben, ASPLOS 2025 · Vollständige Studie
Wenn Sie Pilotnotizen, Traces und Kaufentscheidungen gemeinsam ablegen möchten, können Sie ein Telli.sh-Konto erstellen.