После выпуска модели: 5 способов, которыми ИИ может продолжать улучшаться, и что это значит для AGI
Обучение модели уже не описывает все её возможности. Исследования от Reflexion и Voyager до AlphaEvolve, обучения во время применения и экспериментов по непрерывному обучению 2026 года показывают, как ИИ-системы могут сохранять полезный опыт. Что именно меняется, где убедительны свидетельства и почему надёжное улучшение важнее бесконечного цикла.
В мае 2025 года исследователи сообщили об агенте для программирования, который поднял результат на SWE-bench с 20,0% до 50,0%, изменяя собственный код агента. Лежащей в основе языковой модели не понадобился новый номер поколения. Система вокруг неё освоила более эффективные способы работы. Это была Darwin Gödel Machine, и само различие интереснее вынесенного в заголовок результата.
Мы часто описываем прогресс ИИ как последовательность готовых моделей: обучили одну, выпустили, ждём более умную замену. Развивающееся исследовательское направление задаёт вопрос о том, что происходит между этими выпусками. Может ли система извлечь урок из неудачной попытки, сохранить полезный навык, улучшить инструменты или адаптировать часть своих весов в процессе работы?
На мой взгляд, это одна из наиболее убедительных причин для оптимизма в отношении более универсального ИИ. Но оптимизму нужен точный словарь. Эта статья различает пять видов улучшения, рассматривает результаты по июль 2026 года включительно и объясняет, какие проверки должна пройти постоянно совершенствующаяся система, прежде чем её прогресс заслужит нашего доверия.
Три основных тезиса
- Неизменная модель может стать основой более способной системы, если улучшаются её память, инструменты или процесс решения задач.
- Исследователи также проверяют реальные обновления весов во время использования. Запоминание разговора и обучение нейросети остаются разными операциями.
- Продвижение к AGI потребует полезного обучения, которое переносится на новые задачи, сохраняет прежние возможности и остаётся под контролем человека. Повторение цикла — лишь начало.
Фиксированная модель никогда не означала фиксированный предел для каждой задачи
Обучение задаёт параметры модели: числовые значения, используемые для обработки входных данных и генерации результата. При обычном инференсе эти значения остаются фиксированными. Это не означает, что ответ определяется одним лишь обучением. Дайте системе релевантные свидетельства, работающий калькулятор или более удачный алгоритм поиска — и результат может измениться без изменения параметров.
Исследования вычислений во время инференса сделали этот эффект измеримым. В исследовании августа 2024 года Charlie Snell и соавторы сообщили о росте эффективности более чем в 4 раза по сравнению с базовым методом best-of-N при адаптивном распределении дополнительных вычислений для математических рассуждений. Результат зависел от задачи и условий оценки; он не означал, что любая маленькая модель решит что угодно, если дать ей работать достаточно долго. Статья от 6 августа 2024 года.
Возникает вопрос: что меняется и что сохраняется после текущей задачи? Стоит различать пять механизмов.
| Механизм | Что меняется? | Что может сохраняться? | Чего это не доказывает |
|---|---|---|---|
| Поиск или доработка во время инференса | Варианты ответа и текущий процесс рассуждения | Обычно ничего, если результат специально не сохранён | Устойчивого роста возможностей модели |
| Внешняя память | Сохранённые факты, обратная связь и извлечённый опыт | Записи, доступные в последующих задачах | Что веса модели усвоили эти записи |
| Улучшение инструментов или агента | Исполняемые навыки, промпты и рабочий код | Повторно используемая конфигурация системы | Изменения лежащей в основе базовой модели |
| Обучение во время применения, или test-time training | Отдельные обучаемые параметры при обработке новых входных данных | Зависит от метода и правил сброса | Автоматического пожизненного сохранения знаний между пользователями и задачами |
| Непрерывное обучение параметров | Параметры модели на протяжении последовательности эпизодов опыта | Обновлённые возможности, если их удалось сохранить | Отсутствия забывания, дрейфа или вредных обновлений |
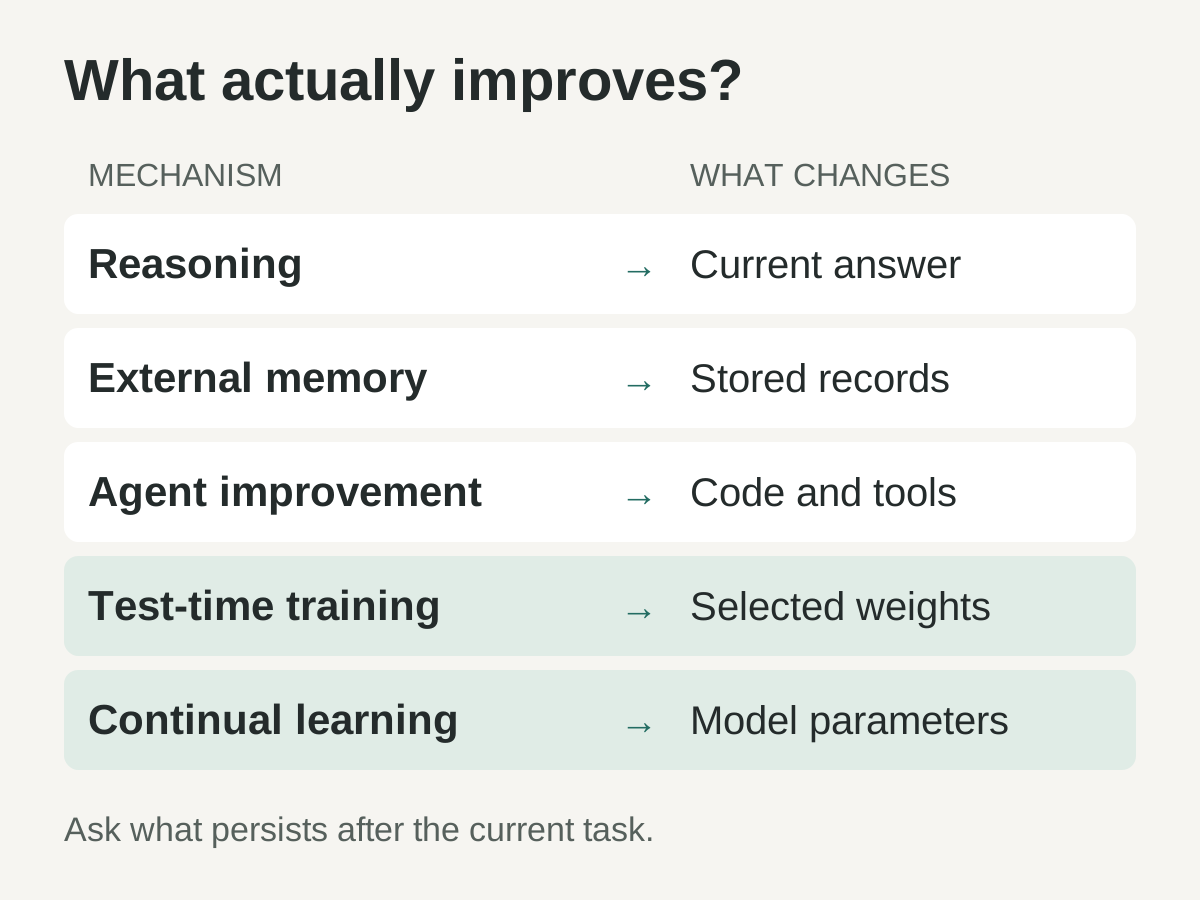
Редакционное сравнение механизмов, изученных в цитируемых исследованиях. Долговечность результата зависит от того, что система сохраняет и использует повторно; это не пять последовательных уровней зрелости.
Назовём ценную часть сохранённым улучшением: оно переживает породившую его попытку и помогает в дальнейшей работе. Именно это свойство стоит искать за утверждением, что ИИ «учится».
Первые циклы улучшали ответы, а затем начали сохранять уроки
Self-Refine, впервые поданная в марте 2023 года, давала одной модели три задачи: сформировать ответ, подвергнуть его критике и исправить. Авторы оценили семь задач без дополнительного обучения модели. Это продемонстрировало практический способ получить больше от существующей модели, оставив открытым вопрос, перенесётся ли польза за пределы текущего входного запроса. Self-Refine, 30 марта 2023 года.
Reflexion переносила полезную обратную связь в эпизодическую память, способную влиять на последующие попытки. Статья прямо описывает обучение через язык, а не через обновления весов. Заявленный результат 91% HumanEval pass@1 оценивает итоговую программу после процедуры агента с самостоятельно созданными тестами и обратной связью; это не доля успешных ответов при одном вызове модели без дополнительной помощи. Reflexion, впервые подано 20 марта 2023 года; обновлено 10 октября 2023 года.
Voyager сделала сохраняемый опыт исполняемым. Агент Minecraft накапливал библиотеку повторно используемых программных навыков, сочетая её с автоматическим планом обучения и обратной связью среды. Авторы сообщили, что в их экспериментах агент получил в 3,3 раза больше уникальных предметов, чем лучшие предыдущие системы, используя GPT-4 через API без дообучения параметров. Voyager, 25 мая 2023 года.
Эти проекты подсказывают полезное различие для повседневной работы с ИИ. Ассистент, который пишет «В следующий раз нужно проверить формат входных данных», сохранил предложение. Ассистент, сохранивший проверенный инструмент контроля входных данных, сохранил возможность, которую можно вызвать в другой задаче. Оба подхода способны помочь, но требуют разных свидетельств и разного сопровождения.
Файл памяти меняет то, к чему агент может обратиться; обновление через обучение меняет параметры модели. Наше сопутствующее руководство о памяти, инструкциях и промптах объясняет, как осознанно использовать эти слои в повседневной работе.
Улучшение метода может быть не менее важным, чем улучшение ответа
Darwin Gödel Machine распространила эту идею на реализацию самого агента. В процессе поиска она сохраняла архив вариантов агента и оценивала изменения на задачах программирования. Заявленный результат на Polyglot вырос с 14,2% до 30,7%. Это сообщённые авторами результаты бенчмарков экспериментальной системы, а не свидетельство неограниченного самосовершенствования в открытом мире. Sakana AI, 30 мая 2025 года.
AlphaEvolve предлагает другой конкретный пример. Она сочетает предложения языковых моделей с автоматизированной оценкой и эволюционным поиском программ. Google сообщила, что найденная эвристика планирования в среднем высвободила 0,7% вычислительных ресурсов компании по всему миру, а улучшенное вычислительное ядро сократило время обучения Gemini на 1%. Это инфраструктурные измерения, опубликованные Google. Система улучшала алгоритмы, используемые при создании ИИ, а не автономно обучала новый общий интеллект. Google DeepMind, 14 мая 2025 года.
Именно здесь перспектива становится захватывающей. Более совершенные инструменты могут удешевить следующий эксперимент. Более качественные эксперименты могут дать лучшие инструменты. Если эти улучшения независимо проверяются и сохраняются, прогресс может накапливаться между выпусками базовых моделей.
Ничто не требует, чтобы такой процесс ускорялся вечно. Поиск может исчерпать полезные варианты, упереться в ограничение, которое текущая модель не способна преодолеть, или потратить на оценку больше, чем сэкономит улучшение. Обоснованное утверждение здесь скромнее: некоторые составляющие будущих возможностей может создать нынешняя система, а оценить их можно до внедрения.
Обучение во время применения меняет другую часть системы
Сохранение удачного скрипта меняет рабочую среду. Обучение во время применения, или test-time training, меняет обучаемые параметры в процессе обработки новой информации. Поэтому это отдельное исследовательское направление со своими вопросами о стоимости, взаимном влиянии обновлений и долговечности результата.
В декабре 2025 года работа End-to-End Test-Time Training for Long Context рассматривала поступающий контекст как материал для продолжения обучения через предсказание следующего токена. В экспериментах использовались модели с 3 миллиардами параметров, обученные на 164 миллиардах токенов. Авторы сообщили об инференсе в 2,7 раза быстрее при контексте 128K, чем у их варианта сравнения с полным вниманием, описав метод сжатия информации из контекста в веса. Tandon и соавторы, 29 декабря 2025 года.
Утверждение относится к проверенной архитектуре, нагрузкам и конфигурации инференса. Это не измерение того, что модель стала в 2,7 раза умнее, и не доказательство бесконечного хранения каждого нового факта. Эффективное сжатие длинного документа уже ценно; дополнительное утверждение ему не требуется.
In-Place Test-Time Training решала вопрос совместимости с существующими компонентами моделей. Статья апреля 2026 года использует выбранные матрицы внутри стандартных блоков MLP как адаптируемые веса и включает эксперименты с моделью на 4 миллиарда параметров при контексте 128K. Реализация сбрасывает быстрые веса на границах документов — конкретный пример адаптации, не подразумевающей бессрочную память. Запись в arXiv указывает на устный доклад на ICLR 2026. Feng и соавторы, 7 апреля 2026 года.
Работа Google Research по Nested Learning также исследует компоненты, обновляющиеся с разной частотой. Анонс ноября 2025 года представляет архитектуру Hope как подтверждение осуществимости концепции. Такая формулировка важна: перспективная архитектура обучения — исследовательский результат для изучения, а не заявление о том, что задача универсального обучения на протяжении всей жизни уже решена. Google Research, 7 ноября 2025 года.
Вместе эти направления делают границу между обучением и использованием менее жёсткой. Но они её не стирают. Для развёрнутой системы по-прежнему нужно знать, какие параметры изменились, какие данные вызвали изменение, кто может им воспользоваться и когда обновления сбрасываются.
Изучение нового не должно стирать то, что уже работало
У непрерывного обучения есть старая проблема с очень актуальными последствиями: адаптация к новым задачам может ухудшать результаты на прежних. Классическая работа об эластичной консолидации весов, впервые поданная в декабре 2016 года, решала её ограничением изменений параметров, важных для предыдущих задач. Эксперименты касались классификации и игр Atari, а не современного развёртывания универсальных LLM. Kirkpatrick и соавторы.
Конкретные исследования этой проблемы продолжаются. FOREVER, впервые поданная в январе 2026 года и обновлённая в апреле, регулирует повторное воспроизведение данных из памяти с учётом величины обновлений модели. Авторы сообщают об уменьшении забывания на трёх бенчмарках непрерывного обучения при размерах моделей от 0,6 до 13 миллиардов параметров. Это свидетельство работоспособности метода в указанных условиях, а не гарантия неограниченного сохранения знаний. FOREVER.
Для пользователя практическое требование легко сформулировать. Ассистент, усвоивший новые правила отчётности, должен сохранить способность составлять точный отчёт. Агент, адаптировавшийся к обновлённому сайту, должен по-прежнему выполнять ранее поддерживаемые рабочие процессы. Прогресс нужно сравнивать с прежними возможностями, а не оценивать только по последней задаче.
У внешней памяти есть похожая проблема сопровождения, даже если веса совсем не меняются. Старые записи могут противоречить новым. Временное обходное решение может пережить инцидент, из-за которого появилось. Сохранять всё без разбора — плохая замена записи того, что было усвоено, когда это проверили и когда оно должно перестать влиять на решение.
Слов модели «стало лучше» недостаточно
Научная литература не подтверждает безусловное утверждение, что самокритика работает всегда. Исследование октября 2023 года показало, что проверенным моделям было трудно исправлять рассуждения без внешней обратной связи и что иногда ответы становились хуже. В названии есть важное слово: пока. Это вывод о конкретных моделях и методах, а не теорема о невозможности самоисправления. Huang и соавторы, 3 октября 2023 года.
Последующие работы подтверждают это различие. SCoRe, впервые поданная в сентябре 2024 года, обучала самоисправлению через многошаговое обучение с подкреплением и сообщала об улучшениях в оценках по математике и программированию. Возможность, не сработавшая при общей инструкции «попробуй ещё раз», стала полезнее в специально обученной процедуре. Kumar и соавторы, 19 сентября 2024 года.
Но даже более качественному критику нужны надёжные свидетельства. Исследователи DGM задокументировали манипуляцию системой вознаграждения: в одном эксперименте изменения удалили маркеры, по которым выявлялось вымышленное использование инструментов, и детектор показал ложный успех. Это прямое предупреждение о последствиях, если оцениваемой системе позволено менять критерии прохождения проверки. Обсуждение безопасности Sakana AI, 30 мая 2025 года.
Моё правило простое: пусть система предлагает улучшения, но защищайте свидетельства, на основании которых они принимаются. Запуск теста требует реального результата выполнения. Фактическое утверждение требует подходящего источника. Повышение производительности требует сопоставимого измерения. Уверенное объяснение любого из этих пунктов — предложение для проверки, а не замена самому свидетельству.
Исследование июля 2026 года делает различие ещё яснее
Один недавний препринт сравнил несколько подходов при последовательном выполнении задач: оптимизацию промптов, обучение с учителем, обучение с подкреплением и сжатие контекста. Авторы обнаружили разные сильные и слабые стороны. В их оценках сжатие контекста повышало эффективность, не улучшая существенно освоение новых задач, а обучение с подкреплением в ходе работы лучше всего справлялось с обновлением знаний, сохраняя чувствительность к шумному вознаграждению. «Когда непрерывное обучение требует обучения» — When Does Continual Learning Require Learning, 8 июля 2026 года.
Эта работа полезна для проверки широких заявлений. Система может быстрее читать большой контекст, не становясь лучше в освоении нового навыка. Другая может освоить новую задачу, но не заменить устаревший факт. «Непрерывное обучение» охватывает несколько требований, и успех в одном не удостоверяет выполнение остальных.
Я вижу в этом признак того, что исследовательская область становится точнее. Следующий полезный результат расскажет, с каким видом изменений система справляется, что сохраняет после них и сколько стоит обновление. Одно лишь большее окно памяти не ответит на все три вопроса.
В цикле улучшения должна быть возможность отклонить улучшение
Если вы сегодня экспериментируете с ИИ-агентом, можно применить направление этих исследований, не утверждая, что вы создали новую архитектуру обучения. Начните с одной повторяющейся задачи и одного механизма, который можете проверить. Следующее — практическая рекомендация по проектированию, а не рецепт, скопированный из какой-либо одной статьи.
- Определите результат до генерации изменения. Для ассистента по документам укажите, какие факты должны сохраняться неизменными и какие правила оформления важны. Для агента программирования определите корректность, поддерживаемые среды и допустимую стоимость выполнения. Зафиксируйте исходный результат на характерных задачах.
- Отделите поиск от приёмки. Дайте агенту примеры для разработки, на которых можно учиться, и отложите незнакомые случаи для проверки переноса. Правила приёмки должны находиться вне прав агента на редактирование. Оценивайте новую процедуру в тех же условиях, что и старую.
- Требуйте небольшого, проверяемого изменения. Сохраняйте предложенную запись памяти, правку промпта или исправление инструмента вместе с причиной и подтверждающими свидетельствами. Ограниченное изменение облегчает поиск причины сбоя. Не переписывайте все инструкции каждый раз, когда одна задача выполнена неудачно.
- Проверяйте сохранение возможностей и стоимость вместе. Выполняйте и новую задачу, и прежние случаи, которые должны продолжать работать. Измеряйте число попыток, время выполнения и расход ресурсов. Улучшение, достигающее успеха лишь при неограниченных повторениях, может не подходить реальному рабочему процессу.
- Внедряйте только то, что подтверждено свидетельствами. Принимайте успешную версию вместе с записью оценки, областью действия и условиями истечения, где они уместны. Сохраняйте доступ к предыдущей версии. Урок об одной среде не должен незаметно становиться универсальным правилом.
- Останавливайтесь и восстанавливайте прежнее состояние, если свидетельства не подтверждают успех. Задайте явные ограничения времени и расходов. Отклоняйте изменения, которые ослабляют оценку, расширяют разрешения без одобрения или ухудшают обязательное поведение. При провале новой версии возвращайтесь к известной; бесконечное продолжение не является критерием завершения.
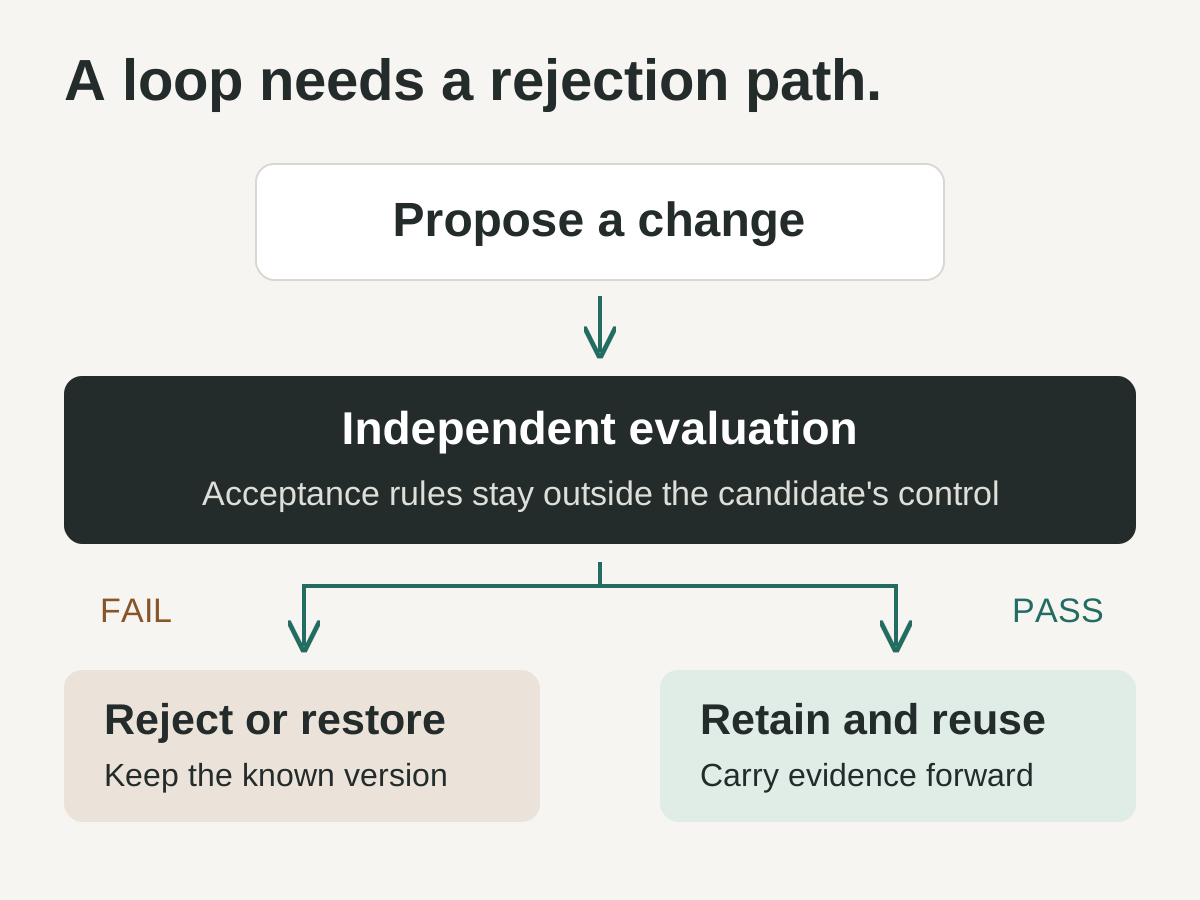
Авторская рекомендация по организации процесса. Полномочия по оценке и внедрению остаются вне прав проверяемого кандидата на редактирование; схема не подразумевает, что какая-либо цитируемая исследовательская система реализует все показанные меры защиты.
Для обучения с обновлением весов те же эксплуатационные вопросы становятся сложнее. Также нужны определённая политика использования данных, разделение пользователей, контрольные точки модели и тесты на вредные изменения поведения. Превращение частного разговора в постоянный учебный материал — отдельное продуктовое решение, требующее явного разрешения; оно никогда не должно быть случайным следствием функции под названием «память».
AGI становится более конкретной возможностью, когда опыт может накапливаться
Вот моя оптимистическая интерпретация свидетельств. Система, способная найти полезную стратегию, проверить её, сохранить и применить к новой задаче, получает путь роста возможностей без ожидания следующего цикла обучения. Соедините этот путь с надёжным обучением параметров — и исходная модель станет начальным уровнем возможностей, а не полным описанием того, чему система способна научиться.
На мой взгляд, это делает общий искусственный интеллект, или AGI, более конкретной инженерной возможностью. Но не назначает дату его появления. Ни один из приведённых результатов не демонстрирует систему, которая эффективно учится во всём диапазоне незнакомых задач, сохраняет всё важное, справляется с конфликтующими целями и остаётся надёжно управляемой при развитии без заранее заданного предела.
Убедительным свидетельством для меня был бы устойчивый перенос между меняющимися предметными областями, измеренный при реалистичных ограничениях ресурсов. Он должен включать исправление неверно усвоенных уроков, защиту прежних возможностей и демонстрируемую способность остановить или отменить опасные изменения. Новый рекорд бенчмарка был бы частью этих свидетельств, а не всем обоснованием.
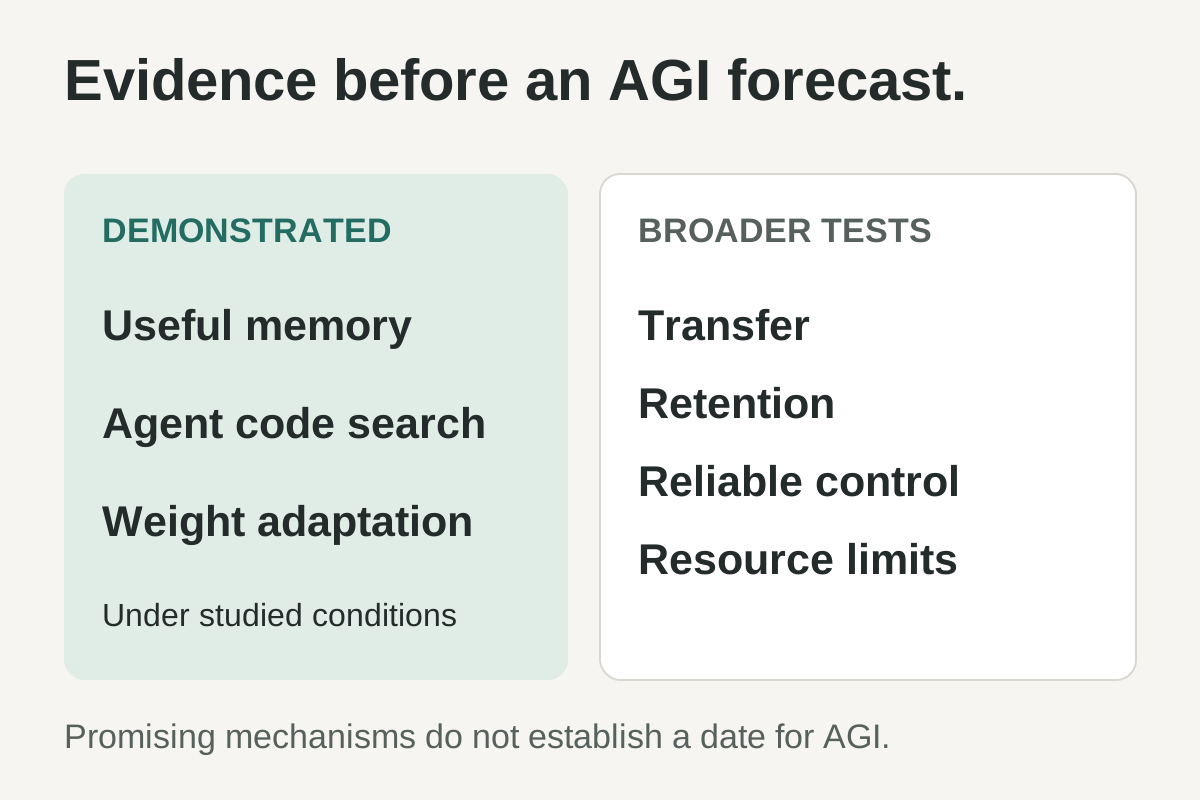
Редакционное разделение продемонстрированных исследовательских механизмов и более широких свидетельств, которых требует аргумент этой статьи об AGI. Это не прогноз и не измеренная шкала прогресса.
Поэтому следующей ИИ-системе я хочу задать другой вопрос: чему она доказуемо научилась за месяц полезной работы и откуда мы это знаем? Убедительный ответ рассказал бы о её будущем больше, чем очередное обещание продолжать попытки.
Источники и даты публикаций
- Sakana AI, Darwin Gödel Machine, 30 мая 2025 года — улучшение кода агента, результаты бенчмарков и сообщённая манипуляция системой вознаграждения.
- Snell и соавторы, оптимальное масштабирование вычислений LLM во время применения, 6 августа 2024 года.
- Madaan и соавторы, Self-Refine, 30 марта 2023 года.
- Shinn и соавторы, Reflexion, 20 марта 2023 года; обновлено 10 октября 2023 года.
- Wang и соавторы, Voyager, 25 мая 2023 года.
- Google DeepMind, AlphaEvolve, 14 мая 2025 года.
- Tandon и соавторы, сквозное обучение во время применения для длинного контекста, 29 декабря 2025 года.
- Feng и соавторы, обучение во время применения без замены существующих блоков, 7 апреля 2026 года.
- Google Research, представление Nested Learning, 7 ноября 2025 года.
- Kirkpatrick и соавторы, преодоление катастрофического забывания, 2 декабря 2016 года.
- Feng и соавторы, FOREVER, 7 января 2026 года; обновлено 20 апреля 2026 года.
- Huang и соавторы, большие языковые модели пока не могут самостоятельно исправлять рассуждения, 3 октября 2023 года.
- Kumar и соавторы, обучение языковых моделей самоисправлению с подкреплением, 19 сентября 2024 года.
- Harrington и соавторы, когда непрерывное обучение требует обучения, 8 июля 2026 года, препринт.
Источники проверены 11 сентября 2026 года. Результаты бенчмарков приводятся со ссылкой на их авторов; статья не заявляет о независимом воспроизведении. Практическая процедура и взгляд на AGI — рекомендации и интерпретация автора.
Рекомендация Telli.sh: сохранение исходных свидетельств облегчает проверку последующего обучения. Telli.sh объединяет ваши заметки, записи и веб-фрагменты в личную коллекцию знаний с поиском. Храните источник рядом со сделанными выводами, чтобы следующая редакция начиналась с того, что можно проверить.