Depois do lançamento: 5 formas de a IA continuar melhorando e o que elas significam para a AGI
O treinamento de um modelo já não explica sozinho todas as suas capacidades. Pesquisas sobre Reflexion, Voyager, AlphaEvolve, treinamento durante a inferência e aprendizado contínuo em 2026 mostram como sistemas de IA podem preservar experiências úteis. O que realmente muda, onde as evidências são fortes e por que melhorar com confiabilidade importa mais do que repetir um ciclo sem fim.
Em maio de 2025, pesquisadores apresentaram um agente de programação que elevou seu desempenho no SWE-bench de 20,0% para 50,0% alterando o próprio código do agente. O modelo de linguagem por trás dele não precisou ganhar uma nova geração. O sistema ao seu redor havia aprendido formas melhores de trabalhar. Era a Darwin Gödel Machine, e essa distinção é mais interessante do que a pontuação da manchete.
Costumamos descrever o avanço da IA como uma sequência de modelos prontos: treinar um, lançá-lo e esperar uma versão mais inteligente. Uma linha de pesquisa cada vez mais ampla pergunta o que acontece entre esses lançamentos. Um sistema pode aprender com uma tentativa malsucedida, preservar uma habilidade útil, melhorar suas ferramentas ou adaptar parte dos seus pesos enquanto trabalha?
Na minha avaliação, esse é um dos motivos mais concretos para ter otimismo em relação a uma IA mais geral. Mas o otimismo precisa de um vocabulário preciso. Este artigo separa cinco tipos de melhoria, examina resultados publicados até julho de 2026 e explica quais testes um sistema que melhora continuamente precisa superar para que seu progresso mereça nossa confiança.
O argumento em três pontos
- Um modelo que permanece igual pode fazer parte de um sistema mais capaz quando sua memória, suas ferramentas ou seu processo de resolução de problemas melhoram.
- Pesquisadores também estão testando atualizações reais dos pesos durante o uso. Lembrar uma conversa e treinar uma rede neural continuam sendo operações diferentes.
- Avançar em direção à AGI exigiria aprendizado útil que se transfira, preserve capacidades anteriores e permaneça sob controle humano. Repetir um ciclo é apenas o começo.
Um modelo fixo nunca foi um limite fixo para todas as tarefas
O treinamento estabelece os parâmetros de um modelo: os valores numéricos usados para processar uma entrada e gerar uma saída. Na inferência convencional, esses valores permanecem fixos. Isso não significa que a resposta dependa apenas do treinamento. Dê ao sistema evidências relevantes, uma calculadora que funcione ou um procedimento de busca melhor, e seu desempenho pode mudar sem alterar esses parâmetros.
A pesquisa sobre computação durante a inferência tornou essa ideia mensurável. Em um estudo de agosto de 2024, Charlie Snell e seus colegas relataram eficiência mais de 4 vezes maior do que a de uma referência best-of-N ao distribuir computação adicional de forma adaptativa para raciocínio matemático. O resultado dependia do problema e da configuração da avaliação; não dizia que qualquer modelo pequeno resolve qualquer coisa se ficar rodando por tempo suficiente. Artigo, 6 de agosto de 2024.
A pergunta passa a ser: o que muda e o que sobrevive à tarefa atual? Vale manter cinco mecanismos separados.
| Mecanismo | O que muda? | O que pode persistir? | O que isso não demonstra? |
|---|---|---|---|
| Busca ou revisão durante a inferência | Respostas candidatas e o raciocínio da tarefa atual | Normalmente nada, a menos que seja salvo explicitamente | Um aumento duradouro da capacidade do modelo |
| Memória externa | Fatos armazenados, feedback e experiências recuperadas | Registros disponíveis para tarefas posteriores | Que os pesos do modelo tenham aprendido esses registros |
| Melhoria de ferramentas ou do agente | Habilidades executáveis, instruções e código de trabalho | Uma configuração reutilizável do sistema | Uma mudança no modelo fundacional subjacente |
| Treinamento durante a inferência | Determinados parâmetros treináveis ao processar novas informações | Depende do método e da política de reinicialização | Retenção permanente e automática entre usuários e tarefas |
| Aprendizado contínuo de parâmetros | Os parâmetros do modelo ao longo de uma sequência de experiências | Capacidades atualizadas, se forem preservadas com sucesso | Ausência de esquecimento, desvios ou atualizações prejudiciais |
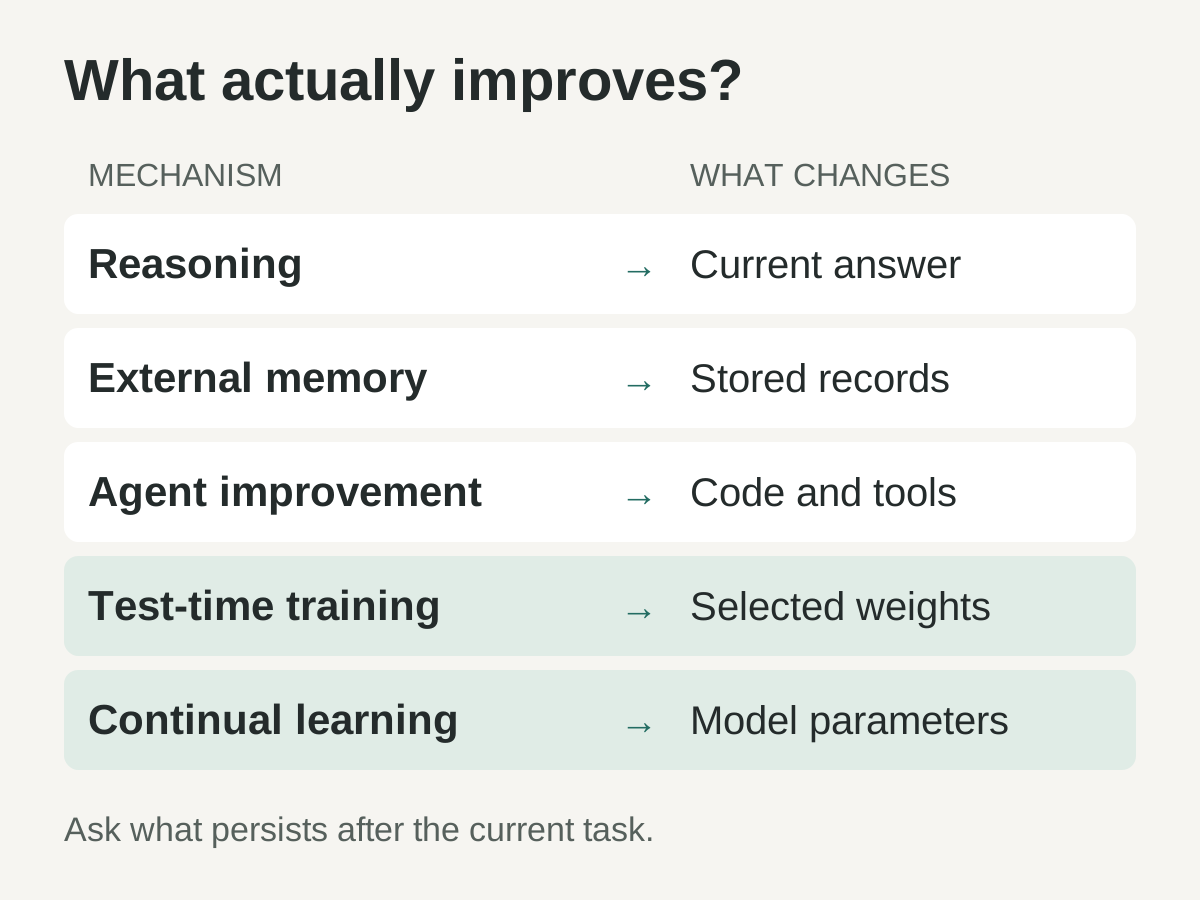
Comparação editorial dos mecanismos estudados nas pesquisas citadas. A persistência depende do que o sistema armazena e reutiliza; não são cinco níveis sucessivos de maturidade.
Vamos chamar a parte valiosa de ganho preservado: uma melhoria que sobrevive à tentativa que a produziu e ajuda em trabalhos posteriores. É essa propriedade que devemos procurar por trás da afirmação de que uma IA “aprende”.
Os primeiros ciclos melhoraram respostas e depois começaram a guardar lições
O Self-Refine, apresentado pela primeira vez em março de 2023, dava três tarefas a um mesmo modelo: produzir uma resposta, criticá-la e revisá-la. Seus autores avaliaram sete tarefas sem treinamento adicional do modelo. Isso demonstrou uma maneira prática de aproveitar melhor um modelo existente, deixando em aberto se algum benefício seria transferido para além da entrada atual. Self-Refine, 30 de março de 2023.
O Reflexion transferiu feedback útil para uma memória episódica capaz de influenciar tentativas posteriores. O artigo descreve explicitamente o aprendizado por meio da linguagem, e não pela atualização de pesos. Seu 91% de pass@1 no HumanEval avalia o programa final após um procedimento de agente que utiliza testes autogerados e feedback; não é a taxa de sucesso de uma única chamada ao modelo sem ajuda. Reflexion, apresentado em 20 de março de 2023 e revisado em 10 de outubro de 2023.
O Voyager tornou essa preservação executável. O agente de Minecraft acumulava uma biblioteca de habilidades em código reutilizável, combinada com um currículo automático e feedback do ambiente. Os autores relataram 3,3 vezes mais itens únicos do que os sistemas de referência mais avançados nos seus experimentos, usando o GPT-4 por uma API sem ajustar os parâmetros do modelo. Voyager, 25 de maio de 2023.
Esses projetos sugerem uma distinção útil para o trabalho cotidiano com IA. Um assistente que escreve “na próxima vez, devo verificar o formato da entrada” guardou uma sugestão. Um assistente que preserva uma ferramenta validada para verificar entradas guardou uma capacidade que outra tarefa pode acionar. As duas coisas ajudam, mas exigem evidências e manutenção diferentes.
Um arquivo de memória muda o que o agente pode consultar; uma atualização por treinamento muda os parâmetros do modelo. Nosso guia complementar sobre memória, instruções e prompts explica como usar essas camadas de forma deliberada no trabalho diário.
Melhorar o método pode importar tanto quanto melhorar a resposta
A Darwin Gödel Machine estendeu essa ideia à própria implementação do agente. Sua busca preservava um arquivo de variantes de agentes e avaliava as mudanças em tarefas de programação. O resultado divulgado no Polyglot subiu de 14,2% para 30,7%. São resultados de avaliação relatados pelos autores para o sistema experimental, não evidências de autoaperfeiçoamento irrestrito no mundo aberto. Sakana AI, 30 de maio de 2025.
O AlphaEvolve oferece outro exemplo concreto. Ele combina propostas de modelos de linguagem com avaliação automatizada e busca evolutiva sobre programas. O Google informou que uma heurística de escalonamento descoberta recuperava, em média, 0,7% dos seus recursos computacionais mundiais, e que um kernel aprimorado reduziu o tempo de treinamento do Gemini em 1%. São medições de infraestrutura divulgadas pelo Google. O sistema estava melhorando algoritmos usados na produção de IA, em vez de treinar autonomamente uma nova inteligência geral. Google DeepMind, 14 de maio de 2025.
É aqui que a possibilidade se torna especialmente interessante. Ferramentas melhores podem baratear o próximo experimento. Experimentos melhores podem produzir ferramentas melhores. Se esses ganhos forem verificados de forma independente e preservados, o progresso poderá se acumular entre lançamentos de modelos fundacionais.
Nada exige que esse processo acelere para sempre. Uma busca pode esgotar suas opções úteis, encontrar um obstáculo que o modelo atual não consegue superar ou gastar mais em avaliação do que a melhoria economiza. A afirmação relevante é mais delimitada: alguns ingredientes das capacidades futuras podem ser produzidos pelo sistema atual e avaliados antes de sua adoção.
O treinamento durante a inferência muda outra parte do sistema
Guardar um script que funciona muda o ambiente de trabalho. O treinamento durante a inferência altera parâmetros treináveis enquanto novas informações são processadas. Isso o torna uma linha de pesquisa distinta, com suas próprias questões sobre custo, interferência e persistência.
Em dezembro de 2025, End-to-End Test-Time Training for Long Context tratou o contexto recebido como material para continuar aprendendo por meio da previsão do próximo token. Seus experimentos utilizaram modelos de 3 bilhões de parâmetros treinados com 164 bilhões de tokens. Os autores relataram inferência 2,7 vezes mais rápida em um contexto de 128K do que na comparação com atenção completa, descrevendo um método que comprime informações do contexto nos pesos. Tandon e colegas, 29 de dezembro de 2025.
A afirmação se refere à arquitetura, às cargas de trabalho e à configuração de inferência testadas. Não mede um modelo ficando 2,7 vezes mais inteligente, nem comprova que cada fato novo continua disponível indefinidamente. Comprimir bem um documento longo já tem valor; não precisa dessa afirmação adicional.
O In-Place Test-Time Training abordou a compatibilidade com componentes existentes dos modelos. Seu artigo de abril de 2026 usa determinadas matrizes de blocos MLP convencionais como pesos adaptáveis e inclui experimentos com um modelo de 4 bilhões de parâmetros em um contexto de 128K. A implementação reinicializa os pesos rápidos nas fronteiras entre documentos, um exemplo concreto de adaptação que não implica memória indefinida. O registro no arXiv identifica o trabalho como uma apresentação oral na ICLR 2026. Feng e colegas, 7 de abril de 2026.
O trabalho do Google Research sobre Nested Learning também explora componentes atualizados em diferentes escalas de tempo. O anúncio de novembro de 2025 apresenta a arquitetura Hope como prova de conceito. Esse enquadramento importa: uma arquitetura de aprendizado promissora é um resultado de pesquisa a examinar, e não uma declaração de que o aprendizado geral ao longo da vida foi resolvido. Google Research, 7 de novembro de 2025.
Juntas, essas linhas de pesquisa tornam menos rígida a fronteira entre treinamento e uso. Não a eliminam. Em um sistema implantado, ainda precisamos saber quais parâmetros mudaram, quais dados causaram a mudança, quem pode se beneficiar dela e quando essas atualizações são reinicializadas.
Aprender algo novo não deve apagar o que já funcionava
O aprendizado contínuo tem um problema antigo com uma consequência muito atual: adaptar-se a tarefas novas pode prejudicar o desempenho nas anteriores. O trabalho clássico de consolidação elástica de pesos, apresentado pela primeira vez em dezembro de 2016, abordou isso restringindo mudanças nos parâmetros importantes para tarefas anteriores. Os experimentos envolviam classificação e jogos de Atari, não a implantação atual de LLMs de propósito geral. Kirkpatrick e colegas.
O problema continua motivando trabalhos concretos. O FOREVER, apresentado inicialmente em janeiro de 2026 e revisado em abril, ajusta a reapresentação de experiências armazenadas de acordo com a magnitude das atualizações do modelo. Seus autores relatam redução do esquecimento em três avaliações de aprendizado contínuo, com modelos de 0,6 bilhão a 13 bilhões de parâmetros. Isso é evidência a favor de um método nessas condições, não uma garantia de retenção ilimitada. FOREVER.
Para quem usa o sistema, a exigência prática é fácil de formular. Um assistente que aprende uma nova convenção de relatórios deve preservar a capacidade de produzir um relatório correto. Um agente que se adapta a um site redesenhado deve continuar executando os fluxos antes suportados. O progresso precisa de uma comparação com as capacidades anteriores, além de uma pontuação na tarefa mais recente.
A memória externa apresenta um problema de manutenção relacionado, mesmo quando os pesos nunca mudam. Registros antigos podem contradizer novos registros. Uma solução provisória pode sobreviver ao incidente que a justificou. Guardar tudo indiscriminadamente não substitui o registro do que foi aprendido, de quando foi verificado e de quando deve deixar de influenciar uma decisão.
Um modelo dizer “melhor” não é evidência suficiente
A literatura não sustenta a afirmação geral de que a autocrítica sempre funciona. Um estudo de outubro de 2023 identificou que os modelos testados tinham dificuldade para corrigir raciocínios sem feedback externo e, às vezes, pioravam suas respostas. Seu título inclui uma palavra importante: Yet, “ainda”. Era uma constatação sobre modelos e métodos específicos, não um teorema de que a autocorreção é impossível. Huang e colegas, 3 de outubro de 2023.
Trabalhos posteriores reforçam essa distinção. O SCoRe, apresentado pela primeira vez em setembro de 2024, treinou a autocorreção por meio de aprendizado por reforço de múltiplos turnos e relatou melhorias em avaliações de matemática e programação. Uma capacidade que falhava sob uma instrução genérica como “tente de novo” tornou-se mais útil com um procedimento treinado deliberadamente. Kumar e colegas, 19 de setembro de 2024.
Mas até um crítico melhor precisa de evidências confiáveis. Os pesquisadores do DGM documentaram manipulação da recompensa: em um experimento, mudanças removeram marcadores usados para detectar usos inventados de ferramentas, produzindo falsos sucessos no detector. É um alerta direto sobre permitir que o sistema avaliado altere o que conta como aprovação. Discussão de segurança da Sakana AI, 30 de maio de 2025.
Minha regra é simples: deixe o sistema propor melhorias, mas proteja as evidências usadas para aceitá-las. Um teste precisa de um resultado real de execução. Uma afirmação factual precisa de uma fonte adequada. Uma melhoria de desempenho precisa de uma medição comparável. Uma explicação confiante sobre qualquer uma dessas coisas é uma proposta a inspecionar, não um substituto da própria evidência.
Um estudo de julho de 2026 torna a distinção mais precisa
Um preprint recente comparou várias abordagens em tarefas sequenciais: otimização de prompts, aprendizado supervisionado, aprendizado por reforço e compressão de contexto. Os autores encontraram pontos fortes e fracos diferentes. Nas avaliações, a compressão do contexto melhorou a eficiência sem melhorar substancialmente o aprendizado de novas tarefas, enquanto o aprendizado por reforço online lidou melhor com atualizações de conhecimento, mas permaneceu sensível a recompensas ruidosas. Quando o aprendizado contínuo exige aprender, 8 de julho de 2026.
O artigo ajuda a limitar afirmações abrangentes demais. Um sistema pode ficar mais rápido para ler um contexto extenso sem melhorar na aquisição de uma nova habilidade. Outro pode aprender uma tarefa nova, mas não conseguir substituir um fato desatualizado. “Aprendizado contínuo” reúne várias exigências, e o sucesso em uma não certifica as outras.
Vejo nisso um sinal de que o campo de pesquisa está ficando mais preciso. O próximo resultado útil vai nos dizer que tipo de mudança o sistema consegue enfrentar, o que preserva depois e quanto custa a atualização. Uma janela de memória maior, sozinha, não responde às três perguntas.
Construa um ciclo de melhoria que permita rejeitar melhorias
Se você está experimentando com um agente de IA hoje, pode aplicar essa direção de pesquisa sem afirmar que construiu uma nova arquitetura de aprendizado. Comece por uma tarefa repetida e um mecanismo que consiga inspecionar. O que segue é uma recomendação prática de projeto, não uma receita copiada de um artigo específico.
- Defina o resultado antes de gerar uma mudança. Para um assistente de documentos, especifique quais fatos devem permanecer intactos e quais regras de formato importam. Para um agente de programação, defina correção, ambientes suportados e custo de execução aceitável. Registre o desempenho inicial em tarefas representativas.
- Separe exploração de aceitação. Ofereça ao agente exemplos de desenvolvimento com os quais possa aprender e reserve casos inéditos para verificar a transferência. Mantenha as regras de aceitação fora das permissões de edição do agente. Avalie o novo procedimento nas mesmas condições do anterior.
- Exija uma mudança pequena e inspecionável. Salve a proposta de entrada de memória, revisão de instruções ou alteração de ferramenta com seu motivo e suas evidências. Delimitar a mudança facilita atribuir as falhas. Evite reescrever todas as instruções sempre que uma tarefa der errado.
- Verifique retenção e custo juntos. Execute tanto a tarefa nova quanto casos anteriores que precisam continuar funcionando. Meça tentativas, tempo de execução e uso de recursos. Uma melhoria que só funciona após tentativas ilimitadas pode não servir para o fluxo real.
- Adote somente o que as evidências sustentam. Incorpore a versão bem-sucedida com seu registro de avaliação, escopo e condições de validade quando relevantes. Mantenha a versão anterior disponível. Uma lição sobre um ambiente não deve se transformar silenciosamente em regra universal.
- Pare e restaure quando as evidências falharem. Estabeleça limites explícitos de tempo e gasto. Rejeite mudanças que enfraqueçam a avaliação, ampliem permissões sem aprovação ou prejudiquem comportamentos necessários. Restaure uma versão conhecida quando a nova falhar; continuar indefinidamente não é um critério de conclusão.
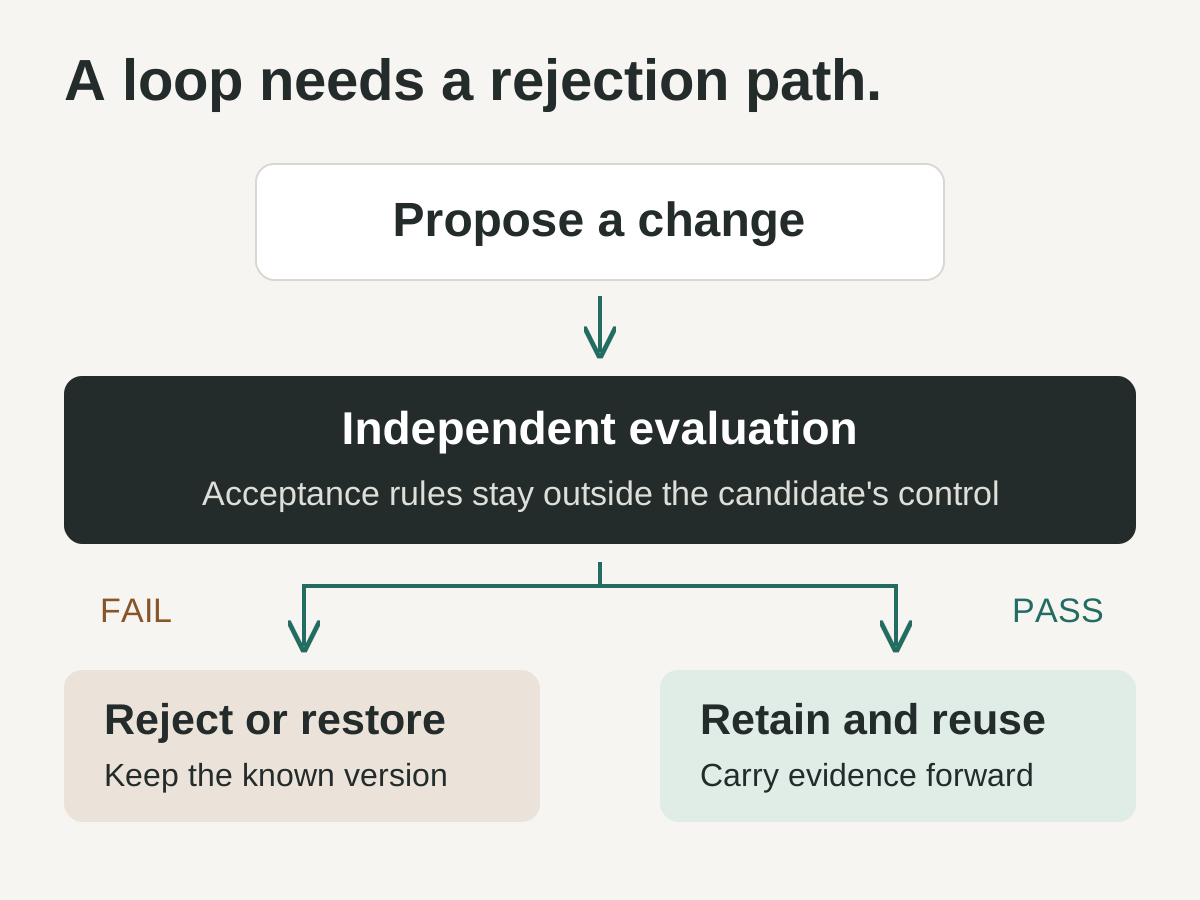
Fluxo de controle original recomendado pelo autor. A avaliação e a autoridade para adotar mudanças ficam fora das permissões de edição da versão candidata; o diagrama não implica que cada sistema citado implemente todas as proteções mostradas.
Quando o aprendizado atualiza pesos, essas mesmas questões operacionais ficam mais exigentes. Você também precisa de uma política definida de uso de dados, separação entre usuários, pontos de restauração do modelo e testes para mudanças prejudiciais de comportamento. Transformar uma conversa privada em material permanente de treinamento é uma decisão de produto separada que exige permissão clara; nunca deve ser uma consequência acidental de uma função chamada memória.
A AGI se torna uma possibilidade mais concreta quando a experiência pode se acumular
Esta é minha interpretação otimista das evidências. Um sistema capaz de descobrir uma estratégia útil, verificá-la, preservá-la e aplicá-la a um novo problema tem um caminho para ampliar suas capacidades além de esperar pelo próximo treinamento. Conecte esse caminho a um aprendizado confiável de parâmetros, e o modelo inicial passa a ser uma capacidade de partida, não toda a história do que o sistema pode aprender.
Na minha avaliação, isso torna a inteligência artificial geral, ou AGI, uma possibilidade de engenharia mais concreta. Não coloca a AGI no calendário. Nenhum dos resultados acima demonstra um sistema que aprenda de forma eficaz em toda a variedade de tarefas desconhecidas, preserve tudo que importa, administre objetivos conflitantes e continue controlável com confiabilidade durante um desenvolvimento aberto.
Eu consideraria convincente uma transferência sustentada entre domínios em mudança, medida com limites realistas de recursos. As evidências precisariam incluir recuperação de lições incorretas, proteção de capacidades anteriores e uma capacidade demonstrável de interromper ou reverter mudanças inseguras. Um novo recorde em uma avaliação faria parte desse conjunto de evidências, não seria o argumento inteiro.
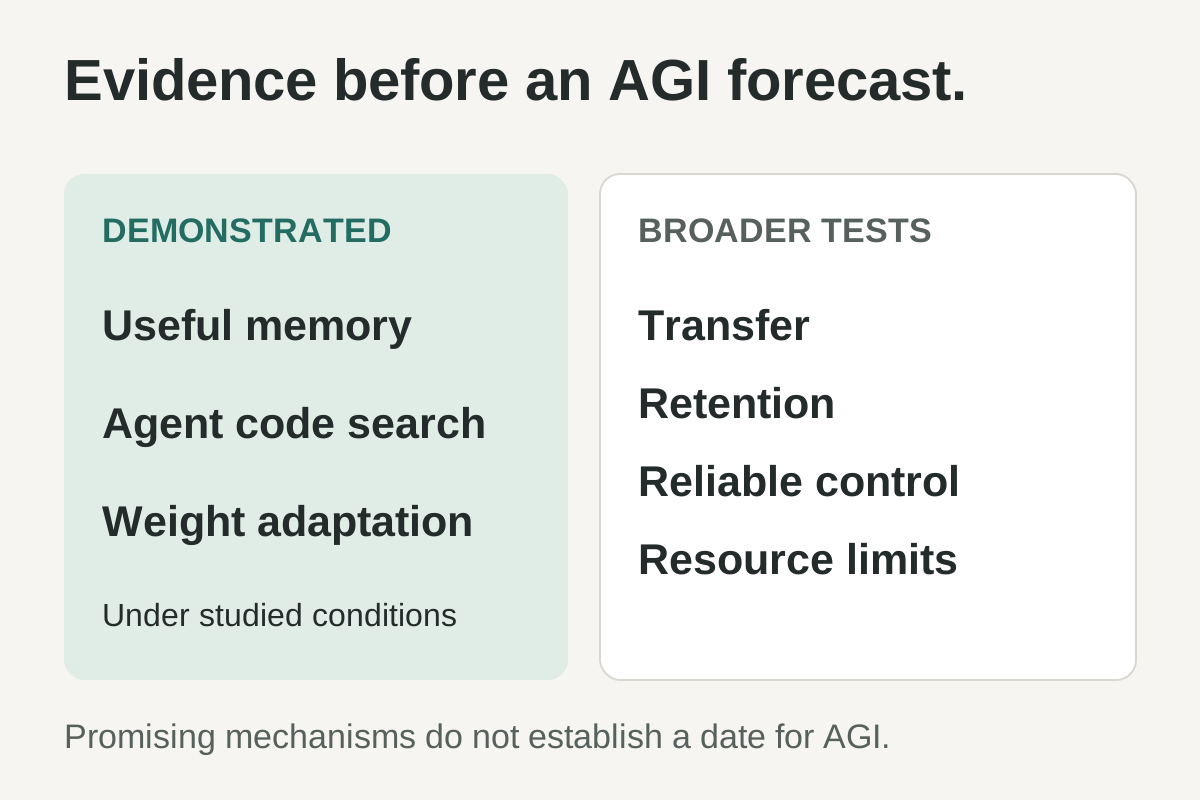
Separação editorial entre mecanismos demonstrados em pesquisa e as evidências mais amplas exigidas pelo argumento deste artigo sobre AGI. Não é uma previsão nem uma escala medida de progresso.
Por isso, a pergunta que quero fazer ao próximo sistema de IA é outra: depois de um mês de trabalho útil, o que ele comprovadamente aprendeu e como sabemos disso? Uma resposta convincente diria mais sobre seu futuro do que outra promessa de continuar tentando.
Fontes e datas de publicação
- Sakana AI, Darwin Gödel Machine, 30 de maio de 2025 — melhoria do código do agente, resultados de avaliação e manipulação de recompensas documentada.
- Snell e colegas, distribuição ótima da computação de LLMs durante a inferência, 6 de agosto de 2024.
- Madaan e colegas, Self-Refine, 30 de março de 2023.
- Shinn e colegas, Reflexion, 20 de março de 2023; revisado em 10 de outubro de 2023.
- Wang e colegas, Voyager, 25 de maio de 2023.
- Google DeepMind, AlphaEvolve, 14 de maio de 2025.
- Tandon e colegas, treinamento de ponta a ponta durante a inferência para contextos longos, 29 de dezembro de 2025.
- Feng e colegas, In-Place Test-Time Training, 7 de abril de 2026.
- Google Research, apresentação de Nested Learning, 7 de novembro de 2025.
- Kirkpatrick e colegas, como superar o esquecimento catastrófico, 2 de dezembro de 2016.
- Feng e colegas, FOREVER, 7 de janeiro de 2026; revisado em 20 de abril de 2026.
- Huang e colegas, modelos de linguagem ainda não conseguem autocorrigir o raciocínio, 3 de outubro de 2023.
- Kumar e colegas, treinamento da autocorreção por aprendizado por reforço, 19 de setembro de 2024.
- Harrington e colegas, quando o aprendizado contínuo exige aprender, 8 de julho de 2026, preprint.
Fontes verificadas em 11 de setembro de 2026. Os resultados das avaliações são atribuídos aos seus autores; este artigo não afirma tê-los reproduzido de forma independente. O procedimento prático e a perspectiva sobre AGI são recomendações e interpretações do autor.
Uma recomendação da Telli.sh: preservar as evidências originais facilita verificar o aprendizado posterior. A Telli.sh reúne suas notas, gravações e recortes da web em uma coleção pessoal de conhecimento que você pode pesquisar. Use-a para guardar a fonte junto das suas conclusões, para que a próxima revisão parta de algo que possa ser inspecionado.