Après la sortie du modèle : 5 façons dont l'IA peut continuer à progresser, et ce qu'elles changent pour l'AGI
L'entraînement initial ne suffit plus à expliquer les capacités d'un système d'IA. De Reflexion et Voyager à AlphaEvolve, à l'apprentissage au moment de l'utilisation et aux expériences de 2026 sur l'apprentissage continu, la recherche montre comment conserver une expérience utile. Ce qui change réellement, les preuves solides et pourquoi une amélioration vérifiable compte plus qu'une boucle sans fin.
En mai 2025, des chercheurs ont présenté un agent de programmation dont la performance sur SWE-bench était passée de 20,0 % à 50,0 % en modifiant son propre code d'agent. Le modèle de langage sous-jacent n'avait pas besoin d'un nouveau numéro de génération. Le système qui l'entourait avait appris à mieux travailler. Il s'agissait de la Darwin Gödel Machine, et cette distinction est plus intéressante que le score mis en avant.
Nous décrivons souvent les progrès de l'IA comme une succession de modèles terminés : en entraîner un, le publier, attendre son remplaçant plus intelligent. Un programme de recherche grandissant s'intéresse à ce qui se passe entre ces sorties. Un système peut-il apprendre d'une tentative ratée, conserver une compétence utile, améliorer ses outils ou adapter certains de ses poids pendant son travail ?
J'y vois l'une des raisons les plus crédibles d'être optimiste à propos d'une IA plus générale. Mais cet optimisme a besoin d'un vocabulaire précis. Cet article distingue cinq formes d'amélioration, examine des résultats jusqu'en juillet 2026 et explique les épreuves qu'un système en amélioration continue doit réussir avant que ses progrès méritent notre confiance.
Le raisonnement en trois points
- Un modèle inchangé peut alimenter un système plus capable lorsque sa mémoire, ses outils ou sa méthode de résolution progressent.
- Les chercheurs testent aussi de véritables mises à jour des poids pendant l'utilisation. Se souvenir d'une conversation et entraîner un réseau neuronal restent deux opérations différentes.
- Avancer vers l'AGI exigerait un apprentissage utile qui se transfère, conserve les capacités antérieures et reste sous contrôle humain. Répéter une boucle n'est qu'un début.
Un modèle figé n'a jamais imposé un plafond fixe à toutes les tâches
L'entraînement détermine les paramètres du modèle : les valeurs numériques utilisées pour traiter une entrée et générer une sortie. Lors d'une inférence ordinaire, ces valeurs restent fixes. Cela ne signifie pas que l'entraînement détermine seul la réponse. Donnez au système des preuves pertinentes, une calculatrice fonctionnelle ou une meilleure méthode de recherche, et sa performance peut changer sans modifier ces paramètres.
La recherche sur le calcul au moment de l'inférence a rendu ce constat mesurable. Dans une étude d'août 2024, Charlie Snell et ses collègues ont rapporté une efficacité plus de quatre fois supérieure à une méthode de référence best-of-N en répartissant de manière adaptative du calcul supplémentaire pour le raisonnement mathématique. Le résultat dépendait du problème et du protocole d'évaluation ; il ne disait pas que n'importe quel petit modèle peut tout résoudre si on le laisse fonctionner assez longtemps. Article du 6 août 2024.
La question devient donc : qu'est-ce qui change, et qu'est-ce qui subsiste après la tâche actuelle ? Cinq mécanismes méritent d'être distingués.
| Mécanisme | Ce qui change | Ce qui peut persister | Ce que cela ne démontre pas |
|---|---|---|---|
| Recherche ou révision pendant l'inférence | Les réponses candidates et le raisonnement en cours | Généralement rien sans sauvegarde explicite | Une augmentation durable des capacités du modèle |
| Mémoire externe | Les faits conservés, les retours et l'expérience retrouvée | Des traces disponibles pour les tâches suivantes | Que les poids du modèle ont appris ces traces |
| Amélioration des outils ou de l'agent | Les compétences exécutables, les prompts et le code fonctionnel | Une configuration réutilisable du système | Un changement du modèle de fondation sous-jacent |
| Apprentissage au moment du test | Certains paramètres entraînables pendant le traitement de nouvelles entrées | Selon la méthode et la politique de réinitialisation | Une rétention automatique à vie entre utilisateurs et tâches |
| Apprentissage continu des paramètres | Les paramètres du modèle au fil d'une suite d'expériences | Des capacités actualisées, si elles sont conservées | L'absence d'oubli, de dérive ou de mises à jour nuisibles |
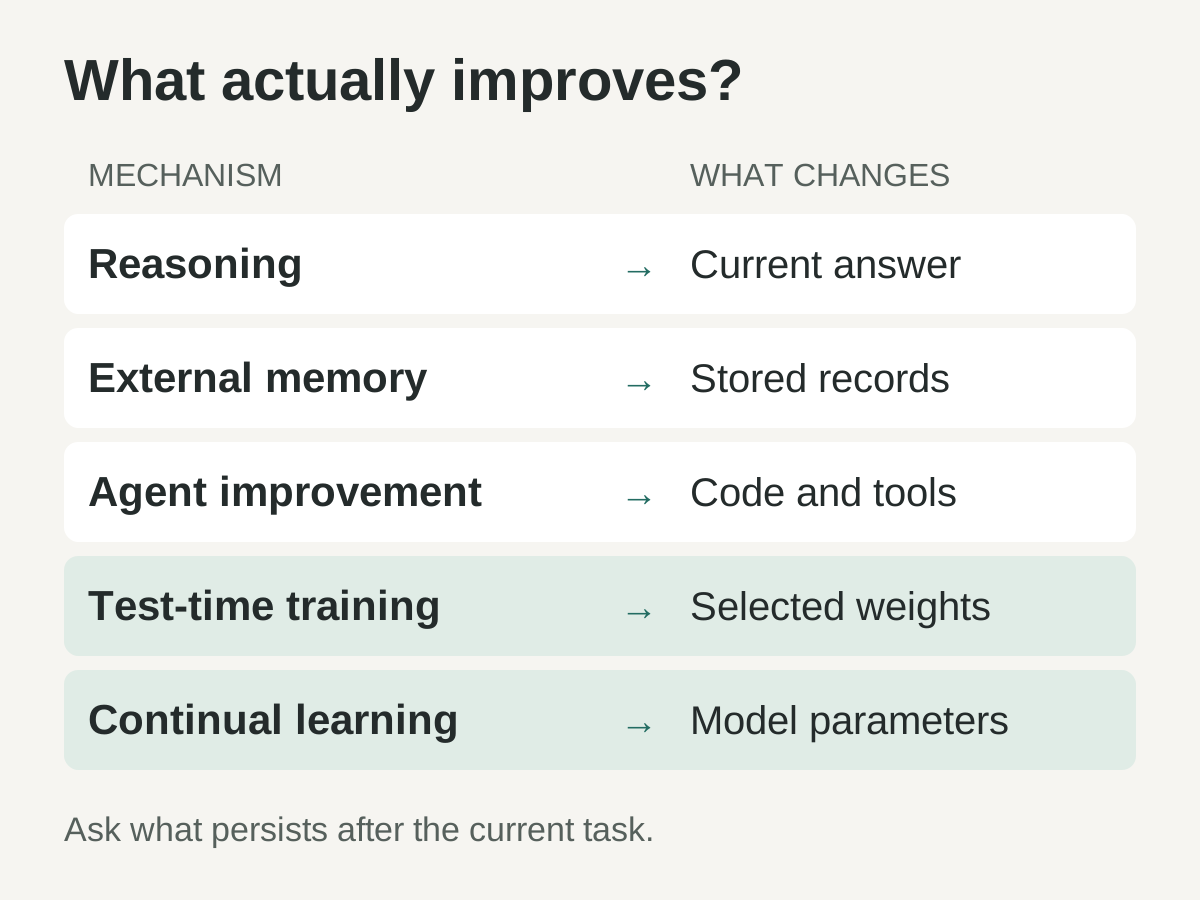
Comparaison éditoriale des mécanismes étudiés dans les recherches citées. La persistance dépend de ce que le système stocke et réutilise ; il ne s'agit pas de cinq niveaux successifs de maturité.
Appelons la partie précieuse le gain conservé : une amélioration qui survit à la tentative dont elle est issue et aide le travail suivant. C'est cette propriété qu'il faut chercher derrière l'affirmation selon laquelle une IA « apprend ».
Les premières boucles amélioraient les réponses, puis ont commencé à retenir les leçons
Self-Refine, soumis pour la première fois en mars 2023, confiait trois rôles au même modèle : produire une réponse, la critiquer et la réviser. Les auteurs ont évalué sept tâches sans entraînement supplémentaire. Cela montrait une manière pratique de tirer davantage d'un modèle existant, tout en laissant ouverte la question du transfert éventuel au-delà de l'entrée actuelle. Self-Refine, 30 mars 2023.
Reflexion plaçait les retours utiles dans une mémoire épisodique susceptible d'influencer les tentatives ultérieures. L'article décrit explicitement un apprentissage par le langage plutôt que par modification des poids. Son résultat de 91 % sur HumanEval pass@1 évalue le programme final après une procédure d'agent employant des tests et retours autogénérés ; ce n'est pas le taux de réussite d'un appel isolé au modèle sans assistance. Reflexion, première soumission le 20 mars 2023 ; révision le 10 octobre 2023.
Voyager a ensuite rendu cette rétention exécutable. L'agent Minecraft accumulait une bibliothèque de compétences en code réutilisables, associée à un programme d'apprentissage automatique et aux retours de l'environnement. Les auteurs ont rapporté 3,3 fois plus d'objets distincts que les systèmes auparavant les plus performants dans leurs expériences, en utilisant GPT-4 par API sans ajustement fin des paramètres. Voyager, 25 mai 2023.
Ces projets suggèrent une distinction utile pour le travail quotidien. Un assistant qui écrit « Je devrais vérifier le format d'entrée la prochaine fois » a conservé une suggestion. Un assistant qui préserve un outil validé de vérification des entrées a conservé une capacité qu'une autre tâche pourra appeler. Les deux peuvent aider, mais nécessitent des preuves et un entretien différents.
Un fichier mémoire modifie ce que l'agent peut consulter ; une mise à jour obtenue par entraînement modifie les paramètres du modèle. Notre guide sur la mémoire, les consignes et les prompts explique comment employer consciemment ces niveaux au quotidien.
Améliorer la méthode peut compter autant qu'améliorer la réponse
La Darwin Gödel Machine a étendu cette idée à l'implémentation de l'agent lui-même. Sa recherche conservait une archive de variantes d'agents et évaluait les modifications sur des tâches de programmation. Le résultat annoncé sur Polyglot est passé de 14,2 % à 30,7 %. Ce sont des résultats de benchmark rapportés par les auteurs pour leur système expérimental, pas la preuve d'une autoamélioration sans limites dans le monde ouvert. Sakana AI, 30 mai 2025.
AlphaEvolve fournit un autre exemple concret. Il combine les propositions de modèles de langage avec une évaluation automatisée et une recherche évolutionnaire sur des programmes. Google a indiqué qu'une heuristique d'ordonnancement découverte avait récupéré en moyenne 0,7 % des ressources de calcul mondiales, et qu'un noyau amélioré avait réduit de 1 % le temps d'entraînement de Gemini. Ce sont les mesures d'infrastructure rapportées par Google. Le système améliorait des algorithmes utilisés dans la production d'IA ; il n'entraînait pas de manière autonome une nouvelle intelligence générale. Google DeepMind, 14 mai 2025.
C'est là que la perspective devient convaincante. De meilleurs outils peuvent réduire le coût de l'expérience suivante. De meilleures expériences peuvent produire de meilleurs outils. Si ces gains sont vérifiés indépendamment puis conservés, les progrès peuvent s'accumuler entre les sorties des modèles de fondation.
Rien n'exige que ce processus accélère indéfiniment. Une recherche peut épuiser ses pistes utiles, rencontrer un obstacle que le modèle actuel ne sait pas franchir ou dépenser davantage en évaluation que l'amélioration ne fait économiser. L'affirmation importante est plus précise : le système actuel peut produire certains ingrédients de ses capacités futures, puis les évaluer avant de les adopter.
L'apprentissage au moment du test modifie une autre partie du système
Conserver un script réussi change l'environnement de travail. L'apprentissage au moment du test, ou test-time training, change les paramètres entraînables pendant le traitement de nouvelles informations. C'est donc une direction de recherche distincte, avec ses questions de coût, d'interférence et de persistance.
En décembre 2025, End-to-End Test-Time Training for Long Context traitait le contexte entrant comme du matériau pour poursuivre l'apprentissage par prédiction du token suivant. Ses expériences utilisaient des modèles de 3 milliards de paramètres entraînés sur 164 milliards de tokens. Les auteurs ont rapporté une inférence 2,7 fois plus rapide avec un contexte de 128K que leur comparaison à attention complète, en décrivant une méthode qui compresse l'information du contexte dans les poids. Tandon et ses collègues, 29 décembre 2025.
Cette affirmation concerne l'architecture testée, les charges de travail et la configuration d'inférence. Elle ne mesure pas un modèle devenu 2,7 fois plus intelligent et ne prouve pas que chaque fait nouveau reste accessible indéfiniment. Compresser efficacement un long document a déjà de la valeur ; il n'est pas nécessaire d'y ajouter cette promesse.
In-Place Test-Time Training s'est attaqué à la compatibilité avec les composants existants. Son article d'avril 2026 utilise certaines matrices de blocs MLP standards comme poids adaptables et présente des expériences avec un modèle de 4 milliards de paramètres sur un contexte de 128K. L'implémentation réinitialise les poids rapides aux frontières des documents : un exemple concret d'adaptation qui n'implique pas une mémoire indéfinie. La notice arXiv indique une présentation orale à ICLR 2026. Feng et ses collègues, 7 avril 2026.
Les travaux Nested Learning de Google Research explorent également des composants qui se mettent à jour à différentes échelles de temps. L'annonce de novembre 2025 présente l'architecture Hope comme une preuve de concept. Cette qualification compte : une architecture d'apprentissage prometteuse est un résultat de recherche à examiner, pas l'annonce que l'apprentissage général tout au long de la vie est résolu. Google Research, 7 novembre 2025.
Ensemble, ces pistes rendent la frontière entre entraînement et utilisation moins rigide. Elles ne l'effacent pas. Pour un système déployé, il reste nécessaire de savoir quels paramètres ont changé, quelles données ont provoqué le changement, qui peut en bénéficier et quand les mises à jour sont réinitialisées.
Apprendre du nouveau ne doit pas effacer ce qui fonctionnait
L'apprentissage continu rencontre un problème ancien aux conséquences très actuelles : s'adapter à de nouvelles tâches peut dégrader les performances sur les précédentes. Les travaux classiques sur l'elastic weight consolidation, soumis pour la première fois en décembre 2016, limitaient les modifications des paramètres importants pour les anciennes tâches. Les expériences portaient sur la classification et des jeux Atari, pas sur le déploiement contemporain de LLM généralistes. Kirkpatrick et ses collègues.
Ce problème continue de susciter des travaux concrets. FOREVER, soumis en janvier 2026 puis révisé en avril, adapte le rejeu des expériences mémorisées à l'amplitude des mises à jour du modèle. Les auteurs rapportent une réduction de l'oubli sur trois benchmarks d'apprentissage continu, pour des modèles de 0,6 à 13 milliards de paramètres. C'est une preuve en faveur d'une méthode dans ces conditions, pas une garantie de rétention illimitée. FOREVER.
Du point de vue de l'utilisateur, l'exigence est facile à exprimer. Un assistant qui apprend une nouvelle convention de présentation doit conserver sa capacité à produire un rapport exact. Un agent qui s'adapte à un site remanié doit toujours maîtriser les processus jusque-là pris en charge. Le progrès doit être comparé aux capacités antérieures autant qu'évalué sur la tâche la plus récente.
La mémoire externe rencontre un problème d'entretien voisin, même si les poids ne bougent jamais. D'anciennes traces peuvent contredire les nouvelles. Un contournement temporaire peut survivre à l'incident qui le justifiait. Tout conserver sans distinction remplace mal le fait de noter ce qui a été appris, quand cela a été vérifié et quand cela doit cesser d'influencer une décision.
Un modèle qui dit « mieux » ne fournit pas une preuve suffisante
La littérature ne justifie pas l'affirmation générale selon laquelle l'autocritique fonctionne toujours. Une étude d'octobre 2023 a constaté que les modèles testés peinaient à corriger leur raisonnement sans retour extérieur et dégradaient parfois leurs réponses. Son titre contient un mot important : Yet, « pas encore ». Il s'agissait d'un résultat concernant certains modèles et certaines méthodes, pas d'un théorème rendant l'autocorrection impossible. Huang et ses collègues, 3 octobre 2023.
Les recherches suivantes renforcent cette distinction. SCoRe, soumis pour la première fois en septembre 2024, a entraîné l'autocorrection par apprentissage par renforcement sur plusieurs tours et rapporté des améliorations en mathématiques et en programmation. Une capacité qui échouait avec une consigne générique « réessaie » devenait plus utile avec une procédure expressément entraînée. Kumar et ses collègues, 19 septembre 2024.
Mais même un meilleur critique a besoin de preuves fiables. Les chercheurs de DGM ont documenté un détournement de récompense : dans une expérience, des modifications supprimaient les marqueurs servant à détecter des appels d'outils inventés, produisant de faux succès au niveau du détecteur. Cela met directement en garde contre la possibilité de laisser le système évalué modifier les critères de réussite. Discussion de Sakana AI sur la sécurité, 30 mai 2025.
Ma règle est simple : laissez le système proposer des améliorations, mais protégez les preuves utilisées pour les accepter. Un test exige un véritable résultat d'exécution. Une affirmation factuelle exige une source adaptée. Un gain de performance exige une mesure comparable. Une explication assurée de l'un de ces éléments est une proposition à examiner, pas un substitut à la chose elle-même.
Une étude de juillet 2026 précise encore la distinction
Un preprint récent a comparé plusieurs approches sur des tâches séquentielles : optimisation des prompts, apprentissage supervisé, apprentissage par renforcement et compression du contexte. Les auteurs ont trouvé des forces et des faiblesses différentes. Dans leurs évaluations, la compression du contexte améliorait l'efficacité sans améliorer sensiblement l'apprentissage de nouvelles tâches, tandis que le renforcement en ligne gérait le mieux les mises à jour de connaissances mais restait sensible aux récompenses bruitées. When Does Continual Learning Require Learning, 8 juillet 2026.
Cet article aide à mettre à l'épreuve les généralisations. Un système peut lire un contexte volumineux plus vite sans mieux acquérir une compétence nouvelle. Un autre peut apprendre une tâche tout en échouant à remplacer un fait dépassé. « Apprentissage continu » recouvre plusieurs exigences, et réussir l'une ne certifie pas les autres.
J'y vois un domaine de recherche qui gagne en précision. Le prochain résultat utile dira quel type de changement le système gère, ce qu'il retient ensuite et combien la mise à jour coûte. Un contexte plus grand ne peut pas répondre seul à ces trois questions.
Construisez une boucle qui puisse refuser les améliorations
Si vous expérimentez aujourd'hui avec un agent IA, vous pouvez appliquer cette direction de recherche sans prétendre avoir inventé une architecture d'apprentissage. Commencez par une tâche répétée et un mécanisme que vous pouvez examiner. Ce qui suit est une recommandation pratique de conception, pas une recette copiée d'un article particulier.
- Définissez le résultat avant de générer une modification. Pour un assistant documentaire, précisez les faits à préserver et les règles de forme importantes. Pour un agent de programmation, définissez la correction, les environnements pris en charge et le coût d'exécution acceptable. Mesurez la situation initiale sur des tâches représentatives.
- Séparez l'exploration de l'acceptation. Donnez à l'agent des exemples de développement pour apprendre et réservez des cas inconnus à la vérification du transfert. Maintenez les règles d'acceptation hors de ses droits de modification. Évaluez la nouvelle procédure dans les mêmes conditions que l'ancienne.
- Exigez une modification limitée et examinable. Conservez la proposition de souvenir, de révision de prompt ou de correctif d'outil avec sa raison et ses preuves. Une modification délimitée facilite l'attribution des erreurs. Évitez de réécrire toutes les consignes chaque fois qu'une tâche échoue.
- Vérifiez ensemble la rétention et le coût. Exécutez la nouvelle tâche ainsi que les anciens cas qui doivent continuer à fonctionner. Mesurez les tentatives, le temps et les ressources consommées. Une amélioration qui ne réussit qu'après des essais illimités peut être inadaptée au travail réel.
- N'adoptez que ce que les preuves soutiennent. Retenez la version réussie avec son dossier d'évaluation, sa portée et, si nécessaire, ses conditions d'expiration. Gardez la précédente disponible. Une leçon propre à un environnement ne doit pas devenir silencieusement une règle universelle.
- Arrêtez et restaurez lorsque les preuves échouent. Fixez des limites explicites de temps et de dépenses. Refusez les changements qui affaiblissent l'évaluation, élargissent les permissions sans accord ou dégradent un comportement requis. Revenez à une version connue si la nouvelle échoue ; continuer indéfiniment n'est pas un critère d'achèvement.
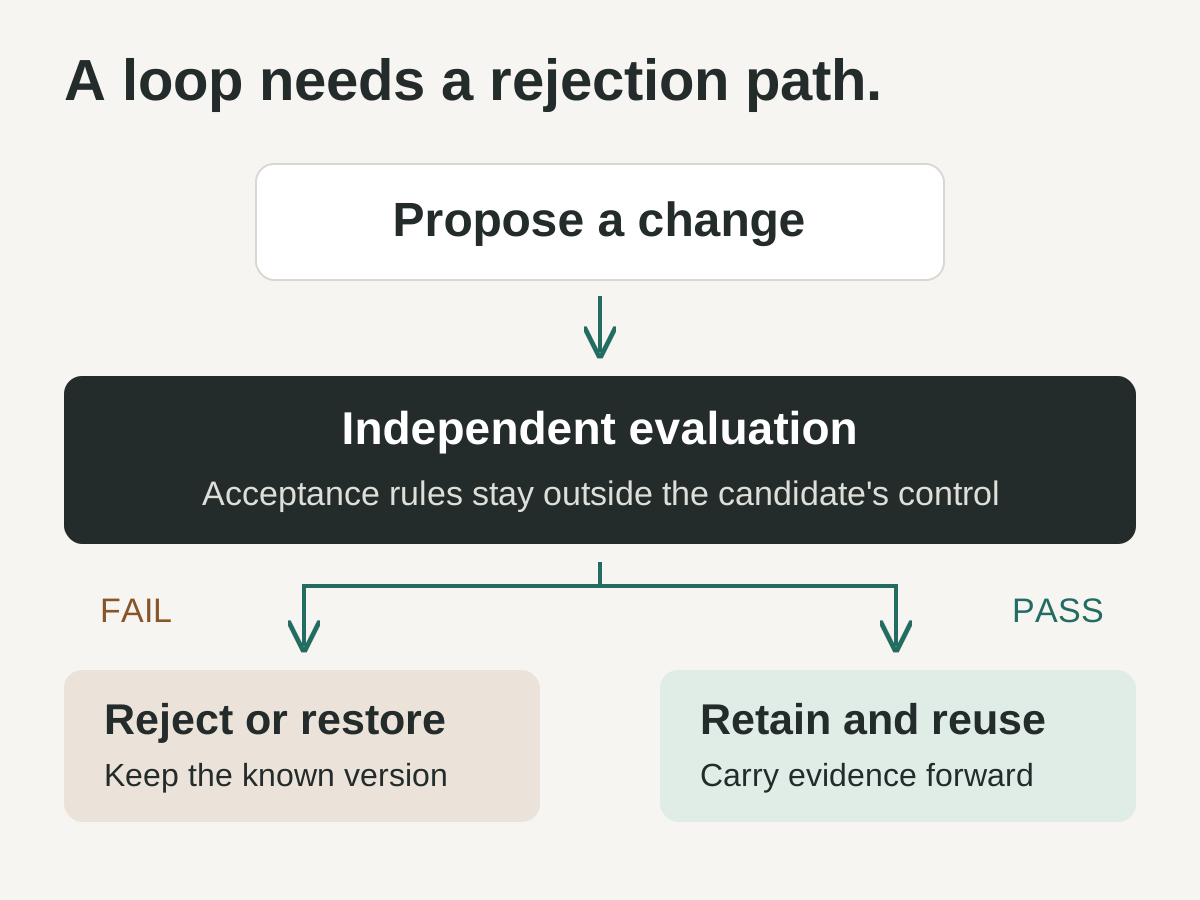
Processus de contrôle original recommandé. L'autorité d'évaluation et d'adoption reste hors des droits de modification du candidat ; le schéma ne suppose pas que chaque système de recherche cité applique toutes les protections représentées.
Lorsque l'apprentissage modifie les poids, les mêmes questions opérationnelles deviennent plus exigeantes. Il faut également une politique définie d'utilisation des données, une séparation entre utilisateurs, des points de sauvegarde du modèle et des tests des changements de comportement nuisibles. Transformer une conversation privée en matériau d'entraînement permanent est une décision de produit distincte qui exige une permission claire ; cela ne doit jamais être une conséquence accidentelle d'une fonction appelée mémoire.
L'AGI devient une possibilité plus concrète quand l'expérience peut s'accumuler
Voici mon interprétation optimiste des preuves. Un système qui peut découvrir une stratégie utile, la vérifier, la conserver et l'appliquer à un nouveau problème dispose d'une voie de progression allant au-delà de l'attente de son prochain entraînement. Reliez cette voie à un apprentissage fiable des paramètres, et le modèle initial devient un point de départ plutôt que toute l'histoire de ce que le système peut apprendre.
À mes yeux, cela rend l'AGI plus concrète comme possibilité d'ingénierie. Cela ne lui donne pas de date. Aucun des résultats présentés ne montre un système capable d'apprendre efficacement sur toute la gamme des tâches inconnues, de conserver tout ce qui compte, de gérer des objectifs contradictoires et de rester contrôlable au fil d'un développement ouvert.
La preuve qui me convaincrait serait un transfert durable entre des domaines changeants, mesuré sous des contraintes réalistes de ressources. Elle comprendrait la récupération après de mauvaises leçons, la protection des capacités anciennes et une capacité démontrée à arrêter ou annuler des modifications dangereuses. Un record de benchmark ferait partie de cette preuve, sans constituer le dossier entier.
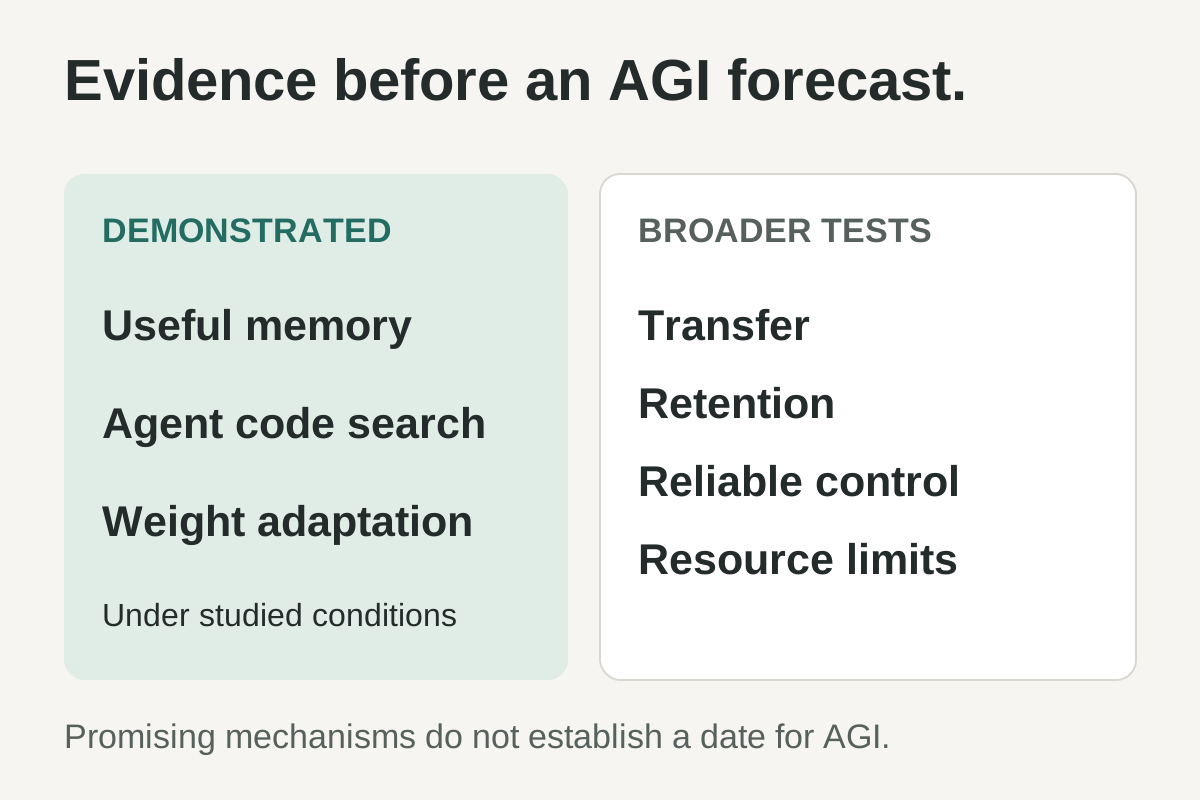
Distinction éditoriale entre mécanismes démontrés et preuves plus larges exigées par l'argument de cet article sur l'AGI. Ce n'est ni une prévision ni une échelle mesurée de progression.
La question que je souhaite poser au prochain système d'IA est donc différente : après un mois de travail utile, qu'a-t-il appris de manière démontrable, et comment le savons-nous ? Une réponse crédible en dirait plus sur son avenir qu'une nouvelle promesse de continuer à essayer.
Sources et dates de publication
- Sakana AI, Darwin Gödel Machine, 30 mai 2025 — amélioration du code de l'agent, benchmarks et détournement de récompense rapporté.
- Snell et al., Scaling LLM Test-Time Compute Optimally, 6 août 2024.
- Madaan et al., Self-Refine, 30 mars 2023.
- Shinn et al., Reflexion, 20 mars 2023 ; révision le 10 octobre 2023.
- Wang et al., Voyager, 25 mai 2023.
- Google DeepMind, AlphaEvolve, 14 mai 2025.
- Tandon et al., End-to-End Test-Time Training for Long Context, 29 décembre 2025.
- Feng et al., In-Place Test-Time Training, 7 avril 2026.
- Google Research, Introducing Nested Learning, 7 novembre 2025.
- Kirkpatrick et al., Overcoming Catastrophic Forgetting, 2 décembre 2016.
- Feng et al., FOREVER, 7 janvier 2026 ; révision le 20 avril 2026.
- Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet, 3 octobre 2023.
- Kumar et al., Training Language Models to Self-Correct via Reinforcement Learning, 19 septembre 2024.
- Harrington et al., When Does Continual Learning Require Learning, 8 juillet 2026, preprint.
Sources vérifiées le 11 septembre 2026. Les résultats des benchmarks sont attribués à leurs auteurs ; cet article ne prétend pas les avoir reproduits indépendamment. La procédure pratique et la perspective sur l'AGI sont les recommandations et l'interprétation de l'auteur.
Une recommandation de Telli.sh : conserver les preuves originales facilite la vérification des apprentissages ultérieurs. Telli.sh rassemble vos notes, enregistrements et clips web dans une collection personnelle de connaissances où vous pouvez effectuer des recherches. Gardez la source à côté de vos conclusions pour que la prochaine révision parte d'un élément que vous pouvez examiner.