Das Transkript war unauffällig: Confident AI nimmt den Klang des Gesprächs in die Bewertung auf
Confident AIs Update vom 23. Oktober ergänzt direkte Audioklassifikation, menschliche Prüfung und Zeitmarken. So lassen sich Unterbrechungen, Stille und Sprechweise anhand nachvollziehbarer Belege bewerten.
Eigene redaktionelle Grafik von Ken Jo auf Grundlage der unten aufgeführten Quellen.
Ein Kunde stellt eine Frage, der Agent antwortet richtig, und das Transkript liest sich einwandfrei. Die Aufnahme erzählt jedoch eine andere Geschichte: Der Agent beginnt zu früh, spricht über eine Korrektur hinweg und lässt eine lange Stille entstehen, bevor er wieder reagiert.
Confident AIs Update vom 23. Oktober 2026 nimmt mehr von dieser hörbaren Erfahrung in die Evaluation auf. Angekündigt wurden direkte Audioklassifikatoren, eine menschliche Prüfung, Problemzeitmarken im Observatory-Player und Pipecat-Audiotracing. Sie verbinden einen vermuteten Fehler mit einem Moment, den jemand tatsächlich hören kann. Offizielles Änderungsprotokoll.
Confident AI bietet Evaluations- und Beobachtungswerkzeuge für KI-Anwendungen. Diese Veröffentlichung lässt sich durch eine praktische Frage verstehen: Wie wird aus einem unangenehmen Gespräch ein reproduzierbarer Fehler? Wir unterscheiden Text- und Audiobelege und entwickeln einen kleinen Prüfprozess für drei typische Sprachagenten-Szenarien.
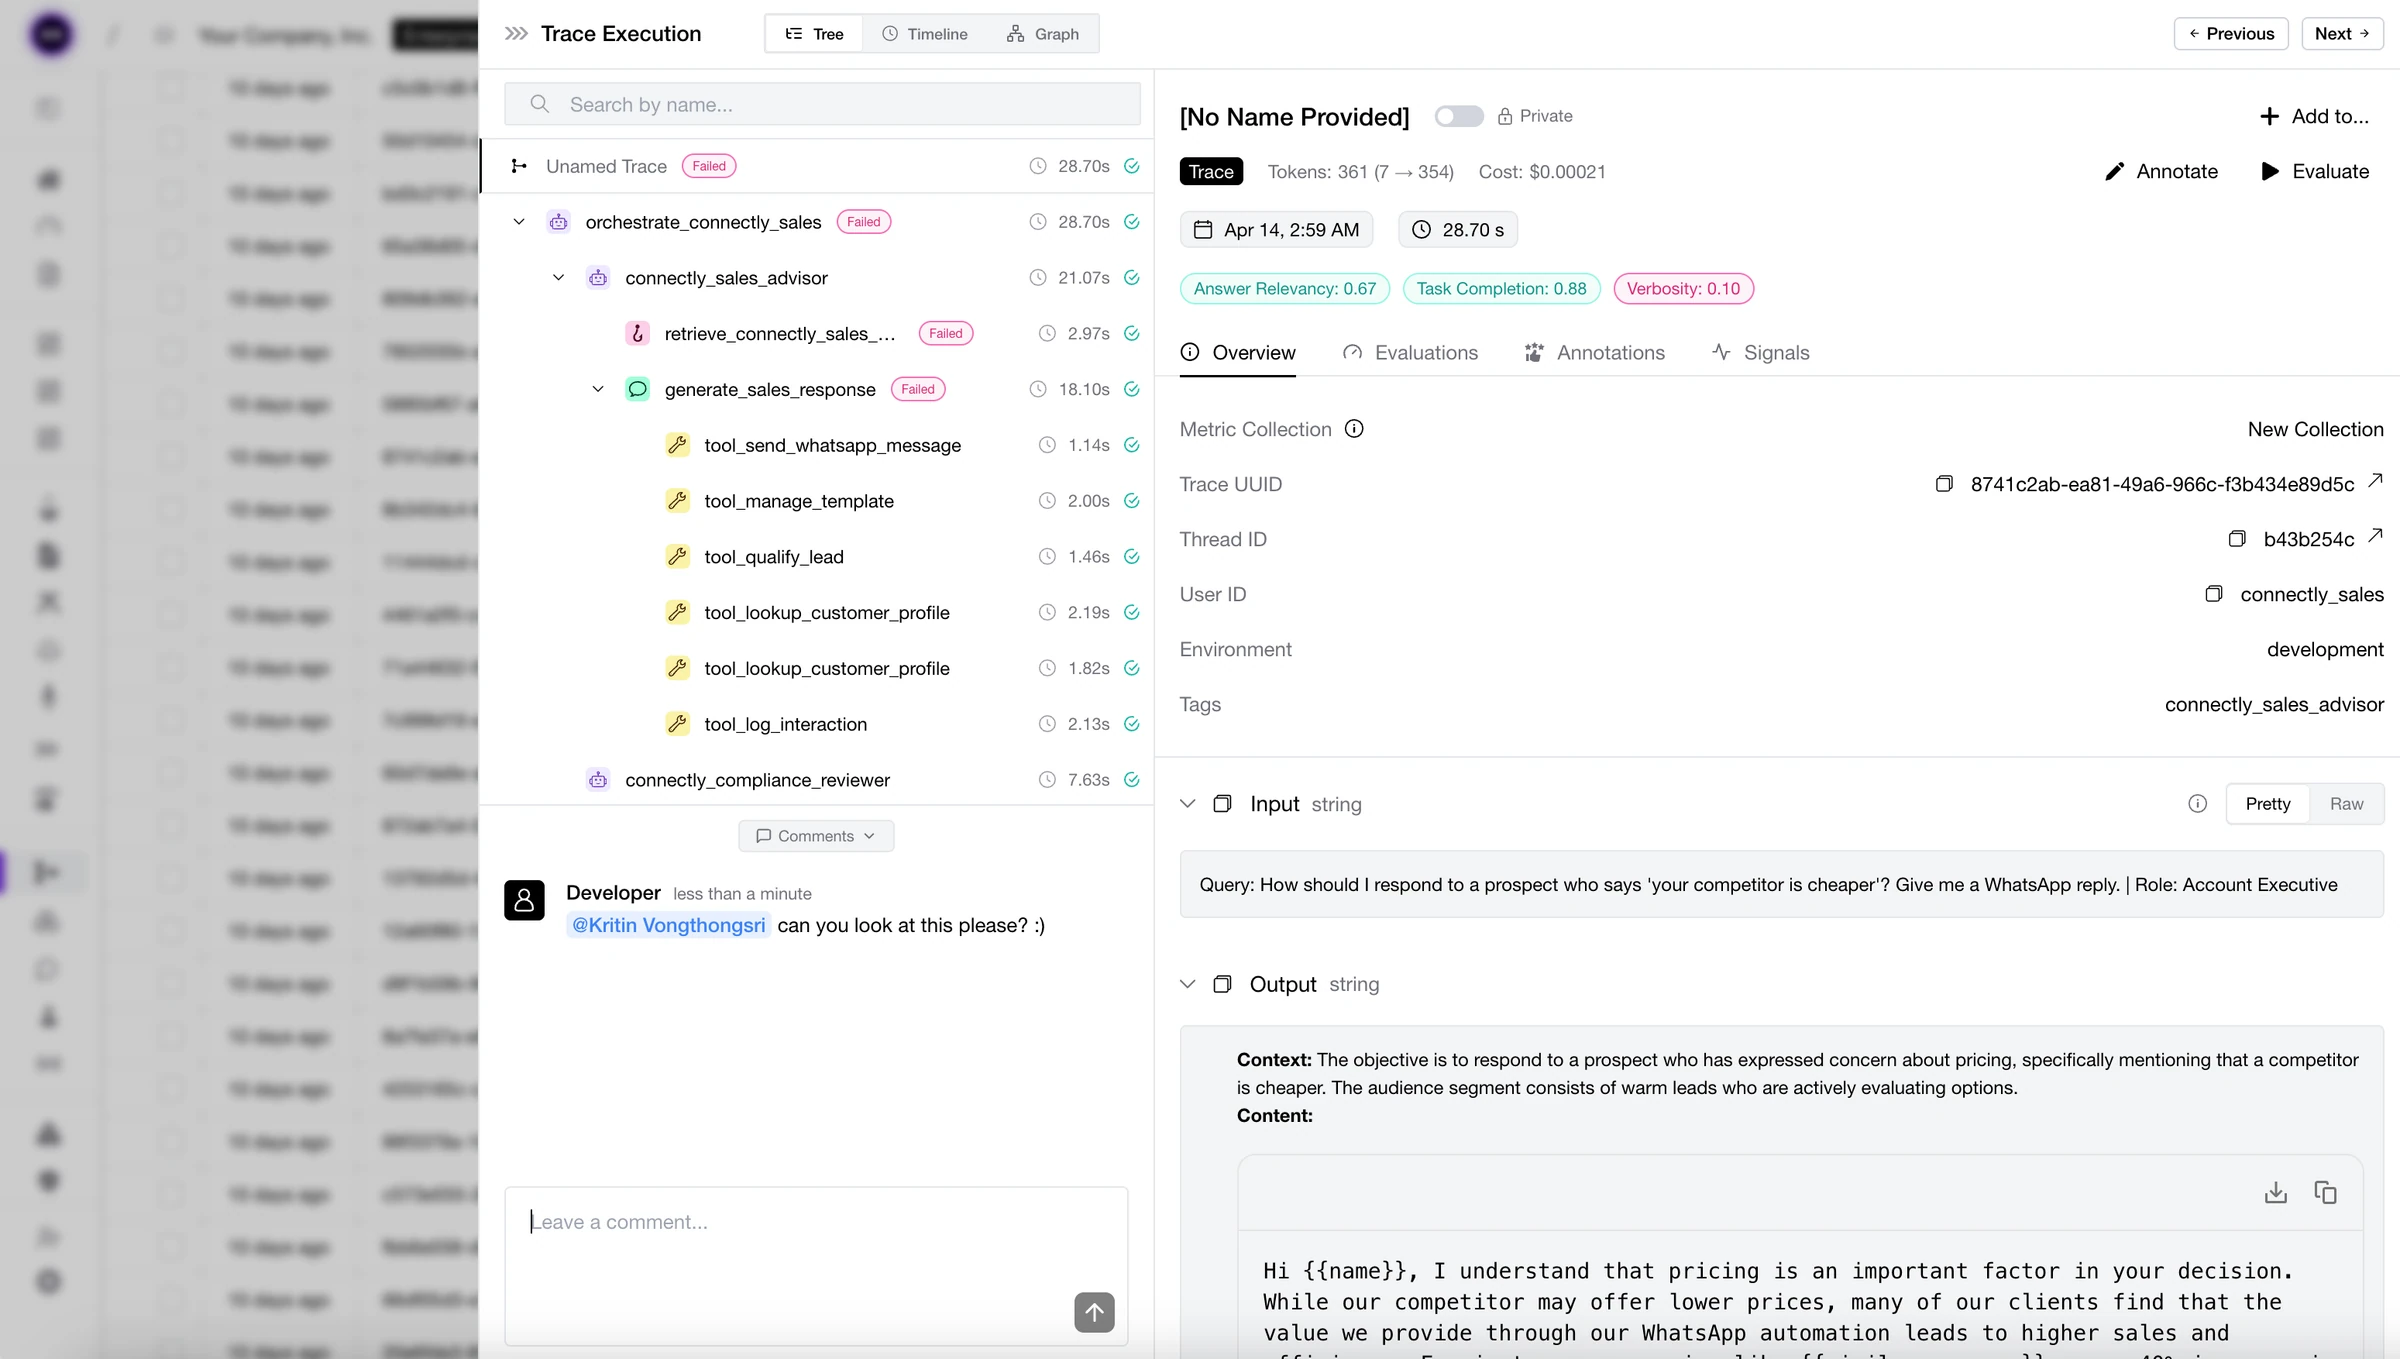
Offizielles Dokumentationsbild von Confident AI, © 2024 Confident AI Inc., Apache 2.0. Die allgemeine Trace-Oberfläche zeigt die Organisation von Ausführungsbelegen, nicht den neuen Audioklassifikator oder Messungen dieses Artikels.

Ein Transkript bewahrt Worte, Audio bewahrt die Interaktion
Ein Transkript erlaubt eine kompakte Prüfung, ob eine Antwort die erwarteten Informationen enthielt. Es kann ein falsches Datum, eine fehlende Anweisung oder einen Widerspruch aufdecken. Über viele Gespräche hinweg ist es leicht durchsuchbar und vergleichbar.
Audio beantwortet andere Fragen. War die Person schon fertig? War eine vermeintliche Pause eigentlich Nachdenken? Hat die Sprechweise einen richtigen Satz schwer verständlich gemacht? Wer nur bereinigten Text liest, kann genau das Ereignis übersehen, das den Anruf frustrierend machte.
Besonders nützlich wird die Unterscheidung, wenn beide Belege auseinandergehen. Das Transkript kann eine vollständige Frage zeigen, obwohl der Agent mitten darin zu antworten begann. Umgekehrt kann ein seltsames Textfragment als kurze Bestätigung im Gespräch ganz natürlich klingen. Halten Sie beides verfügbar, damit Prüfer den Kontext beurteilen können.
Der Audioleitfaden beschreibt, wie eine Aufnahme gemeinsam mit Rolle und Text einer Nachricht zugeordnet und im Trace abgespielt wird. So kann die prüfende Person zwischen verschriftlichtem Inhalt und hörbarem Erlebnis wechseln. Audiodokumentation, geprüft am 27. Oktober 2026.
Wir halten diese zweite Spur für notwendig. Der gesprochene Austausch gehört zum Produkt; seine Qualität lässt sich nicht vollständig durch den endgültigen Text darstellen. Die Verbindung von Aufnahme und Anwendungsereignis macht die Diskussion präziser.
Ein nützlicher Befund enthält einen Zeitpunkt und einen Grund
Die Veröffentlichung vom 23. Oktober ergänzt Audioklassifikatoren für Probleme wie Unterbrechungen, unangenehme Stille und Sprechweise. Hinzu kommt ein Schritt, bei dem ein Mensch vor Bestätigung des Labels zuhört. Der Player markiert Problemzeitpunkte, damit Prüfer zur passenden Stelle zurückkehren können. Neuer Audioprozess.
Das ist handlungsnäher als die allgemeine Beschwerde, der Agent habe falsch geklungen. Entwickler benötigen einen Ort, eine Beschreibung des beobachteten Verhaltens und genug Kontext, um die erwartete Reaktion zu verstehen. Die Klassifikation priorisiert die Suche; der Clip liefert überprüfbare Belege.
Bewahren Sie den Unterschied zwischen Verdacht und bestätigtem Problem. Eine Pause kann angemessen sein, während der Anrufer etwas nachschlägt. Überlappende Sprache kann eine hilfreiche Bestätigung statt einer Unterbrechung sein. Das Label wird erst nützlich, wenn es die tatsächlichen Gesprächserwartungen des Teams abbildet.
Beschreiben Sie diese Erwartungen in Alltagssprache. Ein Unterbrechungsproblem könnte etwa voraussetzen, dass der Agent eine inhaltliche Antwort beginnt, während der Anrufer noch Informationen liefert, sodass etwas verloren geht oder wiederholt werden muss. Das ist ein beispielhaftes Prüfkriterium, keine Produktvorgabe.
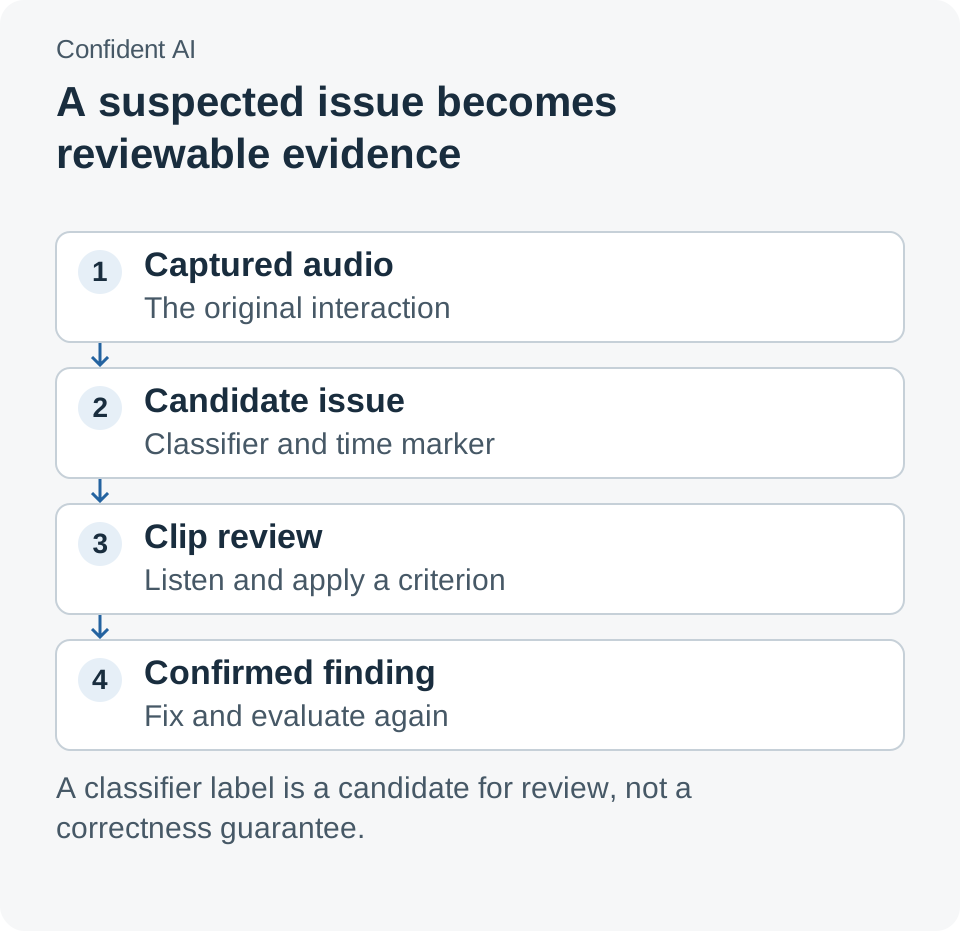
Die Klassifikation findet einen möglichen Fehler. Zuhören und ein klares Kriterium machen daraus einen Befund, an dem das Team arbeiten kann.
Drei Gespräche zeigen, warum Timing Kontext braucht
Betrachten wir zunächst einen Terminassistenten. Der Anrufer möchte eine Buchung verschieben, hält zum Blick in den Kalender inne und nennt dann den Tag. Bietet der Agent während dieser Pause schon Uhrzeiten an, kann seine Antwort inhaltlich passen und die Aufgabe trotzdem stören.
In diesem illustrativen Fall sollte die Prüfung vor und nach der Unterbrechung ansetzen. Hat der Agent nur den Empfang bestätigt oder sich bereits auf eine Deutung festgelegt? Konnte der Anrufer natürlich fortfahren oder musste er neu beginnen? Solche Beobachtungen unterscheiden akzeptable Gesprächsgewohnheiten von reparaturbedürftigen Fehlern.
Das zweite Szenario ist Support für ein unbekanntes Produkt. Der Agent antwortet korrekt, doch die Person weiß nicht, ob sie gehört wurde. Eine lange Zeit ohne Bestätigung kann zur Wiederholung führen, die wiederum als neue Anfrage verstanden wird. Aufnahme und Ausführungstrace zusammen helfen zu finden, wo die wahrnehmbare Verzögerung begann.
Leiten Sie aus einem Beispiel keinen universellen Grenzwert für Stille ab. Eine Kontosuche und die Bestätigung einer einfachen Anweisung erzeugen unterschiedliche Erwartungen. Definieren Sie zuerst die gewünschte Interaktion und vergleichen Sie beobachtete Pausen damit. Entscheidend ist, was die Person vernünftigerweise als gerade ablaufenden Vorgang verstand.
Das dritte Szenario ist ein mehrsprachiger Assistent für Adressen oder Produktcodes. Das Transkript kann eine plausible Wendung enthalten, während die ursprüngliche Aussprache auf einen anderen Begriff deutet. Wiederholtes Anhören beider Seiten hilft zu unterscheiden, ob der Fehler bei Erkennung, Interpretation oder Wiedergabe begann.
Nicht jeder Fehler wird dadurch zum Problem des Audioklassifikators. Die Anwendung braucht vielleicht eine Bestätigung, bessere Wortschatzunterstützung oder eine deutlichere Bitte um Wiederholung wichtiger Angaben. Evaluation ist wertvoll, wenn sie zu einer passenden Änderung der Interaktion führt und nicht nur zum allgemeinen Versuch, freundlicher zu klingen.
| Zu prüfender Beleg | Was er klären hilft | Welcher Kontext weiterhin nötig ist |
|---|---|---|
| Transkript | Erfasste Wörter und Antwortinhalt | Ob Sprecherwechsel und Aussprache verständlich waren |
| Audioclip | Timing, Überlappung, Stille und Sprechweise | Ob das Verhalten die beabsichtigte Aufgabe beeinträchtigte |
| Anwendungstrace | Ausgeführte Schritte und Tooloperationen | Ob die gesamte Interaktion dem Nutzerbedarf entsprach |
| Menschliche Prüfnotiz | Bestätigte Interpretation mit Begründung | Ob eine spätere Änderung denselben Fall tatsächlich behebt |
Ein erfasster Trace garantiert keine abspielbare Aufnahme
Prüfen Sie vor der Audioevaluation, ob der Beleg vorhanden ist. Die Multimodaldokumentation unterscheidet eingebettete Medien, Medienlinks und ausgelassene Dateien. Die allgemeine Erfassung von Modellaufrufen bewahrt unterstützte eingebettete Bilder und PDFs; Audio benötigt einen geeigneten Anhang oder eine unterstützte Sprachintegration. Multimodales Tracing, aktualisiert am 9. Oktober 2026.
Dieser Unterschied beeinflusst die tägliche Fehlersuche. Eine URL im Trace ist ein Verweis und nicht zwingend eine gespeicherte Kopie. Läuft der ursprüngliche Speicherort ab oder fehlt der Zugriff, bleibt der Trace sichtbar, während der hörbare Beleg fehlt. Nehmen Sie Wiedergabe in die erste Integrationsprüfung auf.
Die Dokumentation nennt standardmäßig 5 MiB je Medienelement und insgesamt 16 MiB je Span im TypeScript-SDK. Zu große Medien werden ausgelassen, nicht abgeschnitten. Große Aufnahmen müssen daher bewusst behandelt werden; ein erfolgreich eingetroffener Texttrace beweist nicht, dass sie ebenfalls erfasst wurden. Mediengrenzen.
Der Audioleitfaden ordnet Audio einer Nachricht mit Rolle und Inhalt zu. Für die Evaluation ist diese Zuordnung wichtig: Bewahren Sie, welcher Sprecher die Aufnahme erzeugt hat und welcher Text dazugehört. Ein falsch zugeordneter Clip kann trotz korrekter Wiedergabe zu falschen Schlussfolgerungen führen.
Mit zwölf Clips beginnen, die die Aufgabe erklären
Ein praktischer Pilot kann mit 12 bewusst ausgewählten Clips starten: vier gewöhnliche erfolgreiche Gespräche, vier klare Fehler und vier diskussionsbedürftige Grenzfälle. Das ist ein Vorschlag zur Abstimmung der Prüfung, keine statistisch repräsentative Stichprobe und kein Anbieterbenchmark.
Die Grenzfälle sind besonders wertvoll. Sie zeigen, ob Prüfer Unterbrechungen, akzeptables Warten und verständliche Sprechweise gleich definieren. Bei Uneinigkeit sollten zuerst die Gründe festgehalten werden, bevor ein automatischer Klassifikator ein vermeintlich geklärtes Label reproduzieren soll.
Verwenden Sie einen wiederholbaren Ablauf, damit die erste Evaluation mehr als eine Sammlung von Eindrücken ergibt:
- Erstellen Sie ein Projekt für einen Sprachagenten-Anwendungsfall. Halten Sie den Umfang klein genug, dass für die Clips dieselben Gesprächserwartungen gelten.
- Verknüpfen Sie Aufnahme und Transkript mit derselben Interaktion. Nutzen Sie den dokumentierten Audioanhang oder die passende Sprachintegration. Prüfen Sie, ob beide Seiten eines typischen Gesprächs abspielbar sind.
- Prüfen Sie Belege an den Standardgrenzen. Suchen Sie nach Auslassungsmarkierungen, unerreichbaren Links und falschen Nachrichtenzuordnungen. Beheben Sie Erfassungsfehler, bevor fehlendes Audio als unauffälliger Anruf gilt.
- Definieren Sie wenige Prüflabels. Beschreiben Sie jedes Verhalten konkret und ergänzen Sie einen ähnlichen, aber akzeptablen Fall.
- Klassifizieren Sie und hören Sie markierte Momente an. Bewahren Sie Kandidatenlabel, bestätigte Entscheidung und Begründung. Hören Sie auch unmarkierte Clips, um übersehene Probleme zu finden.
- Ändern Sie einen relevanten Teil und wiederholen Sie die Prüfung. Vergleichen Sie dieselben Fälle nach der Änderung und ergänzen Sie neue Beispiele, bevor der Prozess wächst.
Der Klassifikatorleitfaden erklärt, dass Labelbeschreibungen die Klassifikation beeinflussen und Ergebnisse zu filterbaren Signalen werden. Der ältere allgemeine Leitfaden und das Update vom 23. Oktober beschreiben unterschiedliche Produktstände; orientieren Sie sich für den neuen Audioablauf an den aktuellen Workspace-Funktionen. Dauerhaft gilt: Das gewünschte Verhalten muss so konkret sein, dass ein anderer Prüfer es ebenfalls beurteilen kann. Klassifikatorleitfaden.
Den Prüfprozess ebenso messen wie den Agenten
Mehr erkannte Probleme können verschiedene Ursachen haben. Der Agent könnte schlechter, der Klassifikator empfindlicher oder der Gesprächsbestand schwieriger geworden sein. Halten Sie Evaluationskonfiguration und geprüfte Anrufe sichtbar, damit das Team diese Möglichkeiten unterscheiden kann.
Erfassen Sie im Pilot, wie viele markierte Clips bestätigt werden und wie viele Fehler in unmarkierten Clips auftauchen. Notieren Sie auch die Zeit zum Auffinden der relevanten Stelle. Das sind Beobachtungen des eigenen Prozesses, ohne Anspruch auf eine allgemeingültige Genauigkeitszahl.
Beschreiben Sie bei einer Verbesserung konkret, was besser wurde: Der Anrufer konnte ausreden. Während einer Suche war eine Bestätigung hörbar. Ein unsicherer Code wurde vor einer Aktion rückgefragt. Solche Ergebnisse helfen der Qualitätsdiskussion mehr als die pauschale Aussage, ein Modell klinge natürlich.
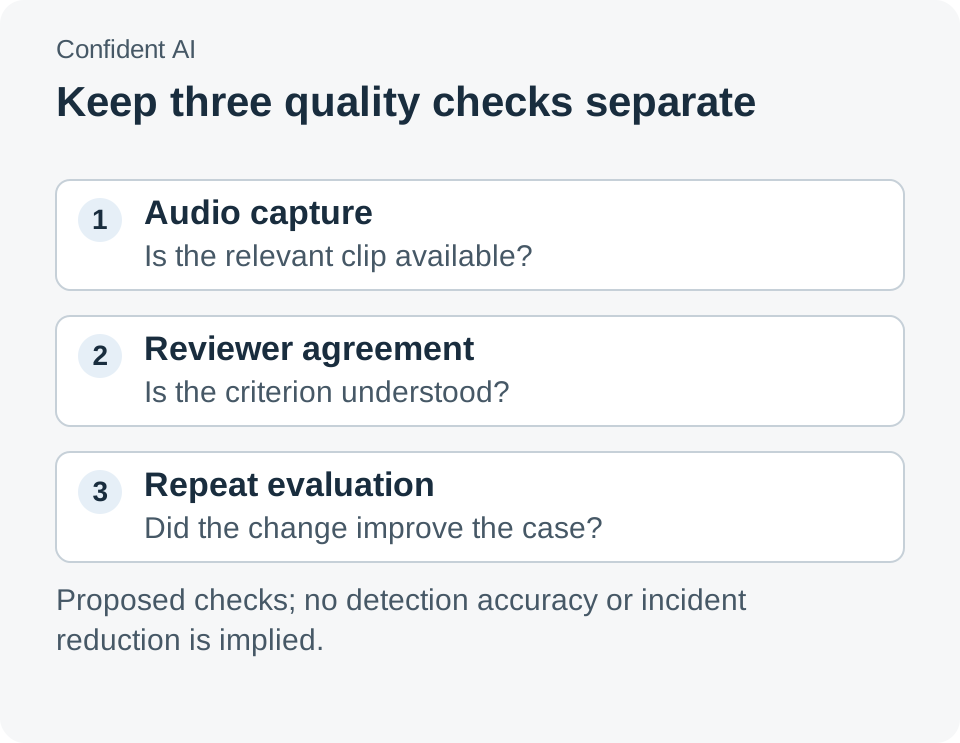
Ein verlässlicher Prüfprozess untersucht Belege, Interpretation und Wirkung einer Änderung getrennt.
Aufnahmezugriff und Speicherung gehören zum Entwurf
Sprachaufnahmen können Informationen enthalten, die nicht jede Prüfung benötigt. Entscheiden Sie, welche Gespräche aufbewahrt werden, wer zuhören darf und wie lange der Beleg nützlich bleibt. Nutzen Sie für den Pilot die kleinste sinnvolle Auswahl, statt ohne Evaluationszweck breit zu sammeln.
Der Datenleitfaden beschreibt Projekte als getrennte Arbeitsbereiche mit eigenen Daten und Zugriffsrechten. Daraus ergibt sich eine praktische Organisationsgrenze: Wer einen Anwendungsfall prüft, benötigt nicht automatisch die Aufnahmen eines anderen. Datenverarbeitung, aktualisiert am 14. Oktober 2026.
Das Änderungsprotokoll vom 23. Oktober führt außerdem Credits und in GB-Monaten gemessenen Trace-Speicher ein. Prüfen Sie vor einer Ausweitung den aktuellen Tarif und die tatsächliche Nutzung. Technisch erfolgreiche Aufnahme ist nur ein Teil eines bezahlbaren und wartbaren Prüfprozesses. Nutzungsänderungen.
Gesprächsqualität wird greifbar, wenn sie erneut hörbar ist
Die interessante Richtung dieser Veröffentlichung ist die Verbindung zwischen Qualitätsurteil und Erlebnis. Zeitmarke, abspielbarer Clip und Prüfentscheidung geben Entwicklern etwas Konkretes zum Verbessern. Sie liefern außerdem eine Aufzeichnung, auf die das Team nach Modell- oder Regeländerungen zurückkommen kann.
Ein natürlich klingender Agent gewinnt Vertrauen im gesamten Austausch: Er hört zu, reagiert zum passenden Zeitpunkt und beendet die Aufgabe verständlich. Bewerten Sie diese Teile gemeinsam, dann wird die Aufnahme zum Beleg für ein besseres Gespräch statt zu einer weiteren Datei im Überwachungssystem.
Quellen
- Confident-AI-Änderungsprotokoll, 23. Oktober 2026.
- Audio in Traces, geprüft am 27. Oktober 2026.
- Multimodales Tracing und Mediengrenzen, aktualisiert am 9. Oktober, geprüft am 27. Oktober 2026.
- Klassifikatoraufgaben, aktualisiert am 6. Oktober 2026. Das Änderungsprotokoll vom 23. Oktober belegt die neuen Audio- und Span-Funktionen.
- Datenverarbeitung, aktualisiert am 14. Oktober 2026.
- Offizielles Dokumentationsbild und Repository, Apache-2.0-Lizenz. Szenarien und der Pilot mit zwölf Clips sind illustrativ; es wurde kein Benchmark zur Erkennungsgenauigkeit durchgeführt.
Eine Empfehlung von Telli.sh
Halten Sie Prüfnotizen, Beispieltranskripte und Entscheidungen hinter einer Gesprächsänderung später leicht auffindbar. Erstellen Sie ein Telli.sh-Konto, um Aufnahmen und Referenznotizen zu organisieren.