[Caderno de ideias de IA 03] ColGrep-Agent: deixe um explorador local encontrar o código antes do modelo maior
Conheça o agente local de busca de código da LightOn: o que ele retorna, como trabalha com assistentes de programação e como testar a economia de tokens sem confundir busca com correção concluída.
Caderno de ideias de IA explora as ideias e as possibilidades práticas de modelos e ferramentas de IA que estão surgindo.
Um relato de erro diz que um upload termina cedo demais. O repositório contém centenas de arquivos, vários manipuladores de progresso e campos de estado com nomes parecidos. Antes de sugerir uma correção, um assistente de IA pode gastar boa parte do turno apenas procurando o código responsável pela conclusão.
O ColGrep-Agent, anunciado pela LightOn em 12 de outubro de 2026, executa localmente essa etapa de busca. Ele explora um repositório e devolve ao assistente principal caminhos de arquivos, intervalos de linhas e código relevantes. A ideia é um explorador local: um especialista menor encontra a trilha antes que o modelo maior raciocine sobre a correção. Anúncio da LightOn
Esta introdução explica os componentes, o caminho prático para começar e o que medir na primeira comparação. O atrativo é reduzir o custo da busca. A pergunta é se essa redução se mantém no repositório, nas perguntas e no hardware que você realmente usa.
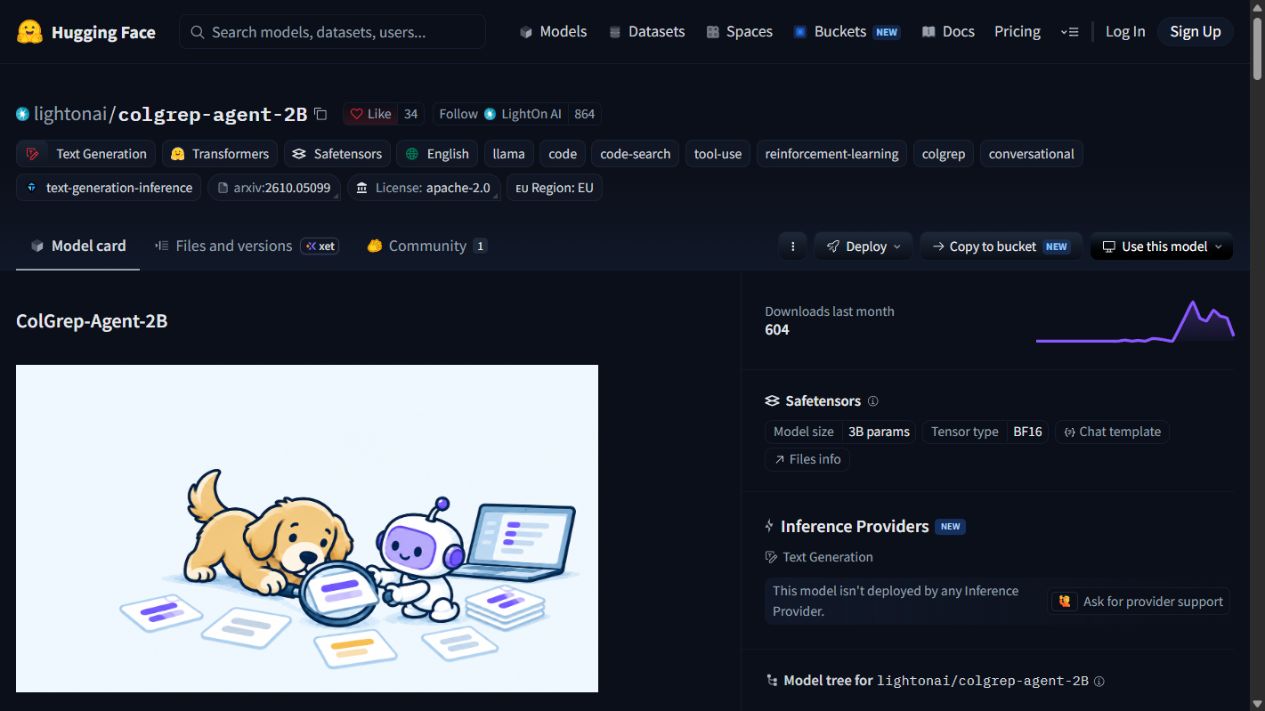 Página pública do modelo, capturada em 20 de outubro de 2026. Esta é uma tela publicada da documentação, não uma evidência de que o modelo rodou na nossa máquina.
Três nomes descrevem três partes do fluxo
ColGrep é a ferramenta de busca semântica. ColGrep-Agent-2B é o nome do modelo lançado. O comando colgrep --agent executa o modelo em um ambiente de busca restrito; é a combinação funcional, não outra família de modelos. Explicação oficial
Essa separação ajuda a escolher quanta infraestrutura acrescentar. Um desenvolvedor pode querer busca semântica no terminal sem um ciclo de agente. Outra equipe pode querer que um assistente faça uma pergunta ao agente local e receba um pacote de contexto menor e mais direcionado.
O sistema combina consultas pelo significado com restrições exatas, como caminhos ou padrões. Essas abordagens resolvem problemas diferentes. Uma pergunta em linguagem natural pode localizar um comportamento com identificadores desconhecidos, enquanto a busca exata continua valiosa para um nome de função copiado de uma stack trace.
Para começar, a saída importante é simples: uma seleção de lugares para examinar. Ainda será necessário entender o código, verificar os contratos ao redor e executar os testes relevantes após alterar o comportamento. Uma localização útil é um insumo para a correção, não a correção em si.
Por que o ciclo de busca pode ficar caro
Um assistente de programação costuma seguir uma sequência: buscar um termo, abrir um arquivo, notar outro identificador, seguir uma referência e buscar novamente. Cada passo acrescenta contexto às chamadas seguintes. Um repositório fácil para um mantenedor pode continuar caro para um assistente que o conhece pela primeira vez.
O ColGrep-Agent transfere esses passos exploratórios para um ciclo local. O assistente principal pergunta, o explorador busca e lê arquivos candidatos, e o contexto devolvido identifica os locais considerados relevantes. A divisão diz respeito à responsabilidade pela exploração, em vez de pedir ao modelo local que resolva toda tarefa de programação.
Imagine investigar por que uma sessão de gravação não se recupera após reconectar. Uma busca ampla por “reconnect” pode retornar utilitários de transporte, notificações de interface e testes antigos. Um resultado útil precisa restringir a lista ao componente atualmente responsável pela sessão e às funções que recriam suas conexões.
Por isso, uma resposta mais curta não representa automaticamente uma busca melhor. Se o explorador remover o único arquivo que explica a persistência final, o assistente principal poderá produzir uma correção confiante, mas incompleta. O objetivo é reduzir contexto irrelevante preservando as evidências necessárias.
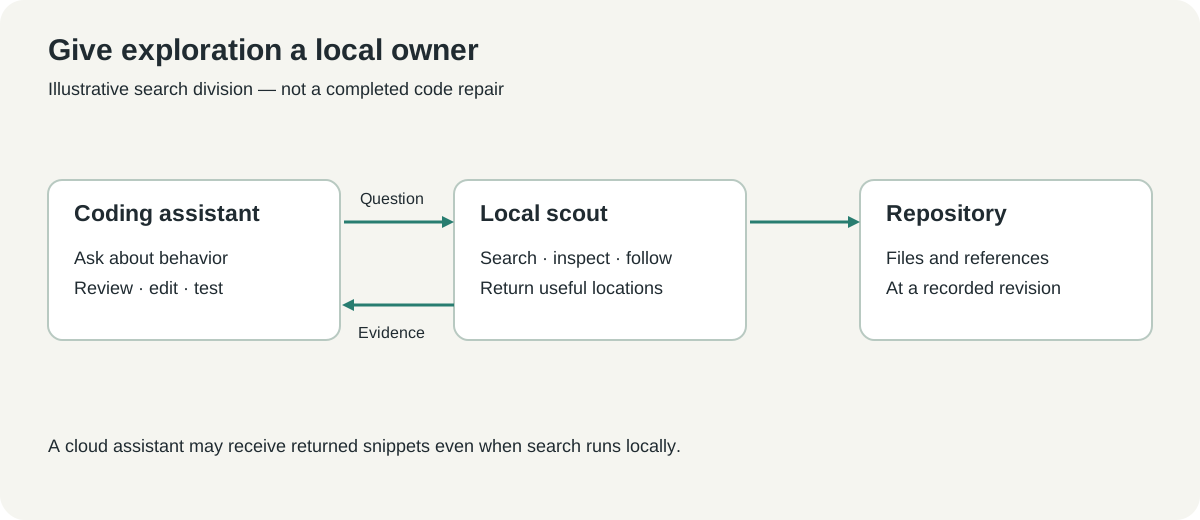 Diagrama original da divisão de trabalho documentada. A pergunta e as localizações de exemplo são ilustrativas.
O resultado destacado trata especificamente de busca de código
A LightOn informa 34% menos tokens de API e 40% menos custo de API considerando cache, em comparação com grep, em um estudo com 52 perguntas de busca de código em 13 repositórios. São medições do desenvolvedor para essa comparação. Elas não demonstram uma redução de 40% no custo de construir ou manter uma aplicação. Descrição do estudo
O escopo importa porque o trabalho de software tem vários custos. A busca pode diminuir enquanto o raciocínio de implementação permanece igual. A execução dos testes pode dominar o tempo total. Um modelo que economiza tokens na nuvem também pode consumir CPU, GPU, memória e tempo de indexação locais.
Considere três perguntas separadas: a busca encontrou o código correto, a tarefa terminou corretamente e quais recursos a tarefa completa consumiu? Medir apenas a mais fácil deixa as outras sem resposta. A equipe deve escolher conforme seu trabalho, em vez de adotar um percentual como previsão universal.
Prompts repetidos também complicam a comparação de preços. Entrada em cache, entrada sem cache e saída gerada podem ter preços diferentes. Registre cada uma separadamente quando a ferramenta permitir e só aplique uma tabela de preços datada após obter as contagens de uso.
Comece com um repositório que você consiga examinar com segurança
As instruções oficiais oferecem instalação para macOS, Windows e compilação do código-fonte. Comece com uma cópia limpa ou um repositório cujo estado você compreenda, e leia as instruções antes de executar um instalador. Não entregue de início um ambiente de produção não revisado a uma ferramenta desconhecida. Documentação do ColGrep
Para leitores de macOS que usam Homebrew, o anúncio da LightOn mostra:
brew install lightonai/tap/colgrep
colgrep --install-agent
O segundo comando prepara o modelo local, não contrata um endpoint de inferência hospedada. O lançamento descreve um download padrão quantizado de cerca de 2.5 GB. Esse é o tamanho de download informado na documentação, não um orçamento completo de memória ou disco para todas as configurações. Configuração do modelo
No Windows, siga a rota PowerShell atual do repositório oficial e examine o instalador antes da execução. O runtime e a aceleração disponíveis dependem da máquina. Um comando bem-sucedido no Mac não comprova configuração, velocidade ou consumo equivalente no Windows.
Use esta sequência inicial para manter o experimento compreensível:
- Registre o commit do repositório e o estado da árvore de trabalho. Escolha uma pergunta cujo código relevante seja conhecido.
- Instale por uma rota documentada e revise
colgrep --helpe as orientações de indexação da versão instalada. - Execute uma busca semântica simples antes de ativar a integração com o agente. Verifique se os arquivos ignorados e diretórios excluídos correspondem ao esperado.
- Teste
colgrep --agentcom a chamada indicada pela ajuda dessa versão. Examine no repositório cada localização retornada. - Conecte a um assistente compatível somente depois que a busca isolada for útil. Preserve a configuração de busca anterior para comparação.
Esses são passos de configuração e avaliação, não um relato de instalação realizada para este artigo. Uma introdução deve ajudar a escolher o primeiro exercício sem inventar o resultado que aparecerá.
Pergunte sobre o comportamento, em vez de indicar um arquivo
Uma boa pergunta descreve o evento e o comportamento que você deseja localizar. “Onde um upload aceito passa a concluído depois que o processamento em segundo plano termina?” informa mais do que “encontre código de upload”. Ela dá ao explorador um contrato a procurar e permite descobrir o verdadeiro responsável.
Evite incorporar sua correção proposta à pergunta. Se você procurar apenas a função que deveria definir uma flag, a busca pode seguir sua hipótese e ignorar o componente que deveria controlar o estado. Comece pelo que o usuário observa e examine a implementação que explica isso.
Três boas perguntas de prática cobrem padrões de navegação distintos. Pergunte onde uma solicitação é autenticada, onde um trabalho em segundo plano persiste o resultado final e onde o frontend assina atualizações de estado. São tarefas ilustrativas que incentivam seguir responsabilidades entre arquivos, em vez de corresponder a um identificador.
Sequências exatas continuam úteis. Uma stack trace, um caminho de rota ou um código de erro tornam a pergunta mais precisa. Combine essa evidência com a descrição do comportamento observado para que a busca não se afaste do fluxo que falha.
Avalie as localizações retornadas antes do texto da resposta
Abra as linhas sugeridas e leia o código ao redor para entender a responsabilidade da função. Um número de linha pode estar correto enquanto o trecho engana por omitir uma condição, um chamador ou a persistência final. O contexto precisa permitir conferir a afirmação, não apenas parecer plausível.
O commit do repositório importa aqui. Um caminho e um intervalo úteis podem ficar desatualizados após uma refatoração. Associe o resultado à mesma revisão usada na avaliação e atualize o índice pelo fluxo documentado quando os arquivos mudarem.
| Resultado da busca | O que o revisor deve verificar | Por que importa |
|---|---|---|
| Responsável correto e contexto útil | O código implementa o comportamento perguntado? | Mostra que o resultado permite agir |
| Apenas um utilitário relacionado | Falta o chamador ou o responsável pelo estado? | Evita uma edição local que deixa o contrato real quebrado |
| Arquivo de teste sem implementação | O teste descreve o comportamento atual ou uma expectativa antiga? | Mantém evidência e implementação conectadas |
| Muitos arquivos plausíveis | O resultado prioriza um conjunto menor sem perder contexto essencial? | Mostra se a busca reduz o trabalho de revisão |
Em um piloto de busca, peça a um mantenedor para identificar os arquivos esperados antes de ver a resposta. Caso contrário, é fácil aceitar uma localização plausível e redefinir silenciosamente o sucesso. Separe perguntas ambíguas, em vez de presumir que cada problema tem exatamente um arquivo correto.
Inclua a conta local na comparação
Execute as mesmas perguntas pelo método existente e pelo novo, na mesma revisão do repositório. Um conjunto inicial pequeno pode ter uma dúzia de perguntas comuns e algumas difíceis sobre responsabilidade. É uma proposta de piloto, não um benchmark oficial nem garantia de confiança estatística.
Registre se cada resultado inclui o arquivo relevante conhecido, quanto código irrelevante retorna, o uso de tokens na nuvem e o tempo total. Registre a construção do índice separadamente das buscas repetidas. Um custo inicial pode ser razoável em um repositório frequente e pouco atraente em uma consulta única.
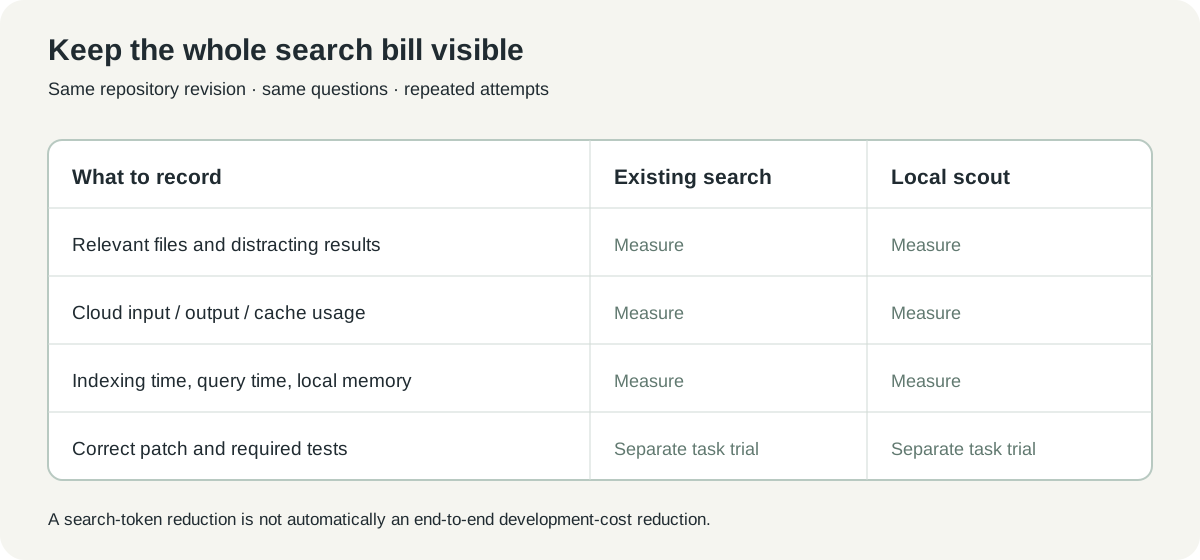 Quadro de avaliação original. Os espaços vazios são intencionais: colete seus próprios valores antes de decidir se a troca compensa.
Se comparar correções completas de bugs, trate isso como outro experimento. Use o mesmo problema, snapshot do repositório, critérios de teste e configuração do modelo; depois, confira o patch. Uma ferramenta vencedora em perguntas de busca pode se comportar de outro modo quando precisa explorar, editar, interpretar testes e corrigir várias vezes.
Repita algumas perguntas, em vez de confiar em uma execução de sorte. A navegação por agentes pode escolher caminhos diferentes a cada tentativa. A conclusão útil talvez seja que o uso típico de tokens cai enquanto perguntas difíceis ficam mais lentas: uma troca real que um número agregado não descreve.
Recuperação local não transforma um assistente na nuvem em offline
A LightOn descreve indexação local e inferência local do agente. Isso pode manter a etapa de busca na máquina, mas um assistente integrado na nuvem ainda pode receber o código selecionado pelo explorador. Avalie o caminho completo, da pergunta à chamada final, em vez de equiparar “busca local” a “nenhum código sai do computador”. Descrição da arquitetura
Revise deliberadamente as exclusões do repositório. Pastas geradas podem criar ruído, enquanto credenciais e exportações privadas não devem virar material de busca apenas por estarem na pasta do projeto. Use o comportamento documentado de exclusão e as práticas normais da sua organização.
Busca somente para leitura é um limite útil para o explorador, mas não autoriza uma alteração posterior. O assistente principal ainda precisa respeitar as instruções do repositório, preservar o trabalho atual e validar a correção. Navegação e autorização continuam sendo responsabilidades diferentes.
Nas equipes, explicite esses limites na documentação de integração. Todos devem saber onde está o índice, qual modelo executa localmente, quais trechos seguem para outro serviço e como desativar a integração. Responsabilidades claras mantêm o experimento compreensível depois que seu criador muda de função.
A melhor economia é explorar menos material irrelevante
Na nossa visão, o ColGrep-Agent apresenta um argumento prático pela especialização. Um assistente não precisa gastar seu raciocínio mais caro em cada busca de diretório se um explorador local consegue devolver evidências relevantes com confiabilidade. A palavra confiabilidade é o que seu piloto precisa demonstrar.
Comece com um repositório e uma pergunta que um mantenedor consiga julgar. Se as localizações reduzirem a leitura sem esconder o responsável pelo comportamento, amplie o teste. O objetivo é encurtar o caminho até uma alteração correta, medindo os custos da busca ao longo dele.
Fontes e mídia
Conferido em 20 de outubro de 2026. Os números publicados são resultados de busca de código informados pela LightOn. Não alegamos instalação local, medição de latência nem benchmark de programação completo. Captura pública feita pelo autor; diagramas originais. Créditos e avisos de licença estão no registro de mídia.
- Anúncio e estudo da LightOn, 12 de outubro de 2026
- Documentação e código do ColGrep
- Documentação do modelo ColGrep-Agent
- Licença Apache 2.0 do repositório
Mantenha o problema conectado às evidências
Guarde o relato original, a pergunta de busca, os links de código e as notas de revisão juntos. O Telli.sh pode ajudar a organizar esse registro da investigação. Crie uma conta no Telli.sh