[KI-Ideen-Notizbuch 03] ColGrep-Agent: Ein lokaler Späher findet den Code, bevor das große Modell ihn liest
LightOns lokaler Agent für die Codesuche: was er liefert, wie er mit Programmierassistenten zusammenarbeitet und wie sich die versprochenen Token-Einsparungen prüfen lassen, ohne Suche und fertige Reparatur zu verwechseln.
Das KI-Ideen-Notizbuch erkundet die Ideen und praktischen Möglichkeiten hinter neu entstehenden KI-Modellen und Werkzeugen.
Ein Fehlerbericht meldet, dass ein Upload zu früh als abgeschlossen gilt. Das Repository enthält Hunderte Dateien, mehrere Fortschrittsbehandler und einige ähnlich benannte Zustandsfelder. Bevor ein KI-Assistent eine Reparatur vorschlagen kann, verbringt er möglicherweise einen großen Teil seines Durchlaufs damit, den für den Abschluss zuständigen Code zu finden.
ColGrep-Agent, von LightOn am 12. Oktober 2026 angekündigt, übernimmt diese Suchphase lokal. Er erkundet ein Repository und liefert relevante Dateipfade, Zeilenbereiche und Code an den eigentlichen Programmierassistenten zurück. Die Idee ist ein lokaler Späher: Ein kleinerer Spezialist findet die Spur, bevor ein größeres Modell über die Reparatur nachdenkt. Ankündigung von LightOn
Diese Einführung erklärt die Bausteine, einen praktischen Einstieg und die Messgrößen für einen ersten Vergleich. Der Reiz liegt im geringeren Suchaufwand. Entscheidend ist, ob diese Verringerung bei Ihrem tatsächlichen Repository, Ihren Fragen und Ihrer Hardware bestehen bleibt.
 Die öffentliche Modellseite, aufgenommen am 20. Oktober 2026. Das ist die veröffentlichte Model Card, kein Beleg für eine Ausführung auf unserem Rechner.
Drei Namen beschreiben drei Teile des Ablaufs
ColGrep ist das Werkzeug für semantische Suche. ColGrep-Agent-2B ist der Name des veröffentlichten Modells. Der Befehl colgrep --agent führt das Modell mit einer begrenzten Suchumgebung aus; er bezeichnet die funktionierende Kombination, keine weitere Modellfamilie. Offizielle Erläuterung
Diese Trennung hilft bei der Entscheidung, wie viel Infrastruktur hinzukommen soll. Ein Entwickler möchte vielleicht semantische Suche im Terminal ohne Agentenschleife. Ein anderes Team möchte, dass ein Programmierassistent dem lokalen Agenten eine Frage stellt und ein kleineres, gezielteres Kontextpaket zurückbekommt.
Das Suchsystem kombiniert bedeutungsbasierte Fragen mit exakten Einschränkungen wie Pfaden oder Mustern. Diese Ansätze lösen unterschiedliche Probleme. Eine natürlichsprachliche Frage kann Verhalten finden, dessen Bezeichner unbekannt sind; eine exakte Suche bleibt für einen aus einem Stacktrace kopierten Funktionsnamen wertvoll.
Für Einsteigende ist das wichtige Ergebnis einfach: eine kurze Liste von Stellen zur Prüfung. Sie müssen den Code weiterhin verstehen, die umgebenden Verträge prüfen und nach einer Verhaltensänderung die relevanten Tests ausführen. Eine nützliche Fundstelle ist eine Eingabe für die Reparatur, nicht die Reparatur selbst.
Warum die Suchschleife teuer werden kann
Ein Programmierassistent arbeitet häufig schrittweise: einen Begriff suchen, eine Datei öffnen, einen weiteren Bezeichner entdecken, einer Referenz folgen und erneut suchen. Jeder Schritt kann den Kontext späterer Modellaufrufe vergrößern. Ein Repository, in dem sich eine erfahrene betreuende Person leicht zurechtfindet, kann für einen Assistenten beim ersten Kontakt trotzdem teuer sein.
ColGrep-Agent verlagert diese Erkundung in eine lokale Schleife. Der Hauptassistent stellt eine Frage, der Späher sucht und liest mögliche Dateien, und der zurückgegebene Kontext nennt die als relevant eingeschätzten Stellen. Bei dieser Arbeitsteilung geht es darum, wer die Erkundung übernimmt, nicht darum, dem lokalen Modell jede Programmieraufgabe zu übertragen.
Stellen Sie sich die Untersuchung einer Aufnahmesitzung vor, die sich nach einer erneuten Verbindung nicht erholt. Eine breite Suche nach „reconnect“ kann Transporthilfen, UI-Meldungen und alte Tests liefern. Ein brauchbares Ergebnis muss diese Liste auf die aktuell zuständige Sitzungskomponente und die Funktionen eingrenzen, die ihre Verbindungen wiederherstellen.
Deshalb ist eine kürzere Antwort nicht automatisch eine bessere Suche. Entfernt der Späher die eine Datei, die die abschließende Speicherung erklärt, kann der Hauptassistent eine selbstsichere, aber unvollständige Lösung erzeugen. Das Ziel ist weniger irrelevanter Kontext bei gleichzeitiger Bewahrung der nötigen Belege.
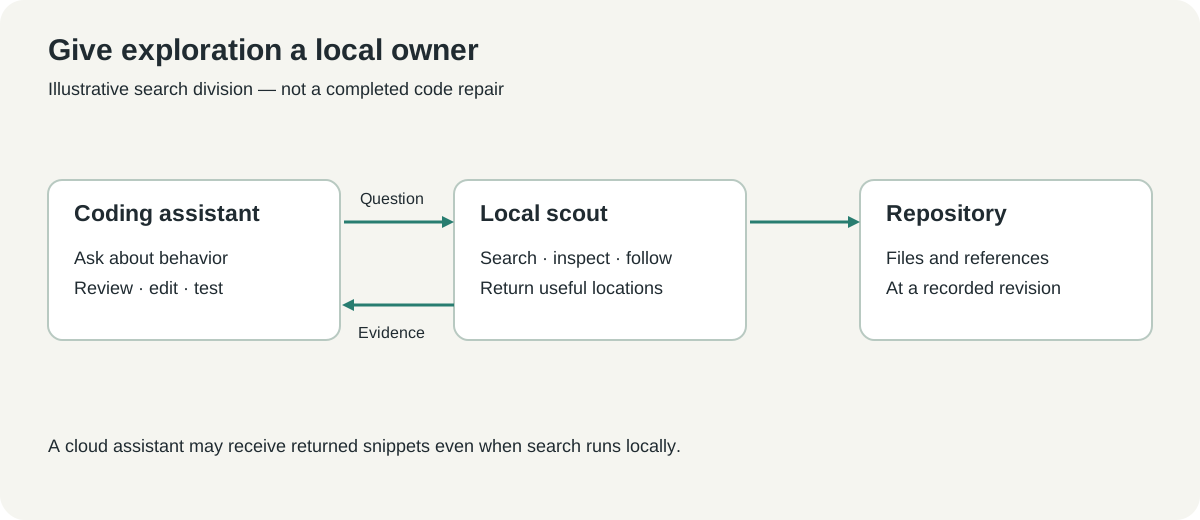 Eigene Erklärungsgrafik zur dokumentierten Arbeitsteilung. Beispielfrage und zurückgegebene Stellen dienen der Veranschaulichung.
Das zentrale Ergebnis bezieht sich ausdrücklich auf Codesuche
LightOn berichtet im Vergleich mit grep von 34% weniger API-Tokens und 40% geringeren cacheberücksichtigenden API-Kosten in einer Untersuchung mit 52 Codesuchfragen aus 13 Repositories. Das sind Messungen des Herausgebers für diesen Vergleich. Daraus folgt keine Senkung der Kosten für Entwicklung oder Wartung einer Anwendung um 40%. Beschreibung der Untersuchung
Der Umfang ist wichtig, weil Softwarearbeit mehrere Kostenarten hat. Die Suche kann schrumpfen, während das Nachdenken über die Implementierung unverändert bleibt. Die Testausführung kann die Gesamtdauer bestimmen. Ein Modell, das Cloud-Tokens spart, beansprucht möglicherweise lokale CPU, GPU, Speicher und Indexierungszeit.
Stellen Sie drei getrennte Fragen: Hat die Suche den richtigen Code gefunden? Wurde die Programmieraufgabe korrekt abgeschlossen? Welche Ressourcen hat die gesamte Aufgabe verbraucht? Wer nur die einfachste Frage misst, lässt die anderen beiden offen. Ein Team sollte die zu seiner Arbeit passende Abwägung wählen, statt eine Prozentzahl als allgemeine Prognose zu übernehmen.
Wiederholte Prompts erschweren außerdem Preisvergleiche. Anbieter können zwischengespeicherte Eingaben, nicht zwischengespeicherte Eingaben und erzeugte Ausgaben unterschiedlich berechnen. Erfassen Sie diese separat, soweit das Werkzeug die Informationen liefert, und wenden Sie erst nach der Nutzungsmessung eine datierte Preisliste an.
Beginnen Sie mit einem Repository, das Sie sicher beurteilen können
Die offizielle Einstiegsanleitung bietet Installationswege für macOS, Windows und das Bauen aus dem Quellcode. Beginnen Sie mit einer sauberen Kopie oder einem Repository, dessen Zustand Sie kennen, und lesen Sie vor einem Installer die Veröffentlichungshinweise. Geben Sie einem unbekannten Werkzeug nicht als ersten Schritt einen ungeprüften Produktionsarbeitsbereich. ColGrep-Dokumentation
Für macOS mit Homebrew zeigt LightOns Ankündigung:
brew install lightonai/tap/colgrep
colgrep --install-agent
Der zweite Befehl bereitet das lokale Modell vor, statt ein Abonnement für einen gehosteten Inferenzendpunkt abzuschließen. Die Veröffentlichung beschreibt einen standardmäßigen Download eines quantisierten Modells von ungefähr 2.5 GB. Das ist eine dokumentierte Downloadgröße, kein vollständiges Speicher- oder Festplattenbudget für jede Konfiguration. Modelleinrichtung
Unter Windows sollten Sie dem aktuellen PowerShell-Weg im offiziellen Repository folgen und den Installer vor der Ausführung prüfen. Laufzeitumgebung und Beschleunigung hängen vom Rechner ab. Ein erfolgreicher Befehl auf einem Mac belegt keine gleichwertige Einrichtung, Geschwindigkeit oder Ressourcennutzung unter Windows.
Dieser Ablauf hält den ersten Versuch nachvollziehbar:
- Dokumentieren Sie Commit und Zustand des Arbeitsverzeichnisses. Wählen Sie eine Frage, deren relevanter Code bekannt ist.
- Installieren Sie über einen dokumentierten Weg und prüfen Sie anschließend
colgrep --helpsowie die Indexierungshinweise der installierten Version. - Führen Sie zunächst eine einfache semantische Suche aus, bevor Sie die Agentenintegration aktivieren. Prüfen Sie, ob ignorierte Dateien und ausgeschlossene Verzeichnisse Ihren Erwartungen entsprechen.
- Probieren Sie
colgrep --agentmit dem in der Hilfe dieser Version angegebenen Aufruf aus. Prüfen Sie jede zurückgegebene Stelle im Repository. - Verbinden Sie das Werkzeug erst mit einem unterstützten Programmierassistenten, wenn die eigenständige Suche nützlich ist. Bewahren Sie die bisherige Suchkonfiguration als Vergleich auf.
Das sind Einrichtungs- und Bewertungsschritte, kein Bericht über eine für diesen Artikel ausgeführte Installation. Eine Einführung sollte bei der Wahl einer ersten Übung helfen, ohne deren Ergebnis zu erfinden.
Fragen Sie nach Verhalten, statt eine Datei vorzugeben
Eine gute Suchfrage beschreibt das Ereignis und das gesuchte Verhalten. „Wo wird ein angenommener Upload nach Abschluss seiner Hintergrundverarbeitung als fertig markiert?“ ist aussagekräftiger als „Upload-Code finden“. Sie gibt dem Späher einen Vertrag vor, lässt aber offen, welche Komponente tatsächlich zuständig ist.
Vermeiden Sie es, die vorgeschlagene Reparatur schon in die Frage einzubauen. Fragen Sie ausschließlich nach der Funktion, die ein bestimmtes Flag setzen sollte, folgt die Suche womöglich Ihrer Annahme und übersieht die eigentlich zuständige Zustandskomponente. Beginnen Sie mit der Beobachtung der Nutzenden und prüfen Sie dann die erklärende Implementierung.
Drei nützliche Übungsfragen decken unterschiedliche Navigationsmuster ab: Wo wird eine Anfrage authentifiziert? Wo speichert ein Hintergrundauftrag sein Endergebnis? Wo abonniert das Frontend eine Statusaktualisierung? Diese Beispielaufgaben fördern das Nachverfolgen von Verantwortlichkeiten über Dateigrenzen hinweg, statt nur einen Bezeichner abzugleichen.
Exakte Zeichenfolgen bleiben sinnvoll. Ein Stacktrace, Routenpfad oder Fehlercode kann eine Frage stark präzisieren. Verbinden Sie diese Belege mit einer Beschreibung des beobachteten Verhaltens, damit die Suche nicht den Bezug zum fehlerhaften Ablauf verliert.
Bewerten Sie die Fundstellen vor dem Text
Öffnen Sie die vorgeschlagenen Zeilen und lesen Sie genügend umgebenden Code, um die Verantwortung der Funktion zu verstehen. Eine Zeilennummer kann stimmen und der Ausschnitt dennoch irreführen, weil eine Schutzbedingung, ein Aufrufer oder ein abschließender Speicherschritt fehlt. Der Kontext muss die Aussage überprüfbar machen, nicht bloß plausibel aussehen.
Hier ist der Repository-Commit wichtig. Ein nützlicher Pfad und Zeilenbereich können nach einer Umstrukturierung veralten. Verknüpfen Sie das Suchergebnis mit derselben Revision, die bei der Bewertung verwendet wurde, und aktualisieren Sie den Index bei Quellcodeänderungen nach dem dokumentierten Ablauf.
| Suchergebnis | Was zu prüfen ist | Warum es zählt |
|---|---|---|
| Richtige zuständige Komponente mit nützlichem Kontext | Implementiert der Code das in der Frage beschriebene Verhalten? | Zeigt, dass sich mit dem Ergebnis arbeiten lässt |
| Nur eine verwandte Hilfsfunktion | Fehlt der Aufrufer oder die zuständige Zustandskomponente? | Verhindert eine lokale Änderung, die den eigentlichen Vertrag defekt lässt |
| Testdatei ohne Implementierung | Beschreibt der Test aktuelles Verhalten oder eine alte Erwartung? | Verbindet Belege mit Implementierung |
| Viele plausible Dateien | Kann eine kleinere Auswahl priorisiert werden, ohne wesentlichen Kontext zu verlieren? | Zeigt, ob die Suche den Prüfaufwand verringert |
Lassen Sie bei einem Codesuchpilot die erwarteten Dateien von einer betreuenden Person bestimmen, bevor sie die Werkzeugantwort sieht. Sonst lässt sich leicht eine plausible Stelle akzeptieren und der Erfolg stillschweigend neu definieren. Erfassen Sie mehrdeutige Fragen separat, statt so zu tun, als hätte jedes Problem genau eine richtige Datei.
Bauen Sie einen Vergleich, der auch die lokale Rechnung enthält
Führen Sie dieselben Fragen mit der bisherigen und der neuen Suchmethode auf derselben Repository-Revision aus. Ein kleiner Einstieg könnte ein Dutzend gewöhnliche und einige schwierigere Fragen zu Verantwortlichkeiten enthalten. Das ist ein Vorschlag für einen Pilotversuch, kein offizieller Benchmark und keine Zusicherung statistischer Sicherheit.
Erfassen Sie, ob jedes Ergebnis die bekannte relevante Datei enthält, wie viel irrelevanter Code zurückkommt, wie viele Cloud-Tokens verbraucht werden und wie lange es dauert. Messen Sie den Indexaufbau getrennt von wiederholten Suchen. Ein anfänglicher Einrichtungsaufwand kann für häufig genutzte Repositories angemessen, für einmalige Orientierung aber unattraktiv sein.
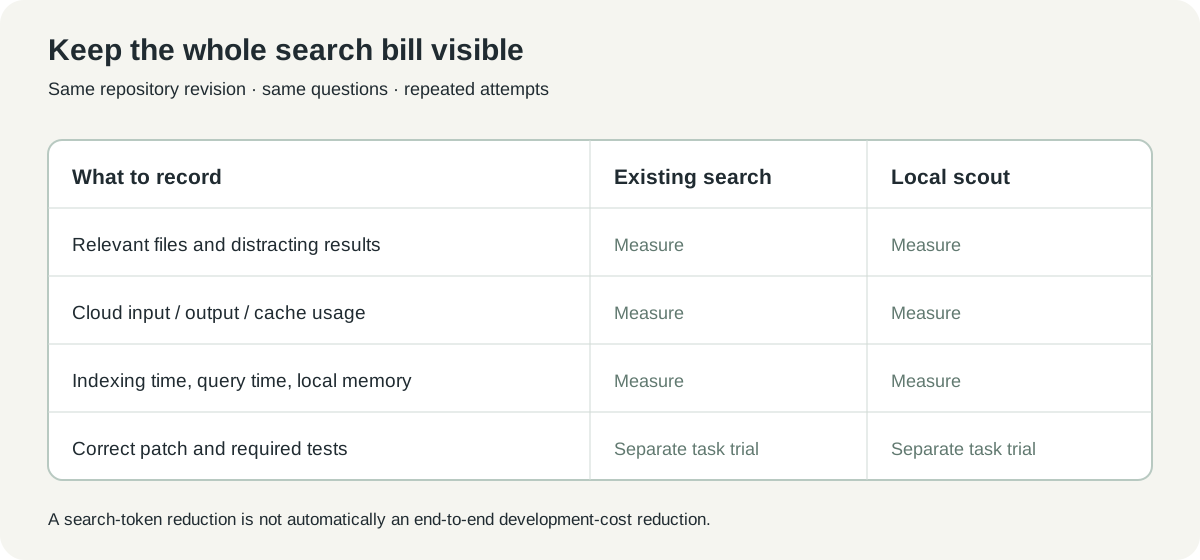 Eigenes Bewertungsprotokoll. Die Messfelder bleiben absichtlich leer: Erheben Sie eigene Werte, bevor Sie die Abwägung beurteilen.
Wenn Sie auch vollständige Fehlerbehebungen vergleichen, behandeln Sie das als eigenen Versuch. Nutzen Sie dasselbe Problem, denselben Repository-Stand, dieselben Testkriterien und dieselbe Modellkonfiguration und prüfen Sie anschließend den entstandenen Patch. Ein Werkzeug, das Suchfragen gewinnt, kann sich anders verhalten, wenn eine Aufgabe Erkundung, Änderungen, Testinterpretation und mehrere Korrekturrunden erfordert.
Wiederholen Sie einige Fragen, statt einem einzigen glücklichen Durchlauf zu vertrauen. Agentengestützte Navigation kann zwischen Versuchen andere Wege einschlagen. Die nützliche Schlussfolgerung könnte lauten, dass der typische Tokenverbrauch sinkt, schwierige Fragen aber langsamer werden. Das ist eine reale Abwägung, die ein Gesamtwert nicht beschreibt.
Lokales Retrieval macht einen Cloud-Assistenten nicht offline
LightOn beschreibt lokale Indexierung und lokale Agenteninferenz. Das kann die Suchphase auf Ihrem Rechner halten; ein integrierter Cloud-Programmierassistent erhält möglicherweise trotzdem den ausgewählten Code vom Späher. Prüfen Sie den vollständigen Weg von der Frage zum letzten Modellaufruf, statt „lokale Suche“ mit „kein Code verlässt den Computer“ gleichzusetzen. Architekturbeschreibung
Repository-Ausschlüsse sollten bewusst geprüft werden. Generierte Ordner können Rauschen verursachen; Zugangsdaten und private Exporte sollten nicht allein deshalb Suchmaterial werden, weil sie im Projektverzeichnis liegen. Nutzen Sie das dokumentierte Ignore-Verhalten und die üblichen Repository-Verfahren Ihrer Organisation.
Nur lesende Suche ist eine sinnvolle Grenze für einen Späher, genehmigt aber keine spätere Änderung. Der Hauptassistent muss weiterhin die Repository-Vorgaben beachten, bestehende Arbeit bewahren und jede resultierende Reparatur validieren. Navigation und Berechtigung bleiben getrennte Verantwortlichkeiten.
Machen Sie diese Grenzen für Teams in der Integrationsdokumentation sichtbar. Alle sollten wissen, wo der Index liegt, welches Modell lokal läuft, welche ausgewählten Ausschnitte einen anderen Dienst erreichen und wie die Integration deaktiviert wird. Klare Zuständigkeiten halten einen nützlichen Versuch auch dann verständlich, wenn sein ursprünglicher Autor nicht mehr dabei ist.
Die beste Einsparung ist weniger irrelevante Erkundung
Unserer Ansicht nach liefert ColGrep-Agent ein praktisches Argument für Spezialisierung. Ein Programmierassistent muss nicht bei jeder Verzeichnissuche seine teuersten Denkschritte einsetzen, wenn ein lokaler Späher die relevanten Belege zuverlässig zurückgeben kann. Das Wort zuverlässig muss Ihr Pilotversuch belegen.
Beginnen Sie mit einem Repository und einer Frage, die eine betreuende Person beurteilen kann. Wenn die Fundstellen das Lesen reduzieren, ohne die zuständige Verhaltenskomponente zu verbergen, erweitern Sie den Versuch. Das Ziel ist ein kürzerer Weg zur korrekten Änderung, begleitet von einer gemessenen Suchrechnung.
Quellen und Medien
Geprüft am 20. Oktober 2026. Die Leistungsangaben sind LightOns veröffentlichte Ergebnisse zur Codesuche. Eine lokale Installation, Latenzmessung oder ein vollständiger Programmierbenchmark wird nicht behauptet. Der Autor hat den öffentlichen Screenshot aufgenommen; die Diagramme sind eigene Arbeiten. Quellen- und Lizenzhinweise stehen im Mediennachweis.
- LightOn-Ankündigung und Untersuchung vom 12. Oktober 2026
- ColGrep-Dokumentation und Quellcode
- ColGrep-Agent Model Card
- Apache-2.0-Lizenz des Repositorys
Halten Sie Fehlerbericht und Belege zusammen
Speichern Sie ursprünglichen Bericht, Suchfrage, relevante Codelinks und Prüfnotizen gemeinsam. Telli.sh kann helfen, diese Untersuchungsunterlagen zu organisieren. Telli.sh-Konto erstellen