Baseten joey-1:每一个 AI 决策都需要大模型吗?
一个 2B 决策模型、每百万输入 token 0.01 美元的 API,以及把不确定任务交给更大模型或人工的实用分流方法。
“这张工单该由哪个团队处理?”通常不需要五段长文。它需要的是几个有效去向之一、足以支持负责任选择的置信度,以及请求不符合既定类别时寻求帮助的途径。
Baseten 于 2026 年 10 月 29 日推出 joey-1,面向的正是这类工作。它由研究团队 Base Labs 开发,与 elephant-1 和 mammoth-1 同属决策模型系列,位于该系列的小型端。吸引力在于更明确的输出约定:返回决策和概率,而不是让应用程序再去解释一段生成式说明。Baseten 的发布公告介绍了这次推出。
实际机会在于重新分工:让小模型处理定义清楚、反复出现的决策,把更多资源留给不确定的其余任务。本文解释价格计算、三个假设应用,以及让这种路由策略真正有用所需的检查。
 Baseten 官方 joey-1 模型卡横幅。图片:Base Labs / Baseten,来自声明采用 MIT 许可的模型仓库;已缩放并添加留白。图片来源 · 许可与图片说明。
决策模型应从应用能够接受的选项出发
通用语言模型可以输出“账务”、返回 JSON,或解释客户为何应该获得退款,以此为请求分类。这些接口各有用途。专用决策模型则聚焦于从给定答案中选择,并以结构化形式报告概率。
这会改变推理前的准备工作。问题需要精确,选项需要对应有意义的行动。“我们该怎么办?”是一个薄弱约定。“账务、技术支持、反欺诈,哪个团队应接收此案例?”更加明确,但仍需要为同时匹配多个团队或完全不匹配的请求制定规则。
截至 11 月 2 日查阅的 Baseten joey-1 模型库页面说明,它通过 /v1/systemone 支持文本与图像输入、选择题、是非判断及有序评分。结果面向程序使用。如果用户需要解释或回复,它不能代替单独的解释或回复生成模块。
可以把小模型看作分拣台:把常规工作送往正确位置,把特殊案例交给掌握更多权限或上下文的人。即便每次推理都很便宜,一个自信地把难题分错地方的分拣台,也会给下游制造隐性工作。
因此,应用应保留不确定性。路由系统可以记录暂定标签、提出澄清问题,或交给人工处理,不必把每个概率分布立即变成业务行动。
一美分购买的是输入 token,而不是固定次数的决策
截至 2026 年 11 月 2 日,官方价格条目列出 每 100 万输入 token 0.01 美元,缓存输入和输出标价均为 $0.00。“一美分”指的是这个 token 单位。包含长篇历史记录的请求,比经过仔细限定的短请求消耗更多输入处理。
下表按公布的输入费率演示计算,未计税费、其他服务或商业条款。它假设输入未缓存、价格稳定,是规划示例,而不是账单估算。
| 示例工作量 | 输入 token 总量 | 每百万 0.01 美元的输入费用 |
|---|---|---|
| 100,000 次请求 × 500 token | 5,000 万 | $0.50 |
| 100 万次请求 × 500 token | 5 亿 | $5.00 |
| 1,000 万次请求 × 500 token | 50 亿 | $50.00 |
| 100 万次请求 × 2,000 token | 20 亿 | $20.00 |
公式很简单:输入 token 总量除以 100 万,再乘以 $0.01。运营计算的范围更大,还应纳入升级处理、数据准备、重试、监控和人工修正的成本。
假设两种路由配置的模型使用费用只差几美元。第一种减少了复核量,却偶尔把紧急请求送入缓慢队列;第二种升级处理更多请求,但避免了这类错误。正确选择取决于错误代价和可用复核能力,不能只看最便宜的 token 账单。
推理越便宜,这一点越重要。当模型费用只占流程总成本的一小部分,适度改善校准或标签设计,可能比进一步降低 token 价格更有价值。低价扩大了可行自动化的范围,却没有取消评估结果价值的必要。
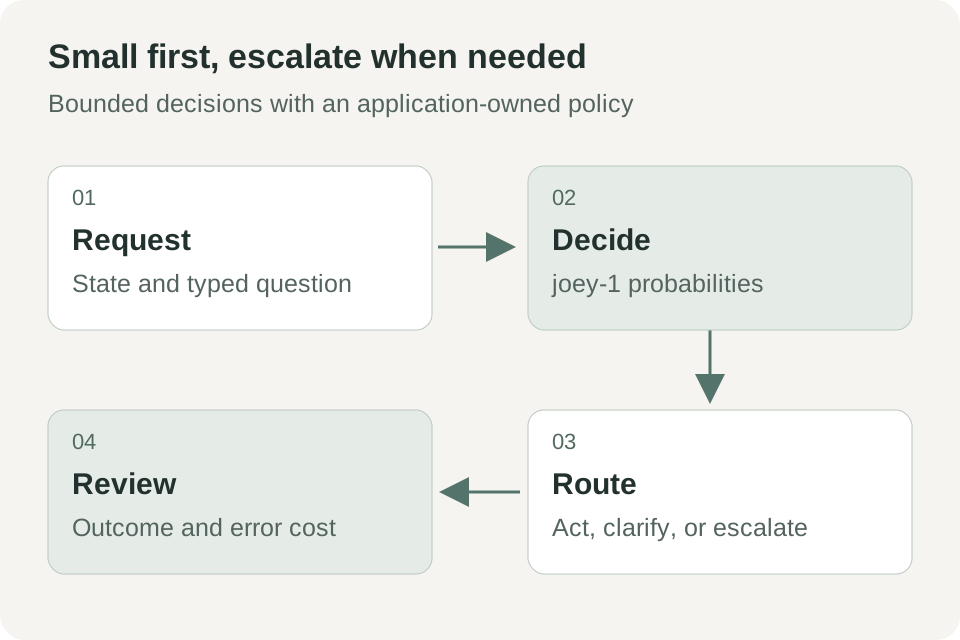 原创路由图,参考 Baseten 10 月 29 日公告中的升级处理思路。阈值由部署应用负责设定。
标签有明确负责人,工单路由才适合作为首个任务
在一个假设客服流程中,joey-1 把新消息分到账务、技术支持或账户安全团队。另一个是非问题检查客户是否要求退款,有序评分则判断需要多快处理。
这些问题相关,却不该合并成单一标签。账务请求也可能紧急,账户安全请求也可能包含退款要求。分别决策,更容易明确每个团队收到什么,以及哪些组合需要特殊处理。
首先应与队列负责人一起编写标签,纳入过去引发分歧的案例。例如,一条消息提到软件缺陷导致支付失败,该怎么处理?组织自己未定义清楚的边界,模型无法代为解决。
上线前,先把建议与现有决策比较,再自动转移工作。按类型复核分歧:政策含糊、上下文缺失、明确的模型错误,或历史标签本身不正确。单一总体准确率会掩盖这些不同问题。
Baseten 的 10 月 29 日公告把 joey-1 定位为第一线模型,不确定时可交给更大的同系列模型。它报告,在其生产服务条件下,平均 2,000 token 的请求具有 20 ms 的 P50 端到端延迟。这是特定服务负载的供应商测量,不是对你的应用或硬件的延迟保证。来源:Baseten。
文档路由器应知道什么时候没有合适去向
第二个假设用途是文档接收。应用收到文件后,需要判断它应进入发票流程、费用复核,还是一般档案队列。文本和可选图像输入适用于混合文档材料,前提是提交的表示包含完成任务所需的信息。
实际决策应严格限定。判断页面看起来是不是发票,不等于核验发票真伪、法律充分性或是否应付款。分类器可以帮助选择流程,但不必获得批准付款的权限。
最有价值的测试案例可能在分类体系之外:合同附带收据、模糊到无法阅读的图像,或不支持的语言。如果应用只提供三个有效去向,就需要另一套机制处理证据不足和陌生内容。明确的复核路径比强行猜测更易运营。
也要跟踪输入群体的变化。评估时主要看到简短本国发票的模型,之后可能遇到多页对账单和扫描信函。只监控最终标签可能错过这种变化,应在适当保护隐私的前提下记录请求长度、输入类型、不确定性及复核结果。
截至 11 月 2 日查阅的模型卡将 joey-1 描述为从 Qwen3.5-2B 后训练而来的 2B 参数模型,并列出 MIT 许可。这些信息支持开放权重部署选项,却不能证明统一的内存要求、CPU 性能,或公告中每张插图的再利用权限。
图像检查要围绕确实可观察的条件
第三个场景是假设在人工商品目录审核前检查提交的产品照片。有用的问题包括标签是否可见、是否包含指定物品,或遮挡是否严重到无法判断。每个问题都应指向图中能观察到的内容。
不好的评分准则会把观察与隐藏事实混在一起。仅凭产品照片,无法判断“卖家是否值得信任”。“要求提供的序列号区域是否可见?”则更明确,也能为下一流程要求补拍提供具体原因。
如果复核人员已有共同准则,例如不可用、需复核、可用,有序评分就可能有价值。标准应让人能够一致执行。如果相邻两级连人都无法区分,概率分布也修不好这个分类体系。
在允许自动拒绝之前,先用模型安排复核优先级。拒绝提交可能直接影响客户,误拒成本可能高于自动化节省。复核阶段还能提供例子,用于完善准则并检查不同输入条件下的表现。
这些是设计示例,不是已报告的 joey-1 部署。共同点是提出边界明确的问题,再采取可逆的下一步。这是了解模型如何处理自身数据的合理起点。
概率变成行动之前,需要先有政策
置信度数值不是权限标志。如果应用决定超过 0.90 就采取行动,这个阈值是一项需要测量后果的设计选择。高分仍可能出错,尤其是请求与建立阈值时的数据不同时。
不同错误需要不同政策。把普通问题分错客服团队只是造成不便,把账户被盗报告当成常规请求则可能代价高得多。不能自动用同一个概率阈值管理两者。
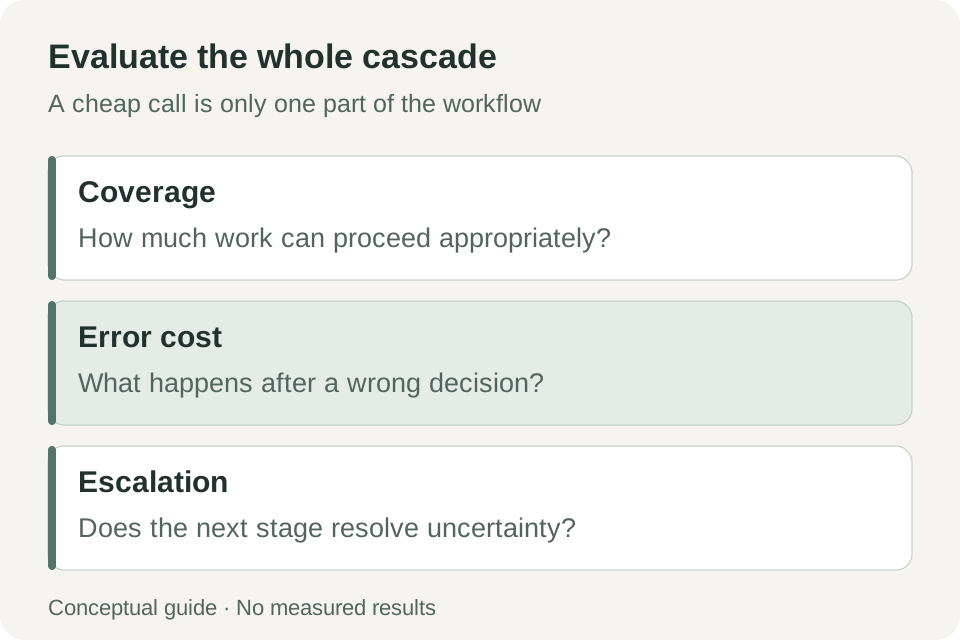 原创评估框架。覆盖率、错误行动代价和升级处理质量都是应用指标;图中不包含 joey-1 的实测结果。
构建包含典型常规案例、难例和范围外输入的留出集。对每个候选阈值,检查自动处理比例及其中错误,再观察其余请求如何处理。如果模型靠几乎全部升级来避免错误,工作流程可能根本没有改变。
将整个级联系统与单独使用大模型比较。小模型优先增加了一个路由阶段,也带来自己的失败模式和延迟。只有足够多的请求能在首阶段妥善处理,升级路径也改善剩余难例时,这种设计才占优。
可以从托管 API 开始,也可以明确预算自托管成本
Baseten 提供托管 Model APIs、专用部署和可下载权重,需要分别检查上下文及服务条件。发布文章称 Model APIs 为 16k 上下文,专用部署有 262k 选项;模型卡则指定 16,384 token 的训练序列长度,并拒绝超出训练限制的请求。不能把某一个最大值不加区分地套用到所有路径。发布文章、模型卡。
- 选定一个决策约定。 写明有效选项、各自含义,以及证据不足时应用如何处理。
- 选择部署路径。 托管试点可打开模型 API 入口,在供应商账户界面创建凭据;本地服务则遵循模型卡锁定的运行时要求。
- 发送最小请求。 官方示例使用
https://inference.baseten.co/v1/systemone,包含state、类型化questions和模型标识符decision-models/baseten-joey-2b-latest。 - 验证结构化响应。 拒绝格式错误或不可用结果,保留评估所需概率,把路由政策留在应用内。
- 开展影子评估。 启用自动行动前,先把建议与复核后的结果比较。
- 加入并衡量升级处理。 将不确定或后果重大的案例交给大模型或人工,再检查整条路径的结果。
模型卡说明的自托管配置需要 CUDA GPU 和锁定的服务环境。“2B”描述模型规模,不保证任意笔记本都有足够内存。部署选型还要计算运行时开销、图像处理、并发和上下文长度。
API 试点可以在投入基础设施前,先回答产品是否适配。自托管则是关于控制、利用率、运维工作和总成本的另一项决定。开放权重提供了选择,不会自动让选择具有经济性。
模型或提示改变时,回放集可以保护工作流程
首次试点奏效后,保留一套有版本的已复核请求,包括常规案例、代价高的错误,以及正确做法是求助的例子。使用获准保留的数据,把问题措辞、选项说明和预期结果一起保存。
调整提示、阈值或服务配置后,扩大流量前先回放这套集合。一个类别的进步可能隐藏另一类别的退步。例如,更果断的分流减少复核,却增加简短含糊消息的错误。总体平均值无法解释这种取舍。
记录每次评估实际使用的模型标识符和服务路径。如果部署跟随不断更新的 latest 标识符,就要明确如何察觉行为变化、重新验收。应用结构稳定,不等于决策永远一致。
也要演练服务失败。超时、模型不可用或响应无效时,应进入明确的恢复路径,而不是悄悄选一个默认团队。默认选择本身也是业务决定,可能不适合敏感请求。可靠的小模型系统对“没有可用答案”的处理,应与对高置信度答案一样认真。即使正常请求只花一美分的很小一部分,这种运营纪律也很重要。
小模型让决策边界的质量更清晰
我们的看法是:joey-1 最有价值的地方,是应用已经明确定义选项的任务。便宜、迅速的决策可以推动大量工作,但糟糕的分类只会让错误传播得更快。
真正值得问的是,系统在已知范围内能正确处理多少工作,又如何处理其余部分。当升级路径是产品的一部分,而不是价格之后的脚注,小模型才算找到了位置。
来源
- Baseten:一美分的决策,介绍 joey-1,2026 年 10 月 29 日。
- Baseten joey-1 模型库与 API 示例,2026 年 11 月 2 日查阅。
- Base Labs joey-1 模型卡,2026 年 11 月 2 日查阅。基准条目由发布方报告,Artificial Analysis 条目明确标为内部复现。
让审阅意见与原始资料保持联系
Telli.sh 是一个选择,可保存获准使用的原始资料与技术决策背后的笔记。创建笔记工作区。