Baseten joey-1 fragt, ob jede KI-Entscheidung ein großes Modell braucht
Ein 2B-Entscheidungsmodell, eine API für $0.01 pro Million Eingabetokens und ein praktischer Weg, Unsicheres an größere Modelle oder Menschen weiterzugeben.
„Welches Team soll dieses Ticket übernehmen?“ braucht selten fünf Absätze. Nötig sind eines von wenigen gültigen Zielen, genügend Sicherheit für verantwortliche Auswahl und eine Rückfrageoption, wenn die Anfrage nicht passt.
Baseten stellte joey-1 am 29. Oktober 2026 für solche Arbeit vor. Das Modell der Forschungsgruppe Base Labs bildet das kleine Ende einer Entscheidungsmodellfamilie neben elephant-1 und mammoth-1. Attraktiv ist der engere Ausgabevertrag: Entscheidungen und Wahrscheinlichkeiten statt einer von der App zu deutenden Erklärung. Basetens Ankündigung stellt den Start vor.
Die praktische Chance ist eine andere Arbeitsteilung. Ein kleines Modell übernimmt definierte Wiederholungsentscheidungen; mehr Aufwand gilt dem unsicheren Rest. Dieser Leitfaden erklärt Preisrechnung, drei beispielhafte Anwendungen und die Prüfungen für nützliches Routing.
 Basetens offizielles joey-1-Modellkartenbanner. Bild: Base Labs / Baseten, aus dem als MIT-lizenziert ausgewiesenen Modellrepository; mit Rändern skaliert. Bildquelle · Lizenz und Bildhinweise.
Ein Entscheidungsmodell beginnt bei den akzeptierten Auswahlmöglichkeiten
Ein allgemeines Sprachmodell kann eine Anfrage klassifizieren, indem es „Abrechnung“ schreibt, JSON zurückgibt oder erklärt, warum ein Kunde eine Erstattung verdient. Jede dieser Schnittstellen hat ihren Platz. Ein spezielles Entscheidungsmodell konzentriert sich darauf, zwischen vorgegebenen Antworten zu wählen und Wahrscheinlichkeiten in strukturierter Form zu melden.
Das verändert die Arbeit vor der Inferenz. Sie brauchen präzise Fragen und Optionen für sinnvolle Aktionen. „Was sollen wir tun?“ ist ein schwacher Vertrag. „Welche Stelle aus Abrechnung, Technik oder Betrug soll den Fall erhalten?“ ist enger, braucht aber weiterhin eine Regel für mehrere oder keine passenden Stellen.
Basetens am 2. November geprüfte joey-1-Modellseite dokumentiert Text und Bilder, Auswahlfragen, Ja/Nein-Entscheidungen und geordnete Bewertung über /v1/systemone. Das Ergebnis ist programmatisch nutzbar. Es ersetzt keinen eigenen Erklärungs- oder Antwortgenerator, wenn Nutzer diesen benötigen.
Stellen Sie sich das kleine Modell als Sortiertisch vor. Sein Wert entsteht dadurch, dass gewöhnliche Arbeit an den richtigen Ort gelangt und ungewöhnliche Fälle an jemanden mit mehr Befugnis oder Kontext gehen. Ein Tisch, der schwierige Fälle selbstsicher falsch zuordnet, schafft verborgene Folgearbeit, auch wenn jede Inferenz günstig ist.
Deshalb sollte die Anwendung Unsicherheit bewahren. Ein Routingsystem kann eine vorläufige Kategorie erfassen, eine klärende Frage stellen oder den Vorgang an einen Menschen übergeben. Es muss nicht jede Wahrscheinlichkeitsverteilung in eine sofortige Geschäftsaktion verwandeln.
Ein Cent kauft Eingabetokens, keine feste Entscheidungszahl
Der am 2. November 2026 geprüfte offizielle Preiseintrag nennt $0.01 pro 1 Million Eingabetokens, mit Cacheeingaben und Ausgabe zu $0.00. „Ein Penny“ bezieht sich auf diese Tokeneinheit. Lange Historie verursacht mehr Eingabeverarbeitung als eine kurze gezielte Anfrage.
Hier folgt Beispielarithmetik zum veröffentlichten Satz vor Steuern, anderen Diensten und Vertragsbedingungen. Sie setzt ungecachte Eingabe und stabilen Preis voraus und ist eine Planungshilfe, keine Rechnungsschätzung.
| Beispielarbeitslast | Eingabetokens insgesamt | Eingabekosten zu $0.01 pro Million |
|---|---|---|
| 100.000 Anfragen × 500 Tokens | 50 Millionen | $0.50 |
| 1 Million Anfragen × 500 Tokens | 500 Millionen | $5.00 |
| 10 Millionen Anfragen × 500 Tokens | 5 Milliarden | $50.00 |
| 1 Million Anfragen × 2.000 Tokens | 2 Milliarden | $20.00 |
Die Formel ist einfach: gesamte Eingabetokens geteilt durch 1 Million, multipliziert mit $0.01. Die betriebliche Rechnung ist umfassender. Beziehen Sie die Kosten aller Eskalationen, Datenvorbereitung, Wiederholungen, Überwachung und manuellen Korrekturen ein.
Zwei Routingkonfigurationen unterscheiden sich vielleicht um wenige Dollar Modellkosten. Eine schickt weniger zur Prüfung, leitet aber gelegentlich Dringendes in eine langsame Warteschlange. Die andere eskaliert mehr und vermeidet das. Die richtige Wahl hängt von Fehlerkosten und Prüferkapazität ab, nicht nur von der Tokenrechnung.
Dieses Argument wird stärker, je günstiger Inferenz wird. Macht die Modellnutzung nur einen kleinen Teil der Gesamtkosten des Ablaufs aus, kann eine geringe Verbesserung der Kalibrierung oder Kategoriengestaltung mehr zählen als eine weitere Senkung des Tokenpreises. Günstige Inferenz erweitert den Bereich wirtschaftlich möglicher Automatisierung; sie beseitigt nicht die Notwendigkeit, Ergebnisse zu bewerten.
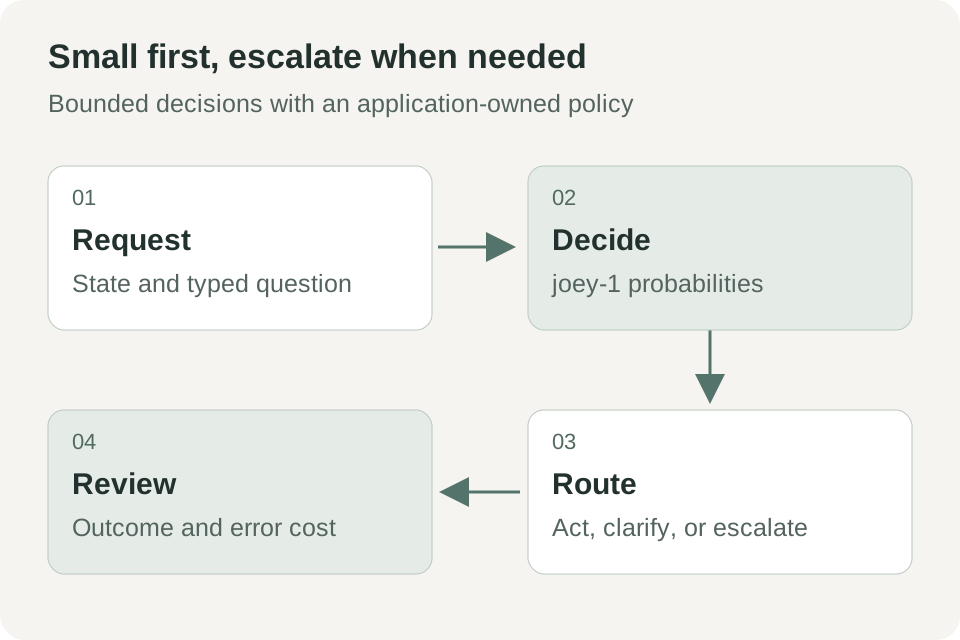 Eigene Routinggrafik, angeregt durch den Eskalationsansatz in Basetens Ankündigung vom 29. Oktober. Schwellenwerte gehören der einführenden Anwendung.
Ticketrouting ist ein guter Einstieg, wenn Labels Verantwortliche haben
In einem beispielhaften Supportablauf ordnet joey-1 eingehende Nachrichten der Abrechnung, dem technischen Support oder der Kontosicherheit zu. Eine separate Ja/Nein-Frage prüft, ob der Kunde eine Erstattung anfordert. Ein geordneter Bewertungswert zeigt, wie dringend der Fall Aufmerksamkeit benötigt.
Diese Fragen hängen zusammen, sollten aber nicht zu einer einzigen Kategorie zusammengezogen werden. Eine Abrechnungsanfrage kann zugleich dringend sein. Eine Anfrage zur Kontosicherheit kann eine Erstattungsforderung enthalten. Getrennte Entscheidungen erleichtern die Definition dessen, was jedes Team erhält und welche Kombinationen eine Sonderbehandlung erfordern.
Beginnen Sie damit, die Kategorien gemeinsam mit den für die Warteschlangen verantwortlichen Personen zu formulieren. Nehmen Sie Beispiele für Fälle auf, die früher zu Meinungsverschiedenheiten geführt haben. Entscheiden Sie, wie eine Nachricht behandelt werden soll, die einen durch einen Softwarefehler verursachten Zahlungsausfall erwähnt. Das Modell kann keine organisatorische Mehrdeutigkeit lösen, die die Organisation selbst undefiniert gelassen hat.
Vergleichen Sie bei der Einführung Empfehlungen mit bestehenden Entscheidungen, bevor Sie Arbeit automatisch weiterleiten. Prüfen Sie Meinungsverschiedenheiten nach Kategorien: mehrdeutige Richtlinie, fehlender Kontext, klarer Modellfehler oder falsche historische Kennzeichnung. Ein einziger zusammengefasster Genauigkeitsprozentsatz verbirgt diese unterschiedlichen Probleme.
Basetens Ankündigung vom 29. Oktober positioniert joey-1 als erste Stufe mit größeren Geschwistern für Unsicherheit. Sie nennt 20 Millisekunden P50-Ende-zu-Ende-Latenz bei durchschnittlich 2.000 Eingabetokens unter ihren Produktionsbedingungen. Das ist eine Herstellermessung bestimmter Dienstlast, keine Garantie für Ihre App oder Hardware. Quelle: Baseten.
Dokumentrouting sollte ein fehlendes Ziel erkennen
Eine zweite beispielhafte Anwendung ist der Dokumenteneingang. Eine Anwendung erhält eine Datei und muss entscheiden, ob diese in einen Rechnungsablauf, eine Ausgabenprüfung oder eine allgemeine Dokumentenwarteschlange gehört. Text- und optionale Bildeingaben können das Modell für gemischtes Dokumentenmaterial relevant machen, sofern die übermittelte Darstellung die für die Aufgabe nötigen Informationen enthält.
Definieren Sie die eigentliche Entscheidung eng. Zu prüfen, ob eine Seite wie eine Rechnung aussieht, ist etwas anderes, als Echtheit, rechtliche Vollständigkeit oder Zahlbarkeit dieser Rechnung zu bestätigen. Ein Klassifikator kann helfen, einen Ablauf auszuwählen, ohne die Erlaubnis zu erhalten, eine Zahlung freizugeben.
Wertvollste Testfälle liegen möglicherweise außerhalb der Taxonomie: ein Beleg am Vertrag, ein unlesbares Bild oder eine nicht unterstützte Sprache. Bei nur drei gültigen Zielen braucht die Anwendung einen weiteren Mechanismus für fehlende Belege und Unbekanntes. Ein ausdrücklicher Prüfpfad ist leichter zu betreiben als ein erzwungener Tipp.
Verfolgen Sie auch Veränderungen der Eingabepopulation. Ein Modell, das während der Bewertung überwiegend kurze Inlandsrechnungen sieht, kann später auf mehrseitige Kontoauszüge und gescannte Korrespondenz treffen. Wer nur die endgültig gewählte Kategorie überwacht, kann diese Verschiebung übersehen. Erfassen Sie Anfragelänge, Eingabetyp, Unsicherheit und Prüfergebnisse mit angemessenem Datenschutz.
Die am 2. November geprüfte Modellkarte beschreibt 2B Parameter, Nachtraining auf Qwen3.5-2B und eine MIT-Lizenz. Das stützt eine Bereitstellungsoption mit offenen Gewichten. Es belegt keine universelle Speicheranforderung, CPU-Leistung oder Wiederverwendungsrechte an jeder Ankündigungsillustration.
Bildprüfungen helfen bei beobachtbaren Bedingungen
Stellen Sie sich als drittes Szenario vor, eingereichte Produktfotos zu prüfen, bevor sie in eine manuelle Katalogprüfung gelangen. Nützliche Fragen könnten lauten, ob ein Etikett sichtbar ist, ob das Bild den angeforderten Gegenstand enthält oder ob das Foto zu stark verdeckt ist, um es zu beurteilen. Jede Frage sollte etwas benennen, das im bereitgestellten Bild beobachtet werden kann.
Ein unbrauchbarer Maßstab vermischt Beobachtung mit verborgenen Tatsachen. „Ist dies ein vertrauenswürdiger Verkäufer?“ lässt sich nicht allein anhand eines Produktfotos beantworten. „Ist der angeforderte Seriennummernbereich sichtbar?“ ist enger und gibt dem nächsten Ablauf einen konkreten Grund, ein weiteres Bild anzufordern.
Geordnete Bewertung kann nützlich sein, wenn Prüfer bereits einen gemeinsamen Maßstab haben, etwa unbrauchbar, prüfbedürftig und brauchbar. Formulieren Sie die Kriterien so, dass ein Prüfer sie konsistent anwenden kann. Sind zwei benachbarte Stufen selbst für Menschen nicht unterscheidbar, wird eine Wahrscheinlichkeitsverteilung die Taxonomie nicht reparieren.
Nutzen Sie das Modell zur Priorisierung der Prüfung, bevor Sie automatische Ablehnungen erlauben. Abgelehnte Einreichungen können Kunden direkt betreffen, und die Kosten einer falschen Ablehnung können die Automatisierungseinsparungen übersteigen. Eine Prüfphase liefert außerdem Beispiele zur Verfeinerung des Maßstabs und zur Kontrolle, ob sich die Leistung zwischen Eingabebedingungen unterscheidet.
Dies sind beispielhafte Entwürfe, keine berichteten joey-1-Einführungen. Ihr gemeinsames Merkmal ist eine begrenzte Frage mit einem anschließenden umkehrbaren Schritt. Das ist ein sinnvoller Ausgangspunkt, um das Verhalten des Modells auf Ihren Daten kennenzulernen.
Wahrscheinlichkeiten brauchen vor Aktionen eine Richtlinie
Ein Konfidenzwert ist keine Berechtigungsmarkierung. Entscheidet die Anwendung, oberhalb von 0,90 zu handeln, ist dieser Schwellenwert eine Entwurfsentscheidung, deren Folgen gemessen werden müssen. Auch ein hoher Wert kann falsch sein, besonders wenn die Anfrage von den Daten abweicht, anhand derer der Schwellenwert festgelegt wurde.
Verschiedene Fehler brauchen verschiedene Regeln. Eine gewöhnliche Frage falsch zuzuordnen ist lästig. Eine Kontoübernahmemeldung als Routine zu behandeln kann viel teurer sein. Derselbe Schwellenwert sollte nicht automatisch beide Aufgaben steuern.
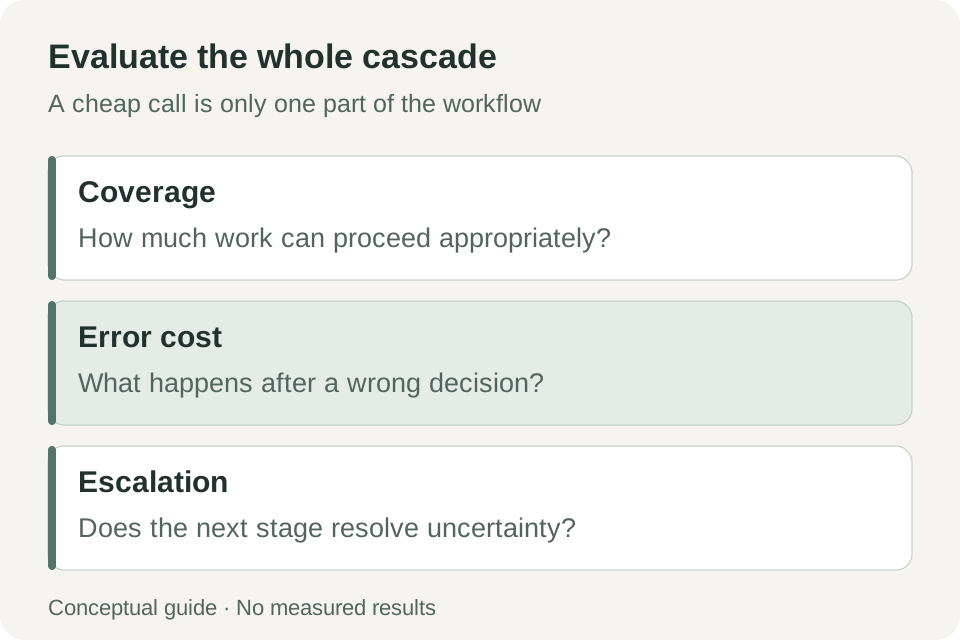 Eigener Bewertungsrahmen. Abdeckung, Kosten falscher Aktionen und Eskalationsqualität sind Anwendungsmaße; die Grafik zeigt keine gemessenen joey-1-Ergebnisse.
Bilden Sie eine zurückgehaltene Prüfmenge mit repräsentativen gewöhnlichen Fällen, schwierigen Fällen und Eingaben außerhalb des Aufgabenbereichs. Untersuchen Sie für jeden vorgeschlagenen Schwellenwert den automatisch bearbeiteten Anteil und die Fehler innerhalb dieses Anteils. Betrachten Sie dann, was mit dem Rest geschieht: Ein Modell, das Fehler durch Eskalation fast aller Fälle vermeidet, lässt den Ablauf möglicherweise unverändert.
Vergleichen Sie die gesamte Kaskade mit einem allein eingesetzten größeren Modell. Der Ansatz mit kleinem Modell zuerst ergänzt eine Routingstufe mit eigenen Fehlermöglichkeiten und eigener Latenz. Er gewinnt, wenn genügend Anfragen bereits in der ersten Stufe angemessen bearbeitet werden und der Eskalationsweg den schwierigen Rest verbessert.
Beginnen Sie gehostet oder planen Sie Selbsthosting ausdrücklich
Baseten bietet gehostete Model APIs, dedizierte Bereitstellung und Gewichtsdownloads. Kontext und Betrieb sind getrennt zu prüfen. Der Startbeitrag nennt 16k für Model APIs und 262k als dedizierte Option; die Modellkarte nennt 16.384 Tokens trainierte Sequenzlänge und lehnt längere Anfragen ab. Es gibt keinen undifferenziert übertragbaren Höchstwert. Startbeitrag, Modellkarte.
- Wählen Sie einen Entscheidungsvertrag. Benennen Sie gültige Optionen, Bedeutung und Verhalten bei ungenügenden Belegen.
- Wählen Sie den Bereitstellungsweg. Öffnen Sie gehostet den API-Eintrag und erstellen Sie Zugangsdaten im Anbieterkonto. Folgen Sie lokal den festgelegten Laufzeitanforderungen der Modellkarte.
- Senden Sie eine minimale Anfrage. Das offizielle Beispiel nutzt
https://inference.baseten.co/v1/systemonemitstate, typisiertenquestionsunddecision-models/baseten-joey-2b-latest. - Validieren Sie die strukturierte Antwort. Verwerfen Sie ungültige oder fehlende Ergebnisse, speichern Sie Prüfungswahrscheinlichkeiten und halten Sie Routingregeln in Ihrer Anwendung.
- Bewerten Sie im Schattenbetrieb. Vergleichen Sie Empfehlungen mit geprüften Ergebnissen vor automatischen Aktionen.
- Ergänzen und messen Sie Eskalation. Leiten Sie unsichere oder folgenreiche Fälle an größere Modelle oder Menschen und prüfen Sie den Gesamtpfad.
Die Modellkarte dokumentiert eine Konfiguration für Eigenbetrieb, die eine CUDA-GPU und eine festgelegte Ausführungsumgebung benötigt. „2B“ beschreibt die Modellgröße; es verspricht nicht, dass jeder Laptop genügend Speicher besitzt. Berücksichtigen Sie bei der Dimensionierung Laufzeitaufwand, Bildverarbeitung, Parallelität und Kontextlänge.
Ein API-Pilot kann Produkteignung vor Infrastrukturinvestitionen klären. Selbsthosting ist eine eigene Entscheidung über Kontrolle, Auslastung, Betriebsaufwand und Gesamtkosten. Offene Gewichte ermöglichen diese Wahl, machen sie aber nicht automatisch wirtschaftlich.
Ein Wiederholungsset schützt bei Modell- oder Promptänderungen
Bewahren Sie eine versionierte Sammlung geprüfter Anfragen auf, sobald der erste Pilotversuch funktioniert. Nehmen Sie gewöhnliche Fälle, kostspielige Fehler und Beispiele auf, bei denen die richtige Antwort darin besteht, um Hilfe zu bitten. Bewahren Sie Fragewortlaut und Optionsbeschreibungen neben dem erwarteten Ergebnis auf und verwenden Sie dafür Daten, die Sie aufbewahren dürfen.
Spielen Sie diese Sammlung bei Änderungen an Prompt, Schwellenwert oder Ausführungskonfiguration erneut ab, bevor Sie den Datenverkehr ausweiten. Ein Gewinn in einer Kategorie kann eine Regression in einer anderen verbergen. Entschiedeneres Routing kann beispielsweise das Prüfvolumen senken und zugleich Fehler bei kurzen, mehrdeutigen Nachrichten erhöhen. Der Gesamtdurchschnitt allein erklärt diese Abwägung nicht.
Erfassen Sie die tatsächliche Modellkennung und den bei jeder Bewertung verwendeten Bereitstellungsweg. Folgt eine Bereitstellung einer beweglichen latest-Kennung, legen Sie fest, wie Sie Verhaltensänderungen bemerken und die Abnahme erneut prüfen. Ein stabiles Anwendungsschema garantiert nicht auf Dauer identische Entscheidungen.
Erproben Sie auch Dienstausfälle. Eine Zeitüberschreitung, ein nicht verfügbares Modell oder eine ungültige Antwort sollte in einen definierten Wiederherstellungspfad führen, statt stillschweigend ein Standardteam zu wählen. Der Standard ist selbst eine Geschäftsentscheidung und kann für sensible Anfragen ungeeignet sein. Ein verlässliches System mit kleinem Modell behandelt nicht verfügbare Antworten ebenso bewusst wie selbstsichere. Diese betriebliche Sorgfalt zählt auch dann, wenn eine normale Anfrage nur einen Bruchteil eines Cents kostet.
Kleine Modelle machen die Qualität der Entscheidungsgrenze sichtbarer
Unsere Einschätzung: joey-1 ist besonders interessant bei bereits klar definierten Auswahlmöglichkeiten. Billige schnelle Entscheidungen bewegen viel Arbeit, aber schlechte Kategorien bewegen nur Fehler schneller.
Die wertvolle Frage lautet, wie viel Arbeit das System innerhalb eines bekannten Umfangs korrekt erledigen kann und wie gut es den Rest behandelt. Ein kleines Modell verdient seinen Platz, wenn der Eskalationsweg Teil des Produkts ist statt einer Fußnote nach dem Preis.
Quellen
- Baseten: Entscheidungen für einen Penny, Einführung von joey-1, 29. Oktober 2026.
- Baseten-joey-1-Modellbibliothek und API-Beispiel, geprüft am 2. November 2026.
- Base-Labs-joey-1-Modellkarte, geprüft am 2. November 2026. Benchmarks stammen vom Herausgeber; der Artificial-Analysis-Eintrag ist als interne Replik ausgewiesen.
Verbinden Sie Ihre Prüfung mit ihrer Quelle
Telli.sh ist eine Möglichkeit, autorisiertes Quellenmaterial und die Notizen hinter einer technischen Entscheidung aufzubewahren. Notizbereich anlegen.