下一台 AI 服务器能装进现有的风冷机柜吗?
Axelera 的 Titania 瞄准风冷 4U 服务器上的大模型推理。厂商公布的模拟性能引出了电力、内存和部署成本这三个问题。
下一台 AI 服务器在回答第一个问题之前,可能需要增设供电回路、调整冷却设施,还要迁移软件。对计划在自有设施内运行推理的团队来说,这些条件的重要性不亚于加速器的价格。芯片再快,也要有维持整套系统运行的条件,才能成为可用算力。
2026 年 11 月 12 日,荷兰加速器公司 Axelera AI 公布了第三代 AI 加速技术 Titania 的架构。拟议的 AX8 参考服务器是一台风冷 4U 设备,配置八个加速器封装和 1 TB 加速器内存。Axelera 给出的典型整机功耗为 5–6 kW,目标是在现有数据中心的供电和冷却条件下运行。这些数字是未来平台的设计指标。目前尚无可购服务器的实测结果。Axelera 11 月 12 日的公告
这套设计能否让现有设施切实承担大模型推理?回答这个问题,要看内存容量、每位用户得到的响应、安装工作和长期维护的软件。Titania 的产品页还列出了性能比较的条件,为讨论这些问题提供了一个具体案例。
Titania 将 Axelera 从边缘侧带向更大规模的推理系统
Axelera 已经推出面向边缘和企业应用的 Metis 与 Europa 加速器。Titania 延续这条产品路线,瞄准更大规模的推理部署,每个系统级封装(SiP)内集成两个小芯片。它采用该公司的数字存内计算架构、可编程 RISC-V 计算单元和 LPDDR6 内存。公告列出了 PCIe 卡和 OAM 加速器模块,计划通过整机合作伙伴提供风冷和液冷配置。
对采购方而言,加速器封装与整台服务器是两个层面的决策。PCIe 形态无法保证现有机箱有足够的插槽、供电、气流和软件支持。即便有风冷参考设计,也要逐一确认机房条件。应当比较的是供应商确实能交付并提供服务的整机配置。
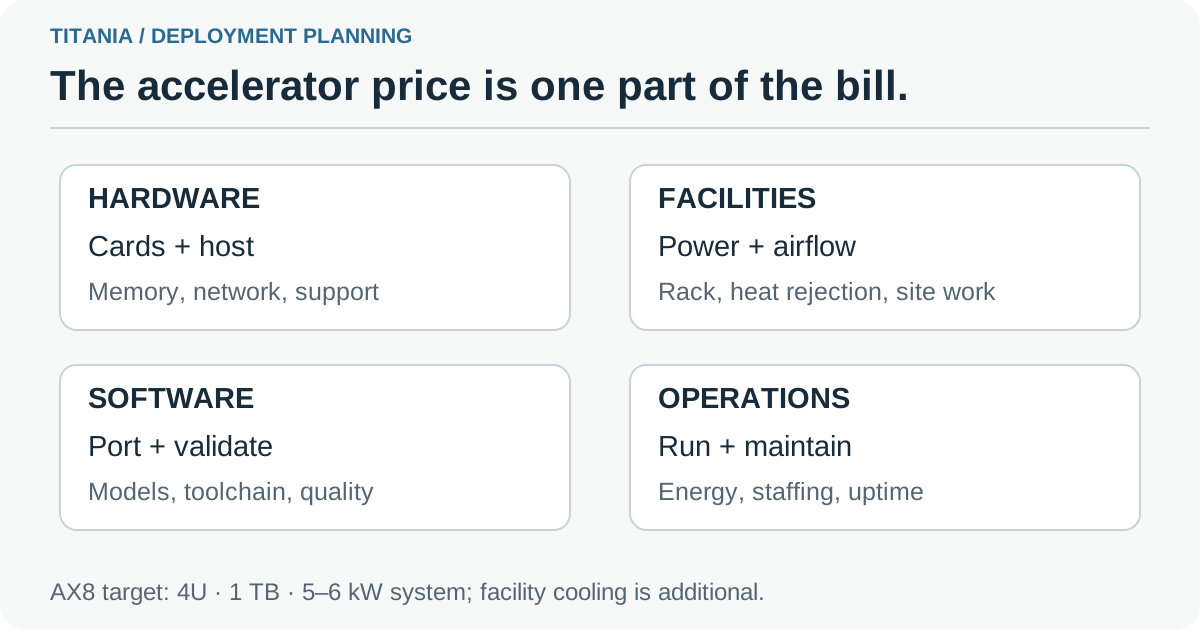
自制说明图。部署预算还包括让服务器成为可持续维护的推理服务所需的基础设施和软件。AX8 的尺寸和功耗数据出自Axelera 11 月 12 日的公告。
Axelera 的产品资料提供了一幅厂商绘制的 Titania 小芯片架构图,呈现其规划中的结构和内存层级。该页面也列出了理解性能图表所需的配置说明。
1 TB 首先回答的是容量问题,速度还要另测
Axelera 表示,每个 Titania 封装配有 128 GB LPDDR6。八封装的 AX8 参考设计因此达到标称的 1 TB 加速器内存,并给出合计 19.6 TB/s 的内存带宽与 20 PFLOPS 的 FP8 算力。厂商还列出了 FP4、MXFP4、FP8、MXFP8 和 BF16 支持。解读这些数字时,要一并考虑精度和模型在不同封装之间的分布方式。公布的架构与参考服务器规格
对大型混合专家模型而言,参数总量决定要存多少权重数据,而单个 token 可能只激活部分模型。即使计算量还可以应付,内存容量依然可能成为瓶颈。Axelera 据此强调大容量 LPDDR6 和数据搬运效率。与围绕 HBM 设计的加速器相比,它对内存、计算和封装的取舍不同。
公告称,一台 AX8 的设计目标是容纳采用 FP4 的 1.6 万亿参数模型,并给键值缓存留出空间。这是厂商在特定精度下提出的容量主张。使用方仍要核实自己的模型表示方式、上下文长度和并发请求数能否放进受支持的配置。会话越多、越长,服务在权重之外需要的工作内存也越多。
让模型常驻内存可以消除一道障碍,但用户实际感受到的是等待时间和答案质量。即使能装得下,模型也可能需要调优才能达到应用的响应目标。反过来,如果小模型已经可以准确完成任务,额外容量就未必有必要。先根据业务确定模型和可接受的精度,再评估可提供服务的硬件。
交互速度和总吞吐量考验不同的设计
设想员工会在开会时使用一个内部文档助手。及时给出答案,让讨论继续,与夜间批量完成数百条问答,价值各不相同。对会议助手而言,除了总 token 处理量,还要看第一段有用文本要等多久,以及之后生成得多快。这是说明用途的示例,未做 Titania 实机试验。
另一个团队也许要处理积压文档,并没有人守着等待单次响应。如果批处理可提高每小时完成量,就可以接受每项任务多等一会儿。大规模共享服务还可能在不同时段需要两种模式。因此,固定单用户速度的比较,与追求总吞吐量最大的比较,可能给出不同排名。
Axelera 将 Titania 定位在高响应性的推理上,同时在产品页承认,机柜级 GPU 在极大批量下可能领先。其图表覆盖不同模型和机柜配置。采购时真正要问的是,哪套配置能够在预计的并发与成本下,满足服务的延迟要求。Titania 的性能比较条件
| 工作负载问题 | 应索取的证据 | 单一峰值还回答不了什么 |
|---|---|---|
| 员工能否在会议中即时使用文档助手? | 在目标并发量下的首次响应时间和生成速度 | 繁忙时的排队和尾延迟 |
| 批处理服务能否在夜间清完积压? | 使用代表性文档时每小时完成的任务数 | 输入长度与批次设计对完成时间的影响 |
| 一台服务器能否同时处理视频和语言任务? | 同时运行解码、推理与应用逻辑时的端到端结果 | 主机负载、任务争用、处理丢失或延迟 |
看性能倍数之前,先核对模拟条件
Titania 产品页明确说明,其性能数字是在 Axelera 的生产用编译器中运行内部模拟得出的。一项服务器比较采用 2026 年 8 月模拟的八卡 Titania 系统,对照 InferenceX 在 2026 年 9 月发布的竞品数据。列出的条件包括 FP4、8,000 token 输入和 1,000 token 输出。其他图表还采用了 10 月份的机柜级模拟,各有不同的系统配置。
这些条件说明了图表针对的比较问题,也限定了采购方可以得到的结论。引入编译器的模拟具有工程参考价值。正式版 Titania 硬件上的独立实测还需另外取得。Metis 和 Europa 的既有部署可以帮助理解 Axelera 的技术,但无法把 Titania 的预测值变成出货系统的实测数据。
公告所称的每瓦吞吐量最高提升至七倍、总体拥有成本最高有二十倍优势,都来自厂商的比较框架。它们不能当作单一站点的报价或账单预测。产品页说,功耗比较采用 TDP 对 TDP,成本采用 Axelera 的总体拥有成本模型。TDP 是设计功率指标,服务上线后实际消耗多少电力,取决于整套系统和工作负载。
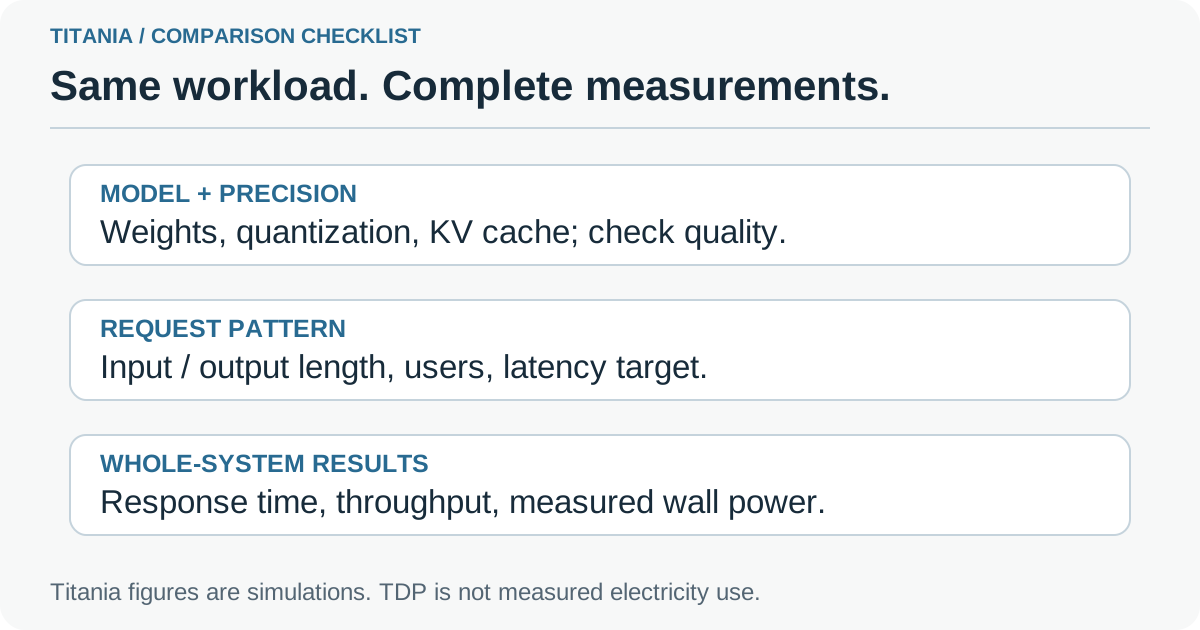
自制说明图。解读性能比较时,应把模型、精度、请求长度和并发量放在一起看。条件来源为Axelera 的 Titania 产品页。
把倍数填入采购表之前,先问清具体配置。同时保留模型版本、精度、质量检验结果和请求分布。再确认功耗测量范围是加速器、整机还是设施。否则,更窄的测量边界可能让结果看起来更好。
风冷同样需要核算电力和排热能力
“风冷”说明服务器如何把热量传给周围空气。这些热量仍需由合适的设施冷却系统排出机房。Axelera 拟定的 AX8 典型功耗为 5–6 kW,对单台 4U 设备来说是可观的负载。设施团队需要掌握报价对应的配置、安装要求和预期负载,才能判断现有机柜能否接纳。
简单算一笔账,就能看出规模。假设机器全天 24 小时持续平均消耗 5–6 kW,服务器自身一天就会用电 120–144 kWh。这是基于持续平均功率的算术推演,Titania 的实测数据尚未给出。真实工作负载与空闲行为都可能改变结果,而冷却、供电转换损耗及其他设施还有各自的用电量。
Axelera 的吸引力在于,有机会继续使用现有数据中心,而不必围绕高密度液冷机柜重建设施。能节省多少,取决于场地可承受什么。有备用电力和排热能力的场地,与配电回路和机房冷却接近上限的场地,面临的是两种改造项目。即使采用 4U 机箱或 PCIe 卡,安装也要比给台式电脑升级复杂得多。
软件能否延续,与硬件容量同样重要
Axelera 表示,Voyager SDK 和 AxeleraScript 基础覆盖 Metis、Europa 和 Titania。公告提到计划支持张量并行、专家并行、流水线并行、推测解码以及 KV 缓存卸载或解耦,并把 Titania PCIe 卡作为采用 Europa 的 Axelera Server 250p 的未来升级方案。已在评估该公司软件生态的团队尤其需要留意这些计划。
已有 Europa 的用户会先问,支持的算子、模型转换、集成代码、监控和部署打包能延用多少。对来自其他平台的团队而言,迁移到 Voyager 本身就是一项工程。统一的 SDK 可以减少同一厂商内的重复工作,但应用仍需在每个目标配置上验证。用真实模型及其配套流程检验可移植性。
以给录像中的事件生成说明的视频服务为例。Titania 公布的片上 H.265 和 AV1 的 8K 解码及 4K 编码,可能改变加速器与主机的分工。实际试验应涵盖受支持的编解码设置、帧预处理、语言模型、存储和应用响应。单独加快语言模型,还不能说明整个服务有能力处理要求的视频负载。
对于私有文档助手,还要考虑检索与访问控制。将推理移到本地只改变模型的运行地点。文档授权、日志、备份、服务凭据仍需专门设计。硬件报价应和软件运维计划一起评估,明确由谁更新运行时、验证模型变更,以及在故障后恢复服务。
一次有价值的评估,从六个决定开始
Titania 的现状更适合分阶段评估。先明确应用和今天可用的基准,等受支持的系统陆续可用,再索取证据。如果记录了配置和限制,厂商演示可以帮助决定下一步。最终仍应在预定部署地点完成验收测试。
- 确定任务与服务目标。 选出有代表性的文档、智能体或视频请求。在选参数最大的模型之前,先定义可以接受的回答质量、响应时间和繁忙时段的并发量。
- 记录当前基准。 用现有系统或托管服务确定工作量、延迟和运营成本。保留模型和请求版本,以便日后作有效比较。
- 索取受支持的配置。 核实计划支持的模型、内存布局、主机规格、软件版本和整机合作伙伴的责任范围。区分已公布的功能与已经在该配置中演示的功能。
- 请设施团队检查现场。 向负责团队提供供应商的供电、气流和安装要求。让他们在评估中考虑邻近设备与可用的冷却容量。
- 硬件可用后,测试完整服务。 覆盖请求到达规律、检索、编解码和监控。在同一时间区间测量整机功耗、已完成的工作及响应时间统计。
- 核算长期运营投入。 纳入集成时间、技术支持、维护与可执行的备用方案。按照实际预期负载比较拥有成本,记得计入清闲时段。
这些步骤也让继续使用现有设备成为有据可依的决定。若较小的模型无需多少运维投入就已达标,避免不必要的迁移可以节省预算和人力。如果制约因素是内存容量或安装工作,Titania 的拟议设计就为下一次与供应商的讨论提供了具体起点。
生产时间也是硬件规格的一部分
Axelera 11 月的公告把生产目标定在 2027 年第三季度,并提到延续至 2028 年初的客户部署承诺。产品页将生产窗口写为更宽泛的 2027 年下半年,并列出 2028 年的升级路径。这些说法描述的是路线图。开始生产、交付有技术支持的服务器,以及在某个国家完成安装,是三个不同的节点。
以 2026 年 11 月为规划起点,地区报价、到货日期和服务范围仍需整机合作伙伴确认。承诺购买未来硬件与已经部署运行的系统,证据价值不同。若组织眼下就需要推理能力,仍需采用目前可用的方案和能持续维护的运营计划。可以把 Titania 纳入未来的评估范围,不必让它成为近期上线的前置条件。
最有价值的结果,是让团队在自己的场地内装得下、养得起,也维护得了的推理能力。Titania 把内存、交互响应和现有基础设施放在一起,提出了这样的选择。下一步是把设计目标与模拟结果转化为有技术支持的系统,并在客户实际需要处理的工作上取得实测数据。
来源
- Axelera AI:Titania 架构公告,2026 年 11 月 12 日
- Axelera AI:Titania 产品规格、路线图和模拟条件,2026 年 11 月 18 日查阅。
- DARE 项目:合作伙伴 Axelera 公布 Titania,2026 年 11 月 12 日
把工作负载定义、给供应商的问题和日后的测试结果记在一起,下次就能用同一套假设开展比较。用 Telli.sh 创建第一条笔记。