Seu próximo servidor de IA caberia no rack refrigerado a ar que você já tem?
O Titania, da Axelera, mira a inferência de grandes modelos em um servidor 4U refrigerado a ar. As simulações levantam questões sobre energia, memória e custo de implantação.
Antes de responder à primeira pergunta, o próximo servidor de IA pode precisar de um circuito elétrico novo, outra configuração de refrigeração e uma migração de software. Para equipes que querem rodar inferência nas próprias instalações, esses requisitos podem pesar tanto quanto o preço do acelerador. Um chip mais rápido só vira capacidade útil se o restante do sistema consegue mantê-lo funcionando.
Em 12 de novembro de 2026, a empresa neerlandesa Axelera AI apresentou a arquitetura Titania, sua terceira geração de tecnologia de aceleração de IA. O servidor de referência AX8 proposto reúne oito encapsulamentos de aceleradores e 1 TB de memória de acelerador em um sistema 4U refrigerado a ar. A Axelera indica potência típica de 5–6 kW e tem como alvo as condições existentes de alimentação e refrigeração em data centers. Esses números descrevem o projeto de uma plataforma futura. Ainda faltam medições de um servidor disponível para compra. Anúncio da Axelera de 12 de novembro
Esse projeto poderia viabilizar a inferência de modelos grandes nas instalações que as empresas já têm? Para responder, é preciso olhar para capacidade de memória, tempo de resposta por pessoa, instalação e software a ser mantido. O Titania permite examinar o caso em detalhe porque sua página de produto também expõe as condições das comparações de desempenho.
Titania leva a Axelera da borda a sistemas de inferência maiores
A Axelera já fabrica os aceleradores Metis e Europa para aplicações de borda e corporativas. O Titania amplia essa linha para implantações maiores de inferência, unindo dois chiplets em cada sistema em encapsulamento, ou SiP. O projeto usa a arquitetura de computação digital em memória da empresa, unidades de processamento RISC-V programáveis e memória LPDDR6. O anúncio apresenta placas PCIe e módulos aceleradores OAM, com versões refrigeradas a ar e a líquido previstas por meio de integradores parceiros.
Para quem compra, escolher o encapsulamento do acelerador e escolher o servidor completo são decisões distintas. Uma placa PCIe ainda exige conferir se o chassi oferece slots, alimentação, fluxo de ar e suporte de software. Um projeto de referência refrigerado a ar também não atesta que toda sala com um rack esteja pronta para recebê-lo. Compare configurações compatíveis que cada fornecedor consiga entregar e manter.
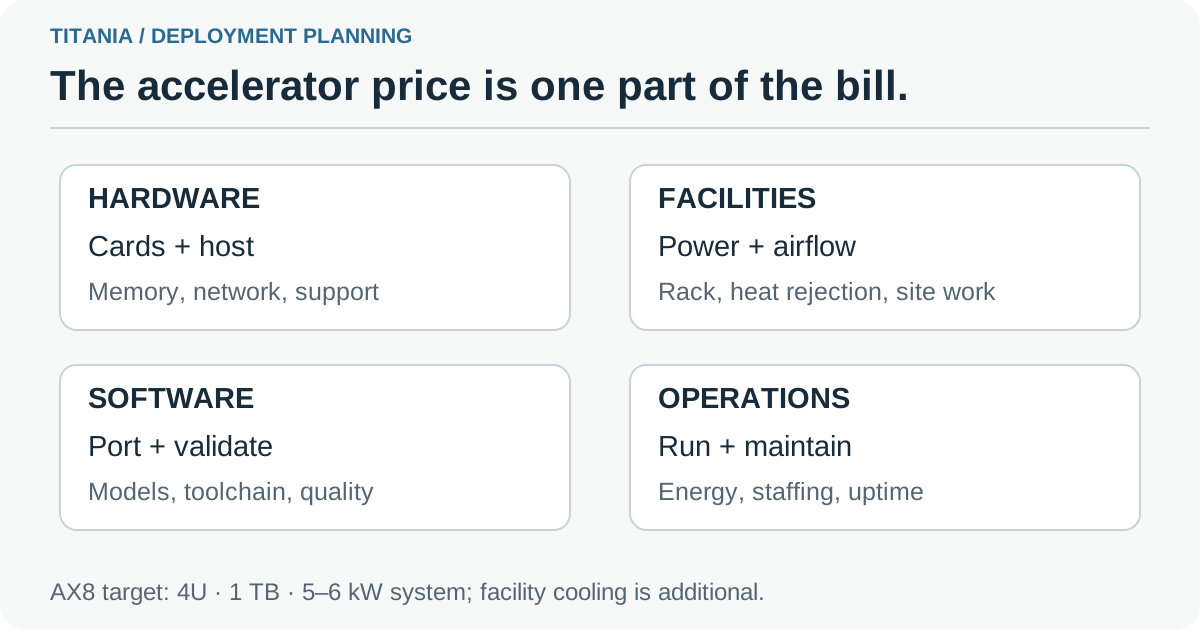
Gráfico explicativo original. O orçamento inclui a infraestrutura e o software necessários para que um servidor se torne um serviço de inferência com manutenção. As dimensões e a potência do AX8 vêm do anúncio da Axelera de 12 de novembro.
O material de produto traz uma ilustração da fabricante sobre a arquitetura de chiplets do Titania. Ela mostra o projeto previsto e sua hierarquia de memória. A página também fornece as configurações necessárias para entender os gráficos de desempenho.
Um terabyte responde primeiro à pergunta sobre capacidade
A Axelera especifica 128 GB de LPDDR6 por encapsulamento Titania. O AX8 de oito encapsulamentos chega ao 1 TB de memória de acelerador anunciado. A empresa aponta largura de banda de memória agregada de 19,6 TB/s e capacidade de cálculo de 20 PFLOPS em FP8. Também anuncia suporte a FP4, MXFP4, FP8, MXFP8 e BF16. Para interpretar esses números, é preciso considerar a precisão e a distribuição do modelo entre os encapsulamentos. Arquitetura e especificações anunciadas para o servidor de referência
Em um grande modelo de mistura de especialistas, o número total de parâmetros determina o volume de pesos que precisam ser armazenados, mesmo quando um token ativa apenas parte do modelo. A memória pode continuar sendo um limite com uma carga de cálculo que parece administrável. A Axelera usa essa observação para justificar LPDDR6 de alta capacidade e movimentação eficiente de dados. A combinação de memória, computação e encapsulamento difere do projeto de um acelerador centrado em HBM.
O anúncio afirma que o AX8 foi projetado para abrigar um modelo de 1,6 trilhão de parâmetros em FP4 e deixar espaço para o cache de chaves e valores. É uma alegação do fornecedor sobre capacidade em uma precisão específica. Cada aplicação precisa verificar se a representação exata do modelo, os comprimentos de contexto e as solicitações simultâneas cabem na configuração suportada. Quanto mais numerosas ou longas as conversas, mais a memória de trabalho necessária cresce além dos pesos armazenados.
Manter o modelo residente em memória resolve um obstáculo. O usuário acaba sentindo o tempo de espera e a qualidade das respostas. Mesmo um modelo que cabe pode exigir ajustes para cumprir a meta de latência. Se um modelo menor já acerta o suficiente, talvez a capacidade adicional seja dispensável. Defina o modelo e a precisão que a tarefa admite antes de avaliar o hardware.
Velocidade interativa e volume total favorecem projetos diferentes
Imagine um assistente interno de documentos usado em reuniões. Uma resposta que chega a tempo de dar continuidade à conversa tem valor diferente de centenas de respostas concluídas à noite. Para esse assistente, o tempo até o primeiro texto útil e a velocidade da geração seguinte importam tanto quanto o total de tokens atendidos. Trata-se de uma carga de exemplo, sem teste com Titania.
Outra equipe pode processar documentos acumulados sem que ninguém espere cada resposta. Mais demora é tolerável se agrupar solicitações aumenta o trabalho concluído por hora. Serviços compartilhados de grande porte podem precisar dos dois comportamentos em horários diferentes. Uma comparação com velocidade fixa por usuário pode, portanto, mudar a classificação em relação a uma que maximiza o volume total.
A Axelera posiciona o Titania para inferência responsiva e reconhece na página de produto que GPUs em escala de rack podem levar vantagem em lotes muito grandes. Os gráficos incluem diferentes modelos e configurações de rack. Na hora da compra, interessa saber qual configuração cumpre a meta de latência com a concorrência e o custo previstos. Condições de desempenho do Titania
| Pergunta sobre a carga de trabalho | Evidência a solicitar | O que um pico isolado deixa em aberto |
|---|---|---|
| Pessoas conseguem usar o assistente de documentos em tempo real? | Tempo até a primeira resposta e velocidade de geração na concorrência prevista | Filas e respostas mais lentas nos períodos de pico |
| Um serviço em lotes consegue eliminar o volume acumulado durante a noite? | Tarefas concluídas por hora com documentos representativos | Impacto do tamanho da entrada e dos lotes no prazo de conclusão |
| Um servidor consegue combinar vídeo e linguagem? | Resultados de ponta a ponta com decodificação, inferência e lógica do aplicativo | Carga do host, competição por recursos e trabalho perdido ou atrasado |
Antes de olhar as razões de desempenho, leia as condições das simulações
A página do Titania identifica seus números de desempenho como simulações internas feitas com o compilador de produção da Axelera. Uma comparação de servidores contrapõe um sistema de oito placas Titania, simulado em agosto de 2026, a dados de concorrentes do InferenceX datados de setembro de 2026. As condições declaradas incluem FP4, 8.000 tokens de entrada e 1.000 de saída. Outros gráficos usam simulações em escala de rack de outubro, com suas próprias configurações.
Essas condições explicam a comparação dos gráficos e limitam o que se pode concluir. Uma simulação que incorpora um compilador é um dado de engenharia. Uma avaliação independente no equipamento Titania de série ainda é uma etapa distinta. Implantações de Metis ou Europa ajudam a entender a tecnologia da Axelera, mas não transformam as projeções de Titania em medições de sistemas entregues.
As vantagens anunciadas, de até sete vezes na taxa de processamento por watt e de até vinte vezes na comparação de custo total de propriedade, pertencem ao modelo de comparação da fabricante. Os números não fornecem uma cotação nem preveem a conta de um local em particular. A página de produto explica que compara TDP com TDP e calcula os custos com o modelo de TCO da Axelera. TDP é um valor de projeto. O gasto de energia de um serviço em operação depende do sistema completo e de sua carga.
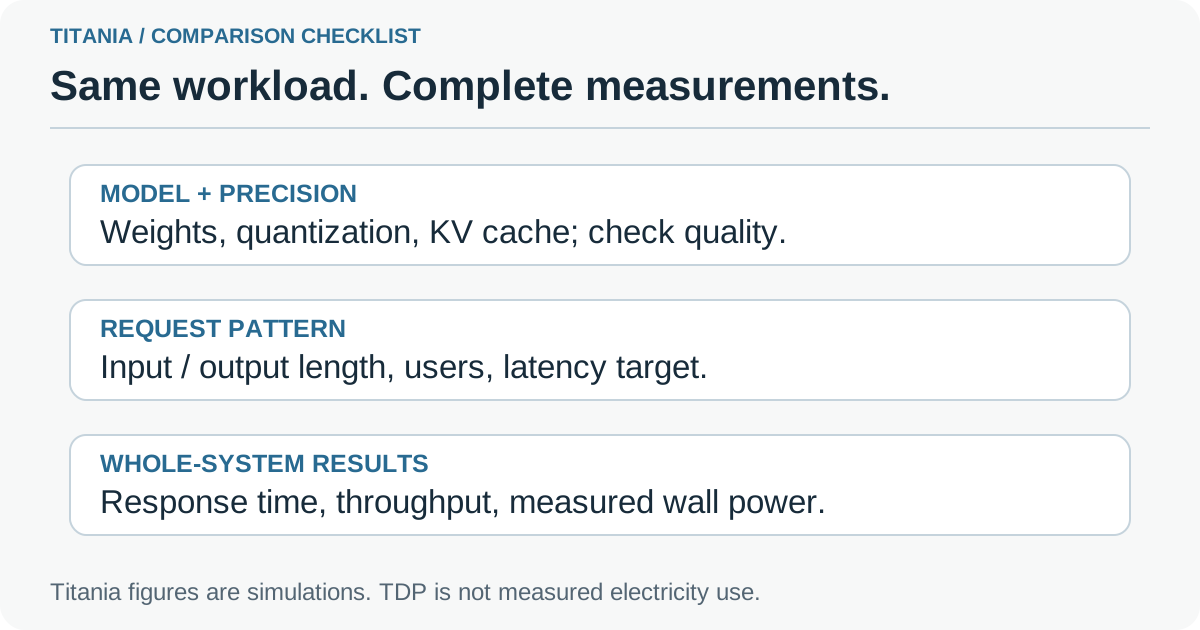
Gráfico explicativo original. Leia em conjunto o modelo, a precisão, o comprimento das solicitações e a concorrência antes de interpretar o desempenho. As condições vêm da página de produto Titania da Axelera.
Antes de usar um multiplicador em uma planilha de compras, peça a configuração que o produziu. Registre a versão do modelo, a precisão, a avaliação de qualidade e a distribuição das solicitações. Confirme também o que foi medido: acelerador, servidor completo ou instalação. Um perímetro menor de medição pode favorecer o resultado sem que o serviço seja melhor.
Refrigeração a ar também precisa de capacidade elétrica e térmica
A expressão “refrigerado a ar” descreve como o servidor transfere calor para o ambiente. Um sistema de refrigeração apropriado ainda precisa retirar esse calor da sala. Os 5–6 kW típicos projetados para o AX8 representam uma carga importante para uma única máquina 4U. A equipe de infraestrutura precisa conhecer a configuração cotada, os requisitos de instalação e a carga esperada antes de decidir se o rack pode recebê-la.
Uma conta simples dá noção de escala. Uma máquina operando a uma média contínua de 5–6 kW por 24 horas consumiria 120–144 kWh no dia só no servidor. O cálculo supõe potência média constante. O consumo real depende da carga e do comportamento em repouso. Refrigeração, perdas de conversão elétrica e outros equipamentos da instalação adicionam seus próprios gastos.
A proposta da Axelera abre a possibilidade de aproveitar um data center existente sem reconstruí-lo para um rack denso refrigerado a líquido. A economia depende do que o local já suporta. Um local com reservas elétrica e térmica enfrenta um projeto diferente de outro cujos circuitos e refrigeração estão perto do limite. Um chassi 4U ou uma placa PCIe ainda exige mais trabalho que uma atualização em um PC de mesa.
A continuidade do software pode valer tanto quanto a capacidade do hardware
A Axelera diz que o SDK Voyager e a base AxeleraScript abrangem Metis, Europa e Titania. O anúncio prevê paralelismo de tensores, especialistas e estágios, decodificação especulativa e descarregamento ou desagregação do cache KV. A placa Titania PCIe também é apresentada como futura opção de substituição para o Axelera Server 250p baseado em Europa. Esses planos interessam a equipes que já avaliam o software da empresa.
Para quem usa Europa, a questão imediata é quanto pode ser reaproveitado: operações suportadas, conversão de modelos, código de integração, monitoramento e pacotes de implantação. Para quem vem de outro ambiente, mudar para Voyager já é trabalho de engenharia. Um SDK compartilhado pode reduzir o esforço entre produtos do mesmo fornecedor. Ainda é preciso validar o aplicativo em cada destino. Teste a portabilidade com o modelo e seu fluxo real de processamento.
Pense em um serviço de vídeo que gera descrições de eventos gravados. A decodificação 8K e a codificação 4K no chip anunciadas para H.265 e AV1 poderiam alterar a divisão de trabalho entre acelerador e host. Um ensaio precisa incluir as configurações de codec admitidas, a preparação dos quadros, o modelo de linguagem, o armazenamento e a resposta do aplicativo. Acelerar o modelo, por si só, não comprova que o serviço completo suporta a carga de vídeo.
No caso de um assistente privado de documentos, o trabalho inclui busca e controle de acesso. Executar inferência nas próprias instalações muda onde o modelo roda. Autorização de documentos, logs, cópias de segurança e credenciais do serviço ainda exigem planejamento. Some à cotação do hardware um plano que atribua as atualizações do ambiente, os testes de mudanças de modelo e a recuperação do serviço após falhas.
Uma avaliação útil começa com seis decisões
O estágio atual do Titania recomenda avaliar em fases. Comece pelo aplicativo e pela referência disponível hoje. Peça evidências à medida que apareçam sistemas com suporte. Uma apresentação do fornecedor orienta o passo seguinte se suas configurações e seus limites forem documentados. O teste final de aceitação no local de implantação continua sendo necessário.
- Defina o trabalho e a meta do serviço. Escolha solicitações representativas de documentos, agentes ou vídeo. Estabeleça a qualidade, a latência e a concorrência aceitáveis nos horários de pico antes de optar pelo maior modelo.
- Registre a referência de hoje. Use o sistema existente ou o serviço hospedado para medir o volume, a latência e o custo operacional. Preserve versões de modelos e solicitações para assegurar comparações válidas depois.
- Peça a configuração suportada. Obtenha a lista de modelos previstos, a disposição da memória, as especificações do host, versões de software e responsabilidades do integrador. Distinga as funções anunciadas daquelas demonstradas nessa configuração.
- Solicite a avaliação da instalação. Entregue ao pessoal responsável os requisitos do fornecedor sobre eletricidade, circulação de ar e montagem. Inclua na análise os equipamentos vizinhos e a capacidade disponível de refrigeração.
- Teste o serviço completo quando houver hardware. Inclua padrões de chegada das solicitações, busca, codecs e monitoramento. No mesmo intervalo, meça a potência do servidor completo, o trabalho concluído e os tempos de resposta.
- Calcule o compromisso operacional. Inclua o tempo de integração, suporte, manutenção e uma alternativa viável. Compare custos de propriedade com a carga prevista, inclusive nos períodos de baixa demanda.
Esses passos também embasam a decisão de ficar com o equipamento que já funciona. Se um modelo menor cumpre a meta com pouco esforço, evitar a migração economiza dinheiro e tempo. Se o limite está na memória ou na instalação, o projeto de Titania dá foco à próxima conversa com o fornecedor.
O prazo de produção faz parte da especificação
O anúncio de novembro da Axelera aponta para produção no terceiro trimestre de 2027 e menciona compromissos de implantação com clientes até o começo de 2028. A página de produto indica o segundo semestre de 2027, um período mais amplo, e mostra um caminho de atualização para 2028. São previsões. O início da fabricação, a entrega de um servidor com suporte e a instalação em um país específico são marcos diferentes.
Para planejar em novembro de 2026, confirme com um integrador o preço regional, as datas de entrega e a cobertura do suporte. Comprometer-se a comprar hardware futuro tem valor diferente de uma instalação em pleno funcionamento. Quem precisa de inferência agora ainda requer uma solução disponível e um plano operacional com suporte. Pode colocar Titania na avaliação futura sem fazer dele uma dependência de um lançamento próximo.
O resultado de maior valor seria uma capacidade de inferência que a equipe pudesse instalar, manter e pagar em sua própria estrutura. O Titania conecta essa possibilidade à memória, ao desempenho interativo e à infraestrutura existente. O próximo teste é transformar as escolhas de projeto e as simulações em sistemas com suporte e medir seu desempenho no trabalho que os clientes de fato precisam fazer.
Fontes
- Axelera AI, anúncio da arquitetura Titania, 12 de novembro de 2026
- Axelera AI, especificações do Titania, cronograma e condições de simulação, consultado em 18 de novembro de 2026.
- Projeto DARE, a parceira Axelera apresenta Titania, 12 de novembro de 2026
Reúna a definição da carga, as perguntas para o fornecedor e os resultados de testes para partir das mesmas premissas na próxima comparação. Crie sua primeira nota com o Telli.sh.