Passt der nächste KI-Server in das vorhandene luftgekühlte Rack?
Axeleras Titania zielt auf die Inferenz großer Modelle in einem luftgekühlten 4U-Server. Die simulierte Leistung wirft Fragen zu Strom, Speicher und Bereitstellungskosten auf.
Der nächste KI-Server könnte einen neuen Stromkreis, eine andere Kühlung und eine Softwaremigration benötigen, bevor er die erste Frage beantwortet. Für ein Team, das Inferenz im eigenen Gebäude betreiben will, sind diese Anforderungen womöglich so wichtig wie der Preis des Beschleunigers. Aus einem schnelleren Chip wird erst nutzbare Kapazität, wenn das umgebende System ihn dauerhaft betreiben kann.
Am 12. November 2026 stellte der niederländische Beschleunigerhersteller Axelera AI die Architektur seiner dritten Generation von KI-Beschleunigern vor. Der geplante AX8-Referenzserver für Titania vereint acht Beschleuniger-Packages und 1 TB Beschleunigerspeicher in einem luftgekühlten 4U-System. Axelera nennt eine typische Systemleistung von 5–6 kW und hat die Stromversorgung und Kühlung vorhandener Rechenzentren im Blick. Die Werte sind angekündigte Auslegungsdaten einer zukünftigen Plattform. Messwerte für einen heute käuflichen Server liegen damit noch nicht vor. Axeleras Ankündigung vom 12. November
Könnte dieser Entwurf die Inferenz großer Modelle in bestehenden Anlagen praktikabel machen? Dazu muss man Speicherkapazität, Antwortverhalten pro Nutzer, Installationsaufwand und die zu pflegende Software gemeinsam betrachten. Titania eignet sich als Fallbeispiel, weil die Produktseite auch die Bedingungen der Leistungsvergleiche offenlegt.
Titania führt Axelera vom Edge zur Inferenz in größerem Maßstab
Axelera bietet mit Metis und Europa bereits Beschleuniger für Edge- und Unternehmensanwendungen an. Titania setzt diese Produktlinie für größere Inferenzumgebungen fort. Zwei Chiplets sitzen in einem System-in-Package, kurz SiP. Der Entwurf kombiniert Axeleras digitale In-Memory-Computing-Architektur mit programmierbaren RISC-V-Recheneinheiten und LPDDR6-Speicher. Angekündigt sind PCIe-Karten und OAM-Beschleunigermodule sowie luft- und flüssigkeitsgekühlte Konfigurationen über Systempartner.
Für den Einkauf sind das Beschleuniger-Package und der komplette Server zwei verschiedene Entscheidungen. Bei einer PCIe-Karte ist gesondert zu klären, ob ein vorhandenes Gehäuse über die nötigen Steckplätze, Stromversorgung, Luftführung und Softwareunterstützung verfügt. Ein luftgekühlter Referenzentwurf bescheinigt noch keinem konkreten Serverraum seine Eignung. Vergleichbar sind die unterstützten Konfigurationen, die ein Anbieter tatsächlich liefern und warten kann.
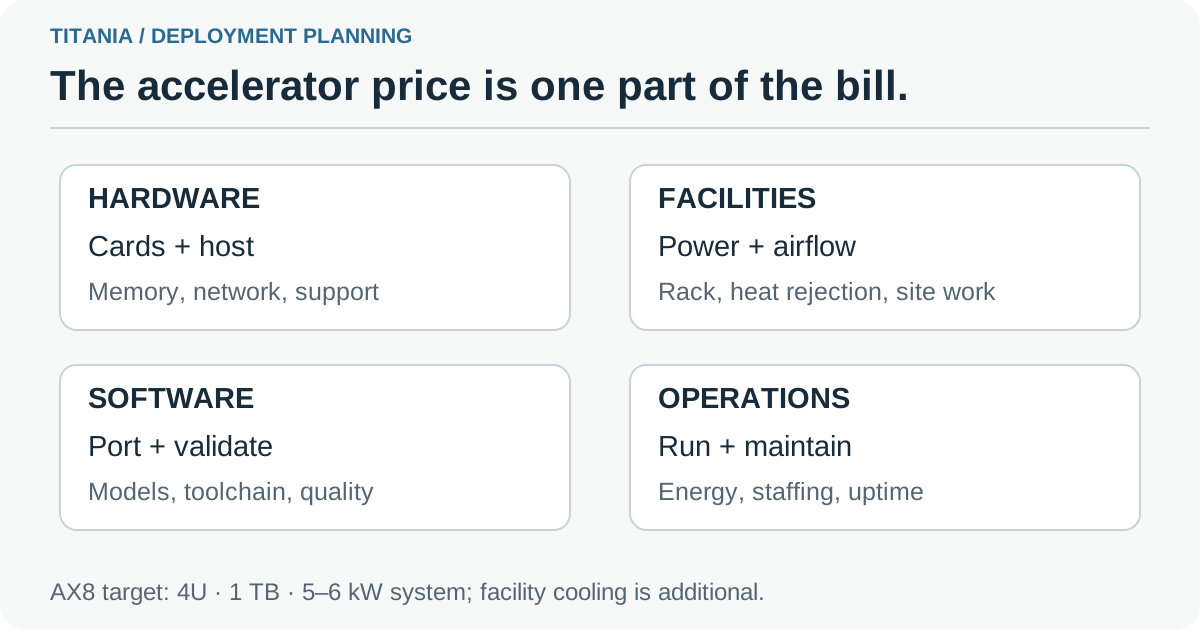
Eigene Erläuterungsgrafik. Zum Bereitstellungsbudget gehören Infrastruktur und Software, die aus einem Server einen dauerhaft betreuten Inferenzdienst machen. Angaben zu Größe und Leistungsaufnahme des AX8 stammen aus Axeleras Ankündigung vom 12. November.
Axeleras Produktunterlagen enthalten eine Herstellerzeichnung der Chiplet-Architektur von Titania. Sie illustriert den geplanten Aufbau und die Speicherhierarchie. Dieselbe Seite liefert die Konfigurationshinweise zur Einordnung der Leistungsdiagramme.
Ein Terabyte beantwortet zuerst die Kapazitätsfrage
Axelera nennt 128 GB LPDDR6 pro Titania-Package. Der AX8-Entwurf mit acht Packages erreicht damit den angegebenen 1 TB Beschleunigerspeicher. Als zusammengefasste Werte nennt Axelera außerdem 19,6 TB/s Speicherbandbreite und 20 PFLOPS FP8-Rechenleistung. Unterstützt werden laut Hersteller FP4, MXFP4, FP8, MXFP8 und BF16. Für die Einordnung zählen die Rechenpräzision und die Verteilung des Modells auf die Packages. Angekündigte Architektur und Daten des Referenzservers
Bei einem großen Mixture-of-Experts-Modell bestimmt die Gesamtzahl der Parameter, wie viele Gewichtsdaten gespeichert werden müssen. Für ein einzelnes Token ist möglicherweise nur ein Teil des Modells aktiv. Der Speicher kann daher auch dann knapp werden, wenn der Rechenaufwand beherrschbar aussieht. So begründet Axelera die Entscheidung für LPDDR6 mit hoher Kapazität und effiziente Datentransfers. Speichertechnik, Recheneinheiten und Packaging sind anders ausbalanciert als bei einem Beschleuniger, der auf HBM setzt.
Laut Ankündigung soll ein AX8-Server ein Modell mit 1,6 Billionen Parametern in FP4 aufnehmen und Platz für den Key-Value-Cache lassen. Das ist eine Kapazitätsangabe des Herstellers für eine bestimmte Präzision. Für eine Anwendung bleibt zu prüfen, ob ihre konkrete Modellrepräsentation, ihre Kontextlängen und ihre gleichzeitigen Anfragen in die unterstützte Konfiguration passen. Über die gespeicherten Gewichte hinaus wächst der Speicherbedarf, wenn mehr oder längere Gespräche bedient werden.
Ein vollständig im Speicher gehaltenes Modell beseitigt eine Hürde. Nutzer erleben vor allem Wartezeit und Antwortqualität. Auch ein passendes Modell kann Abstimmung brauchen, um das Reaktionsziel einzuhalten. Erfüllt ein kleineres Modell die Aufgabe bereits zuverlässig, kann zusätzliche Kapazität entbehrlich sein. Die Aufgabe gibt das Modell und die akzeptable Präzision vor. Danach lässt sich die passende Hardware beurteilen.
Interaktive Geschwindigkeit und Gesamtdurchsatz stellen unterschiedliche Anforderungen
Ein Beispiel ist ein interner Dokumentenassistent, den Beschäftigte in Besprechungen einsetzen. Eine Antwort, die schnell genug erscheint, um das Gespräch weiterzuführen, hat einen anderen Wert als Hunderte über Nacht abgeschlossene Antworten. Neben der Gesamtzahl verarbeiteter Token zählen bei diesem Assistenten die Zeit bis zum ersten brauchbaren Text und die anschließende Ausgabegeschwindigkeit. Das beschreibt eine mögliche Arbeitslast. Ein Titania-Test ist damit nicht dokumentiert.
Ein anderes Team könnte einen Dokumentenrückstand abarbeiten, ohne dass jemand auf einzelne Antworten wartet. Längere Wartezeiten sind tolerierbar, wenn Bündelung die Zahl der erledigten Aufträge pro Stunde erhöht. Große gemeinsam genutzte Dienste brauchen je nach Tageszeit möglicherweise beide Betriebsweisen. Bei festem Tempo pro Nutzer kann sich daher eine andere Rangfolge ergeben als bei maximalem Gesamtdurchsatz.
Axelera positioniert Titania ausdrücklich für reaktionsschnelle Inferenz und räumt auf der Produktseite ein, dass GPU-Systeme auf Rack-Ebene bei sehr großen Batches vorne liegen können. Die Diagramme zeigen verschiedene Modelle und Rack-Konfigurationen. Beim Einkauf zählt, welche Konfiguration die Latenzanforderung bei der erwarteten Parallelität und zu vertretbaren Kosten erfüllt. Bedingungen der Titania-Leistungsvergleiche
| Frage zur Arbeitslast | Welche Nachweise weiterhelfen | Was ein einzelner Spitzenwert offenlässt |
|---|---|---|
| Können Beschäftigte den Dokumentenassistenten live nutzen? | Zeit bis zur ersten Antwort und Ausgabetempo bei der geplanten Parallelität | Warteschlangen und besonders langsame Antworten zu Stoßzeiten |
| Schafft ein Batchdienst den Rückstand über Nacht? | Abgeschlossene Aufträge pro Stunde mit repräsentativen Dokumenten | Einfluss von Eingabelänge und Bündelung auf die Abschlusszeit |
| Kann ein Server Video- und Sprachaufgaben kombinieren? | Durchgängige Ergebnisse bei aktiver Dekodierung, Inferenz und Anwendungslogik | Hostlast, konkurrierende Arbeit sowie verlorene oder verspätete Aufträge |
Vor den Leistungsfaktoren stehen die Simulationsbedingungen
Die Titania-Produktseite kennzeichnet die Leistungswerte als interne Simulationen mit Axeleras Produktionscompiler. Ein Serververgleich stellt ein im August 2026 simuliertes Titania-System mit acht Karten den Wettbewerbsdaten von InferenceX vom September 2026 gegenüber. Zu den genannten Bedingungen gehören FP4, 8.000 Eingabe-Token und 1.000 Ausgabe-Token. Andere Diagramme verwenden Rack-Simulationen aus dem Oktober mit jeweils eigenen Konfigurationen.
Diese Bedingungen erklären das Ziel der Diagramme und begrenzen zugleich die möglichen Schlussfolgerungen. Eine Simulation mit Compiler ist ein technischer Anhaltspunkt. Ein unabhängiger Test auf Titania-Serienhardware steht gesondert aus. Einsätze von Metis oder Europa geben Axeleras Technologie Kontext. Aus Titania-Prognosen werden dadurch keine Messungen an ausgelieferten Servern.
Die angekündigten Vorteile von bis zu siebenfachem Durchsatz pro Watt und bis zu zwanzigfach beim Vergleich der Gesamtbetriebskosten beziehen sich auf Axeleras Vergleichsrahmen. Darin liegen weder Preisangebote noch Vorhersagen für einen einzelnen Standort. Laut Produktseite wird bei der Leistung TDP mit TDP verglichen. Die Kosten stammen aus Axeleras TCO-Modell. Die TDP beschreibt eine Auslegungsleistung. Der Stromverbrauch eines eingesetzten Dienstes hängt vom Gesamtsystem und von der Arbeitslast ab.
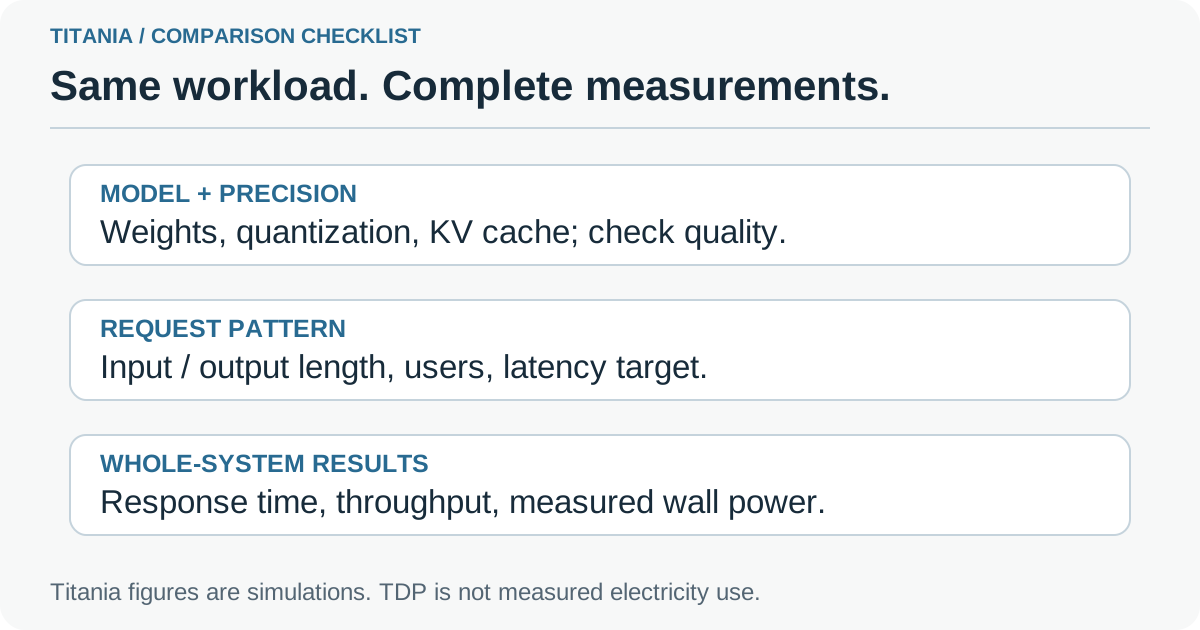
Eigene Erläuterungsgrafik. Ein Leistungsvergleich sollte Modell, Präzision, Anfragelängen und Parallelität gemeinsam berücksichtigen. Quelle der Bedingungen ist Axeleras Titania-Produktseite.
Wer einen Faktor in eine Beschaffungstabelle einträgt, sollte zuerst die Konfiguration erfragen. Zum Ergebnis gehören Modellversion, Präzision, Qualitätsprüfung und Verteilung der Anfragen. Entscheidend ist auch, ob die Leistung am Beschleuniger, am kompletten Server oder an der Anlage gemessen wurde. Ein engerer Messbereich kann einen Vergleich sonst zu seinen Gunsten verzerren.
Luftkühlung braucht einen Plan für Strom und Abwärme
Luftkühlung beschreibt, wie der Server seine Wärme an die Umgebungsluft abgibt. Ein geeignetes Kühlsystem der Anlage muss diese Wärme aus dem Raum abführen. Die geplanten 5–6 kW typische Leistungsaufnahme des AX8 sind für ein einzelnes 4U-Gerät erheblich. Das Gebäudeteam braucht die angebotene Konfiguration, die Installationsanforderungen und die erwartete Arbeitslast, bevor es die Eignung eines Racks beurteilt.
Eine Rechenannahme veranschaulicht die Größenordnung. Bei durchschnittlich 5–6 kW über durchgehend 24 Stunden würde der Server an diesem Tag 120–144 kWh verbrauchen. Die Rechnung nimmt eine konstante mittlere Leistung an und beruht auf keiner Titania-Messung. Arbeitslast und Leerlauf können das Ergebnis verändern. Kühlung, Umwandlungsverluste und übrige Anlagentechnik kommen hinzu.
Axelera stellt in Aussicht, ein bestehendes Rechenzentrum nutzen zu können, ohne es für ein dicht belegtes flüssigkeitsgekühltes Rack umzubauen. Die Einsparung hängt davon ab, was der Standort bereits verträgt. Freie elektrische und thermische Reserven führen zu einem anderen Projekt als ausgelastete Stromkreise und Raumkühlung. Auch bei einem 4U-Gehäuse oder einer PCIe-Karte ist die Installation aufwändiger als die Aufrüstung eines Desktop-PCs.
Softwarekontinuität kann genauso wichtig sein wie die Hardwarekapazität
Axelera zufolge bilden Voyager SDK und AxeleraScript eine gemeinsame Grundlage für Metis, Europa und Titania. Die Ankündigung beschreibt geplante Unterstützung für Tensor-, Experten- und Pipelineparallelität, spekulatives Dekodieren sowie Auslagerung oder Entkopplung des KV-Caches. Die Titania-PCIe-Karte soll zudem einen künftigen Aufrüstungspfad für den auf Europa basierenden Axelera Server 250p bieten. Das betrifft Teams, die Axeleras Softwareumgebung bereits prüfen.
Wer Europa einsetzt, wird zunächst wissen wollen, welche unterstützten Operationen, Modellkonvertierungen, Integrationsbausteine, Überwachungsfunktionen und Bereitstellungspakete sich übernehmen lassen. Für ein Team aus einer anderen Umgebung ist der Wechsel zu Voyager bereits Entwicklungsarbeit. Ein gemeinsames SDK kann Aufwand zwischen den Produkten eines Herstellers sparen. Die Anwendung braucht dennoch eine Prüfung je Zielkonfiguration. Die Portabilität zeigt sich am konkreten Modell mitsamt Verarbeitungskette.
Ein Videodienst, der Aufnahmen mit Beschreibungen versieht, ist ein Beispiel. Die angekündigte integrierte 8K-Dekodierung und 4K-Kodierung von H.265 und AV1 könnte Aufgaben zwischen Beschleuniger und Host neu verteilen. Ein praktischer Versuch sollte die unterstützten Codec-Einstellungen, die Bildaufbereitung, das Sprachmodell, die Speicherung und die Antwort der Anwendung enthalten. Ein schnelleres Sprachmodell allein belegt keine ausreichende Leistung für die gesamte Videoverarbeitung.
Bei einem internen Dokumentenassistenten gehören Suche und Zugriffssteuerung zur Arbeit. Inferenz vor Ort ändert den Ausführungsort des Modells. Dokumentberechtigungen, Protokolle, Backups und Dienstzugangsdaten benötigen weiterhin eigene Entscheidungen. Zum Hardwareangebot gehört deshalb ein Betriebsplan, der festlegt, wer die Laufzeit aktualisiert, Modelländerungen prüft und den Dienst nach einem Ausfall wiederherstellt.
Sechs Entscheidungen vor der Bewertung
Der heutige Stand von Titania spricht für eine stufenweise Bewertung. Am Anfang stehen die Anwendung und eine verfügbare Ausgangsbasis. Nachweise lassen sich einholen, sobald unterstützte Systeme bereitstehen. Eine Herstellerdemonstration kann weiterhelfen, wenn Konfiguration und Grenzen festgehalten werden. Die abschließende Abnahme am vorgesehenen Standort bleibt eine eigene Aufgabe.
- Aufgabe und Dienstziel festlegen. Repräsentative Dokument-, Agenten- oder Videoanfragen auswählen. Akzeptable Antwortqualität, Reaktionszeit und Parallelität in Stoßzeiten festlegen, bevor das größte Modell ausgewählt wird.
- Aktuelle Ausgangswerte festhalten. Mit dem bestehenden System oder gehosteten Dienst Arbeitsvolumen, Latenz und Betriebskosten bestimmen. Die Modell- und Anfrageversionen für spätere Vergleiche aufbewahren.
- Unterstützte Konfiguration erfragen. Geplante Modellunterstützung, Speicheranordnung, Hostdaten, Softwareversionen und Zuständigkeiten der Systempartner klären. Angekündigte Merkmale von in dieser Konfiguration vorgeführten Funktionen unterscheiden.
- Den Standort prüfen lassen. Dem zuständigen Team die Strom-, Luftführungs- und Installationsanforderungen des Anbieters geben. Benachbarte Geräte und verfügbare Kühlreserven in die Beurteilung einbeziehen.
- Den kompletten Dienst testen, sobald Hardware verfügbar ist. Anfragemuster, Suche, Codecs und Überwachung einbeziehen. Über denselben Zeitraum Serverleistung, abgeschlossene Arbeit und Reaktionszeiten erfassen.
- Den längerfristigen Betrieb kalkulieren. Integrationszeit, Support, Wartung und eine praktikable Ausweichlösung berücksichtigen. Die Gesamtbetriebskosten anhand der erwarteten Arbeitslast einschließlich ruhiger Phasen vergleichen.
Auch die Entscheidung für den Weiterbetrieb vorhandener Geräte wird dadurch belastbarer. Erreicht ein kleineres Modell das Ziel mit geringem Aufwand, spart eine vermiedene Migration Geld und Arbeitszeit. Ist dagegen die Speicherkapazität oder die Installation der Engpass, liefert Titanias Entwurf einen konkreten Ansatzpunkt für das nächste Gespräch mit einem Anbieter.
Der Produktionszeitpunkt gehört zu den Hardwaredaten
Axeleras November-Ankündigung nennt das dritte Quartal 2027 als Produktionsziel und spricht von Kundenzusagen für Einsätze bis Anfang 2028. Die Produktseite nennt das breitere Fenster der zweiten Jahreshälfte 2027 und zeigt einen Aufrüstungspfad für 2028. Das sind Angaben zur Roadmap. Produktionsbeginn, Lieferung eines unterstützten Servers und Installation in einem bestimmten Land sind eigene Meilensteine.
Wer im November 2026 plant, braucht Angaben eines Systempartners zu regionalem Preis, Lieferterminen und Serviceumfang. Eine Kaufzusage für künftige Hardware hat eine andere Aussagekraft als eine laufende Kundeninstallation. Wer sofort Inferenzkapazität braucht, benötigt eine verfügbare Lösung und einen tragfähigen Betriebsplan. Titania kann in eine spätere Evaluation eingehen, ohne zur Voraussetzung für eine baldige Einführung zu werden.
Am wertvollsten wäre eine Inferenzkapazität, die ein Team in der eigenen Anlage installieren, warten und bezahlen kann. Titania verknüpft diese Aussicht mit Speicher, interaktiver Leistung und vorhandener Infrastruktur. Der nächste Schritt ist, Auslegung und Simulation in unterstützte Systeme zu überführen und diese an der tatsächlichen Arbeit von Kunden zu messen.
Quellen
- Axelera AI: Ankündigung der Titania-Architektur vom 12. November 2026
- Axelera AI: Titania-Produktdaten, Roadmap und Simulationsbedingungen, abgerufen am 18. November 2026.
- DARE-Projekt: Projektpartner Axelera stellt Titania vor, 12. November 2026
Wer die Arbeitslast, die Fragen an Anbieter und die späteren Testergebnisse zusammen aufbewahrt, kann beim nächsten Vergleich mit denselben Annahmen arbeiten. Erste Notiz mit Telli.sh erstellen.