Mil alertas de segurança, um banco acessível: o AWS Continuum muda a fila
O AWS Continuum para vulnerabilidades de código está disponível. Sua promessa útil é oferecer evidências de explorabilidade e impacto no negócio antes de mais um dia revisando correções geradas.
Um painel de segurança mostra centenas de achados. Um está em um utilitário que nunca recebe tráfego externo. Outro fica a poucos passos do sistema que guarda dados de pagamento dos clientes. Uma classificação de gravidade, sozinha, não diz a uma equipe pequena qual corrigir primeiro.
Em 22 de outubro de 2026, a AWS anunciou a disponibilidade geral do Continuum para vulnerabilidades de código. O serviço conecta análise de código e contexto do ambiente, avalia explorabilidade e impacto no negócio e propõe correções para revisão. Seu artigo detalhado de lançamento coloca uma pessoa antes da decisão final de remediação. Anúncio de lançamento da AWS.
A AWS é a provedora de infraestrutura em nuvem por trás de serviços como EC2 e S3. Esse contexto importa porque uma fraqueza de código ganha ou perde urgência conforme a rede, os recursos e os dados ao redor. A alegação interessante do Continuum é uma fila de reparos mais bem informada, e não apenas outra maneira de gerar um patch.
 Centros de dados da AWS no Oregon, agosto de 2023. Foto: Tedder / Wikimedia Commons, CC BY-SA 4.0. Redimensionada e convertida para WebP sem cortes. Esta fotografia externa de contexto não mostra a interface do Continuum; veja o anúncio e as telas oficiais do produto.

Uma vulnerabilidade se torna um incidente por um caminho
Um scanner pode identificar uma função perigosa ou uma dependência com uma fraqueza conhecida. A possibilidade de um invasor usá-la depende de outros fatos. O caminho vulnerável é realmente utilizado? Uma requisição externa consegue alcançá-lo? Quais permissões e dados ficam disponíveis se a requisição der certo?
Essas perguntas conectam a segurança da aplicação à forma como o sistema é implantado. Uma ferramenta apenas de desenvolvimento e um serviço exposto podem compartilhar um componente vulnerável e apresentar riscos muito diferentes. No sentido oposto, um problema com pontuação genérica menos alarmante pode merecer atenção imediata se levar diretamente a um sistema importante.
O lançamento do Continuum descreve um grafo de contexto construído a partir do código e, quando configurado, de informações do ambiente AWS coletadas por um coletor autorizado. Ele usa esse contexto para relacionar achados a recursos e sistemas críticos para o negócio. Contexto e fluxo do coletor; visão geral do serviço.
Nossa avaliação é que isso coloca a priorização no centro da questão do produto. Uma correção gerada por IA só é útil se a equipe entende o problema o suficiente para revisar a mudança e decidir quando publicá-la. Mais saídas automáticas não ajudam se ampliam uma fila de revisão já impossível de administrar.
A fila é como uma sala de espera. Ordenar todos pelo volume do alarme é menos útil do que entender qual condição é urgente, quais evidências sustentam o julgamento e o que o tratamento mudaria. Um serviço de segurança conquista confiança tornando esse raciocínio inspecionável.
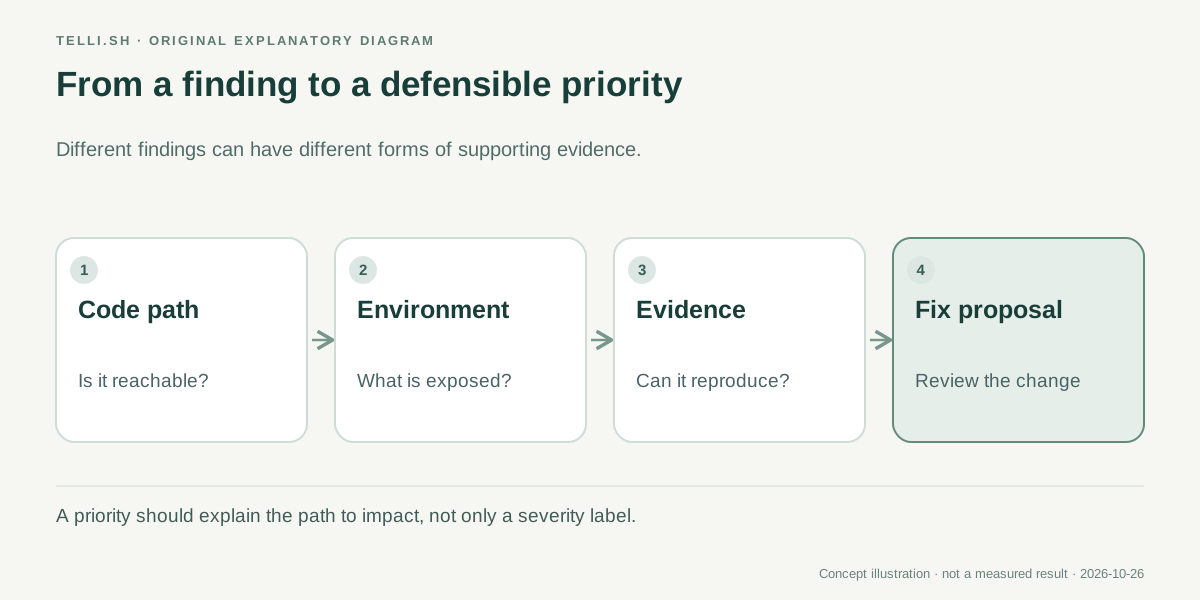 Explicação original de uma revisão orientada por evidências. Nem todo achado tem o mesmo tipo de prova ou pode ser reproduzido da mesma maneira.
Níveis de evidência importam mais do que uma explicação confiante
A AWS descreve várias formas de evidência de apoio. Um achado pode ser estabelecido por análise estática de um caminho de código. Para problemas que o serviço consegue reproduzir, ele pode usar um sandbox isolado e anexar código de prova de conceito e etapas de reprodução. A distinção importa: uma narrativa plausível sobre exploração não é a mesma coisa que um exploit reproduzido.
A demonstração de lançamento também distingue produzir um patch de resolver o problema. O Continuum pode abrir uma pull request, mas a equipe precisa revisá-la e fazer o merge. A existência de uma mudança gerada, por si só, não significa que o serviço vulnerável foi corrigido em produção. Demonstração de lançamento e fluxo de revisão.
O revisor deve conseguir responder a perguntas concretas a partir das evidências. Qual entrada alcança a operação vulnerável? Quais suposições a prova faz sobre autenticação ou permissões? A mudança proposta remove esse caminho sem quebrar um uso legítimo?
É útil separar essas perguntas da qualidade de escrita do relatório. Uma explicação clara pode acelerar a revisão, mas clareza não é validação independente. O código de apoio, a configuração e as condições de reprodução ainda sustentam a afirmação técnica.
Em um piloto, inclua exemplos em que a exploração deveria falhar. Um serviço atrás de um controle eficaz, um caminho de dependência não utilizado e um problema já mitigado por uma mudança de configuração podem revelar se a ferramenta entende o contexto ou apenas repete a gravidade do scanner original.
Um serviço de pagamentos e uma ferramenta de desenvolvimento precisam de decisões diferentes
Considere uma aplicação ilustrativa com um serviço público de checkout e um gerador privado de relatórios usado apenas no desenvolvimento. Ambos contêm achados que parecem graves isoladamente. O checkout trata requisições ligadas a transações de clientes; o gerador não tem um papel previsto em produção.
Uma revisão orientada por evidências estabeleceria primeiro os fatos reais da implantação. Verificaria se o utilitário supostamente privado está acessível, se o problema do checkout cruza uma fronteira real de confiança e quais dados ou operações ficam disponíveis por cada caminho. A descrição no documento de arquitetura deve ser confrontada com a configuração implantada.
Se o caminho do checkout for confirmado, a correção ainda precisa ser delimitada. Um patch que bloqueia uma requisição maliciosa, mas também rejeita pedidos válidos, desloca o problema em vez de resolvê-lo. As verificações de regressão devem cobrir o comportamento legítimo que a equipe pretende preservar.
Se a ferramenta de desenvolvimento realmente está ausente da aplicação implantada, a equipe pode agendar sua correção de outra forma. Isso não é motivo para ignorar o problema para sempre. É motivo para distinguir exposição imediata de manutenção e guardar as evidências que sustentam a distinção.
Esse exemplo é uma forma de estruturar a avaliação, não um resultado relatado de cliente. O resultado importante é uma ordem de reparos que a equipe possa defender com informações atuais. Uma ferramenta que concorda com todas as prioridades existentes revela menos do que uma que explica uma diferença surpreendente, mas verificável.
A primeira implantação deve inspecionar uma aplicação, não autorizar toda correção
O anúncio de disponibilidade geral do Continuum identifica US East, no norte da Virgínia, e US West, no Oregon, como regiões iniciais. Ele descreve a conexão de uma fonte de código por GitHub ou S3 e a inclusão opcional do contexto do ambiente AWS com um coletor. Requisitos de conta, região e acesso continuam fazendo parte da configuração. Disponibilidade e requisitos das fontes.
Para uma equipe que considera um teste, o ponto de partida adequado é uma aplicação cuja arquitetura e fluxos importantes já sejam conhecidos. Isso facilita perceber um achado inesperado e uma suposição ausente. Também dá aos revisores uma referência do que o serviço deve considerar crítico.
- Selecione o repositório ou a fonte compatível e identifique o ambiente da aplicação que ela realmente representa.
- Leia os requisitos atuais do serviço, escolha uma região compatível e revise o acesso necessário para conectar o código.
- Decida se deve adicionar um coletor AWS autorizado e qual contexto de ambiente ele fornecerá.
- Compare os primeiros achados com problemas conhecidos, mitigações conhecidas e casos difíceis escolhidos deliberadamente.
- Inspecione as evidências de um reparo proposto, incluindo suposições e o provável efeito sobre usuários legítimos.
- Revise a pull request, execute as verificações relevantes e confirme o resultado implantado pelo processo normal de lançamento da equipe.
Essa é uma sequência proposta de avaliação. Ela não substitui o guia atual de configuração do produto nem as regras de implantação da organização. O hábito útil é manter acesso à fonte, revisão de evidências e aprovação de lançamento como decisões distintas.
O cálculo de custo deve seguir a mesma lógica. A equipe precisa entender o preço atual e a quantidade de trabalho que pretende analisar. Também deve contar o tempo gasto para aceitar, rejeitar ou corrigir uma proposta. Um patch que economiza codificação ainda pode criar esforço de revisão em outro lugar.
Uma proposta de reparo e um reparo autônomo são marcos diferentes
O artigo detalhado de lançamento diz que a remediação começa com uma correção proposta que uma pessoa aprova. Ele descreve a aplicação autônoma mais ampla de correções selecionadas como capacidade futura. Outros textos de produto da AWS falam de aplicação progressiva de forma mais abrangente. Para uma equipe decidindo uma implantação, o ponto de partida conservador e prático é o caminho documentado com revisão humana. Descrição detalhada do lançamento; anúncio What's New.
A distinção não é um detalhe de redação. Preparar um patch automaticamente, abrir uma pull request automaticamente e alterar um sistema em execução automaticamente têm consequências diferentes. Uma demonstração de uma etapa não deve ser tratada como prova de que todas as etapas seguintes estão habilitadas ou são adequadas.
| Etapa | O que a equipe pode aprender | O que falta estabelecer |
|---|---|---|
| Achado | Existe uma fraqueza suspeita | Se o código e a configuração relevantes são realmente usados |
| Evidência e contexto | Por que um caminho pode ser explorável e importante | Se as suposições correspondem ao ambiente atual |
| Patch ou PR proposto | Há uma mudança concreta disponível para revisão | Se resolve o problema e preserva o comportamento desejado |
| Mudança integrada e implantada | O sistema em execução recebeu uma mudança aprovada | Se o caminho vulnerável foi fechado sem nova regressão |
Essa separação ajuda a usar a automação de forma incremental. Um serviço pode ser valioso como fonte de evidências antes de a equipe aceitar seus patches rotineiramente. Pode produzir patches úteis antes de a organização desejar qualquer forma de publicação automática.
As próximas evidências a acompanhar são como o serviço lida com operações repetidas em ambientes reais. Uma classe de reparo anteriormente aceita continua segura depois que a aplicação muda? O revisor consegue ver por que um achado aparentemente semelhante recebe outra prioridade? O sistema detecta quando o contexto de que depende está incompleto?
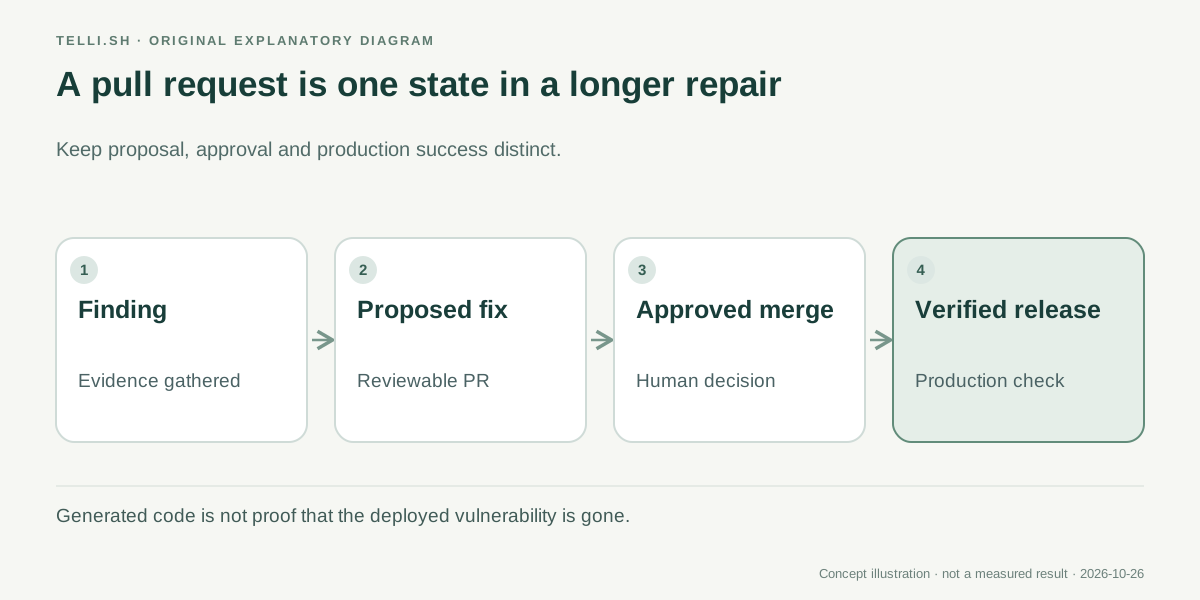 Uma PR gerada é um artefato para revisão. A remediação bem-sucedida em produção é um estado posterior, com suas próprias evidências.
O coletor de contexto merece o mesmo escrutínio que o modelo
Um contexto melhor pode tornar o julgamento de segurança mais útil, mas a conexão que o fornece passa a fazer parte das premissas operacionais do sistema. Se o coletor vê apenas alguns recursos, o relatório pode descrever apenas parte do caminho de ataque. Se o ambiente mudou, um julgamento anterior pode precisar ser revisto.
Por isso, um piloto deve registrar quais fontes foram conectadas e quando seus dados estavam atualizados. Um relatório deve ser interpretado em relação a esse escopo. Ele não deve virar uma declaração universal de que a aplicação é segura só porque um conjunto de achados foi revisado.
O mesmo princípio se aplica ao impacto no negócio. Um banco pode estar tecnicamente acessível, mas conter material de teste de pouco valor, ou parecer periférico enquanto sustenta um fluxo crítico. O responsável de negócio e a equipe técnica precisam compartilhar o entendimento do significado do recurso.
Há uma divisão promissora de trabalho aqui. O software ajuda a conectar grandes volumes de evidências técnicas e produzir uma proposta concreta. As pessoas decidem qual sistema importa, se as premissas estão certas e qual risco de lançamento a empresa está disposta a assumir.
Uma avaliação eficaz deve medir falsos alarmes e prioridades perdidas. Menos alertas pode parecer impressionante mesmo quando problemas importantes somem de vista. A meta é uma fila que preserve o trabalho certo e dê aos revisores uma razão melhor para agir.
A ferramenta útil de segurança com IA facilita justificar a próxima decisão
O lançamento do Continuum é interessante porque conecta reparos assistidos por IA ao contexto que permite decidir se merecem atenção. É uma ambição mais útil do que produzir outra pilha de alterações plausíveis no código.
Antes de aceitar uma correção proposta, pergunte o que mudou na sua compreensão do risco. Se a resposta inclui um caminho acessível, evidências inspecionáveis e um reparo delimitado, a ferramenta ajudou na parte difícil. Se só oferece um parágrafo confiante e uma nova PR, a fila ainda é sua.
Fontes
- AWS: disponibilidade geral do Continuum para vulnerabilidades de código, 22 de outubro de 2026.
- AWS What's New: Continuum GA, 22 de outubro de 2026.
- Guia do usuário do AWS Continuum, consultado em 26 de outubro de 2026.
Mantenha sua revisão conectada à fonte
O Telli.sh é uma opção para guardar material de origem autorizado e as notas por trás de uma decisão técnica. Crie um espaço de notas.