Tausend Sicherheitswarnungen, eine erreichbare Datenbank: AWS Continuum sortiert neu
AWS Continuum for code vulnerabilities ist allgemein verfügbar. Sein praktisches Versprechen: Belege für Ausnutzbarkeit und geschäftliche Folgen, bevor ein Team den nächsten Tag mit generierten Korrekturen verbringt.
Ein Sicherheitsdashboard zeigt Hunderte Befunde. Einer liegt in einem Hilfswerkzeug, das nie externen Verkehr erhält. Ein anderer ist nur wenige Schritte von dem System entfernt, das Zahlungsdaten der Kunden speichert. Eine Schweregradangabe allein sagt einem kleinen Entwicklungsteam nicht, welchen Fehler es zuerst beheben sollte.
Am 22. Oktober 2026 gab AWS die allgemeine Verfügbarkeit von Continuum for code vulnerabilities bekannt. Der Dienst verbindet Codeanalyse mit Umgebungskontext, bewertet Ausnutzbarkeit und geschäftliche Folgen und schlägt Korrekturen zur Prüfung vor. Der ausführliche Einführungsartikel sieht vor der endgültigen Behebungsentscheidung einen Menschen vor. AWS-Ankündigung.
AWS ist der Cloud-Infrastrukturanbieter hinter Diensten wie EC2 und S3. Dieser Hintergrund zählt hier, weil die Dringlichkeit einer Codeschwäche von den umgebenden Netzwerken, Ressourcen und Daten abhängt. Continuums interessante Zusage ist eine besser begründete Reparaturreihenfolge und nicht einfach eine weitere Möglichkeit, Patches zu erzeugen.
 AWS-Rechenzentren in Oregon, August 2023. Foto: Tedder / Wikimedia Commons, CC BY-SA 4.0. Ohne Beschnitt verkleinert und in WebP umgewandelt. Dieses externe Hintergrundfoto zeigt nicht die Continuum-Oberfläche; diese finden Sie in der offiziellen Produktankündigung mit Bildschirmansichten.

Über einen konkreten Pfad wird aus einer Schwachstelle ein Vorfall
Ein Scanner kann eine gefährliche Funktion oder eine Abhängigkeit mit bekannter Schwäche erkennen. Ob ein Angreifer sie nutzen kann, hängt von weiteren Fakten ab. Wird der verwundbare Codepfad tatsächlich ausgeführt? Erreicht ihn eine externe Anfrage? Welche Berechtigungen und Daten stehen bei einem erfolgreichen Angriff zur Verfügung?
Solche Fragen verbinden Anwendungssicherheit mit der tatsächlichen Bereitstellung des Systems. Ein reines Entwicklungswerkzeug und ein öffentlich erreichbarer Dienst können dieselbe verwundbare Komponente enthalten und trotzdem sehr unterschiedliche Risiken aufweisen. Umgekehrt kann ein Befund mit einem weniger alarmierenden allgemeinen Wert sofortige Aufmerksamkeit verdienen, wenn er direkt zu einem wichtigen System führt.
Continuums Einführung beschreibt einen Kontextgraphen aus Code und, sofern eingerichtet, Informationen zur AWS-Umgebung, die ein autorisierter Collector erfasst. Dieser Kontext verbindet Befunde mit Ressourcen und geschäftskritischen Systemen. Ablauf mit Kontext und Collector; Dienstübersicht.
Unsere Einschätzung: Damit wird die Priorisierung zur zentralen Produktfrage. Eine KI-generierte Korrektur ist nur nützlich, wenn das Team den Fehler gut genug versteht, um die Änderung zu prüfen und ihren Veröffentlichungszeitpunkt zu bestimmen. Mehr automatisierter Output hilft nicht, wenn er eine bereits unbeherrschbare Prüfliste weiter vergrößert.
Die Liste ähnelt einem Wartezimmer. Alle nach der Lautstärke des Alarms zu sortieren, ist weniger hilfreich, als zu verstehen, welcher Zustand dringend ist, welche Belege das Urteil stützen und was die Behandlung verändern würde. Ein Sicherheitsdienst verdient Vertrauen, indem er diese Überlegungen prüfbar macht.
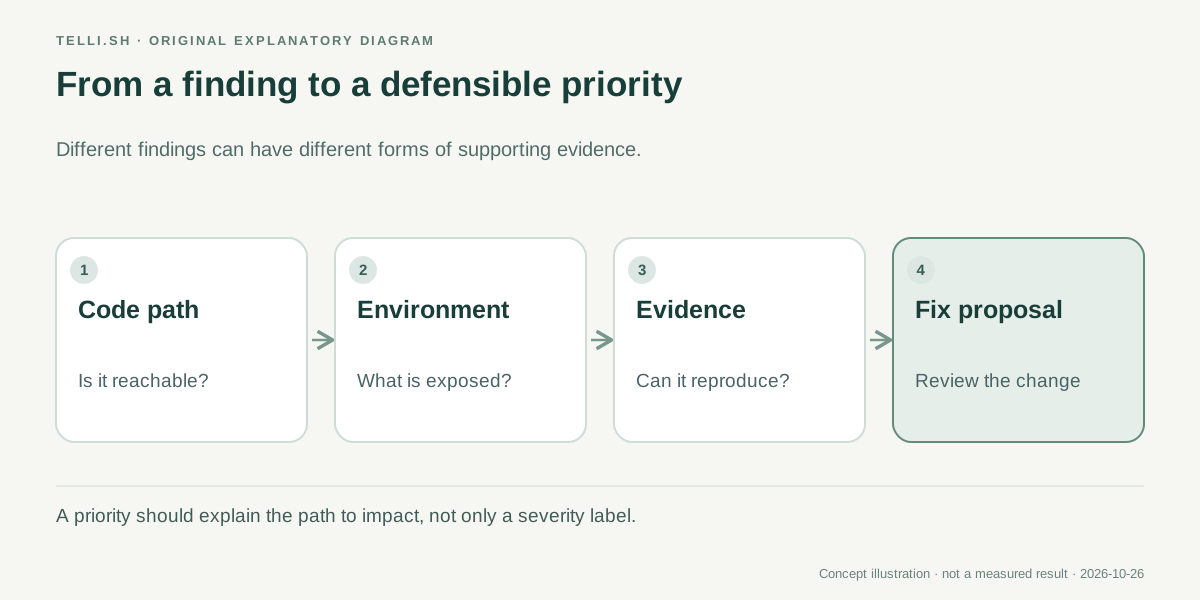 Eigene Erklärung eines beleggestützten Prüfwegs. Nicht jeder Befund hat dieselbe Art von Nachweis oder lässt sich auf dieselbe Weise reproduzieren.
Die Art des Nachweises zählt mehr als eine selbstsichere Erklärung
AWS beschreibt mehrere Formen unterstützender Nachweise. Ein Befund kann durch statische Analyse eines Codepfads festgestellt werden. Bei reproduzierbaren Problemen kann der Dienst eine isolierte Sandbox nutzen und Machbarkeitscode sowie Reproduktionsschritte beifügen. Der Unterschied ist wesentlich: Eine plausible Geschichte über die Ausnutzung ist nicht dasselbe wie ein reproduzierter Angriff.
Die Einführung trennt außerdem sinnvoll zwischen dem Erstellen eines Patches und dem Beheben eines Problems. Continuum kann einen Pull Request öffnen, das Team muss ihn aber prüfen und zusammenführen. Eine generierte Änderung allein bedeutet nicht, dass der verwundbare Dienst im Produktivbetrieb repariert ist. Einführungsbeispiel und Prüfablauf.
Aus den Belegen sollte eine prüfende Person mehrere konkrete Fragen beantworten können. Welche Eingabe erreicht den verwundbaren Vorgang? Welche Voraussetzungen zu Anmeldung oder Berechtigungen macht der Nachweis? Entfernt die vorgeschlagene Änderung diesen Pfad, ohne eine berechtigte Nutzung zu unterbrechen?
Trennen Sie diese Fragen von der sprachlichen Qualität des Berichts. Eine klare Erklärung kann die Prüfung beschleunigen, ist aber keine unabhängige Bestätigung. Die technische Aussage tragen weiterhin Code, Konfiguration und Reproduktionsbedingungen.
Nehmen Sie in einen Pilotversuch Fälle auf, bei denen eine Ausnutzung scheitern sollte. Ein Dienst hinter einer wirksamen Schutzmaßnahme, ein ungenutzter Abhängigkeitspfad oder eine bereits durch Konfiguration entschärfte Schwäche helfen zu erkennen, ob das Werkzeug Kontext versteht oder nur den Schweregrad des ursprünglichen Scanners wiederholt.
Zahlungsdienst und Entwicklungswerkzeug verlangen unterschiedliche Entscheidungen
Betrachten wir beispielhaft eine Anwendung mit öffentlichem Bestelldienst und einem privaten Berichtsgenerator, der nur während der Entwicklung verwendet wird. Beide enthalten isoliert betrachtet ernst wirkende Befunde. Der Bestelldienst verarbeitet Anfragen zu Kundentransaktionen; der Berichtsgenerator hat keine vorgesehene Rolle im Produktivbetrieb.
Eine beleggestützte Prüfung würde zunächst die tatsächlichen Bereitstellungsbedingungen feststellen. Ist das angeblich private Hilfswerkzeug erreichbar? Überschreitet der Befund im Bestelldienst eine reale Vertrauensgrenze? Welche Daten oder Vorgänge werden über die einzelnen Pfade zugänglich? Die Beschreibung im Architekturpapier sollte mit der bereitgestellten Konfiguration abgeglichen werden.
Bestätigt sich der Pfad im Bestelldienst, braucht die vorgeschlagene Korrektur weiterhin einen begrenzten Umfang. Ein Patch, der einen schädlichen Aufruf blockiert, aber auch gültige Bestellungen abweist, hat das Problem nur verlagert. Regressionsprüfungen sollten das legitime Verhalten abdecken, das das Team erhalten möchte.
Ist das Entwicklungswerkzeug tatsächlich nicht Teil der bereitgestellten Anwendung, kann das Team seine Reparatur anders einplanen. Das ist kein Grund, den Fehler dauerhaft zu ignorieren. Es ist ein Grund, unmittelbare Gefährdung und Wartungsarbeit zu unterscheiden und die Belege für diese Unterscheidung aufzubewahren.
Dieses Beispiel beschreibt einen Bewertungsansatz, kein gemeldetes Kundenergebnis. Entscheidend ist eine Reparaturreihenfolge, die das Team mit aktuellen Informationen begründen kann. Ein Werkzeug, das jeder vorhandenen Priorität zustimmt, liefert weniger Erkenntnis als eines, das einen überraschenden, aber überprüfbaren Unterschied erklärt.
Beim Einstieg eine Anwendung prüfen, nicht jede Korrektur erlauben
Die Ankündigung zur allgemeinen Verfügbarkeit nennt US East in Northern Virginia und US West in Oregon als erste Regionen. Sie beschreibt die Anbindung von Code über GitHub oder S3 und optional zusätzlichen AWS-Umgebungskontext über einen Collector. Konto-, Regions- und Zugriffsanforderungen gehören weiterhin zur Einrichtung. Verfügbarkeit und Quellanforderungen.
Für einen Versuch eignet sich eine Anwendung, deren Architektur und wichtige Abläufe das Team bereits versteht. So fallen unerwartete Befunde und fehlende Annahmen leichter auf. Die prüfenden Personen haben zudem eine Grundlage dafür, was der Dienst als kritisch betrachten sollte.
- Wählen Sie das Repository oder eine unterstützte Quelle und benennen Sie die tatsächlich damit verbundene Anwendungsumgebung.
- Lesen Sie die aktuellen Dienstanforderungen, wählen Sie eine unterstützte Region und prüfen Sie die nötigen Zugriffe für die Codeanbindung.
- Entscheiden Sie über einen autorisierten AWS-Collector und den Umgebungskontext, den er liefern soll.
- Vergleichen Sie die ersten Befunde mit bekannten Fehlern, vorhandenen Schutzmaßnahmen und bewusst ausgewählten schwierigen Fällen.
- Prüfen Sie die Nachweise hinter einem Reparaturvorschlag, einschließlich Annahmen und wahrscheinlicher Auswirkungen auf berechtigte Nutzer.
- Prüfen Sie den Pull Request, führen Sie die relevanten Kontrollen aus und verifizieren Sie das bereitgestellte Ergebnis im normalen Veröffentlichungsprozess des Teams.
Dies ist eine vorgeschlagene Bewertungsfolge. Sie ersetzt weder die aktuelle Einrichtungsanleitung des Produkts noch die Bereitstellungsregeln der Organisation. Die nützliche Gewohnheit ist, Quellzugriff, Nachweisprüfung und Veröffentlichungsfreigabe als getrennte Entscheidungen sichtbar zu halten.
Für die Kostenrechnung gilt dieselbe Logik. Ein Team muss aktuelle Preise und den geplanten Prüfumfang verstehen. Es sollte auch die Zeit für Annahme, Ablehnung und Korrektur eines Vorschlags zählen. Ein generierter Patch kann Programmieraufwand sparen und trotzdem an anderer Stelle Prüfaufwand erzeugen.
Reparaturvorschlag und autonome Reparatur sind verschiedene Meilensteine
Laut ausführlichem Einführungsartikel beginnt die Behebung mit einem Korrekturvorschlag, den ein Mensch freigibt. Eine breitere autonome Anwendung ausgewählter Korrekturen beschreibt er als künftige Fähigkeit. Andere AWS-Produkttexte sprechen allgemeiner über eine schrittweise Durchsetzung. Für eine Bereitstellungsentscheidung ist der dokumentierte Weg mit menschlicher Prüfung der vorsichtige und praktisch nutzbare Ausgangspunkt. Ausführliche Einführung; What's-New-Ankündigung.
Diese Unterscheidung ist keine sprachliche Nebensache. Einen Patch automatisch vorzubereiten, einen Pull Request automatisch zu öffnen und ein laufendes System automatisch zu verändern hat unterschiedliche Folgen. Eine Vorführung einer Stufe belegt nicht, dass alle späteren bereits aktiviert oder angemessen sind.
| Stufe | Was das Team daraus erfährt | Was noch festzustellen ist |
|---|---|---|
| Befund | Es besteht der Verdacht einer Schwäche | Ob der relevante Code und die Konfiguration tatsächlich genutzt werden |
| Nachweise und Kontext | Warum ein Pfad ausnutzbar und wichtig sein könnte | Ob die Annahmen zur aktuellen Umgebung passen |
| Patchvorschlag oder PR | Eine konkrete Änderung steht zur Prüfung bereit | Ob sie den Fehler behebt und gewünschtes Verhalten erhält |
| Zusammengeführte und bereitgestellte Änderung | Das laufende System hat eine freigegebene Änderung erhalten | Ob der verwundbare Pfad ohne neue Regression geschlossen ist |
Diese Trennung ermöglicht einen schrittweisen Einsatz von Automatisierung. Ein Dienst kann bereits als Belegquelle wertvoll sein, bevor das Team seine Patches regelmäßig akzeptieren möchte. Er kann brauchbare Patches liefern, bevor die Organisation automatische Veröffentlichungen erwägt.
Als Nächstes sind Nachweise aus wiederholtem Betrieb in echten Umgebungen interessant. Bleibt eine zuvor akzeptierte Reparaturklasse nach Änderungen der Anwendung sicher? Versteht ein Prüfer, warum ein scheinbar ähnlicher Befund eine andere Priorität erhält? Erkennt das System unvollständigen Kontext?
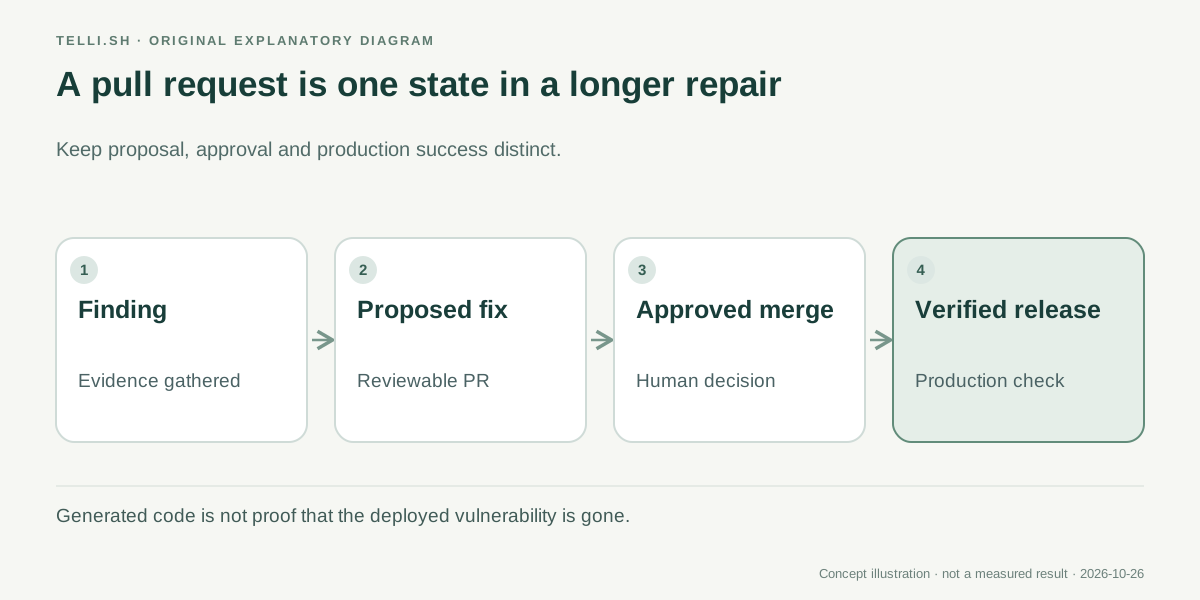 Ein generierter PR ist ein prüfbares Arbeitsergebnis. Erfolgreiche Behebung im Produktivbetrieb ist ein späterer Zustand mit eigenen Nachweisen.
Der Kontext-Collector verdient dieselbe Aufmerksamkeit wie das Modell
Besserer Kontext kann ein Sicherheitsurteil nützlicher machen, doch die liefernde Verbindung wird Teil der Betriebsannahmen. Sieht der Collector nur manche Ressourcen, beschreibt der Bericht möglicherweise nur einen Teil des Angriffspfads. Hat sich die Umgebung geändert, muss ein früheres Urteil vielleicht erneut geprüft werden.
Ein Pilot sollte deshalb festhalten, welche Quellen verbunden waren und wann sie aktuell waren. Berichte sind vor diesem Umfang zu interpretieren. Sie sollten keine allgemeine Aussage über die Sicherheit einer Anwendung werden, nur weil eine bestimmte Befundmenge geprüft wurde.
Dasselbe gilt für geschäftliche Folgen. Eine Datenbank kann technisch erreichbar sein und nur wenig wertvolle Testdaten enthalten. Eine scheinbar nebensächliche Ressource kann dagegen einen kritischen Ablauf stützen. Geschäftsverantwortliche und Entwicklungsteam brauchen ein gemeinsames Verständnis davon, was die Ressource bedeutet.
Hier bietet sich eine sinnvolle Arbeitsteilung an. Software kann große Mengen technischer Belege verbinden und einen konkreten Vorschlag erstellen. Menschen entscheiden, welches System wichtig ist, ob die Annahmen stimmen und welches Veröffentlichungsrisiko das Unternehmen eingehen will.
Eine wirksame Bewertung sollte Fehlalarme und übersehene Prioritäten messen. Weniger Warnungen können eindrucksvoll wirken, obwohl wichtige Probleme aus dem Blick geraten. Ziel ist eine Liste, die die richtige Arbeit erhält und den Prüfern einen besseren Grund zum Handeln gibt.
Ein nützliches KI-Sicherheitswerkzeug macht die nächste Entscheidung begründbarer
Continuums Veröffentlichung ist interessant, weil sie KI-gestützte Reparatur mit dem Kontext verbindet, anhand dessen ein Team über Aufmerksamkeit entscheidet. Das ist ein hilfreicheres Ziel als ein weiterer Stapel plausibler Codeänderungen.
Fragen Sie vor der Annahme eines Vorschlags, was sich an Ihrem Verständnis des Risikos geändert hat. Enthält die Antwort einen erreichbaren Pfad, prüfbare Belege und eine begrenzte Korrektur, hat das Werkzeug beim schwierigen Teil geholfen. Liefert es nur einen selbstsicheren Absatz und einen neuen PR, bleibt die Warteschlange weiterhin Ihre Aufgabe.
Quellen
- AWS: Continuum for code vulnerabilities is generally available, 22. Oktober 2026.
- AWS What's New: Continuum GA, 22. Oktober 2026.
- AWS-Continuum-Benutzerhandbuch, geprüft am 26. Oktober 2026.
Prüfung und Quelle verbunden halten
Telli.sh ist eine Möglichkeit, zur Aufbewahrung freigegebenes Ausgangsmaterial und die Notizen hinter einer technischen Entscheidung zu erhalten. Einen Notizbereich anlegen.