Dois mini PCs de 128 GB, uma pergunta cara: o RTX Spark vale o preço extra?
O ASUS ProArt GR1X está à venda. Testes independentes do RTX Spark trazem uma pergunta de compra melhor do que a capacidade de memória: qual fluxo de trabalho completo justifica o custo extra?
Dois computadores podem trazer 128 GB na caixa e ainda representar compras muito diferentes. A capacidade informa quanta memória existe. Ela não informa a rapidez de resposta de um assistente, quais ferramentas criativas funcionam bem nem quanto trabalho útil a máquina conclui pelo preço cobrado.
O anúncio de vendas do ASUS ProArt GR1X e as novas análises independentes do RTX Spark tornam essa distinção concreta. A ASUS oferece configurações de 64 e 128 GB. O Tom’s Guide informa preço inicial de US$ 4.499 nos Estados Unidos e de US$ 6.999 para o equipamento de 128 GB que testou, e então o compara com um mini PC de 128 GB baseado em AMD.
A pergunta de compra é se a aceleração RTX, a capacidade de resposta e o software que você realmente usa justificam o valor adicional. É uma pergunta mais consistente do que saber se a máquina consegue carregar um modelo local grande.
Em poucas palavras: testes independentes mostram vantagem para a máquina ASUS em tarefas específicas com modelos locais, mas seu preço de compra é elevado. Compare seu modelo, suas ferramentas, o tempo da tarefa completa e os custos de operação contínua antes de escolher apenas pela capacidade de memória.
Este PC Windows já está à venda, com detalhes regionais a conferir
O anúncio da NVIDIA de 18 de novembro de 2026 informa que desktops compactos RTX Spark de ASUS, Dell e MSI estão disponíveis, com outros fabricantes previstos para depois. A página de imprensa da ASUS está marcada como 19 de novembro, enquanto o texto do anúncio tem data de 18 de novembro. A novidade prática é a disponibilidade comercial, em vez de mais uma apresentação de plataforma futura.
ProArt é a linha da ASUS voltada a criadores. No GR1X, esse posicionamento conecta modelos e agentes locais a aplicativos criativos em um desktop Windows compacto. A NVIDIA descreve software Windows em Arm, fluxos acelerados por RTX, ComfyUI e aplicativos nativos como parte do atrativo da plataforma. Ainda é necessário conferir a compatibilidade de cada aplicativo e extensão com seu trabalho.
As opções ASUS de 64 e 128 GB não são intercambiáveis na hora de citar um preço. O valor inicial de US$ 4.499 na análise do Tom’s Guide não é o preço da unidade de 128 GB avaliada. Essa custava US$ 6.999. Trate esses valores como referências americanas da análise, não como um orçamento coreano convertido nem como garantia de que uma loja tenha a mesma configuração em estoque.
Antes de comparar ofertas, confirme memória, armazenamento, sistema operacional, garantia, devoluções e código exato do modelo regional. Um anúncio de vendas respaldado responde se um produto chegou ao mercado. Uma nota de compra local e uma política de suporte respondem o que comprá-lo significa para você.
Um modelo de 27B testa a promessa de memória de forma mais útil
O Tom’s Guide comparou o ProArt GR1X de 128 GB com o Geekom A9 Mega de 128 GB, baseado no Ryzen AI Max 395 da AMD. O avaliador usou LM Studio e Qwen 3.8 27B em duas tarefas generativas e uma tarefa de programação com agente. A mesma análise descreve a máquina AMD como aproximadamente US$ 3.000 mais barata nessa comparação.
Os resultados publicados separam velocidade de geração de tempo de reação. O segundo é a espera até a resposta começar; a primeira é a taxa em que a saída chega depois disso. Nenhuma das colunas, sozinha, informa se uma tarefa de programação produziu uma mudança correta.
| Tarefa do Tom’s Guide, LM Studio com Qwen 3.8 27B | Geração ProArt GR1X | Geração A9 Mega | Reação ProArt GR1X | Reação A9 Mega |
|---|---|---|---|---|
| Redação sobre Apollo 17 | 25.63 tokens/s | 20.76 tokens/s | 0.32 s | 1.10 s |
| Resumo sobre Waterloo | 31.11 tokens/s | 24.30 tokens/s | 0.98 s | 2.41 s |
| Programação com agente | 30.03 tokens/s | 23.77 tokens/s | 0.55 s | 1.26 s |
Fonte: análise independente do Tom’s Guide. Esses são os resultados do modelo, do ambiente de execução e das tarefas daquela análise, não medições nossas nem uma classificação universal de todas as cargas locais.
Na linha de programação, 30,03 dividido por 23,77 é aproximadamente 1,26: cerca de 26% mais tokens gerados por segundo naquele teste. Esse cálculo não significa que um projeto de software termine 26% antes. O agente pode esperar por ferramentas, executar testes, cometer erros ou exigir outro ciclo de revisão. Tampouco estabelece o desempenho de um checkpoint substancialmente maior só porque os dois sistemas têm memória suficiente para carregá-lo.
A diferença no tempo de reação merece uma avaliação separada. Se uma pessoa faz muitas perguntas curtas, uma espera menor antes de cada resposta pode influenciar a experiência mais do que sugere a taxa de geração. Se uma máquina executa um lote longo sem supervisão, o tempo total e a confiabilidade podem importar mais.
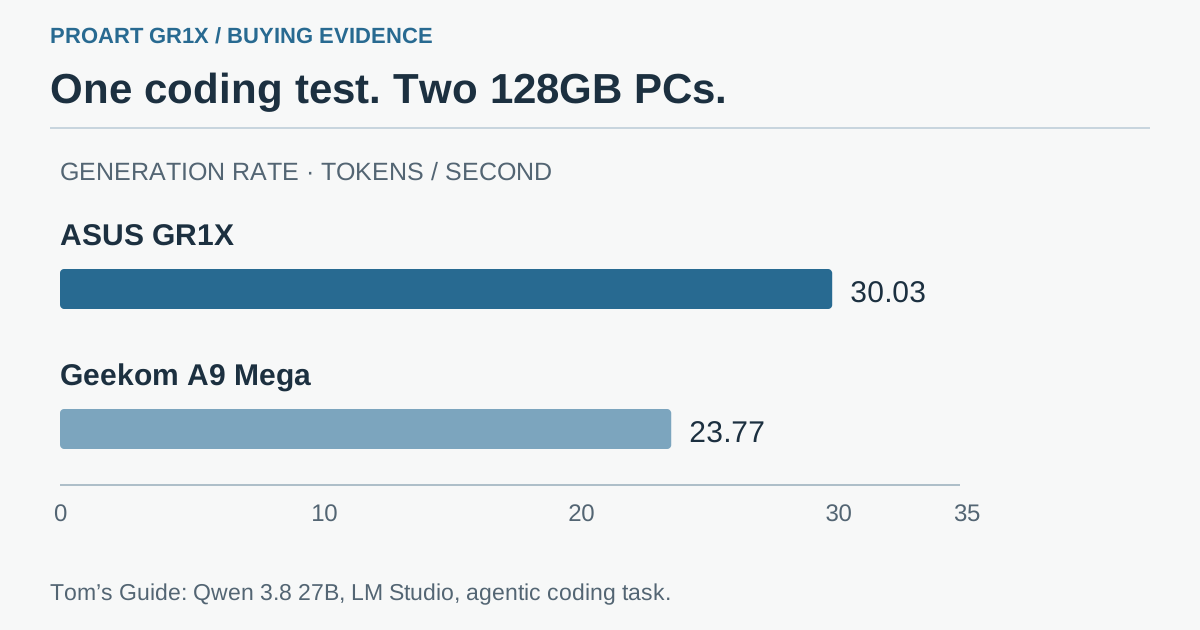 Estrutura original para decidir a compra: a mesma capacidade de memória não comprova a mesma resposta, compatibilidade de software ou custo total. O resultado da análise vale para as tarefas indicadas com Qwen e LM Studio.
O dinheiro extra precisa de uma função definida
Considere um exemplo ilustrativo de uma família ou pequeno estúdio que quer um assistente local permanente. Ele resume documentos, responde a perguntas ocasionais e executa uma tarefa agendada durante a noite. A comparação relevante não é uma especificação máxima do acelerador. É saber se a máquina mais barata atende à mesma carga aceita com espera tolerável e confiabilidade suficiente.
Um segundo comprador pode usar um modelo local durante o dia e gerar elementos visuais no ComfyUI depois do trabalho. Para essa pessoa, a compatibilidade com um fluxo RTX/CUDA específico pode valer mais do que uma diferença modesta na taxa de uma conversa geral. A evidência útil seria um fluxo concluído com os nós, modelos e extensões pretendidos, e não apenas o fato de o aplicativo abrir.
Um terceiro cenário é uma pequena equipe de desenvolvimento que usa uma máquina dedicada enquanto os notebooks viajam. Separar o computador que hospeda o agente do notebook do dia a dia pode ajudar o trabalho agendado a continuar. Porém, credenciais do repositório, gestão de atualizações, backups e acesso remoto continuam sendo tarefas operacionais. Um dispositivo anunciado para agentes permanentes não fornece sozinho um projeto seguro de permissões.
Esses são cenários de compra, não implantações que testamos. O objetivo é atribuir uma função ao valor adicional. Se o benefício proposto é simplesmente “mais IA”, fica difícil saber se o gasto melhorou alguma coisa.
O software RTX pode importar mais do que um número de memória igual
O anúncio de vendas da NVIDIA destaca geração local, aplicativos criativos e ferramentas de desenvolvimento junto com a capacidade de memória. É uma direção razoável para avaliar uma máquina destinada a cargas mistas. Um endpoint de modelo, um grafo de geração de imagens e um aplicativo de edição podem revelar pontos fortes e limitações diferentes.
Windows em Arm é uma questão de compatibilidade, além de um nome de sistema operacional. Verifique os aplicativos, plug-ins, drivers e pacotes de linha de comando exatos de que precisa. Um aplicativo nativo pode funcionar enquanto uma extensão antiga, um utilitário de dispositivo ou uma dependência compilada impede o projeto. Um aplicativo emulado não é automaticamente inutilizável, mas merece sua própria verificação funcional e de desempenho.
Da mesma forma, o suporte a CUDA deve levar a uma pergunta específica: a versão do pacote ou fluxo de que você precisa oferece suporte a esta plataforma e configuração? Não presuma que todo tutorial NVIDIA para desktop funcionará sem mudanças. Formatos de modelos, operações compatíveis e distribuição de software podem ser tão decisivos quanto o nome do acelerador.
A análise separada do ProArt GR1X pelo Windows Central oferece outra avaliação independente para comparar com o Tom’s Guide. Leia as condições de teste e a conclusão de cada publicação, em vez de juntar medições diferentes em uma pontuação inventada. Duas análises independentes são úteis porque podem revelar prioridades distintas de compra; elas não eliminam a necessidade de testar seu aplicativo essencial.
O local muda a conta, mas não a apaga
Executar inferência compatível localmente pode evitar a cobrança por token de uma API remota para aquela inferência. Também transfere mais custos para o dispositivo, a eletricidade, o armazenamento e o tempo gasto na operação. Ferramentas do agente conectadas à Internet ou serviços externos ainda podem ter suas próprias cobranças.
Para uma máquina que fica sempre ligada, meça a potência na tomada em pelo menos três estados: ociosa, durante uma tarefa representativa do modelo e na carga mista normal mais intensa. A especificação de potência de um componente não é uma medição na tomada, e um pico curto não é uma conta mensal de energia.
A aritmética é simples quando você tem uma diferença medida. Um acréscimo médio de 10 watts durante um ano inteiro corresponde a 87,6 kWh: 0,010 kW multiplicado por 24 horas e 365 dias. É um exemplo de cálculo, não a afirmação de que esses PCs diferem em 10 watts. Multiplique a energia medida pela sua própria tarifa e pelas horas de funcionamento.
O preço de compra geralmente merece um tratamento igualmente explícito. Distribua o custo do dispositivo pelo período em que espera mantê-lo, inclua o armazenamento e o backup realmente necessários e depois compare o número de tarefas úteis concluídas. Se uma máquina mais barata já atende à carga, um equipamento premium mais rápido precisa oferecer benefício suficiente para justificar a diferença. Se um fluxo compatível poupa esforço repetido considerável, esse pode ser um argumento mais forte do que um teste isolado de chat.
Evite também a armadilha oposta: comprar pelo menor preço e depois passar semanas substituindo software incompatível. O tempo gasto reconstruindo as ferramentas faz parte da compra, mesmo que nunca apareça na nota.
Use o prazo de devolução a seu favor
Um teste de compra útil deve ser pequeno o suficiente para terminar enquanto a compra ainda pode ser revertida. Prepare-o antes do pedido para que a primeira semana seja dedicada a avaliar o fluxo, em vez de reunir seus ingredientes.
- Escolha três trabalhos que representem a finalidade da máquina. Por exemplo, execute uma tarefa de programação local com uma suíte de testes existente, uma resposta sobre um documento longo com fatos conhecidos e um grafo específico de geração de imagens. Mantenha os mesmos prompts e materiais de origem entre os sistemas candidatos.
- Registre a configuração exata. Inclua checkpoint do modelo, quantização, comprimento do contexto, versão do ambiente de execução, driver, versões dos aplicativos e modo de energia. Números de parâmetros iguais não bastam para uma comparação significativa.
- Separe o comportamento a frio e a quente. Meça o primeiro carregamento do modelo e a solicitação seguinte. Não compare uma execução em cache em uma máquina com a primeira inicialização na outra.
- Avalie o resultado concluído. Verifique se o código passa nos testes pretendidos, se a resposta documental preserva os fatos necessários e se o fluxo criativo produz o arquivo esperado com todos os nós exigidos.
- Acrescente o trabalho normal em segundo plano. Mantenha abertos os aplicativos que pretende usar. Observe pressão de memória, capacidade de resposta, comportamento das ventoinhas e eventuais solicitações com falha em uma sessão representativa.
- Meça a sessão completa. Registre tempo total, potência na tomada se tiver um medidor adequado, falhas e intervenção manual. Decida com base nos critérios que escreveu antes de ver o resultado mais rápido.
Uma resposta mais lenta que produz o resultado correto de forma confiável pode ser uma compra melhor do que uma resposta rápida que exige correções repetidas. O contrário também pode ocorrer quando a compatibilidade ou a taxa de processamento é o gargalo. O teste deve mostrar para qual situação você está comprando.
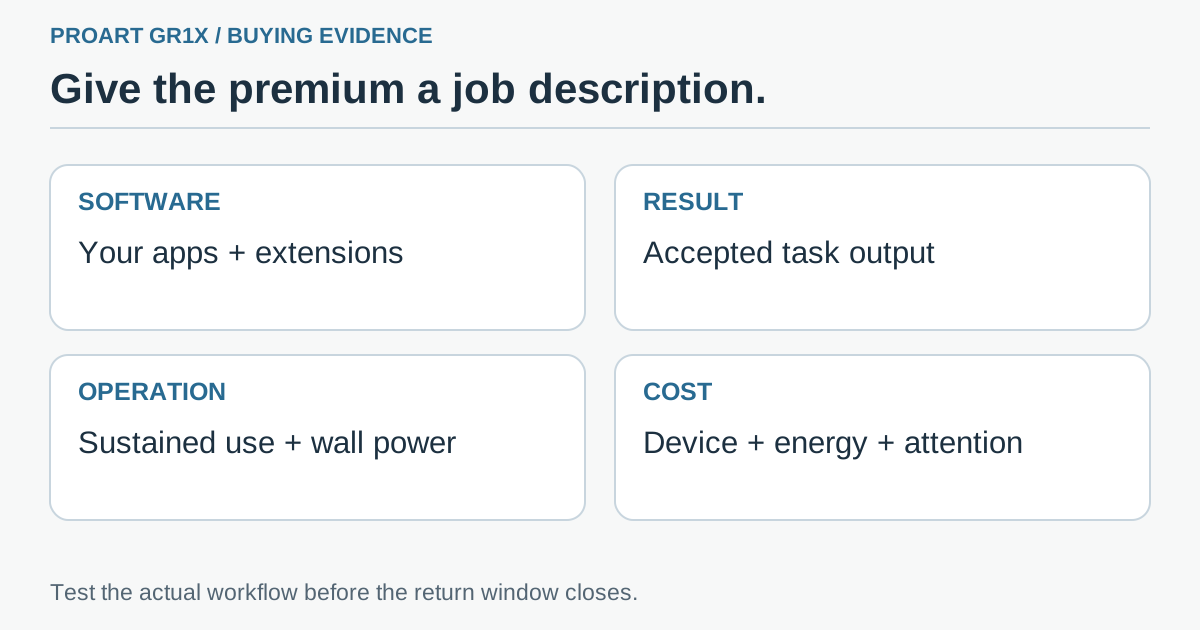 Lista de avaliação original: verifique compatibilidade dos aplicativos, resultados aceitos, operação sustentada e custo completo da carga pretendida antes do fim do prazo de devolução.
Compre o trabalho realizado, não a etiqueta de 128 GB
Os novos anúncios de vendas tornam o RTX Spark uma opção concreta de desktop, e as análises independentes acrescentam evidências além dos números máximos dos fabricantes. No ProArt GR1X, a comparação publicada com Qwen 3.8 27B mostra saída mais rápida e esperas iniciais menores nas tarefas testadas. A configuração de 128 GB avaliada também tem um preço americano elevado.
Nossa visão de compra é começar pelo gargalo que você consegue identificar. Se precisa de um fluxo criativo específico acelerado por RTX, teste esse fluxo. Se precisa de um assistente geral ágil, compare a interação e as respostas aceitas com alternativas mais baratas. Se a máquina funcionará sem supervisão, inclua confiabilidade sustentada e energia.
A memória é o tamanho da bancada, não o valor do trabalho que sai dela. O preço extra torna-se defensável quando as tarefas que importam para você, e não apenas a ficha técnica, o justificam.
Fontes e mídia oficial
- Anúncio de disponibilidade do ASUS ProArt GR1X: página de 19 de novembro; texto do anúncio de 18 de novembro de 2026.
- Anúncio de vendas de desktops RTX Spark da NVIDIA, 18 de novembro de 2026.
- Tom’s Guide: preços nos EUA e comparação Qwen 3.8 27B / LM Studio.
- Windows Central: uma análise separada do ProArt GR1X.
- Imagem oficial do produto ASUS. Fotografias e gráficos das análises permanecem com seus editores originais; os infográficos de compra incluídos aqui são originais.

A tabela reproduz fatos numéricos atribuídos, não o gráfico de uma publicação. Os testes de compra e o exemplo de energia são análises propostas, não medições dessas unidades avaliadas.
Recomendação Telli.sh: Guarde juntos os orçamentos, as configurações exatas e os resultados aceitos das tarefas para que sua próxima decisão de hardware comece com evidências reutilizáveis. Crie sua primeira nota com o Telli.sh.