Không ai nói tháng Chín: chín phút rà soát mà mọi bản tóm tắt cuộc họp bằng AI đều cần
Nghiên cứu về tóm tắt bản ghi cuộc họp cho thấy 30,4% bản tóm tắt do mô hình tạo ra từ biên bản họp hội đồng thành phố chứa ít nhất một lỗi sự kiện, và phía sau là bảy loại lỗi có tên gọi rõ ràng. Hướng dẫn thực tế để rà soát ghi chú AI đối chiếu với chính bản ghi của nó: kiểm tra gì, theo thứ tự nào, và nên nói gì trong phòng họp để việc rà soát chỉ mất chín phút thay vì ba mươi.
Bản tóm tắt dài ba đoạn, bố cục gọn gàng, và sai đúng một câu: nhóm đã thống nhất phát hành đợt chuyển đổi vào tháng Chín.
Không ai thống nhất điều đó. Có người nói rằng tháng Chín chắc là kịp nếu nhà cung cấp phản hồi đúng hạn — một câu điều kiện, nói đúng một lần, giữa lúc câu chuyện đang lạc sang chủ đề khác. Mô hình bỏ mất mệnh đề điều kiện, nâng một phỏng đoán lên thành quyết định, và bản ghi chú được gửi tới mười một người không có mặt trong phòng. Hai người trong số đó bắt đầu lên kế hoạch theo mốc tháng Chín.
Chuyện này chẳng có gì lạ. Đó là một trong những hành vi được ghi nhận kỹ nhất của các hệ thống tóm tắt tự động, có hẳn tên gọi trong tài liệu nghiên cứu, và sẽ không biến mất chỉ vì mô hình đời sau lớn hơn. Bài viết này mang lại ba thứ: bảy cách một bản tóm tắt lệch khỏi những gì thực sự được nói, quy trình rà soát chín phút bắt được cả bảy, và vài câu nói ngay trong cuộc họp giúp rút ngắn việc rà soát đó.
Tóm tắt nhanh:
- Trong bộ đánh giá TofuEval (NAACL 2024), 30,4% bản tóm tắt sinh ra từ biên bản họp hội đồng thành phố có thật chứa ít nhất một lỗi sự kiện; với các chủ đề rìa — những đoạn lạc chuyện — con số lên tới 43,6%.
- Lỗi không phải nhiễu ngẫu nhiên. Các nhà nghiên cứu phân loại chúng thành bảy loại có tên, và hai loại gây hại nhất cho cuộc họp là trình bày ý kiến như sự thật và dịch chuyển thì và tình thái — đúng chỗ mà "có thể sẽ" biến thành "sẽ".
- Bạn cũng không thể giao việc kiểm tra ngược lại cho mô hình: trên FaithBench (tháng 10/2024), những bộ phát hiện ảo giác tốt nhất chỉ đạt độ chính xác quanh mức 50%, còn trong TofuEval, các mô hình ngôn ngữ đóng vai người chấm đã thua những chỉ số chuyên dụng nhỏ hơn.
Ảnh: Shixart1985, Wikimedia Commons, CC BY 2.0. Cặp kính mới là điểm mấu chốt. Rốt cuộc vẫn phải có người đọc.
Việc thu âm đã xong. Việc kiểm tra thì chưa từng bắt đầu.
Thử đếm số công cụ ghi chú cuộc họp ra mắt trên Hacker News trong sáu tháng qua: ít nhất mười lăm cái từ ngày 1/3 đến 13/8/2026. Bộ chuyển giọng nói chạy ngay trên máy, sổ ghi chú không cần bot vào phòng họp, trình nhập dữ liệu cho Obsidian, các bản sao mã nguồn mở của Granola. Tất cả đều mang cùng hai tính năng: thu âm và tạo bản tóm tắt.
Không cái nào mang bước thứ ba — bước duy nhất cần đến phán đoán. Bản tóm tắt vào hộp thư của bạn đã được định dạng sẵn, đã tự tin sẵn, đã gửi cho cả phòng họp. Điều mà quy trình ấy ngầm khẳng định chỉ có một: sản phẩm này đã xong.
Điểm mấu chốt là đây: bản tóm tắt do mô hình sinh ra không phải là hồ sơ của cuộc họp. Nó là một lời phát biểu về cuộc họp, do một hệ thống không chịu trách nhiệm về tính đúng đắn tạo ra, và nên được đọc như mọi lời thuật lại gián tiếp khác — nghĩa là đối chiếu với bằng chứng mà nó sinh ra từ đó.
May thay, bằng chứng nằm ngay bên cạnh. Chính công cụ tạo ra bản tóm tắt cũng đã tạo ra bản ghi, và việc đối chiếu hai thứ mất ít thời gian hơn phần giới thiệu đầu buổi họp.
Con số nên thay đổi cách bạn đọc ghi chú
TofuEval, do các nhà nghiên cứu ở Salesforce AI cùng cộng sự công bố tại NAACL 2024, là thứ gần nhất với một phép đo có kiểm soát mà chúng ta có về vấn đề này. Họ lấy hai kho ngữ liệu hội thoại — một là phỏng vấn báo chí, một tên MeetingBank gồm biên bản họp hội đồng thành phố có thật ở Mỹ — cho năm mô hình ngôn ngữ viết tóm tắt theo chủ đề, rồi thuê các nhà ngôn ngữ học chuyên nghiệp gán nhãn từng câu tóm tắt theo mức độ nhất quán với nguồn.
Trên biên bản cuộc họp, tính trung bình năm mô hình, 30,4% bản tóm tắt về chủ đề chính chứa ít nhất một điểm không nhất quán với sự kiện, và con số tăng lên 43,6% với chủ đề rìa. Bài báo nói thẳng: trừ GPT-3.5-Turbo, "khoảng 40–50% bản tóm tắt của chúng chứa ít nhất một điểm không nhất quán".
Nói cho sòng phẳng: năm mô hình đó thuộc thế hệ 2023 — Vicuna, ba cỡ WizardLM và GPT-3.5-Turbo — và các mô hình tiên phong hôm nay đã tốt hơn đáng kể về độ trung thành với sự kiện. Nhưng có hai phát hiện trong cùng bài báo vượt qua được phản biện đó, và đó chính là hai điều ảnh hưởng tới ngày thứ Ba của bạn.
Thứ nhất, quy mô không giải quyết vấn đề một cách đáng tin. Trên dữ liệu cuộc họp, tỷ lệ lỗi của WizardLM-30B chỉ thấp hơn WizardLM-7B 3,8 điểm phần trăm, dù lớn hơn gấp bốn lần; ở một số so sánh, mô hình lớn hơn trong cùng dòng lại tạo ra nhiều lỗi hơn. Thứ hai, số lỗi không có quan hệ đáng kể với độ dài bản tóm tắt (hệ số tương quan Pearson ρ = 0,18). Bản tóm tắt dài và chi tiết hơn không phải là bản an toàn hơn. Ngồi chờ mô hình lớn hơn không phải là một quy trình rà soát.
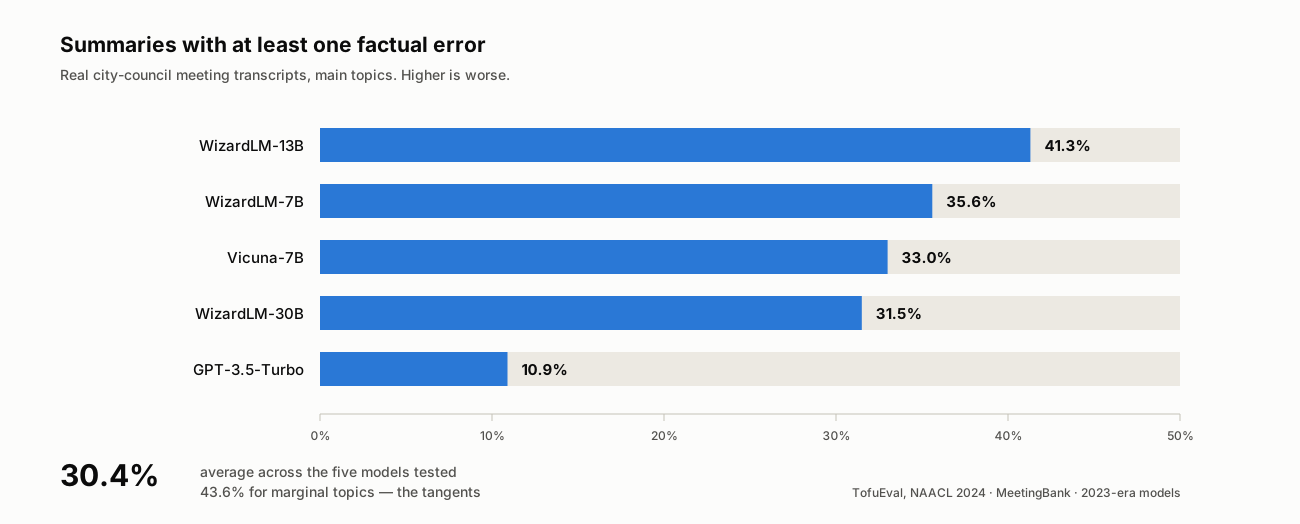
Tỷ lệ bản tóm tắt từ biên bản họp hội đồng thành phố có thật chứa ít nhất một lỗi sự kiện, chỉ tính chủ đề chính. Nguồn: TofuEval, Tang và cộng sự, NAACL 2024 (arXiv:2402.13249). Các mô hình được thử nghiệm thuộc thế hệ 2023; những loại lỗi bên dưới thì sống lâu hơn chúng.
Bảy cách một bản tóm tắt lệch khỏi phòng họp
Thứ hữu ích nhất trong bài báo đó không phải con số phần trăm, mà là bảng phân loại: bảy loại lỗi có tên, được những người gán nhãn rút ra từ hàng nghìn câu bị đánh dấu, mở rộng từ một bảng phân loại trước đó xây trên hội thoại ngắn.
Đọc một lần thôi, rồi bạn sẽ bắt đầu nhìn thấy chúng trong chính ghi chú của mình. Vì đó không phải trục trặc ngẫu nhiên, mà là những con đường cụ thể, lặp đi lặp lại, theo đó việc nén lời nói thành văn viết xóa mất một phân biệt mà cả phòng họp đang dựa vào.
| Loại lỗi (TofuEval) | Trông thế nào trong ghi chú cuộc họp | Cách bắt |
|---|---|---|
| Thông tin ngoại lai | Một chi tiết có trong bản tóm tắt mà không có ở đâu trong audio — một con số, tên khách hàng, một lý do không ai nêu ra | Tìm danh từ riêng hoặc con số đó trong bản ghi; không có kết quả nghĩa là nó được bịa ra |
| Quy sai người | Quyết định đúng nhưng gán cho sai người, hoặc phản đối của người này bị ghi thành của người kia | Nhảy tới mốc thời gian và xem ai đang nói |
| Biến ý kiến thành sự thật | "Việc đổi giá sẽ làm tăng tỷ lệ rời bỏ" trong khi ai đó chỉ lo rằng có thể như vậy | Tìm từ giảm nhẹ trong bản gốc: nghĩ rằng, lo rằng, ngờ rằng |
| Lỗi suy luận | Tính toán sai, hoặc một quan hệ nhân quả mà phòng họp chưa bao giờ vạch ra | Tính lại mọi con số; hỏi xem chữ "vì" đó được nói ra hay được suy ra |
| Thì / thể / tình thái | "Chúng ta có thể phát hành tháng Chín" thành "chúng ta sẽ phát hành tháng Chín" | Đối chiếu mọi động từ tương lai với từ tình thái trong bản gốc |
| Mâu thuẫn | Mất một phủ định: "chúng ta không dời hạn chót" thành "chúng ta dời hạn chót" | Tìm không, chưa bao giờ, trừ khi quanh khẳng định đó |
| Trượt nghĩa tinh vi | "đưa ra khuyến nghị" bị viết lại thành "đưa ra yêu cầu" | So động từ trong bản tóm tắt với động từ trong nguồn |
Ba loại trong đó dễ nhận ra nhất khi nhìn vào vật chứng. Dưới đây là từng loại, với bản ghi và câu trong bản tóm tắt đặt cạnh nhau.
Mất một phủ định — lỗi mâu thuẫn. Điều đã nói trong phòng họp:
DANIEL (00:31:12): Tức là ngày ra mắt thì mình không dời. Mọi thứ khác
có đổi thì đổi, ngày đó giữ nguyên.
Điều bản tóm tắt viết ra:
Nhóm đã thống nhất dời ngày ra mắt.
Mất đúng một từ, và câu này giờ chỉ đạo hành động ngược lại. Nó lại đúng ngữ pháp hoàn hảo, đúng vì thế mà đọc soát trượt qua nó, trong khi tìm chữ "không" quanh chỗ ra quyết định thì bắt được trong bốn giây.
Quy sai người — lỗi tham chiếu. Điều đã nói trong phòng họp:
PRIYA (00:18:40): Em phản đối tính giá theo chỗ ngồi. Quý trước hai
khách hàng doanh nghiệp nói với mình là làm vậy thì hỏng hợp đồng.
MINA (00:18:55): Vâng, em đồng ý.
Điều bản tóm tắt viết ra:
Mina phản đối cách tính giá theo chỗ ngồi, dẫn phản hồi từ khách hàng
doanh nghiệp.
Mọi dữ kiện trong câu đó đều có trong bản ghi. Chỉ con người là không. Toàn bộ cái khó nằm ở đây: bạn không bắt được lỗi này bằng cách hỏi các khẳng định có đúng không, mà chỉ bằng cách hỏi chúng có thuộc về đúng người bị gán hay không.
Một phỏng đoán được nâng cấp — lỗi tình thái. Điều đã nói trong phòng họp:
SAM (00:44:02): Tháng Chín chắc là kịp, nếu nhà cung cấp phản hồi cho
mình đúng hạn.
Điều bản tóm tắt viết ra:
Nhóm đã thống nhất phát hành đợt chuyển đổi vào tháng Chín.
Hai từ hạn định bị bỏ đi — chữ "chắc là" và trọn mệnh đề điều kiện — và một phỏng đoán chung biến thành cam kết có kèm ngày. Không ai cần nói dối để chuyện đó xảy ra. Chính việc nén đã làm.
Hai loại trong đó đáng chú ý đặc biệt, vì chúng khiến các nhóm mất tiền thật.
Biến ý kiến thành sự thật chính là sự cố tháng Chín ở đầu bài. Trong cuộc họp, phần lớn câu nói đều có từ giảm nhẹ — người ta đang nghĩ thành tiếng, và chính từ giảm nhẹ gánh toàn bộ ý nghĩa. Mô hình tóm tắt loại bỏ từ giảm nhẹ theo thiết kế, vì khi nén văn bản thì đó là thứ bị cắt đầu tiên. Kết quả đọc lên quả quyết hơn thực tế phòng họp, và đó chính là lý do không ai chất vấn nó.
Dịch chuyển tình thái gây thiệt hại y hệt với các mốc thời gian. "Có thể", "nên", "chắc là" và "nếu nhà cung cấp phản hồi" là ranh giới giữa một kế hoạch và một cam kết, đồng thời cũng là những từ rẻ nhất để bỏ đi. Một bản tóm tắt nói rằng nhóm sẽ làm gì đó vào tháng Chín đã lặng lẽ chế tạo ra một hạn chót không ai đứng tên.
Để ý điểm chung của cả hai. Mô hình không bịa sự kiện từ hư không: nó gỡ bỏ những từ hạn định. Đó là chỉnh sửa ít lộ liễu nhất mà nó có thể làm, và là chỉnh sửa mà không độc giả nào phát hiện được nếu không có bản gốc trước mặt.
Chuyện bịa xảy ra ở những đoạn lạc đề
Trong dữ liệu còn một mẫu hình thứ hai, khớp chính xác với cách các cuộc họp diễn ra.
Bản tóm tắt về chủ đề rìa — những thứ được nhắc lướt qua thay vì bàn kỹ — tệ hơn hẳn: 43,6% so với 30,4% trên kho dữ liệu cuộc họp. Các nhà nghiên cứu giải thích cơ chế: khi một chủ đề gần như không được đề cập trong nguồn, mô hình "dựa vào kiến thức của chính nó để suy đoán về chủ đề đó, mang thông tin không có căn cứ vào bản tóm tắt". Chỗ nào bằng chứng mỏng thì được trám bằng kiến thức chung, và phần trám ấy không thể phân biệt về giọng điệu với những phần thực sự có căn cứ.
Cuộc họp của bạn đầy chủ đề rìa: hai phút nói về đợt rà soát bảo mật, nhà cung cấp được nhắc đúng một lần, con số mà ai đó nhớ mang máng. Những dòng ấy được bàn ít nhất và dễ sai nhất, mà lại đọc trơn tru y như phần còn lại.
Tầng bên dưới cũng cùng hình dạng. Trong "Careless Whisper", trình bày tại ACM FAccT 2024, Koenecke và cộng sự phát hiện khoảng 1% bản chuyển văn bản của Whisper chứa nguyên cả cụm từ hoặc câu ảo giác không tồn tại dưới bất kỳ dạng nào trong audio gốc, và 38% những ảo giác đó mang tổn hại rõ rệt: liên hệ bịa đặt, quyền uy giả, bạo lực dựng lên. Điều thú vị là yếu tố kích hoạt: ảo giác xuất hiện nhiều bất thường ở những người nói có các quãng không phát âm dài hơn.
Nói cách khác là im lặng. Mà cuộc họp thì được làm từ im lặng: khoảng ngừng để suy nghĩ, lúc ai đó bật lại micro, khi màn hình chia sẻ đang tải, bốn giây sau một câu hỏi khó. Đó đúng là loại nguyên liệu mà mô hình chuyển giọng nói dễ lấp đầy nhất bằng thứ chưa từng được nói. Điều này cũng có nghĩa lỗi bản ghi và lỗi tóm tắt không độc lập với nhau: một dòng bịa trong bản ghi lại là đầu vào "hoàn toàn có căn cứ" dưới mắt bản tóm tắt.
Bạn không thể giao việc kiểm tra ngược lại cho mô hình
Ý tưởng hiển nhiên là để mô hình thứ hai kiểm tra mô hình thứ nhất. Các con số đo được không mấy khích lệ.
Cũng trong nghiên cứu TofuEval, các tác giả đánh giá mô hình ngôn ngữ trong vai người phán xét nhị phân về tính nhất quán sự kiện, và thấy rằng tất cả, kể cả GPT-4, "hoạt động kém trong việc phát hiện lỗi ở các bản tóm tắt do mô hình ngôn ngữ sinh ra" — thua cả những chỉ số nhỏ hơn, không dựa trên mô hình ngôn ngữ, được xây riêng cho nhiệm vụ này. Ngay cả khi GPT-4 đánh dấu đúng một câu, phần giải thích vì sao của nó cũng chỉ đúng khoảng 80% số lần; với các bộ đánh giá khác thì chừng một nửa.
FaithBench, do Vectara phát hành tháng 10/2024, đặt một con số cho trần này. Nó gom các ảo giác do mười mô hình ngôn ngữ hiện đại thuộc tám dòng tạo ra mà các bộ phát hiện hiện có bất đồng ý kiến, rồi báo cáo rằng ngay cả bộ phát hiện ảo giác tốt nhất cũng chỉ đạt độ chính xác gần 50%. Tung đồng xu, đúng ở những ca quan trọng nhất.
Vậy nên việc rà soát là của bạn. Nghe như gánh nặng, cho tới khi bạn nhận ra sự bất đối xứng: bộ phát hiện phải phán xét một văn bản bất kỳ dựa trên tài liệu nó chưa từng biết, còn bạn thì đã ngồi trong phòng đó. Bạn vốn đã biết khẳng định nào nghe kỳ kỳ. Chỉ cần đi kiểm chứng nó thôi.
Ba sản phẩm, ba nhiệm vụ khác nhau
Phần lớn tranh luận "ghi chú AI so với ghi chú thật" là lỗi phạm trù. Một cuộc họp tạo ra ba sản phẩm, chúng không thay thế cho nhau, và nhóm nào chỉ giữ một thứ thì luôn mất đi một điều cụ thể.
| Bản ghi thô | Tóm tắt AI | Nhật ký quyết định | |
|---|---|---|---|
| Giữ nguyên câu chữ | Có — nguyên văn | Không — bị nén, từ giảm nhẹ rơi mất | Không |
| Ai đã nói | Có, nếu tách được người nói | Đôi khi; quy sai người là một loại lỗi có tên | Có — người chịu trách nhiệm là trọng tâm |
| Nói lúc nào | Có — kèm mốc thời gian | Hiếm khi | Chỉ có hạn chót |
| Quyết định kèm người phụ trách và ngày | Chôn trong khoảng 9.000 từ | Một phần, và không đáng tin | Có — đây là nhiệm vụ duy nhất của nó |
| Đã loại bỏ gì, và vì sao | Có, nếu có ai nói ra | Thường bị cắt vì cho là thừa | Có, trong một dòng |
| Đọc xong trong 60 giây | Không | Có | Có |
| Có thể đối chiếu với bằng chứng | Nó chính là bằng chứng | Chỉ khi bản ghi còn được giữ | Chỉ khi cả hai còn được giữ |
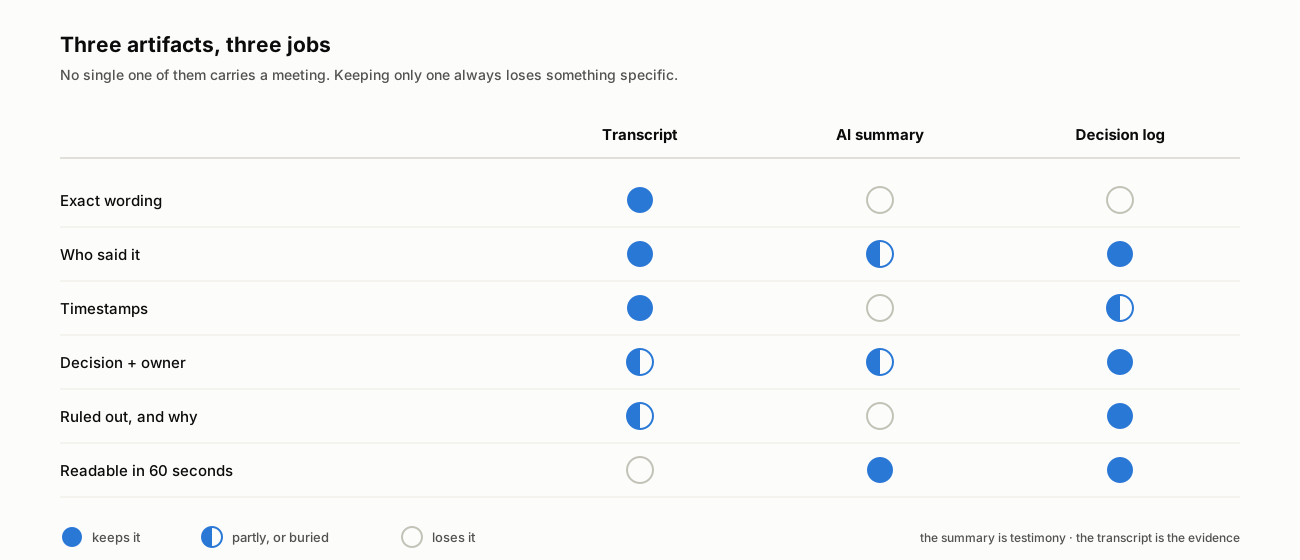
Mỗi sản phẩm giữ được gì, giữ một phần gì, và mất gì. Hàng dưới cùng mới là hàng quyết định hai thứ kia có giá trị hay không.
Hàng dưới cùng chính là toàn bộ lập luận. Một bản tóm tắt không còn bản ghi đi kèm là thứ không thể phản bác: khi đồng nghiệp nói "chúng ta đâu có thống nhất như vậy", bạn có hai ý kiến và không có hồ sơ nào. Đây đúng là chỗ ghi chú AI mong manh hơn ghi chú của người: biên bản do người viết mang sẵn sự sai sót lộ thiên, và ai cũng đọc nó với mức nghi ngờ vừa phải. Văn máy thì đến với tiêu đề gọn gàng và những câu khẳng định chắc nịch, mượn lấy uy tín mà nó chưa hề kiếm được.
Cứ gọi đúng tên: bản tóm tắt là lời khai, còn bản ghi là bằng chứng. Lời khai thì hữu ích. Lời khai cũng là thứ người ta đem đi đối chiếu.
Chín phút rà soát, theo thứ tự
Đây là quy trình chúng tôi khuyến nghị, tính giờ cho một cuộc họp 60 phút. Thứ tự rất quan trọng: nó đặt lên trước những phần kiểm tra mà sai sẽ tốn kém nhất, để nếu bạn bị gián đoạn ở phút thứ tư thì các lỗi đắt giá đã được bắt xong.
- 0:00–1:30 — Chỉ đọc các câu quyết định. Ở lượt đầu, bỏ qua hoàn toàn phần tóm tắt kể chuyện. Tìm mọi câu khẳng định một kết quả, một cam kết hoặc một mốc thời gian. Trong một cuộc họp 60 phút điển hình có từ ba đến sáu câu như vậy. Chỉ những dòng đó mới có người đem đi làm.
- 1:30–3:00 — Khôi phục tình thái. Với từng câu ấy, nhảy tới đúng vị trí trong bản ghi và kiểm tra động từ. Người ta nói sẽ, hay nói có thể, nên, chắc là? Nếu bản gốc có từ giảm nhẹ, hãy viết lại dòng tóm tắt kèm từ giảm nhẹ đó — hoặc tốt hơn, đánh dấu nó thành câu hỏi còn treo, có người phụ trách.
- 3:00–4:30 — Kiểm tra mọi danh từ riêng và mọi con số. Tên người, công ty, phiên bản, giá, ngày tháng, phần trăm. Tìm từng thứ trong bản ghi. Thứ nào không có ở đó là thông tin ngoại lai: xóa đi hoặc xác nhận ngoài cuộc họp. Đây là việc của ô tìm kiếm, không phải việc đọc.
- 4:30–5:30 — Xác minh việc quy trách nhiệm. Với mỗi quyết định và mỗi ý kiến phản đối, xác nhận ai đang nói tại mốc thời gian đó. Quy sai người là loại lỗi dễ gây rắc rối giữa con người hơn là rắc rối kế hoạch, và cũng là loại kiểm tra nhanh nhất.
- 5:30–6:30 — Săn những phủ định bị rơi. Tìm trong bản ghi các từ không, đừng, chưa bao giờ, trừ khi, thay vì quanh mỗi quyết định. Lỗi mâu thuẫn lật ngược ý nghĩa trong khi câu vẫn đúng ngữ pháp hoàn hảo, nên đọc soát sẽ không thấy — phải tìm kiếm mới thấy.
- 6:30–8:00 — Hỏi xem thiếu gì. Đây là bước không công cụ nào làm thay bạn được, vì một bản tóm tắt không thể tự đánh dấu chỗ nó bỏ sót. Hai câu hỏi: chúng ta đã loại bỏ điều gì, và vì sao? Và câu hỏi nào chúng ta chưa trả lời được? Cả hai đều không sống sót qua quá trình nén, và cả hai đều là thứ làm cho ghi chú còn hữu ích sau sáu tháng.
- 8:00–9:00 — Viết nhật ký quyết định và gửi đi. Từ ba đến sáu dòng, mỗi dòng ghi rõ đã quyết gì, ai lo bước tiếp theo, và hạn đến khi nào. Gắn liên kết tới bản ghi. Chính liên kết đó khiến toàn bộ phần rà soát có thể được người khác kiểm lại.
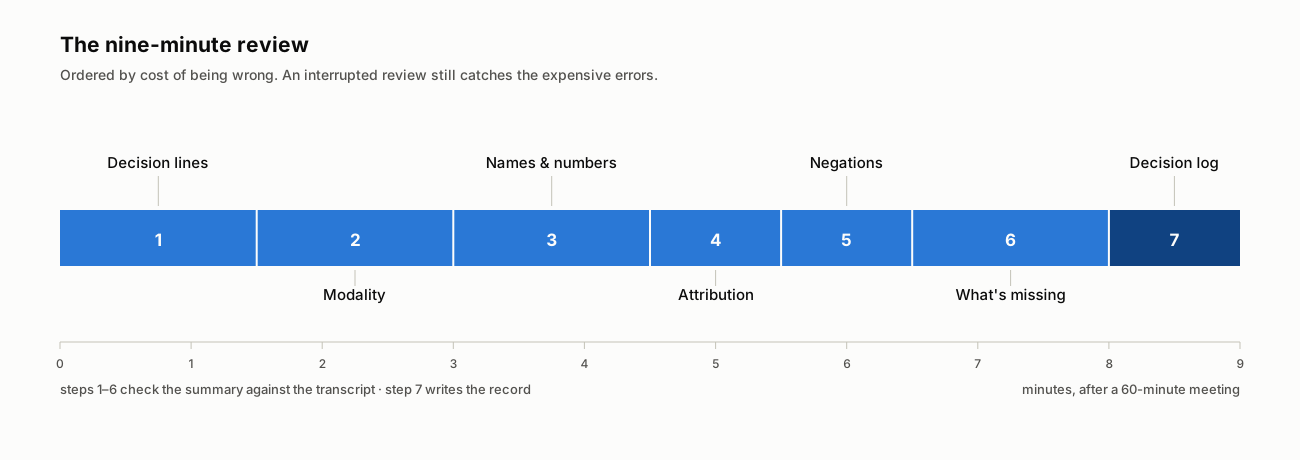
Thứ tự chính là thiết kế: tình thái và chi tiết bịa đặt trước, phần bỏ sót để cuối. Một lượt rà soát bị ngắt quãng vẫn bắt được các lỗi đắt giá.
Hai lưu ý để làm được đều đặn. Nếu cuộc họp dài 30 phút thì đây là việc bốn phút. Và nếu bạn làm ngay trong công cụ giữ cả bản tóm tắt lẫn bản ghi có mốc thời gian, thì bước 2 đến bước 5 chỉ còn là tìm kiếm và nhấp chuột thay vì chuyển qua lại giữa các cửa sổ — đó chính là khác biệt giữa một thói quen sống sót qua tuần bận rộn và một thói quen thì không.
Mười giây trong phòng họp tiết kiệm năm phút rà soát
Việc rà soát sẽ ngắn đi rất nhiều nếu bản ghi âm gốc vốn đã chứa thông tin đó. Mô hình không thể khôi phục điều không ai nói ra, và phần lớn những gì làm ghi chú trở nên mơ hồ vốn chưa bao giờ có trong audio.
- Mở đầu bằng câu hỏi, nói to lên. "Hôm nay ta quyết định đợt chuyển đổi ra trước hay sau hội nghị." Một câu hỏi được nói ra sẽ cho mô hình một chủ đề chính thay vì một mớ chủ đề rìa — mà chủ đề rìa chính là phía 43,6%.
- Nói quyết định thành một câu, kèm tên và ngày, trước khi có ai rời phòng. "Chốt: Mina lo phần theo dõi với nhà cung cấp, và ta xác nhận mốc tháng Chín trước ngày 25." Mọi công cụ ghi chú trên thị trường đều bắt câu này hoàn hảo. Không công cụ nào nghĩ hộ bạn câu đó.
- Nói phủ định một cách rõ ràng. "Chúng ta không dời ngày ra mắt" an toàn hơn một cái nhún vai kèm gật đầu, vì phủ định bị rơi là loại lỗi đã được ghi nhận — còn phủ định chưa từng được nói ra thì chẳng có gì để rơi.
- Nêu trong một dòng những gì đã bị bác và vì sao. "Chúng ta có cân nhắc tính giá theo chỗ ngồi nhưng bỏ, vì quý trước hai khách hàng doanh nghiệp phản đối." Đây chính là câu ngăn cuộc tranh luận cũ mở lại sau sáu tháng.
- Đánh vần một lần các danh từ riêng lạ. Tên nhà cung cấp, mật danh nội bộ và từ viết tắt đúng là thứ bản ghi hay làm hỏng, rồi bản tóm tắt lặp lại đầy tự tin.
- Đừng để im lặng lên tiếng. Nếu cả phòng im vì mọi người đang đọc tài liệu, hãy nói ra điều đó. Các quãng dài không phát âm chính là điều kiện khiến mô hình chuyển giọng nói ảo giác nhiều nhất.
Không có gì trong số này là diễn kịch phòng họp. Đó là đọc cho hồ sơ chép lại — một kỹ năng trở nên có giá hơn kể từ khi hồ sơ bắt đầu tự viết ra.
Điểm mấu chốt
Bản tóm tắt cuộc họp do AI viết không phải là hồ sơ. Nó là lời khai về một hồ sơ, được trình bày trôi chảy, bởi một nhân chứng chẳng mất gì nếu sai và có xu hướng đã được ghi nhận là hay đánh rơi chữ "chắc là".
Cách định nghĩa lại đó khép lại cuộc tranh luận thủ công-hay-AI, vốn chưa bao giờ là tranh luận thật. Hãy giữ bản ghi âm, vì đó là bằng chứng duy nhất. Hãy để mô hình viết bản tóm tắt, vì nó nhanh hơn bạn và đến phút thứ bốn mươi vẫn không chán. Rồi dành chín phút cho phần duy nhất đòi hỏi phải có mặt: đối chiếu những câu chắc nịch với những gì thực sự được nói, và viết ra ba dòng mà ai đó phải hành động.
Những nhóm bị bỏng tay năm 2026 không phải là nhóm bỏ qua công cụ ghi chú AI. Đó là những nhóm đọc đầu ra của nó như thể đó là bản ghi, trong khi thực chất là một bản diễn giải — và không giữ lại bản ghi vốn có thể chỉ ra khác biệt ấy. Phiên bản đầy đủ hơn về những gì một ghi chú tốt phải mang theo nằm ở sáu thứ mà ghi chú cuộc họp vẫn cần có, còn lý do tỷ lệ lỗi từ hầu như không nói lên điều gì về việc bản ghi có dùng được hay không nằm ở chính xác thôi thì chưa đủ.
Telli.sh đứng ở đâu: chín phút rà soát chỉ hiệu quả khi bản tóm tắt và nguồn nằm cùng một chỗ. Telli.sh giữ bản ghi có mốc thời gian kèm nhận diện người nói ngay cạnh bản tóm tắt AI có thể chỉnh sửa, nên việc kiểm chứng một khẳng định chỉ là một lần tìm kiếm và một cú nhấp, thay vì lục lọi giữa hai hệ thống — và khi phòng họp không nói cùng một ngôn ngữ, bản dịch nằm bên cạnh bản gốc chứ không thay thế nó. Bản tóm tắt đến như một bản nháp để bạn sửa, không phải một kết quả để bạn chấp nhận.
Nguồn
- Tang và cộng sự, "TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization", NAACL 2024 (arXiv:2402.13249, 20/2/2024)
- Koenecke và cộng sự, "Careless Whisper: Speech-to-Text Hallucination Harms", ACM FAccT 2024 (arXiv:2402.08021, 12/2/2024)
- Bao và cộng sự, "FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs", Vectara (arXiv:2410.13210, 17/10/2024)
- Hu và cộng sự, "MeetingBank: A Benchmark Dataset for Meeting Summarization", ACL 2023 (arXiv:2305.17529, 27/5/2023)
- Wang và cộng sự, "Analyzing and Evaluating Faithfulness in Dialogue Summarization", EMNLP 2022 (arXiv:2210.11777, 21/10/2022)
- Trang ảnh trên Wikimedia Commons
