ไม่มีใครพูดว่าเดือนกันยายน: ตรวจทานสรุปการประชุมจาก AI ให้จบใน 9 นาที
งานวิจัยด้านการสรุปบทถอดเสียงการประชุมพบว่า 30.4% ของสรุปที่โมเดลสร้างจากบทถอดเสียงการประชุมสภาเมืองมีข้อผิดพลาดเชิงข้อเท็จจริงอย่างน้อยหนึ่งจุด และเบื้องหลังคือความผิดพลาดเจ็ดประเภทที่มีชื่อเรียกชัดเจน คู่มือปฏิบัติสำหรับตรวจทานบันทึกการประชุมที่ AI สร้าง เทียบกับบทถอดเสียงการประชุมของมันเอง ว่าต้องตรวจอะไร เรียงลำดับอย่างไร และควรพูดอะไรในห้องประชุมเพื่อให้การตรวจทานใช้เวลาเก้านาทีแทนที่จะเป็นสามสิบ
สรุปฉบับนั้นยาวสามย่อหน้า เรียบเรียงดี และผิดอยู่ประโยคเดียวพอดี: ทีมตกลงกันว่าจะปล่อยงานย้ายระบบในเดือนกันยายน
ไม่มีใครตกลงเรื่องนั้น มีคนพูดประมาณว่าเดือนกันยายนน่าจะทันถ้าเวนเดอร์ตอบกลับมาทัน เป็นประโยคเงื่อนไข พูดครั้งเดียว กลางวงสนทนาที่กำลังออกนอกเรื่อง โมเดลตัดเงื่อนไขทิ้ง เลื่อนขั้นการเดาให้กลายเป็นการตัดสินใจ แล้วบันทึกนั้นก็ถูกส่งไปยังคนสิบเอ็ดคนที่ไม่ได้อยู่ในห้อง สองคนในนั้นเริ่มวางแผนโดยยึดเดือนกันยายนเป็นหลัก
เรื่องนี้ไม่ได้แปลกประหลาดอะไรเลย มันคือพฤติกรรมที่ถูกบันทึกไว้ละเอียดที่สุดอย่างหนึ่งของระบบสรุปอัตโนมัติ มีชื่อเรียกในงานวิจัย และจะไม่หายไปเพียงเพราะโมเดลรุ่นถัดไปใหญ่ขึ้น บทความนี้ให้คุณสามอย่าง: เจ็ดวิธีที่สรุปเบี่ยงออกจากสิ่งที่พูดกันจริง การตรวจทานเก้านาทีที่จับได้ครบทั้งเจ็ด และประโยคไม่กี่ประโยคที่พูดระหว่างประชุมแล้วทำให้การตรวจทานสั้นลง
สรุปสั้น
- ในเบนช์มาร์ก TofuEval (NAACL 2024) สรุปที่สร้างจากบทถอดเสียงการประชุมสภาเมืองจริง 30.4% มีข้อผิดพลาดเชิงข้อเท็จจริงอย่างน้อยหนึ่งจุด และสำหรับหัวข้อชายขอบ ตัวเลขขึ้นไปถึง 43.6%
- ข้อผิดพลาดไม่ใช่สัญญาณรบกวนแบบสุ่ม นักวิจัยจัดกลุ่มไว้เป็นเจ็ดประเภทที่มีชื่อ และสองประเภทที่ทำร้ายการประชุมมากที่สุดคือ การเสนอความเห็นเป็นข้อเท็จจริง กับ การเลื่อนกาลและมาลา — ซึ่งก็คือจุดที่ "อาจจะ" กลายเป็น "จะ"
- คุณโยนงานตรวจกลับให้โมเดลไม่ได้ด้วย: บน FaithBench (ตุลาคม 2024) ตัวตรวจจับการหลอนที่ดีที่สุดทำความแม่นยำได้ราว 50% และใน TofuEval ตัวประเมินที่เป็น LLM แพ้เมตริกเฉพาะทางที่เล็กกว่า
ภาพ: Shixart1985, Wikimedia Commons, CC BY 2.0 แว่นคือประเด็น สุดท้ายก็ยังต้องมีคนอ่านอยู่ดี
การถอดเสียงการประชุมแก้จบไปแล้ว แต่การตรวจทานยังไม่เริ่มด้วยซ้ำ
ลองนับเครื่องมือบันทึกประชุมที่เปิดตัวบน Hacker News ในหกเดือนที่ผ่านมา ระหว่าง 1 มีนาคมถึง 13 สิงหาคม 2026 มีอย่างน้อยสิบห้าตัว ทั้งตัวถอดเสียงบนเครื่อง สมุดโน้ตที่ไม่ต้องส่งบอทเข้าห้อง ตัวนำเข้าสู่ Obsidian และโคลนโอเพนซอร์สของ Granola ทุกตัวมาพร้อมฟีเจอร์เดียวกันสองอย่าง: บันทึกเสียง แล้วสร้างสรุป
ไม่มีตัวไหนมีขั้นที่สาม ซึ่งเป็นขั้นเดียวที่ต้องใช้วิจารณญาณ สรุปมาถึงกล่องจดหมายของคุณโดยจัดรูปแบบเรียบร้อยแล้ว มั่นใจแล้ว และส่งถึงทุกคนในห้องแล้ว สิ่งที่เวิร์กโฟลว์นี้อ้างโดยนัยมีข้อเดียว: ผลลัพธ์นี้เสร็จสมบูรณ์
นี่คือประเด็น: สรุปที่โมเดลสร้างไม่ใช่บันทึกของการประชุม แต่เป็นคำแถลงเกี่ยวกับการประชุม ผลิตโดยระบบที่ไม่ต้องรับผิดชอบว่าถูกหรือผิด และควรถูกอ่านแบบเดียวกับคำบอกเล่ามือสองอื่น ๆ คืออ่านโดยเทียบกับหลักฐานที่มันมาจาก
โชคดีที่หลักฐานอยู่ตรงนั้นเอง เครื่องมือที่สร้างสรุปก็สร้างบทถอดเสียงด้วย และการเทียบสองอย่างนี้ใช้เวลาน้อยกว่าที่การประชุมใช้ไปกับการแนะนำตัวเสียอีก
ตัวเลขที่ควรเปลี่ยนวิธีอ่านบันทึกการประชุมของคุณ
TofuEval เผยแพร่โดยนักวิจัยจาก Salesforce AI และผู้ร่วมงาน ในงาน NAACL 2024 นับเป็นการวัดที่มีการควบคุมมากที่สุดเท่าที่เรามีสำหรับเรื่องนี้ พวกเขาใช้คลังบทสนทนาสองชุด — ชุดหนึ่งเป็นบทสัมภาษณ์ข่าว อีกชุดชื่อ MeetingBank ซึ่งทำจากบทถอดเสียงการประชุมสภาเมืองในสหรัฐฯ จริง — ให้โมเดลภาษาห้าตัวเขียนสรุปแยกตามหัวข้อ แล้วให้นักภาษาศาสตร์มืออาชีพกำกับทุกประโยคของสรุปว่าตรงกับต้นทางหรือไม่
บนบทถอดเสียงการประชุม เฉลี่ยข้ามทั้งห้าโมเดล สรุปหัวข้อหลัก 30.4% มีความไม่ตรงกับข้อเท็จจริงอย่างน้อยหนึ่งจุด และขึ้นเป็น 43.6% สำหรับหัวข้อชายขอบ ตัวบทความระบุตรง ๆ ว่า ยกเว้น GPT-3.5-Turbo แล้ว "ราว 40–50% ของสรุปมีความไม่ตรงกับข้อเท็จจริงอย่างน้อยหนึ่งจุด"
ข้อสงวนที่ต้องพูดตามตรง: โมเดลทั้งห้าเป็นรุ่นปี 2023 — Vicuna, WizardLM สามขนาด และ GPT-3.5-Turbo — และโมเดลแนวหน้าของวันนี้ดีขึ้นอย่างมีนัยสำคัญในด้านความตรงข้อเท็จจริง แต่มีสองข้อค้นพบจากบทความเดียวกันที่รอดพ้นข้อโต้แย้งนั้น และเป็นสองข้อที่ส่งผลกับวันอังคารของคุณ
ข้อแรก ขนาดไม่ได้แก้ปัญหาอย่างน่าเชื่อถือ อัตราผิดพลาดของ WizardLM-30B บนข้อมูลการประชุมต่ำกว่า WizardLM-7B เพียง 3.8 จุดเปอร์เซ็นต์ ทั้งที่ใหญ่กว่ากันกว่าสี่เท่า และในบางการเปรียบเทียบ โมเดลที่ใหญ่กว่าในตระกูลเดียวกันกลับผิดมากกว่า ข้อสอง จำนวนข้อผิดพลาดไม่มีความสัมพันธ์ที่มีความหมายกับความยาวของสรุป (สหสัมพันธ์เพียร์สัน ρ = 0.18) สรุปที่ยาวและละเอียดกว่าไม่ได้ปลอดภัยกว่า การรอโมเดลที่ใหญ่กว่าไม่ใช่กระบวนการตรวจทาน
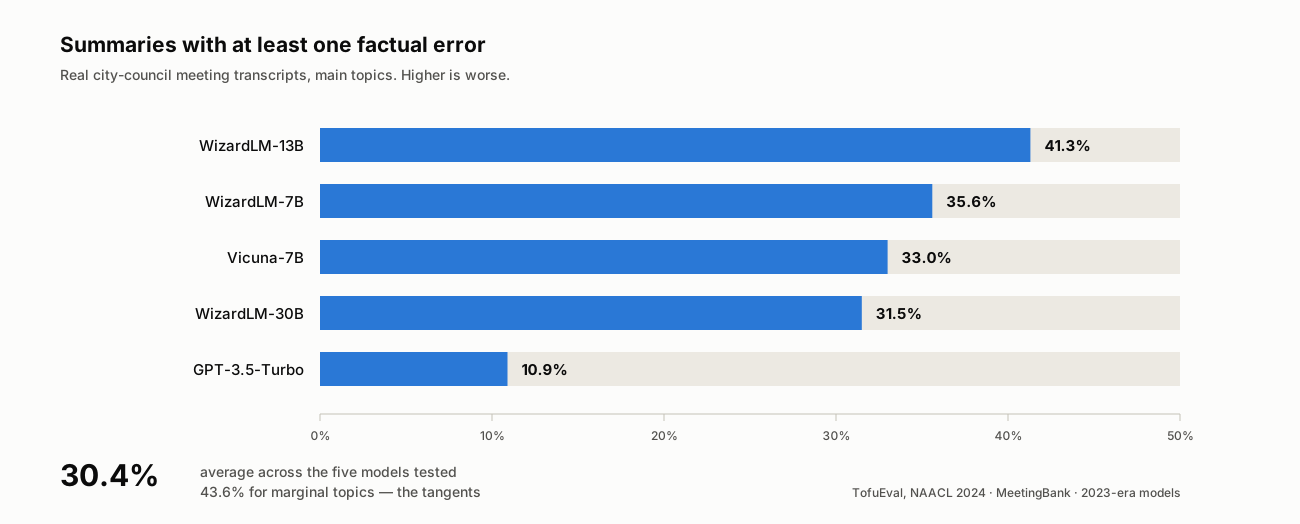
สัดส่วนของสรุปจากบทถอดเสียงการประชุมสภาเมืองจริงที่มีข้อผิดพลาดเชิงข้อเท็จจริงอย่างน้อยหนึ่งจุด เฉพาะหัวข้อหลัก ที่มา: TofuEval, Tang และคณะ, NAACL 2024 (arXiv:2402.13249) โมเดลที่ทดสอบเป็นรุ่นปี 2023 แต่ประเภทข้อผิดพลาดด้านล่างอยู่ยืนยาวกว่าโมเดลเหล่านั้น
เจ็ดวิธีที่สรุปเบี่ยงออกจากห้องประชุม
สิ่งที่มีประโยชน์ที่สุดในบทความนั้นไม่ใช่ตัวเลขเปอร์เซ็นต์ แต่คือระบบจำแนก: ข้อผิดพลาดเจ็ดประเภทที่ผู้กำกับข้อมูลสกัดจากประโยคที่ถูกทำเครื่องหมายไว้หลายพันประโยค ต่อยอดจากระบบจำแนกก่อนหน้าที่สร้างขึ้นสำหรับบทสนทนาสั้น
อ่านสักรอบแล้วคุณจะเริ่มเห็นมันในบันทึกของตัวเอง เพราะมันไม่ใช่ความผิดพลาดสุ่ม แต่เป็นเส้นทางเฉพาะที่เกิดซ้ำได้ ซึ่งการบีบอัดคำพูดให้เป็นร้อยแก้วทำให้ความแตกต่างที่ห้องประชุมพึ่งพาอยู่หายไป
| ประเภทข้อผิดพลาด (TofuEval) | หน้าตาในบันทึกประชุม | วิธีจับ |
|---|---|---|
| ข้อมูลจากภายนอก | รายละเอียดที่มีในสรุปแต่ไม่มีในเสียง — ตัวเลข ชื่อลูกค้า เหตุผลที่ไม่มีใครให้ไว้ | ค้นบทถอดเสียงด้วยคำนามหรือตัวเลขนั้น ถ้าไม่เจอ แปลว่าถูกแต่งขึ้น |
| อ้างอิงผิดคน | การตัดสินใจที่ถูกต้องถูกยกให้คนผิด หรือคำคัดค้านของคนหนึ่งถูกนับเป็นของอีกคน | กระโดดไปที่ไทม์สแตมป์แล้วดูว่าใครกำลังพูด |
| ทำความเห็นให้เป็นข้อเท็จจริง | "การปรับราคาจะทำให้ลูกค้าเลิกใช้มากขึ้น" ทั้งที่มีคนแค่กังวลว่าอาจเป็นเช่นนั้น | มองหาคำผ่อนน้ำหนักในต้นฉบับ: คิดว่า กังวลว่า สงสัยว่า |
| การให้เหตุผลผิด | คำนวณผิด หรือสร้างความสัมพันธ์เชิงเหตุผลที่ห้องประชุมไม่เคยลากเส้นไว้ | คำนวณตัวเลขใหม่ และถามว่า "เพราะว่า" นั้นมีคนพูดหรือถูกอนุมานเอา |
| กาล การณ์ลักษณะ และมาลา | "เราอาจปล่อยในกันยายน" กลายเป็น "เราจะปล่อยในกันยายน" | ตรวจกริยาอนาคตทุกตัวเทียบกับคำแสดงมาลาในต้นฉบับ |
| ความขัดแย้ง | คำปฏิเสธหล่นหาย — "เราไม่เลื่อนกำหนดส่ง" กลายเป็น "เราเลื่อนกำหนดส่ง" | ค้นบทถอดเสียงหาคำว่า ไม่ ไม่เคย เว้นแต่ ใกล้ ๆ ข้อความนั้น |
| ความหมายเคลื่อนแบบละเอียด | "เสนอแนะ" ถูกถอดความเป็น "ร้องขอ" | เทียบกริยาในสรุปกับกริยาในต้นฉบับ |
สามประเภทในนี้จำได้ง่ายที่สุดเมื่อเห็นของจริง ลองวางบทถอดเสียงกับประโยคในสรุปไว้ข้างกันดู
คำปฏิเสธหล่นหาย ความผิดพลาดแบบขัดแย้ง สิ่งที่พูดในห้องประชุม:
แดเนียล (00:31:12): คือเราไม่เลื่อนวันเปิดตัวนะครับ อย่างอื่นจะเปลี่ยนยังไง
วันนั้นคงเดิม
สิ่งที่สรุปเขียนไว้:
ทีมตกลงเลื่อนวันเปิดตัว
คำเดียวที่หายไป แล้วประโยคนี้ก็สั่งให้ทำตรงกันข้าม แถมยังถูกไวยากรณ์ทุกประการ นั่นแหละคือเหตุผลที่การอ่านทวนเลื่อนผ่านมันไป และเป็นเหตุผลที่การค้นคำว่า "ไม่" ใกล้ ๆ การตัดสินใจจับมันได้ในสี่วินาที
ยกให้ผิดคน ความผิดพลาดแบบอ้างอิงผิด สิ่งที่พูดในห้องประชุม:
ปรียา (00:18:40): ฉันไม่เห็นด้วยกับการคิดราคาต่อที่นั่ง ไตรมาสก่อนลูกค้า
องค์กรสองรายบอกเราว่าแบบนั้นดีลจะพัง
มินา (00:18:55): ค่ะ เห็นด้วย
สิ่งที่สรุปเขียนไว้:
มินาคัดค้านการคิดราคาต่อที่นั่ง โดยอ้างเสียงสะท้อนจากลูกค้าองค์กร
ข้อเท็จจริงทุกอย่างในประโยคนั้นมีอยู่ในบทถอดเสียง มีแต่ตัวบุคคลที่ไม่มี ความยากอยู่ตรงนี้เอง คุณจับมันไม่ได้ด้วยการถามว่าข้อความเหล่านั้นจริงหรือไม่ ต้องถามว่ามันเป็นของคนที่ถูกระบุชื่อไว้จริงหรือเปล่า
การเดาที่ถูกเลื่อนขั้น ความผิดพลาดแบบมาลา สิ่งที่พูดในห้องประชุม:
แซม (00:44:02): เดือนกันยายนน่าจะทันนะ ถ้าเวนเดอร์ตอบกลับมาให้ทัน
สิ่งที่สรุปเขียนไว้:
ทีมตกลงกันว่าจะปล่อยงานย้ายระบบในเดือนกันยายน
คำจำกัดขอบเขตหายไปสองอย่าง คือคำว่า "น่าจะ" กับอนุประโยคเงื่อนไขทั้งอัน แล้วการเดาร่วมกันก็กลายเป็นคำมั่นที่มีวันที่กำกับ ไม่มีใครต้องโกหกเลยกว่าจะมาถึงจุดนี้ การบีบอัดทำเอง
สองประเภทในนี้ควรได้รับความสนใจเป็นพิเศษ เพราะเป็นสองประเภทที่ทำให้ทีมเสียเงินจริง
การทำความเห็นให้เป็นข้อเท็จจริง คือเหตุการณ์เดือนกันยายนที่เปิดบทความนี้ ในการประชุม ประโยคส่วนใหญ่มีคำผ่อนน้ำหนักติดอยู่ เพราะคนกำลังคิดออกเสียง และคำผ่อนน้ำหนักนั้นแบกความหมายทั้งหมดไว้ ระบบสรุปตัดคำเหล่านี้ทิ้งโดยการออกแบบ เพราะมันคือสิ่งแรกที่ถูกตัดเวลาบีบอัดข้อความ ผลลัพธ์จึงอ่านแล้วเด็ดขาดกว่าที่ห้องประชุมเป็นจริง และนั่นแหละคือเหตุผลที่ไม่มีใครตั้งคำถามกับมัน
การเลื่อนมาลา ทำลายเรื่องวันที่ในแบบเดียวกัน "อาจ" "ควร" "น่าจะ" และ "ถ้าเวนเดอร์ตอบกลับมา" คือเส้นแบ่งระหว่างแผนกับคำมั่น และก็เป็นคำที่ถูกตัดทิ้งง่ายที่สุดด้วย สรุปที่บอกว่าทีมจะทำบางอย่างในเดือนกันยายน ได้ผลิตเส้นตายที่ไม่มีใครเป็นเจ้าของขึ้นมาอย่างเงียบ ๆ
สังเกตสิ่งที่ทั้งสองมีร่วมกัน โมเดลไม่ได้เสกข้อเท็จจริงขึ้นจากความว่างเปล่า แต่ลบคำจำกัดขอบเขตออก ซึ่งเป็นการแก้ที่มองเห็นยากที่สุดที่มันทำได้ และเป็นการแก้ที่ไม่มีผู้อ่านคนไหนตรวจจับได้หากไม่มีต้นฉบับอยู่ตรงหน้า
ช่วงที่คุยนอกประเด็นคือจุดที่โมเดลแต่งเรื่อง
ในข้อมูลยังมีรูปแบบที่สอง ซึ่งซ้อนทับพอดีกับวิธีที่การประชุมดำเนินไปจริง
สรุปของหัวข้อชายขอบ — เรื่องที่ถูกพูดผ่าน ๆ ไม่ได้ถกกันยาว — แย่กว่าอย่างชัดเจน: 43.6% เทียบกับ 30.4% บนคลังข้อมูลการประชุม นักวิจัยอธิบายกลไกไว้ว่า เมื่อหัวข้อหนึ่งแทบไม่ถูกครอบคลุมในต้นทาง โมเดลจะ "พึ่งความรู้ของตัวเองเพื่ออนุมานเกี่ยวกับหัวข้อนั้น และนำข้อมูลที่ไม่มีหลักฐานเข้ามาในสรุป" ที่ที่หลักฐานบางถูกถมด้วยความรู้ทั่วไป และส่วนที่ถมเข้ามาก็แยกไม่ออกจากส่วนที่มีหลักฐานเมื่อดูจากน้ำเสียง
การประชุมของคุณเต็มไปด้วยหัวข้อชายขอบ ช่วงสองนาทีที่พูดถึงการตรวจสอบความปลอดภัย เวนเดอร์ที่ถูกเอ่ยถึงครั้งเดียว ตัวเลขที่ใครบางคนจำได้ครึ่ง ๆ กลาง ๆ บรรทัดเหล่านี้ถูกถกน้อยที่สุดและมีโอกาสผิดมากที่สุด แต่จะอ่านลื่นไหลไม่ต่างจากส่วนอื่นเลย
ชั้นที่อยู่ล่างลงไปก็รูปทรงเดียวกัน ในงาน "Careless Whisper" ที่เสนอในการประชุม ACM FAccT 2024 Koenecke และคณะพบว่า บทถอดเสียงของ Whisper ราว 1% มีวลีหรือประโยคที่ถูกหลอนขึ้นมาทั้งดุ้นโดยไม่ปรากฏในเสียงต้นฉบับในรูปแบบใดเลย และ 38% ของการหลอนเหล่านั้นมีอันตรายชัดเจน ทั้งการสร้างความเชื่อมโยงเท็จ การอ้างอำนาจปลอม และการแต่งเรื่องความรุนแรง ส่วนที่น่าสนใจคือตัวกระตุ้น: การหลอนเกิดขึ้นมากผิดสัดส่วนกับผู้พูดที่มีช่วงเวลาไร้เสียงยาวกว่า
พูดอีกอย่างคือความเงียบ ซึ่งก็คือสิ่งที่การประชุมทำมาจากนั่นเอง ช่วงหยุดคิด ตอนที่ใครสักคนกำลังปิดไมค์ ระหว่างรอหน้าจอแชร์โหลด สี่วินาทีหลังคำถามยาก นั่นคือวัตถุดิบที่โมเดลถอดเสียงมีแนวโน้มจะเติมด้วยสิ่งที่ไม่เคยถูกพูดมากที่สุด และยังหมายความว่าข้อผิดพลาดของบทถอดเสียงกับของสรุปไม่ได้เป็นอิสระต่อกัน เพราะบรรทัดที่ถูกแต่งขึ้นในบทถอดเสียงคืออินพุตที่ "มีหลักฐานรองรับ" อย่างสมบูรณ์ในสายตาของตัวสรุป
คุณโยนงานตรวจกลับให้โมเดลไม่ได้
ความคิดที่ชัดเจนคือให้โมเดลตัวที่สองตรวจตัวแรก ผลการวัดไม่น่าชื่นใจนัก
ในงาน TofuEval ชิ้นเดียวกัน ผู้เขียนประเมิน LLM ในฐานะผู้ตัดสินความตรงข้อเท็จจริงแบบสองค่า และพบว่าทุกตัวรวมถึง GPT-4 "ทำได้แย่ในการตรวจจับข้อผิดพลาดในสรุปที่สร้างโดย LLM" และแพ้เมตริกความตรงข้อเท็จจริงที่ไม่ใช่ LLM ซึ่งเล็กกว่าและสร้างมาเพื่องานนี้โดยเฉพาะ แม้ตอนที่ GPT-4 ชี้ประโยคได้ถูกต้อง คำอธิบายว่าทำไมถึงผิดก็ถูกราว 80% ส่วนตัวประเมินอื่น ๆ ถูกราวครึ่งเดียว
FaithBench ที่ Vectara ปล่อยออกมาในเดือนตุลาคม 2024 ใส่ตัวเลขให้เพดานนี้ มันรวบรวมการหลอนที่โมเดลสมัยใหม่สิบตัวจากแปดตระกูลผลิตออกมา และเป็นกรณีที่ตัวตรวจจับเดิม ๆ เห็นไม่ตรงกัน แล้วรายงานว่าแม้แต่ตัวตรวจจับการหลอนที่ดีที่สุดก็ทำความแม่นยำได้ราว 50% นั่นคือการโยนหัวก้อยบนกรณีที่สำคัญที่สุด
ดังนั้นการตรวจทานจึงเป็นงานของคุณ ฟังดูเป็นภาระ จนกระทั่งคุณสังเกตเห็นความไม่สมมาตรอย่างหนึ่ง: ตัวตรวจจับต้องตัดสินข้อความอะไรก็ไม่รู้เทียบกับเอกสารที่ไม่คุ้นเคย ส่วนคุณอยู่ในห้องนั้น คุณรู้อยู่แล้วว่าข้อความไหนดูแปลก คุณแค่ต้องไปตรวจสอบมัน
สามสิ่งที่ได้จากการประชุม สามหน้าที่ต่างกัน
การถกเถียงแบบ "บันทึกด้วย AI หรือบันทึกด้วยมือ" ส่วนใหญ่เป็นความผิดพลาดเชิงหมวดหมู่ การประชุมหนึ่งครั้งผลิตของสามอย่าง มันไม่ได้ทดแทนกัน และทีมที่เก็บไว้อย่างเดียวจะสูญเสียบางอย่างที่เจาะจงเสมอ
| บทถอดเสียงดิบ | สรุปจาก AI | บันทึกการตัดสินใจ | |
|---|---|---|---|
| เก็บถ้อยคำตามจริง | ได้ — คำต่อคำ | ไม่ได้ — ถูกบีบอัด คำผ่อนน้ำหนักหลุด | ไม่ได้ |
| ใครเป็นคนพูด | ได้ ถ้าแยกผู้พูดไว้ | บางครั้ง การอ้างอิงผิดคนเป็นประเภทข้อผิดพลาดที่มีชื่อ | ได้ — เจ้าของงานคือหัวใจ |
| พูดตอนไหน | ได้ — มีไทม์สแตมป์ | แทบไม่มี | มีแต่กำหนดส่ง |
| การตัดสินใจพร้อมเจ้าของและกำหนดเวลา | ฝังอยู่ในราว 9,000 คำ | บางส่วน และไม่น่าเชื่อถือ | ได้ — นี่คือหน้าที่เดียวของมัน |
| ตัดอะไรทิ้งไป และเพราะอะไร | ได้ ถ้ามีคนพูดออกมา | มักถูกตัดเพราะดูซ้ำซ้อน | ได้ ในบรรทัดเดียว |
| อ่านจบใน 60 วินาที | ไม่ได้ | ได้ | ได้ |
| ตรวจย้อนกับหลักฐานได้ | ตัวมันเองคือหลักฐาน | ต่อเมื่อบทถอดเสียงยังอยู่ | ต่อเมื่อทั้งสองอย่างยังอยู่ |
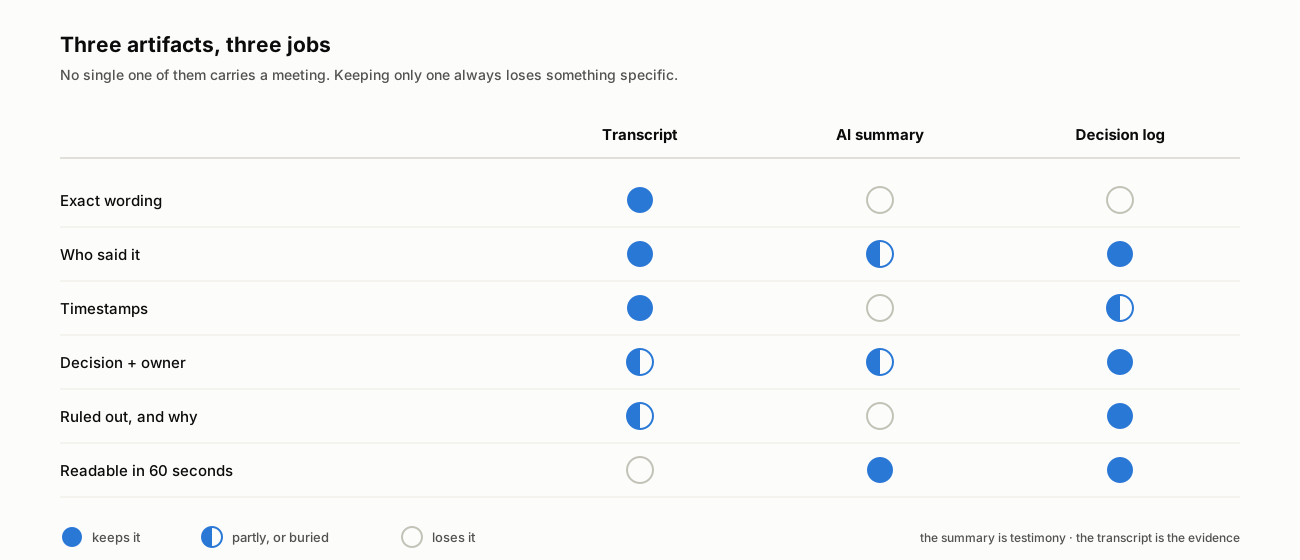
แต่ละอย่างเก็บอะไรไว้ เก็บไว้บางส่วน หรือทำหล่นหาย แถวล่างสุดคือแถวที่ตัดสินว่าอีกสองอย่างมีค่าหรือไม่
แถวล่างสุดคือข้อโต้แย้งทั้งหมด สรุปที่ไม่มีบทถอดเสียงหลงเหลืออยู่คือสิ่งที่พิสูจน์ว่าผิดไม่ได้ เมื่อเพื่อนร่วมงานพูดว่า "เราไม่ได้ตกลงกันแบบนั้น" สิ่งที่คุณมีคือความเห็นสองอันกับบันทึกศูนย์อัน และตรงนี้เองที่บันทึกจาก AI เปราะบางกว่าบันทึกของมนุษย์ ไม่ใช่น้อยกว่า เพราะรายงานที่คนจดมาพร้อมความผิดพลาดที่มองเห็นได้ ทุกคนจึงอ่านด้วยความระแวงพอเหมาะ ส่วนร้อยแก้วของเครื่องมาถึงพร้อมหัวข้อย่อยที่สะอาดและประโยคบอกเล่าที่มั่นใจ แล้วยืมอำนาจที่มันไม่ได้หามาเอง
เรียกมันตามที่มันเป็นเถอะ: สรุปคือคำให้การ ส่วนบทถอดเสียงคือหลักฐาน คำให้การมีประโยชน์ และคำให้การก็เป็นสิ่งที่ต้องเอาไปตรวจสอบด้วย
การตรวจทานเก้านาที เรียงตามลำดับ
นี่คือขั้นตอนที่เราแนะนำ จับเวลาสำหรับการประชุม 60 นาที ลำดับสำคัญ เพราะมันวางการตรวจที่มีต้นทุนสูงสุดหากพลาดไว้ข้างหน้า ถ้าคุณถูกขัดจังหวะตอนนาทีที่สี่ คุณก็จับข้อผิดพลาดราคาแพงไปแล้ว
- 0:00–1:30 — อ่านเฉพาะประโยคที่เป็นการตัดสินใจ รอบแรกให้ข้ามสรุปเชิงบรรยายไปทั้งหมด หาทุกประโยคที่อ้างผลลัพธ์ คำมั่น หรือวันที่ การประชุม 60 นาทีทั่วไปจะมีสามถึงหกประโยค มีแค่บรรทัดเหล่านี้ที่จะมีคนเอาไปทำจริง
- 1:30–3:00 — คืนมาลากลับเข้าไป สำหรับแต่ละประโยค กระโดดไปยังจุดนั้นในบทถอดเสียงแล้วตรวจกริยา มีคนพูดว่า จะ หรือพูดว่า อาจ ควร น่าจะ ถ้าต้นฉบับมีคำผ่อนน้ำหนัก ให้เขียนบรรทัดสรุปใหม่โดยใส่คำนั้นกลับเข้าไป หรือดีกว่านั้นคือทำเครื่องหมายว่าเป็นคำถามที่ยังค้างพร้อมระบุเจ้าของ
- 3:00–4:30 — ตรวจวิสามานยนามและตัวเลขทุกตัว ชื่อคน บริษัท เวอร์ชัน ราคา วันที่ เปอร์เซ็นต์ ค้นแต่ละอย่างในบทถอดเสียง อะไรที่ไม่ปรากฏที่นั่นคือข้อมูลจากภายนอก ให้ลบทิ้งหรือไปยืนยันนอกรอบ นี่เป็นงานช่องค้นหา ไม่ใช่งานนั่งอ่าน
- 4:30–5:30 — ตรวจสอบการระบุตัวผู้พูด สำหรับทุกการตัดสินใจและทุกคำคัดค้าน ยืนยันว่าใครกำลังพูดที่ไทม์สแตมป์นั้น การอ้างอิงผิดคนคือข้อผิดพลาดที่มีแนวโน้มก่อปัญหาระหว่างบุคคลมากกว่าปัญหาการวางแผน และเป็นข้อที่ตรวจได้เร็วที่สุด
- 5:30–6:30 — ล่าคำปฏิเสธที่หล่นหาย ค้นบทถอดเสียงหาคำว่า ไม่ ไม่เคย อย่า เว้นแต่ และ แทนที่จะ ในบริเวณใกล้แต่ละการตัดสินใจ ข้อผิดพลาดแบบขัดแย้งจะพลิกความหมายทั้งหมดโดยที่ประโยคยังถูกไวยากรณ์สมบูรณ์ การอ่านทวนจึงไม่เจอ ต้องใช้การค้นหา
- 6:30–8:00 — ถามว่าอะไรหายไป นี่คือขั้นที่ไม่มีเครื่องมือใดทำแทนคุณได้ เพราะสรุปไม่สามารถชี้สิ่งที่ตัวเองละไว้ได้ คำถามมีสองข้อ: เราตัดอะไรทิ้ง และเพราะอะไร และเราตอบคำถามข้อไหนไม่ได้ ทั้งสองอย่างไม่รอดจากการบีบอัด และทั้งสองอย่างคือสิ่งที่ทำให้บันทึกนี้ยังมีประโยชน์ในอีกหกเดือน
- 8:00–9:00 — เขียนบันทึกการตัดสินใจแล้วส่ง สามถึงหกบรรทัด แต่ละบรรทัดระบุว่าตัดสินใจอะไร ใครรับผิดชอบก้าวถัดไป และภายในเมื่อไร แล้วลิงก์ไปยังบทถอดเสียง ลิงก์นั้นคือสิ่งที่ทำให้การตรวจทานทั้งหมดถูกตรวจซ้ำได้โดยคนอื่น
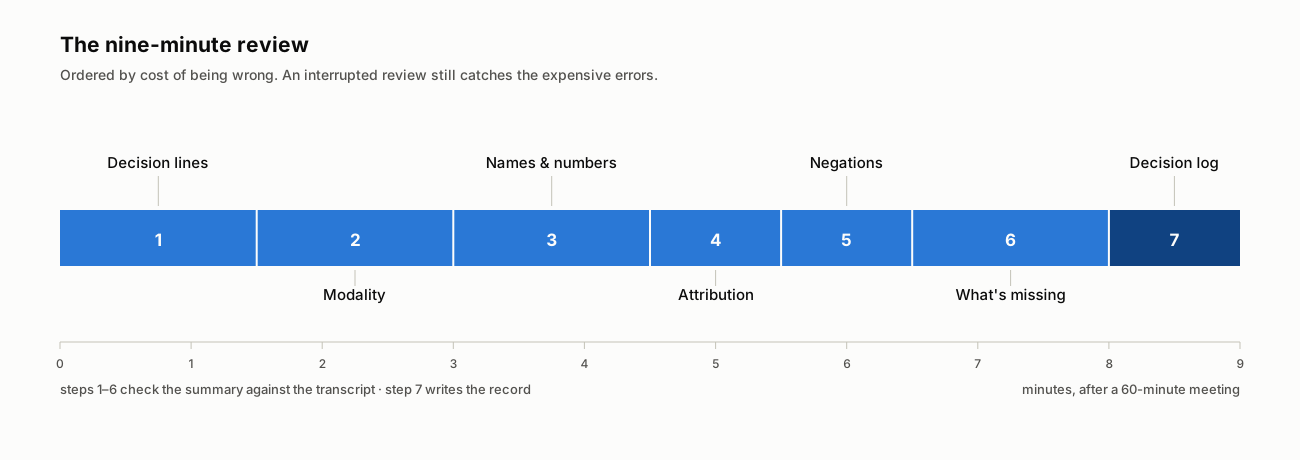
ลำดับคือการออกแบบ: มาลาและรายละเอียดที่ถูกแต่งขึ้นมาก่อน สิ่งที่หายไปไว้ท้ายสุด การตรวจทานที่ถูกขัดจังหวะก็ยังจับข้อผิดพลาดราคาแพงได้
ข้อสังเกตสองข้อสำหรับการทำจริงในระดับใช้งานประจำ ถ้าการประชุมยาว 30 นาที นี่คืองานสี่นาที และถ้าคุณทำมันในเครื่องมือที่เก็บทั้งสรุปและบทถอดเสียงที่มีไทม์สแตมป์ไว้ด้วยกัน ขั้นที่ 2 ถึง 5 จะกลายเป็นการค้นหาและการคลิก แทนที่จะเป็นการสลับหน้าต่างไปมา ซึ่งคือความต่างระหว่างนิสัยที่รอดสัปดาห์ที่งานยุ่งกับนิสัยที่ไม่รอด
สิบวินาทีในห้องประชุม ประหยัดห้านาทีตอนตรวจทาน
การตรวจทานจะสั้นลงอย่างมากถ้าเสียงต้นฉบับมีข้อมูลนั้นอยู่ตั้งแต่แรก โมเดลกู้คืนสิ่งที่ไม่มีใครพูดไม่ได้ และสิ่งที่ทำให้บันทึกกำกวมส่วนใหญ่ไม่เคยอยู่ในเสียงเลย
- เปิดประชุมด้วยคำถาม พูดออกมาดัง ๆ "วันนี้เรามาตัดสินกันว่าจะปล่อยงานย้ายระบบก่อนหรือหลังงานประชุมใหญ่" คำถามที่ถูกพูดออกมาให้หัวข้อหลักแก่ระบบสรุป แทนที่จะมีแต่หัวข้อชายขอบ — และหัวข้อชายขอบคือฝั่ง 43.6%
- พูดการตัดสินใจเป็นประโยคเดียว พร้อมชื่อและวันที่ ก่อนใครออกจากห้อง "สรุป: มินารับผิดชอบตามเรื่องกับเวนเดอร์ และเรายืนยันวันเดือนกันยายนภายในวันที่ 25" เครื่องมือบันทึกทุกตัวในตลาดจับประโยคนี้ได้อย่างสมบูรณ์แบบ และไม่มีตัวไหนคิดประโยคนี้ขึ้นมาให้คุณได้
- พูดคำปฏิเสธออกมาให้ชัด "เราไม่เลื่อนวันเปิดตัว" ปลอดภัยกว่าการยักไหล่แล้วพยักหน้า เพราะคำปฏิเสธที่หล่นหายเป็นประเภทข้อผิดพลาดที่มีบันทึกไว้ ส่วนคำปฏิเสธที่ไม่เคยถูกพูดก็ไม่มีอะไรให้หล่น
- บอกว่าคุณปฏิเสธอะไรและเพราะอะไร ในหนึ่งบรรทัด "เราพิจารณาการคิดราคาต่อที่นั่งแล้ว แต่ตัดทิ้งเพราะลูกค้าองค์กรสองรายคัดค้านเมื่อไตรมาสก่อน" นี่คือประโยคที่หยุดไม่ให้การถกเถียงเดิมเปิดใหม่ในอีกหกเดือน
- สะกดวิสามานยนามที่ไม่คุ้นสักครั้ง ชื่อเวนเดอร์ ชื่อโครงการภายใน และตัวย่อ คือสิ่งที่บทถอดเสียงมักเพี้ยน แล้วสรุปก็เอาไปพูดซ้ำอย่างมั่นใจ
- อย่าปล่อยให้ความเงียบเป็นคนพูด ถ้าห้องเงียบลงเพราะทุกคนกำลังอ่านเอกสาร ให้พูดออกมา ช่วงไร้เสียงที่ยาวคือเงื่อนไขที่โมเดลถอดเสียงหลอนมากที่สุด
ทั้งหมดนี้ไม่ใช่ละครในห้องประชุม แต่คือการบอกให้บันทึกจดตาม เป็นทักษะที่มีค่ามากขึ้นเมื่อบันทึกเริ่มถูกเขียนโดยอัตโนมัติ ไม่ใช่น้อยลง
บรรทัดสุดท้าย
สรุปการประชุมจาก AI ไม่ใช่บันทึก แต่คือคำให้การเกี่ยวกับบันทึก ส่งมาอย่างลื่นไหล โดยพยานที่ไม่มีส่วนได้ส่วนเสียกับความถูกต้อง และมีแนวโน้มที่ถูกบันทึกไว้แล้วว่าจะทำคำว่า "น่าจะ" หล่นหาย
การนิยามใหม่แบบนี้ยุติข้อถกเถียงเรื่องมือกับ AI ซึ่งไม่เคยเป็นข้อถกเถียงจริงตั้งแต่ต้น เก็บเสียงบันทึกไว้ เพราะมันคือหลักฐานเดียว ให้โมเดลเขียนสรุป เพราะมันเร็วกว่าคุณและไม่เบื่อตอนนาทีที่สี่สิบ แล้วใช้เก้านาทีทำส่วนเดียวที่ต้องอาศัยการอยู่ในเหตุการณ์: เอาประโยคที่มั่นใจเหล่านั้นไปเทียบกับสิ่งที่พูดกันจริง แล้วเขียนสามบรรทัดที่ต้องมีคนลงมือทำ
ทีมที่โดนลวกในปี 2026 ไม่ใช่ทีมที่ข้ามเครื่องมือบันทึกด้วย AI แต่คือทีมที่อ่านผลลัพธ์ของมันราวกับเป็นบทถอดเสียง ทั้งที่มันเป็นการถอดความ และไม่ได้เก็บบทถอดเสียงที่จะแสดงความต่างนั้นเอาไว้ สำหรับเวอร์ชันเต็มว่าบันทึกที่ดีต้องบรรจุอะไรบ้าง เราเขียนไว้ในหกสิ่งที่บันทึกการประชุมยังต้องมี และเรื่องที่ว่าทำไมอัตราคำผิดแทบไม่บอกอะไรเลยว่าบทถอดเสียงใช้งานได้จริงหรือไม่ อยู่ในความแม่นยำอย่างเดียวไม่พอ
Telli.sh อยู่ตรงไหน: การตรวจทานเก้านาทีจะได้ผลก็ต่อเมื่อสรุปกับต้นทางอยู่ที่เดียวกัน Telli.sh เก็บบทถอดเสียงที่มีไทม์สแตมป์และระบุผู้พูดไว้ข้าง ๆ สรุปจาก AI ที่แก้ไขได้ การตรวจสอบข้อความหนึ่งจึงเป็นการค้นหาและคลิก ไม่ใช่การไล่หาข้ามสองระบบ และเมื่อห้องประชุมไม่ได้พูดภาษาเดียว คำแปลจะอยู่เคียงข้างต้นฉบับแทนที่จะแทนที่มัน สรุปมาถึงในฐานะร่างที่คุณแก้ ไม่ใช่ผลลัพธ์ที่คุณต้องยอมรับ
แหล่งข้อมูล
- Tang et al., "TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization," NAACL 2024 (arXiv:2402.13249, 20 กุมภาพันธ์ 2024)
- Koenecke et al., "Careless Whisper: Speech-to-Text Hallucination Harms," ACM FAccT 2024 (arXiv:2402.08021, 12 กุมภาพันธ์ 2024)
- Bao et al., "FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs," Vectara (arXiv:2410.13210, 17 ตุลาคม 2024)
- Hu et al., "MeetingBank: A Benchmark Dataset for Meeting Summarization," ACL 2023 (arXiv:2305.17529, 27 พฤษภาคม 2023)
- Wang et al., "Analyzing and Evaluating Faithfulness in Dialogue Summarization," EMNLP 2022 (arXiv:2210.11777, 21 ตุลาคม 2022)
- หน้าภาพบน Wikimedia Commons
