Tiada siapa berkata September: semakan sembilan minit yang diperlukan setiap ringkasan mesyuarat AI
Kajian tentang peringkasan transkrip mesyuarat mendapati 30,4% ringkasan yang dijana daripada sidang majlis perbandaran mengandungi sekurang-kurangnya satu kesilapan fakta, dengan tujuh jenis kesilapan bernama di sebaliknya. Panduan praktikal untuk menyemak nota mesyuarat tulisan AI terhadap transkripnya sendiri: apa yang perlu diperiksa, mengikut susunan apa, dan apa yang patut disebut dalam bilik mesyuarat supaya semakan mengambil masa sembilan minit dan bukan tiga puluh.
Ringkasan itu tiga perenggan, tersusun kemas, dan salah pada tepat satu ayat: pasukan bersetuju melancarkan migrasi pada bulan September.
Tiada sesiapa bersetuju begitu. Seseorang ada berkata September mungkin sempat jika vendor membalas tepat pada masanya — satu ayat bersyarat, disebut sekali sahaja, di tengah perbualan yang sedang terpesong ke hal lain. Model membuang syaratnya, menaikkan tekaan menjadi keputusan, dan nota itu dihantar kepada sebelas orang yang tiada dalam bilik. Dua daripada mereka mula merancang berdasarkan September.
Tiada apa yang pelik tentang perkara ini. Ia salah satu tingkah laku sistem peringkas automatik yang paling terdokumentasi, ada namanya dalam literatur penyelidikan, dan ia tidak akan hilang hanya kerana model seterusnya lebih besar. Tulisan ini memberi tiga perkara: tujuh cara sesebuah ringkasan menyimpang daripada apa yang benar-benar diucapkan, semakan sembilan minit yang menangkap ketujuh-tujuhnya, dan beberapa ayat yang disebut semasa mesyuarat yang memendekkan semakan itu.
Ringkasnya:
- Dalam penanda aras TofuEval (NAACL 2024), 30,4% ringkasan yang dijana daripada transkrip sidang majlis perbandaran sebenar mengandungi sekurang-kurangnya satu kesilapan fakta; bagi topik pinggiran — perbualan yang terpesong — angkanya naik ke 43,6%.
- Kesilapan ini bukan hingar rawak. Penyelidik mengelaskannya kepada tujuh jenis bernama, dan dua yang paling memudaratkan mesyuarat ialah menyampaikan pendapat sebagai fakta dan anjakan kala dan modaliti — tepat di tempat "kita mungkin boleh" bertukar menjadi "kita akan".
- Pemeriksaannya juga tidak boleh dipulangkan kepada model: pada FaithBench (Oktober 2024), pengesan halusinasi terbaik hanya mencapai ketepatan sekitar 50%, dan dalam TofuEval penilai berasaskan model bahasa kalah kepada metrik khusus yang lebih kecil.
Gambar: Shixart1985, Wikimedia Commons, CC BY 2.0. Cermin mata itulah intinya. Akhirnya tetap ada orang yang perlu membacanya.
Rakaman sudah selesai. Pemeriksaan belum pernah bermula.
Cuba kira alat nota mesyuarat yang dilancarkan di Hacker News dalam enam bulan lalu: sekurang-kurangnya lima belas antara 1 Mac dan 13 Ogos 2026. Penstranskrip yang berjalan terus pada peranti, pad nota tanpa bot menyertai panggilan, pengimport untuk Obsidian, klon Granola sumber terbuka. Semuanya membawa dua ciri yang sama: rakam audio, jana ringkasan.
Tiada satu pun membawa langkah ketiga — satu-satunya langkah yang memerlukan pertimbangan. Ringkasan tiba dalam peti masuk anda sudah siap diformat, sudah yakin, sudah dihantar kepada seisi bilik. Apa yang dituntut secara senyap oleh aliran kerja itu cuma satu: hasil ini sudah siap.
Inilah intinya: ringkasan yang dijana bukan rekod mesyuarat. Ia satu kenyataan tentang mesyuarat, dihasilkan oleh sistem yang tidak bertanggungjawab atas ketepatannya, dan sepatutnya dibaca seperti mana-mana laporan tangan kedua — iaitu ditanding dengan bukti asalnya.
Nasib baik, bukti itu ada betul-betul di sebelah. Alat yang menghasilkan ringkasan itu turut menghasilkan transkripnya, dan menanding kedua-duanya mengambil masa lebih singkat daripada sesi perkenalan pada awal mesyuarat.
Angka yang sepatutnya mengubah cara anda membaca minit
TofuEval, diterbitkan oleh penyelidik Salesforce AI bersama rakan penulis di NAACL 2024, adalah yang paling menghampiri pengukuran terkawal yang kita ada tentang perkara ini. Mereka mengambil dua korpus dialog — satu temu bual berita, satu lagi bernama MeetingBank yang terdiri daripada transkrip sidang majlis perbandaran sebenar di Amerika Syarikat — meminta lima model bahasa menulis ringkasan mengikut topik, kemudian meminta ahli bahasa profesional menanda setiap ayat ringkasan mengikut keselarasannya dengan sumber.
Pada transkrip mesyuarat, purata bagi lima model, 30,4% ringkasan tentang topik utama mengandungi sekurang-kurangnya satu ketidakselarasan fakta, dan naik kepada 43,6% bagi topik pinggiran. Kertas kerja itu menyatakan terus terang: kecuali GPT-3.5-Turbo, "lebih kurang 40–50% ringkasan mereka mengandungi sekurang-kurangnya satu ketidakselarasan fakta".
Peringatan jujurnya: kelima-lima model itu daripada generasi 2023 — Vicuna, tiga saiz WizardLM, dan GPT-3.5-Turbo — dan model termaju hari ini jauh lebih baik dari segi kesetiaan kepada fakta. Namun dua penemuan dalam kertas yang sama bertahan terhadap bantahan itu, dan itulah dua perkara yang menyentuh hari Selasa anda.
Pertama, skala tidak menyelesaikannya secara boleh dipercayai. Pada data mesyuarat, kadar kesilapan WizardLM-30B hanya 3,8 mata peratusan lebih rendah daripada WizardLM-7B, walaupun saiznya lebih empat kali ganda; dalam sesetengah perbandingan, model yang lebih besar dalam keluarga yang sama menghasilkan lebih banyak kesilapan. Kedua, jumlah kesilapan tiada hubungan bermakna dengan panjang ringkasan (korelasi Pearson ρ = 0,18). Ringkasan yang lebih panjang dan terperinci bukanlah ringkasan yang lebih selamat. Menunggu model yang lebih besar bukan satu proses semakan.
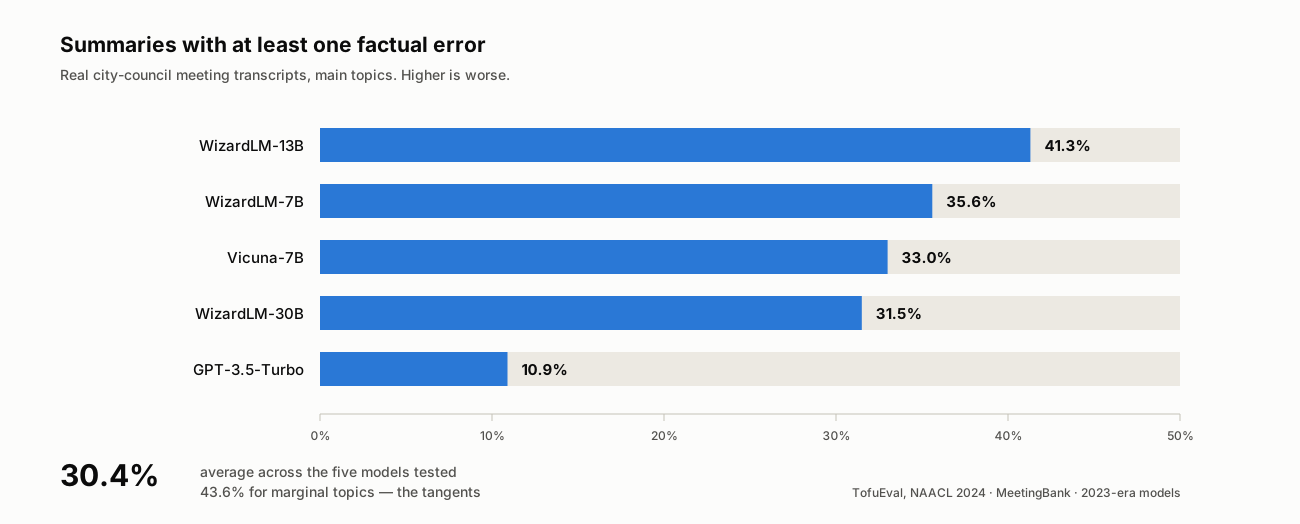
Peratusan ringkasan daripada transkrip sidang majlis perbandaran sebenar yang mengandungi sekurang-kurangnya satu kesilapan fakta, topik utama sahaja. Sumber: TofuEval, Tang et al., NAACL 2024 (arXiv:2402.13249). Model yang diuji daripada generasi 2023; jenis kesilapan di bawah ini hidup lebih lama daripada model-model itu.
Tujuh cara ringkasan menyimpang daripada bilik mesyuarat
Perkara paling berguna dalam kertas itu bukanlah peratusannya, tetapi taksonominya: tujuh jenis kesilapan bernama yang diterbitkan oleh penanda daripada ribuan ayat yang ditanda, sebagai lanjutan taksonomi terdahulu yang dibina atas dialog pendek.
Baca sekali sahaja, dan anda akan mula melihatnya dalam nota anda sendiri. Ini bukan pincang rawak, tetapi laluan khusus dan berulang yang mana pemampatan pertuturan menjadi prosa memadamkan perbezaan yang sedang dijadikan sandaran oleh bilik mesyuarat.
| Jenis kesilapan (TofuEval) | Rupanya dalam nota mesyuarat | Cara menangkapnya |
|---|---|---|
| Maklumat ekstrinsik | Butiran yang ada dalam ringkasan tetapi tiada langsung dalam audio — satu angka, nama pelanggan, alasan yang tiada sesiapa berikan | Cari kata nama khas atau angka itu dalam transkrip; jika tiada hasil, ia direka |
| Salah rujuk | Keputusan yang betul dikaitkan dengan orang yang salah, atau bantahan seorang dicatat sebagai milik orang lain | Lompat ke tanda masa dan lihat siapa yang sedang bercakap |
| Pendapat jadi fakta | "Perubahan harga akan meningkatkan kadar pelanggan berhenti" sedangkan seseorang hanya bimbang ia mungkin berlaku | Cari kata pelembut dalam sumber: fikir, bimbang, syak |
| Kesilapan penaakulan | Kiraan tersalah, atau hubungan sebab-akibat yang tidak pernah dibuat dalam bilik | Kira semula setiap angka; tanya sama ada "kerana" itu diucapkan atau disimpulkan |
| Kala / aspek / modaliti | "Kita mungkin boleh lancar September" menjadi "kita akan lancar September" | Tanding setiap kata kerja masa hadapan dengan modaliti asalnya |
| Percanggahan | Penafian yang tercicir: "kita tidak menganjak tarikh akhir" menjadi "kita menganjak tarikh akhir" | Cari tidak, jangan, melainkan berhampiran kenyataan itu |
| Anjakan makna halus | "membuat saranan" ditulis semula sebagai "membuat tuntutan" | Banding kata kerja dalam ringkasan dengan kata kerja dalam sumber |
Tiga daripadanya paling mudah dikenali apabila dilihat wujudnya. Berikut setiap satu, dengan transkrip dan ayat ringkasan diletakkan bersebelahan.
Penafian yang tercicir — kesilapan percanggahan. Apa yang diucapkan dalam bilik:
DANIEL (00:31:12): Jadi tarikh pelancaran kita tidak anjak. Apa pun yang
berubah, tarikh itu kekal.
Apa yang ditulis ringkasan:
Pasukan bersetuju menganjak tarikh pelancaran.
Satu perkataan hilang, dan ayat itu kini mengarahkan tindakan yang bertentangan. Ia juga sempurna dari segi tatabahasa, dan itulah sebabnya membaca semula terlepas pandang, sementara mencari perkataan "tidak" berhampiran keputusan itu menangkapnya dalam empat saat.
Tersalah letak orang — kesilapan salah rujuk. Apa yang diucapkan dalam bilik:
PRIYA (00:18:40): Saya membantah harga setiap kerusi. Suku lalu dua
pelanggan enterprise beritahu kita, cara itu buat dealnya gagal.
MINA (00:18:55): Ya, saya setuju.
Apa yang ditulis ringkasan:
Mina membantah harga setiap kerusi sambil merujuk maklum balas pelanggan
enterprise.
Setiap fakta dalam ayat itu ada dalam transkrip. Cuma orangnya tiada. Di situlah letaknya keseluruhan kesukaran: kesilapan ini tidak dapat ditangkap dengan bertanya sama ada kenyataan itu benar, hanya dengan bertanya sama ada ia benar-benar milik orang yang dilekatkan padanya.
Tekaan yang dinaikkan taraf — kesilapan modaliti. Apa yang diucapkan dalam bilik:
SAM (00:44:02): September agaknya sempat, kalau vendor balas kepada kita
tepat pada masanya.
Apa yang ditulis ringkasan:
Pasukan bersetuju melancarkan migrasi pada bulan September.
Dua kata pembatas dibuang — perkataan "agaknya" dan keseluruhan klausa bersyarat — lalu tekaan bersama bertukar menjadi komitmen yang bertarikh. Tiada sesiapa perlu berbohong untuk itu berlaku. Pemampatan yang melakukannya.
Dua daripadanya wajar diberi perhatian khusus, kerana dua itulah yang benar-benar merugikan pasukan dari segi wang.
Pendapat jadi fakta ialah insiden September di awal tulisan ini. Dalam mesyuarat, kebanyakan ayat dilembutkan — orang sedang berfikir dengan bersuara, dan kata pelembut itulah yang memikul keseluruhan maknanya. Model peringkas membuang kata pelembut secara reka bentuk, kerana itulah benda pertama yang dipotong ketika memampatkan teks. Hasilnya berbunyi lebih tegas daripada keadaan sebenar bilik itu, dan justeru sebab itulah ia tidak dipersoal.
Anjakan modaliti merosakkan tarikh dengan cara yang sama. "Mungkin", "patut", "agaknya" dan "kalau vendor membalas" ialah garis pemisah antara rancangan dengan komitmen, dan sekali gus perkataan yang paling murah untuk digugurkan. Ringkasan yang menyebut pasukan akan melakukan sesuatu pada September telah diam-diam mencipta tarikh akhir yang tiada sesiapa pertanggungjawabkan.
Perhatikan persamaan kedua-duanya. Model tidak mencipta fakta daripada kekosongan: ia membuang kata pembatas. Itulah suntingan paling tidak ketara yang boleh dilakukannya, dan yang tidak mungkin dikesan mana-mana pembaca tanpa sumber di hadapan mata.
Rekaan berlaku pada perbualan yang terpesong
Ada corak kedua dalam data yang bertindih tepat dengan cara mesyuarat sebenar berjalan.
Ringkasan topik pinggiran — perkara yang disebut sambil lalu dan bukannya dibincang panjang — jauh lebih teruk: 43,6% berbanding 30,4% pada korpus mesyuarat. Penyelidik menerangkan mekanismenya: apabila sesuatu topik nyaris tidak diliputi dalam sumber, model "bersandar pada pengetahuan sendiri untuk membuat inferens tentang topik itu, lalu membawa masuk maklumat tanpa sokongan ke dalam ringkasan". Tempat yang buktinya nipis ditampal dengan pengetahuan am, dan tampalan itu tidak dapat dibezakan nadanya daripada bahagian yang benar-benar bersandar pada sumber.
Mesyuarat anda penuh dengan topik pinggiran: dua minit tentang semakan keselamatan, vendor yang disebut sekali sahaja, angka yang diingati separuh oleh seseorang. Baris-baris itulah yang paling kurang dibincang dan paling mungkin salah — dan ia dibaca selancar bahagian yang lain.
Lapisan di bawahnya berbentuk sama. Dalam "Careless Whisper", yang dibentangkan di ACM FAccT 2024, Koenecke dan rakan-rakan mendapati kira-kira 1% transkripsi Whisper mengandungi frasa atau ayat halusinasi sepenuhnya yang tidak wujud dalam apa jua bentuk dalam audio asal, dan 38% halusinasi itu membawa mudarat yang jelas: kaitan yang direka, kewibawaan palsu, keganasan yang diada-adakan. Pencetusnya bahagian yang menarik: halusinasi berlaku secara tidak seimbang pada penutur yang mempunyai tempoh tanpa suara yang lebih panjang.
Dengan kata lain, kesenyapan. Dan mesyuarat memang dibuat daripada kesenyapan: jeda untuk berfikir, seseorang membuka bisu, skrin kongsi yang sedang dimuatkan, empat saat selepas satu soalan sukar. Itulah bahan mentah yang paling berkemungkinan diisi oleh model transkripsi dengan sesuatu yang tidak pernah diucapkan. Ini juga bermakna kesilapan transkrip dan kesilapan ringkasan tidak berdiri sendiri: satu baris rekaan dalam transkrip ialah input yang "bersandar sempurna" pada pandangan peringkas.
Anda tidak boleh memulangkan pemeriksaan kepada model
Idea yang paling jelas ialah meminta model kedua mengesahkan model pertama. Angka pengukurannya tidak memberangsangkan.
Dalam kajian TofuEval yang sama, penulis menilai model bahasa sebagai hakim binari keselarasan fakta dan mendapati kesemuanya, termasuk GPT-4, "berprestasi lemah dalam mengesan kesilapan pada ringkasan yang dijana model bahasa" — kalah kepada metrik kefaktaan bukan model bahasa yang lebih kecil dan dibina khusus untuk tugas itu. Malah ketika GPT-4 menanda sesuatu ayat dengan betul, penjelasan mengapa-nya hanya tepat kira-kira 80% daripada masa; bagi penilai lain, lebih kurang separuh.
FaithBench, yang dikeluarkan Vectara pada Oktober 2024, meletakkan angka pada siling ini. Ia mengumpulkan halusinasi yang dihasilkan sepuluh model bahasa moden daripada lapan keluarga dan yang mana pengesan sedia ada berbeza pendapat, lalu melaporkan bahawa pengesan halusinasi terbaik pun hanya mencapai ketepatan menghampiri 50%. Lambungan syiling, tepat pada kes-kes yang penting.
Jadi semakan itu tugas anda. Bunyinya seperti beban, sehinggalah anda perasan ketidakseimbangan ini: pengesan terpaksa menilai teks sembarangan terhadap dokumen yang asing baginya, sedangkan anda berada dalam bilik itu. Anda sudah pun tahu kenyataan mana yang berbunyi janggal. Tinggal periksa sahaja.
Tiga artifak, tiga tugas berbeza
Kebanyakan perdebatan "nota AI lawan nota sebenar" ialah kesilapan kategori. Satu mesyuarat menghasilkan tiga artifak, ketiga-tiganya bukan pengganti antara satu sama lain, dan pasukan yang menyimpan satu sahaja sentiasa kehilangan sesuatu yang khusus.
| Transkrip mentah | Ringkasan AI | Log keputusan | |
|---|---|---|---|
| Mengekalkan perkataan tepat | Ya — kata demi kata | Tidak — dimampatkan, kata pelembut gugur | Tidak |
| Siapa yang mengatakannya | Ya, jika penutur diasingkan | Kadangkala; salah rujuk ialah jenis kesilapan bernama | Ya — orang yang bertanggungjawab itulah intinya |
| Bila ia dikatakan | Ya — bertanda masa | Jarang | Tarikh akhir sahaja |
| Keputusan dengan penanggung jawab dan tarikh | Tertimbus dalam kira-kira 9,000 patah perkataan | Sebahagian, dan tidak boleh dipercayai | Ya — inilah satu-satunya tugasnya |
| Apa yang ditolak dan mengapa | Ya, jika ada yang menyebutnya | Selalunya dibuang kerana dianggap lewah | Ya, dalam satu baris |
| Boleh dibaca dalam 60 saat | Tidak | Ya | Ya |
| Boleh ditanding dengan bukti | Ia adalah buktinya | Hanya jika transkrip masih ada | Hanya jika kedua-duanya masih ada |
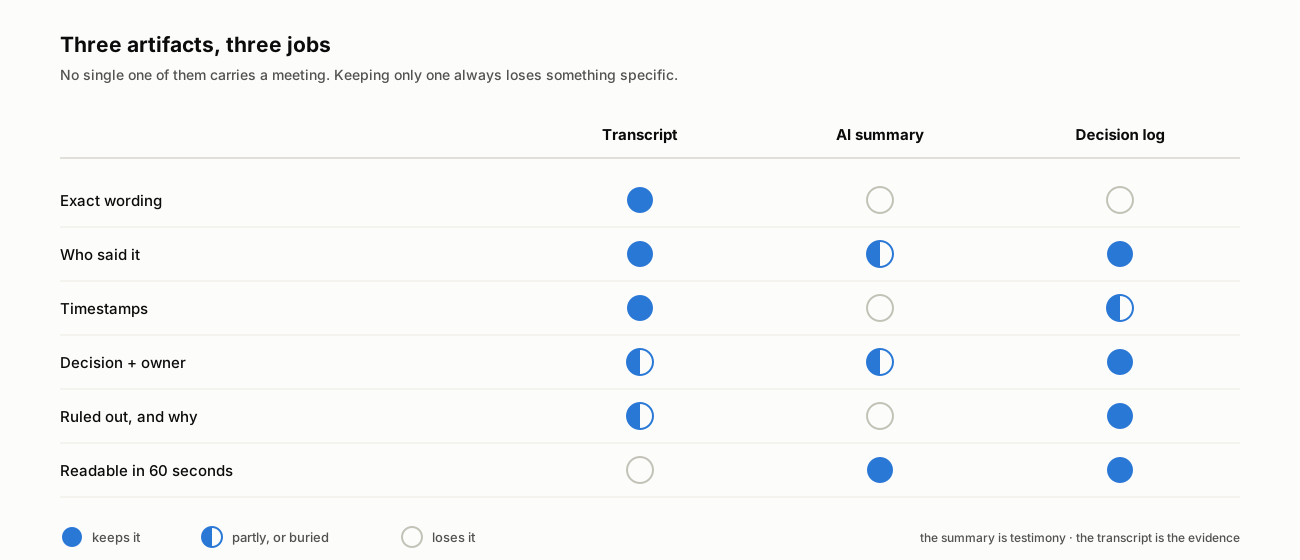
Apa yang disimpan, disimpan separuh, atau hilang bagi setiap artifak. Baris paling bawah itulah yang menentukan sama ada dua yang lain bernilai atau tidak.
Baris paling bawah itu keseluruhan hujahnya. Ringkasan tanpa transkrip yang masih tersimpan tidak boleh disangkal mahupun dibuktikan: apabila rakan sekerja berkata "bukan itu yang kita persetujui", yang anda ada ialah dua pendapat dan sifar rekod. Di sinilah nota AI lebih rapuh daripada nota manusia: minit tulisan tangan membawa kesilapannya secara jelas, dan semua orang membacanya dengan syak yang berpatutan. Prosa mesin tiba dengan tajuk kecil yang kemas dan ayat penyata yang yakin, lalu meminjam kewibawaan yang tidak pernah diusahakannya.
Sebut sahaja apa adanya: ringkasan itu keterangan saksi, transkrip itu bukti. Keterangan saksi berguna. Keterangan saksi juga perkara yang ditanding semula dengan bukti.
Semakan sembilan minit, mengikut susunan
Inilah prosedur yang kami syorkan, dengan masa disukat untuk mesyuarat 60 minit. Susunannya penting: ia meletakkan di hadapan pemeriksaan yang kosnya paling tinggi jika tersilap, supaya jika anda diganggu pada minit keempat, kesilapan yang mahal sudah pun tertangkap.
- 0:00–1:30 — Baca ayat keputusan sahaja. Pada pusingan pertama, abaikan sepenuhnya ringkasan naratifnya. Cari setiap ayat yang menyatakan hasil, komitmen atau tarikh. Dalam mesyuarat 60 minit yang biasa, bilangannya tiga hingga enam. Hanya baris-baris itu yang akan dilaksanakan sesiapa.
- 1:30–3:00 — Pulihkan modalitinya. Bagi setiap ayat itu, lompat ke titiknya dalam transkrip dan periksa kata kerjanya. Adakah orang menyebut akan, atau menyebut mungkin, patut, agaknya? Jika asalnya dilembutkan, tulis semula baris ringkasan itu dengan kata pelembutnya dikembalikan — atau lebih baik, tandakan ia sebagai soalan terbuka dengan penanggung jawab.
- 3:00–4:30 — Periksa setiap kata nama khas dan setiap angka. Nama orang, syarikat, versi, harga, tarikh, peratusan. Cari satu per satu dalam transkrip. Apa yang tidak muncul di situ ialah maklumat ekstrinsik: padam atau sahkan di luar mesyuarat. Ini kerja kotak carian, bukan kerja membaca.
- 4:30–5:30 — Sahkan siapa mengatakan apa. Bagi setiap keputusan dan setiap bantahan, pastikan siapa yang bercakap pada tanda masa itu. Salah rujuk ialah kesilapan yang lebih berkemungkinan menimbulkan masalah antara manusia berbanding masalah jadual, dan ia paling pantas diperiksa.
- 5:30–6:30 — Buru penafian yang tercicir. Cari dalam transkrip perkataan tidak, jangan, bukan, melainkan dan dan bukannya di sekitar setiap keputusan. Kesilapan percanggahan menterbalikkan makna sambil membiarkan ayat itu sempurna dari segi tatabahasa, jadi membaca semula tidak akan menemuinya — mencari akan.
- 6:30–8:00 — Tanya apa yang tertinggal. Inilah langkah yang tiada alat boleh lakukan untuk anda, kerana sesebuah ringkasan tidak mampu menandakan kecicirannya sendiri. Dua soalan: apa yang kita tolak, dan mengapa? Dan soalan mana yang gagal kita jawab? Kedua-duanya tidak terselamat daripada pemampatan, dan kedua-duanya jugalah yang menjadikan nota itu berguna enam bulan lagi.
- 8:00–9:00 — Tulis log keputusan dan hantar. Tiga hingga enam baris, setiap satu memuatkan apa yang diputuskan, siapa memegang langkah seterusnya, dan sampai bila. Pautkan ia kepada transkrip. Pautan itulah yang menjadikan keseluruhan semakan boleh disemak semula oleh orang lain.
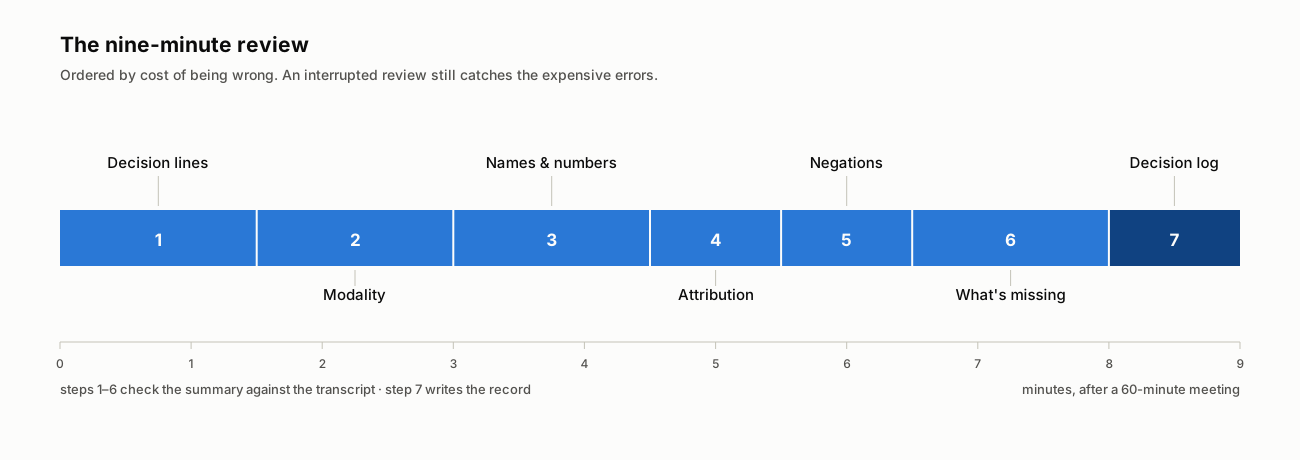
Susunan itu sendiri ialah reka bentuknya: modaliti dan butiran rekaan dahulu, kecicirian paling akhir. Semakan yang terganggu pun tetap menangkap kesilapan yang mahal.
Dua catatan untuk melakukannya secara rutin. Jika mesyuarat itu 30 minit, ini kerja empat minit. Dan jika anda melakukannya dalam alat yang menyimpan ringkasan bersama transkrip bertanda masa, langkah 2 hingga 5 menjadi carian dan klik, bukan bertukar-tukar tetingkap — itulah bezanya antara tabiat yang bertahan pada minggu sibuk dengan yang tidak.
Sepuluh saat dalam mesyuarat menjimatkan lima minit semakan
Semakan menjadi jauh lebih pendek jika maklumat itu memang sudah ada dalam rakaman sejak awal. Model tidak boleh memulihkan apa yang tidak pernah diucapkan sesiapa, dan kebanyakan perkara yang menjadikan nota kabur memang tidak pernah wujud dalam audio.
- Buka dengan soalannya, disebut dengan lantang. "Hari ini kita memutuskan sama ada migrasi dilancarkan sebelum atau selepas persidangan." Soalan yang diucapkan memberi model satu topik utama dan bukannya setimbun topik pinggiran — dan topik pinggiran itulah kes 43,6%.
- Sebut keputusan dalam satu ayat, dengan nama dan tarikh, sebelum sesiapa beredar. "Keputusan: Mina memegang susulan dengan vendor, dan tarikh September kita sahkan sebelum 25 haribulan." Setiap alat nota di pasaran menangkap ayat itu dengan sempurna. Tiada satu pun akan menciptanya untuk anda.
- Sebut penafian secara jelas. "Kita tidak menganjak tarikh pelancaran" lebih selamat daripada mengangkat bahu sambil mengangguk, kerana penafian yang tercicir ialah jenis kesilapan yang terdokumentasi — dan penafian yang tidak pernah diucapkan mustahil tercicir.
- Nyatakan apa yang ditolak dan sebabnya, dalam satu baris. "Kita ada pertimbangkan harga setiap kerusi tetapi kita tolak kerana dua pelanggan enterprise membantah suku lalu." Ayat inilah yang menghalang perdebatan yang sama daripada dibuka semula enam bulan kemudian.
- Eja sekali kata nama khas yang luar biasa. Nama vendor, nama kod dalaman dan singkatan itulah yang selalu dirosakkan transkrip, lalu diulang ringkasan dengan penuh yakin.
- Jangan biarkan kesenyapan bercakap. Jika bilik menjadi sunyi kerana semua orang sedang membaca dokumen, sebutlah begitu. Tempoh panjang tanpa suara ialah keadaan yang paling banyak menyebabkan model transkripsi berhalusinasi.
Tiada satu pun daripada ini lakonan mesyuarat. Ia mengimlakkan kandungan kepada rekod — satu kemahiran yang menjadi lebih bernilai sejak rekod mula menulis dirinya sendiri.
Kesimpulannya
Ringkasan mesyuarat tulisan AI bukanlah rekod. Ia keterangan tentang sesebuah rekod, disampaikan dengan lancar, oleh saksi yang tiada kepentingan terhadap ketepatan dan mempunyai kecenderungan terdokumentasi untuk menggugurkan perkataan "agaknya".
Pembingkaian semula itu menyelesaikan perdebatan manual-lawan-AI, yang sememangnya tidak pernah menjadi perdebatan sebenar. Simpan rakamannya, kerana itulah satu-satunya bukti. Biarkan model menulis ringkasan, kerana ia lebih pantas daripada anda dan tidak jemu pada minit keempat puluh. Kemudian luangkan sembilan minit untuk satu bahagian yang menuntut kehadiran: menanding ayat-ayat yang kedengaran yakin itu dengan apa yang benar-benar diucapkan, dan menulis tiga baris yang perlu dilaksanakan seseorang.
Pasukan yang akan terbakar pada 2026 bukanlah pasukan yang melangkau alat nota AI. Ia pasukan yang membaca outputnya seolah-olah transkrip sedangkan ia sebenarnya parafrasa — dan tidak menyimpan transkrip yang boleh menunjukkan bezanya. Versi lebih lengkap tentang apa yang perlu dimuatkan oleh nota yang baik ada dalam enam perkara yang masih diperlukan sesebuah nota mesyuarat, manakala sebab kadar kesilapan perkataan hampir tidak memberitahu apa-apa tentang kebolehgunaan sesebuah transkrip ada dalam ketepatan sahaja tidak mencukupi.
Di mana Telli.sh berada: semakan sembilan minit hanya berkesan jika ringkasan dan sumbernya tinggal di tempat yang sama. Telli.sh meletakkan transkrip bertanda masa lengkap dengan pengecaman penutur betul-betul di sebelah ringkasan AI yang boleh disunting, jadi menyemak sesuatu kenyataan hanyalah satu carian dan satu klik, bukan memburu antara dua sistem — dan apabila bilik itu tidak bertutur dalam satu bahasa, terjemahan berdiri di sebelah teks asal dan bukannya menggantikannya. Ringkasan tiba sebagai draf untuk anda betulkan, bukan hasil untuk anda terima.
Sumber
- Tang et al., "TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization", NAACL 2024 (arXiv:2402.13249, 20 Februari 2024)
- Koenecke et al., "Careless Whisper: Speech-to-Text Hallucination Harms", ACM FAccT 2024 (arXiv:2402.08021, 12 Februari 2024)
- Bao et al., "FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs", Vectara (arXiv:2410.13210, 17 Oktober 2024)
- Hu et al., "MeetingBank: A Benchmark Dataset for Meeting Summarization", ACL 2023 (arXiv:2305.17529, 27 Mei 2023)
- Wang et al., "Analyzing and Evaluating Faithfulness in Dialogue Summarization", EMNLP 2022 (arXiv:2210.11777, 21 Oktober 2022)
- Halaman imej di Wikimedia Commons
