Nessuno ha detto settembre: la revisione di nove minuti che ogni riassunto AI richiede
La ricerca sulla sintesi delle trascrizioni di riunione ha rilevato che il 30,4% dei riassunti generati da sedute di consigli comunali conteneva almeno un errore fattuale, e dietro ci sono sette tipi di errore con un nome preciso. Una guida pratica per rivedere un verbale scritto dall'AI confrontandolo con la sua stessa trascrizione: cosa controllare, in quale ordine, e cosa dire in riunione perché la revisione duri nove minuti invece di trenta.
Il riassunto era lungo tre paragrafi, ben organizzato, e sbagliato in esattamente una frase: il team ha concordato di rilasciare la migrazione a settembre.
Nessuno aveva concordato niente. Qualcuno aveva detto che settembre era probabilmente fattibile se il fornitore avesse risposto in tempo — una condizionale, pronunciata una sola volta, in mezzo a una divagazione su altro. Il modello ha eliminato la condizione, ha promosso l'ipotesi a decisione, e il verbale è arrivato a undici persone che non erano in sala. Due di loro hanno iniziato a pianificare su settembre.
Non c'è niente di esotico in tutto questo. È uno dei comportamenti meglio documentati dei sistemi di sintesi automatica, ha un nome nella letteratura scientifica e non sparirà perché il prossimo modello sarà più grande. Questo articolo ti dà tre cose: i sette modi in cui un riassunto si allontana da ciò che è stato davvero detto, una revisione di nove minuti che li intercetta tutti e sette, e le poche frasi da pronunciare in riunione che accorciano quella revisione.
In breve:
- Nel benchmark TofuEval (NAACL 2024), il 30,4% dei riassunti generati da trascrizioni reali di consigli comunali conteneva almeno un errore fattuale; sui temi marginali — le divagazioni — si saliva al 43,6%.
- Gli errori non sono rumore casuale. I ricercatori li hanno classificati in sette tipi con un nome, e i due che fanno più danni nelle riunioni sono l'opinione presentata come fatto e gli slittamenti di tempo e modalità: esattamente il punto in cui «potremmo» diventa «faremo».
- Non puoi nemmeno restituire il controllo al modello: su FaithBench (ottobre 2024) i migliori rilevatori di allucinazioni hanno raggiunto un'accuratezza vicina al 50%, e in TofuEval i valutatori basati su LLM sono stati battuti da metriche specializzate più piccole.
Immagine: Shixart1985, Wikimedia Commons, CC BY 2.0. Gli occhiali sono il punto. Qualcuno deve comunque leggerlo.
La cattura è risolta. La verifica non è mai iniziata.
Conta gli strumenti per verbali lanciati su Hacker News negli ultimi sei mesi: almeno quindici tra il 1° marzo e il 13 agosto 2026. Trascrittori on-device, blocchi note senza bot in chiamata, importatori per Obsidian, cloni open source di Granola. Tutti portano le stesse due funzioni: registrare l'audio, generare il riassunto.
Nessuno porta il terzo passaggio, l'unico in cui c'è del giudizio. Il riassunto arriva nella tua casella già impaginato, già sicuro di sé, già inviato a tutta la sala. Ciò che quel flusso afferma implicitamente è una cosa sola: questo prodotto è finito.
Ecco il punto: un riassunto generato non è il verbale della riunione. È una dichiarazione sulla riunione, prodotta da un sistema che non risponde della propria correttezza, e va letta come qualunque altro resoconto di seconda mano: confrontandola con le prove da cui proviene.
Per fortuna quelle prove sono lì accanto. Lo stesso strumento che ha prodotto il riassunto ha prodotto anche la trascrizione, e confrontarli richiede meno tempo di quanto la riunione ne abbia speso in presentazioni.
Il numero che dovrebbe cambiare il modo in cui leggi i verbali
TofuEval, pubblicato da ricercatori di Salesforce AI e collaboratori a NAACL 2024, è la cosa più vicina a una misurazione controllata che abbiamo su questo tema. Hanno preso due corpora di dialogo — uno di interviste giornalistiche e uno chiamato MeetingBank, composto da trascrizioni reali di consigli comunali statunitensi —, hanno fatto scrivere riassunti tematici a cinque modelli linguistici e hanno fatto annotare da linguisti professionisti ogni frase rispetto alla coerenza fattuale con la fonte.
Sulle trascrizioni di riunione, in media sui cinque modelli, il 30,4% dei riassunti sui temi principali conteneva almeno un'incoerenza fattuale, e si saliva al 43,6% sui temi marginali. L'articolo lo dice senza giri di parole: a parte GPT-3.5-Turbo, «circa il 40–50% dei loro riassunti contiene almeno un'incoerenza fattuale».
La riserva onesta: quei cinque modelli sono del 2023 — Vicuna, tre taglie di WizardLM e GPT-3.5-Turbo — e i modelli di frontiera odierni sono nettamente migliori sulla fedeltà ai fatti. Due risultati dello stesso studio, però, sopravvivono a questa obiezione, e sono quelli che riguardano il tuo martedì.
Primo, la scala non ha risolto il problema in modo affidabile. Sui dati delle riunioni, il tasso di errore di WizardLM-30B era inferiore di soli 3,8 punti percentuali rispetto a WizardLM-7B, pur essendo oltre quattro volte più grande; in alcuni confronti il modello più grande della stessa famiglia produceva più errori. Secondo, il numero di errori non aveva una relazione significativa con la lunghezza del riassunto (correlazione di Pearson ρ = 0,18). Un riassunto più lungo e dettagliato non è più sicuro. Aspettare un modello più grande non è un processo di revisione.
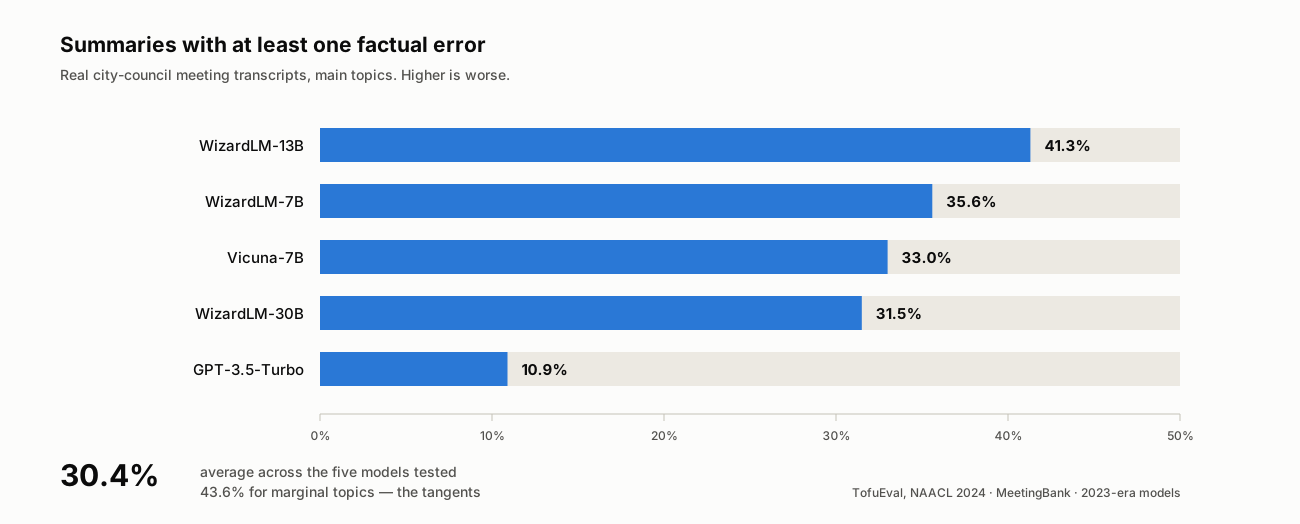
Quota di riassunti di trascrizioni reali di consigli comunali con almeno un errore fattuale, solo temi principali. Fonte: TofuEval, Tang et al., NAACL 2024 (arXiv:2402.13249). I modelli testati sono del 2023; i tipi di errore qui sotto sono sopravvissuti a loro.
Sette modi in cui un riassunto si allontana dalla sala
La cosa più utile di quello studio non è la percentuale: è la tassonomia. Sette tipi di errore con un nome, ricavati dagli annotatori a partire da migliaia di frasi segnalate, come estensione di una tassonomia precedente costruita sui dialoghi brevi.
Leggili una volta e comincerai a vederli nei tuoi verbali, perché non sono guasti casuali: sono percorsi specifici e ripetibili lungo i quali comprimere il parlato in prosa cancella una distinzione su cui la sala faceva affidamento.
| Tipo di errore (TofuEval) | Come appare in un verbale | Come intercettarlo |
|---|---|---|
| Informazione estrinseca | Un dettaglio che compare nel riassunto e in nessun punto dell'audio: un numero, il nome di un cliente, una motivazione che nessuno ha dato | Cerca il nome proprio o la cifra nella trascrizione; se non c'è, è inventato |
| Attribuzione errata | La decisione giusta assegnata alla persona sbagliata, o l'obiezione di uno accreditata a un altro | Salta al timestamp e guarda chi sta parlando |
| Opinione come fatto | «Il cambio di prezzo aumenterà l'abbandono» quando qualcuno temeva soltanto che potesse succedere | Cerca l'attenuazione nell'originale: pensa, teme, sospetta |
| Errore di ragionamento | Conti sbagliati, o un nesso causa-effetto che la sala non ha mai tracciato | Rifai ogni calcolo; chiediti se quel «perché» è stato detto o dedotto |
| Tempo / aspetto / modalità | «Potremmo rilasciare a settembre» diventa «rilasceremo a settembre» | Confronta ogni futuro con il modale originale |
| Contraddizione | Una negazione persa: «non spostiamo la scadenza» diventa «spostiamo la scadenza» | Cerca non, mai, a meno che vicino all'affermazione |
| Slittamento sottile di significato | «formulare una raccomandazione» riscritto come «formulare una richiesta» | Confronta il verbo del riassunto con il verbo della fonte |
Tre di essi si riconoscono più facilmente guardandoli in concreto. Eccoli con la trascrizione e la frase del riassunto messe una accanto all'altra.
Una negazione persa — errore di contraddizione. Ciò che è stato detto in sala:
DANIEL (00:31:12): Quindi la data di lancio non la spostiamo. Cambi pure
il resto, quella data regge.
Ciò che ne ha fatto il riassunto:
Il team ha concordato di spostare la data di lancio.
Manca una parola e la frase prescrive l'azione opposta. È anche perfettamente grammaticale, ed è esattamente per questo che la rilettura ci scivola sopra mentre una ricerca di «non» vicino alla decisione la trova in quattro secondi.
Un'attribuzione sbagliata — errore di riferimento. Ciò che è stato detto in sala:
PRIYA (00:18:40): Io sono contraria al prezzo per postazione. Due clienti
enterprise ci hanno detto lo scorso trimestre che così salta l'accordo.
MINA (00:18:55): Sì, d'accordo.
Ciò che ne ha fatto il riassunto:
Mina si è opposta al prezzo per postazione, citando il riscontro dei
clienti enterprise.
Ogni fatto in quella frase è nella trascrizione. La persona no. Tutta la difficoltà sta qui: non lo si scopre chiedendosi se le affermazioni siano vere, ma solo chiedendosi se appartengano alla persona a cui sono state appiccicate.
Una supposizione promossa — errore di modalità. Ciò che è stato detto in sala:
SAM (00:44:02): Settembre probabilmente è fattibile, se il fornitore ci
risponde in tempo.
Ciò che ne ha fatto il riassunto:
Il team ha concordato di rilasciare la migrazione a settembre.
Due qualificatori rimossi — la parola «probabilmente» e l'intera proposizione condizionale — e una supposizione condivisa è diventata un impegno con una data. Nessuno ha dovuto mentire perché accadesse. L'ha fatto la compressione.
Due meritano attenzione particolare, perché sono quelli che costano soldi veri ai team.
L'opinione presentata come fatto è l'incidente di settembre con cui apre questo articolo. In riunione la maggior parte delle frasi è attenuata: le persone pensano ad alta voce e l'attenuazione porta tutto il significato. I modelli di sintesi rimuovono le attenuazioni per costruzione, perché sono la prima cosa che si taglia comprimendo. Il risultato si legge più deciso di quanto fosse la sala, ed è proprio per questo che non viene messo in dubbio.
Gli slittamenti di modalità fanno lo stesso danno alle date. «Potrebbe», «dovrebbe», «probabilmente» e «se il fornitore ci risponde» sono la differenza tra un piano e un impegno, e sono anche le parole più economiche da eliminare. Un riassunto che dice che il team farà qualcosa a settembre ha fabbricato in silenzio una scadenza di cui nessuno è responsabile.
Nota che cosa hanno in comune. Il modello non ha inventato fatti dal nulla: ha rimosso i qualificatori. È la modifica meno visibile che possa fare, ed è quella che nessun lettore può rilevare senza la fonte davanti.
L'invenzione avviene nelle divagazioni
Nei dati c'è un secondo schema, che si sovrappone esattamente al modo in cui procedono le riunioni.
I riassunti dei temi marginali — quelli accennati di sfuggita anziché discussi a fondo — erano nettamente peggiori: 43,6% contro 30,4% sul corpus delle riunioni. I ricercatori spiegano il meccanismo: quando un tema è appena toccato nella fonte, i modelli «si affidano alle proprie conoscenze per fare inferenze sul tema, portando nel riassunto informazioni non supportate». Dove la prova è sottile si riempie con cultura generale, e quel riempimento è indistinguibile per tono dalle parti effettivamente fondate.
Le tue riunioni sono piene di temi marginali: i due minuti sulla revisione di sicurezza, il fornitore citato una volta sola, il numero che qualcuno ricordava a metà. Sono le righe meno discusse e più a rischio di essere sbagliate, e si leggeranno con la stessa scorrevolezza del resto.
Il livello sottostante ha la stessa forma. In «Careless Whisper», presentato ad ACM FAccT 2024, Koenecke e colleghi hanno rilevato che circa l'1% delle trascrizioni di Whisper conteneva intere frasi allucinate che non esistevano in alcuna forma nell'audio originale, e che il 38% di quelle allucinazioni conteneva danni espliciti: associazioni inventate, autorità fittizia, violenza fabbricata. La parte interessante è l'innesco: le allucinazioni colpivano in modo sproporzionato i parlanti con tratti non vocali più lunghi.
Il silenzio, in altre parole. Ed è di silenzio che è fatta una riunione: le pause per pensare, qualcuno che toglie il muto, uno schermo condiviso che carica, i quattro secondi dopo una domanda difficile. È esattamente la materia prima che un modello di trascrizione riempirà più facilmente con qualcosa che non è mai stato detto. Significa anche che errori di trascrizione ed errori di sintesi non sono indipendenti: una riga inventata nella trascrizione è, per il riassunto, un input perfettamente fondato.
Non puoi restituire il controllo al modello
L'idea ovvia è far verificare il primo modello da un secondo. Le misurazioni non incoraggiano.
Nello stesso studio TofuEval, gli autori hanno valutato gli LLM come giudici binari di coerenza fattuale e hanno trovato che tutti, GPT-4 incluso, «hanno prestazioni scarse nel rilevare errori nei riassunti generati da LLM», risultando inferiori a metriche di fattualità non basate su LLM, più piccole e costruite apposta. Anche quando GPT-4 segnalava correttamente una frase, la sua spiegazione del perché era giusta circa l'80% delle volte; per gli altri valutatori, all'incirca la metà.
FaithBench, pubblicato da Vectara nell'ottobre 2024, ha dato un numero a questo tetto. Ha raccolto le allucinazioni prodotte da dieci LLM moderni di otto famiglie e sulle quali i rilevatori esistenti erano in disaccordo, riportando che anche i migliori rilevatori di allucinazioni hanno raggiunto un'accuratezza vicina al 50%. Testa o croce, proprio sui casi che contano.
Quindi la revisione tocca a te. Sembra un peso finché non noti l'asimmetria: il rilevatore deve giudicare un testo qualsiasi rispetto a un documento sconosciuto, mentre tu eri in sala. Sai già quale affermazione suonava strana. Devi solo verificarla.
Tre artefatti, tre mestieri diversi
Gran parte dei dibattiti «verbali AI contro verbali veri» è un errore di categoria. Una riunione produce tre artefatti, non sono sostituibili tra loro, e un team che ne conserva uno solo perde sempre qualcosa di preciso.
| Trascrizione grezza | Riassunto AI | Registro delle decisioni | |
|---|---|---|---|
| Parole esatte conservate | Sì — alla lettera | No — compresso, le attenuazioni cadono | No |
| Chi l'ha detto | Sì, con separazione dei parlanti | A volte; l'attribuzione errata è un tipo di errore con un nome | Sì — il responsabile è lo scopo |
| Quando è stato detto | Sì — con timestamp | Raramente | Solo la scadenza |
| Decisioni con responsabile e data | Sepolte in circa 9.000 parole | In parte, e in modo inaffidabile | Sì — è la sua unica funzione |
| Cosa è stato scartato e perché | Sì, se qualcuno l'ha detto | Di solito eliminato perché ridondante | Sì, in una riga |
| Leggibile in 60 secondi | No | Sì | Sì |
| Confrontabile con le prove | È la prova | Solo se la trascrizione sopravvive | Solo se sopravvivono entrambe |
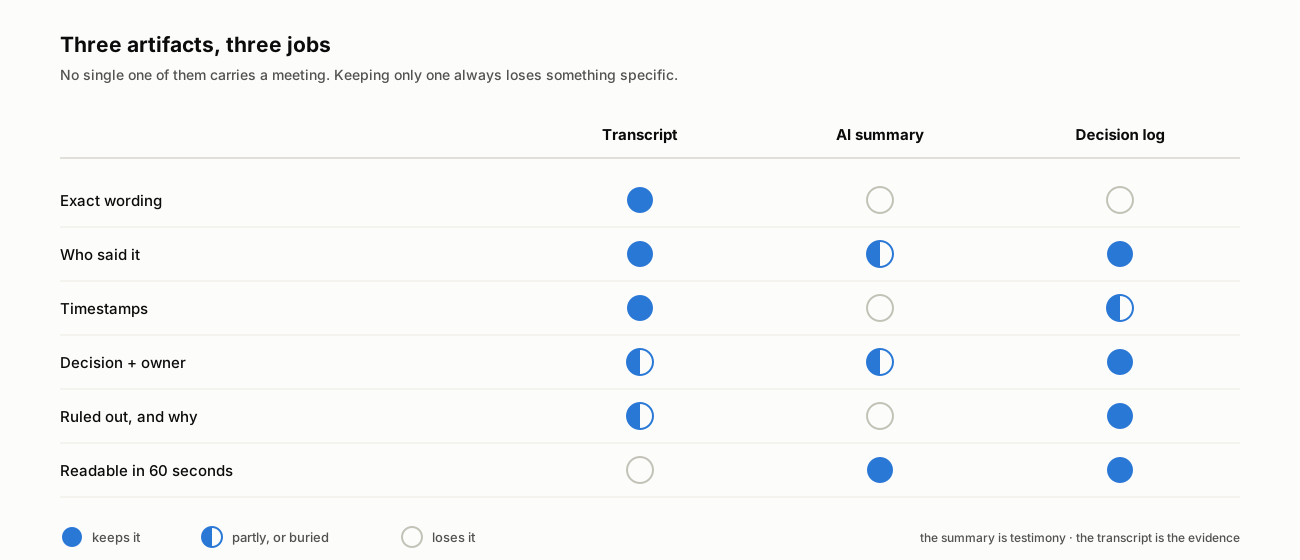
Cosa ciascun artefatto conserva, conserva a metà o perde. È l'ultima riga a decidere se gli altri due valgono qualcosa.
Quell'ultima riga è tutto l'argomento. Un riassunto senza trascrizione superstite è infalsificabile: quando un collega dice «non avevamo deciso così», hai due opinioni e zero registrazioni. Ed è proprio qui che un verbale AI è più fragile di uno umano: i verbali scritti da una persona portavano addosso la propria fallibilità in modo visibile, e tutti li leggevano con il giusto sospetto. La prosa della macchina arriva con titoletti puliti e affermazioni sicure, prendendo in prestito un'autorità che non si è guadagnata.
Chiamiamola col suo nome: il riassunto è una testimonianza, la trascrizione è la prova. Una testimonianza è utile. Una testimonianza è anche ciò che si va a verificare.
La revisione di nove minuti, in ordine
Questa è la procedura che consigliamo, cronometrata per una riunione di 60 minuti. L'ordine conta: mette per prime le verifiche il cui errore costa di più, così se ti interrompono al quarto minuto hai già catturato gli errori cari.
- 0:00–1:30 — Leggi solo le frasi di decisione. Ignora completamente il riassunto narrativo alla prima passata. Cerca ogni frase che afferma un esito, un impegno o una data. In una riunione tipica di un'ora ce ne sono da tre a sei. Sono le uniche righe su cui qualcuno agirà.
- 1:30–3:00 — Ripristina la modalità. Per ognuna di quelle frasi, salta al punto corrispondente nella trascrizione e controlla il verbo. È stato detto faremo, oppure potremmo, dovremmo, probabilmente? Se l'originale era attenuato, riscrivi la riga rimettendo l'attenuazione — o meglio, segnala la frase come domanda aperta con un responsabile.
- 3:00–4:30 — Controlla ogni nome proprio e ogni numero. Nomi, aziende, versioni, prezzi, date, percentuali. Cerca ciascuno nella trascrizione. Ciò che non compare è informazione estrinseca: cancellala o confermala fuori riunione. È lavoro da campo di ricerca, non da lettura.
- 4:30–5:30 — Verifica l'attribuzione. Per ogni decisione e ogni obiezione, conferma chi sta parlando a quel timestamp. L'attribuzione errata è l'errore che più facilmente causa un problema tra persone anziché di pianificazione, ed è il più rapido da controllare.
- 5:30–6:30 — Dai la caccia alle negazioni perse. Cerca nella trascrizione non, mai, a meno che, invece di nei dintorni di ogni decisione. Un errore di contraddizione ribalta il significato lasciando la frase grammaticalmente perfetta: rileggere non lo trova, cercare sì.
- 6:30–8:00 — Chiedi che cosa manca. È il passaggio che nessuno strumento farà al posto tuo, perché un riassunto non può segnalare le proprie omissioni. Due domande: che cosa abbiamo scartato e perché? E a quale domanda non abbiamo risposto? Nessuna delle due sopravvive alla compressione, ed entrambe sono ciò che renderà utile il verbale tra sei mesi.
- 8:00–9:00 — Scrivi il registro delle decisioni e invialo. Da tre a sei righe, ciascuna con che cosa è stato deciso, chi prende in carico il passo successivo e per quando. Collegalo alla trascrizione. È quel collegamento a rendere l'intera revisione ricontrollabile da qualcun altro.
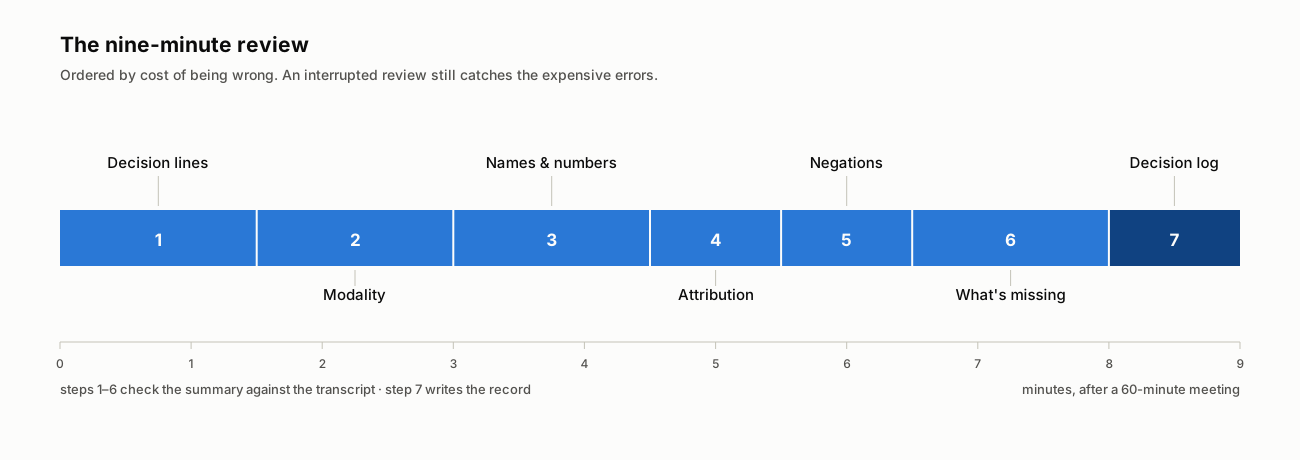
L'ordine è il progetto: modalità e dettagli inventati prima, omissioni per ultime. Una revisione interrotta cattura comunque gli errori cari.
Due note per farlo su scala. Se la riunione durava 30 minuti, è un lavoro da quattro minuti. E se lo fai nello strumento che tiene insieme il riassunto e la trascrizione con timestamp, i passaggi da 2 a 5 diventano ricerche e clic invece di continui cambi di finestra: è la differenza tra un'abitudine che sopravvive a una settimana piena e una che non ci riesce.
Dieci secondi in riunione risparmiano cinque minuti di revisione
La revisione si accorcia moltissimo se l'informazione è nella registrazione fin dall'inizio. Un modello non può recuperare ciò che nessuno ha detto, e quasi tutto ciò che rende ambiguo un verbale non è mai stato nell'audio.
- Apri con la domanda, ad alta voce. «Oggi decidiamo se la migrazione esce prima o dopo la conferenza.» Una domanda dichiarata dà al modello un tema principale invece di un insieme di temi marginali — e i marginali erano il caso al 43,6%.
- Di' la decisione in una frase, con nome e data, prima che qualcuno se ne vada. «Decisione: Mina segue il fornitore e confermiamo la data di settembre entro il 25.» Ogni strumento sul mercato cattura quella frase alla perfezione. Nessuno la inventerà.
- Pronuncia la negazione in modo esplicito. «Non spostiamo la data di lancio» è più sicuro di un'alzata di spalle e un cenno del capo, perché una negazione persa è un tipo di errore documentato, e una negazione mai pronunciata non può essere persa.
- Di' che cosa avete scartato e perché, in una riga. «Abbiamo considerato il prezzo per postazione e l'abbiamo scartato perché due clienti enterprise si sono opposti lo scorso trimestre.» È la frase che impedisce allo stesso dibattito di riaprirsi tra sei mesi.
- Scandisci una volta i nomi propri insoliti. Nomi di fornitori, nomi in codice interni e sigle sono esattamente ciò che la trascrizione storpia e il riassunto poi ripete con sicurezza.
- Non lasciar parlare il silenzio. Se la sala tace perché tutti stanno leggendo un documento, dillo. I lunghi tratti senza voce sono la condizione in cui i modelli di trascrizione allucinano di più.
Niente di tutto questo è teatro da riunione. È dettare al verbale — un'abilità che è diventata più preziosa da quando il verbale ha iniziato a scriversi da solo.
In conclusione
Un riassunto di riunione fatto dall'AI non è un verbale. È una testimonianza su un verbale, resa con scioltezza, da un testimone che non ha alcun interesse a essere accurato e con una documentata tendenza a lasciar cadere la parola «probabilmente».
Questa riformulazione chiude la discussione manuale-contro-AI, che non è mai stata una vera discussione. Conserva la registrazione, perché è l'unica prova. Lascia scrivere il riassunto al modello, perché è più veloce di te e al quarantesimo minuto non si annoia. Poi dedica nove minuti all'unica parte che richiede di esserci stati: confrontare le frasi sicure con ciò che è stato davvero detto e scrivere le tre righe su cui qualcuno deve agire.
I team che si scotteranno nel 2026 non sono quelli che hanno saltato lo strumento di verbalizzazione AI. Sono quelli che ne hanno letto l'output come una trascrizione quando era una parafrasi, e non hanno conservato la trascrizione che avrebbe mostrato la differenza. La versione completa di ciò che un buon verbale deve contenere è in le sei cose che un verbale di riunione richiede ancora, e il motivo per cui il tasso di errore sulle parole dice quasi nulla sull'usabilità di una trascrizione è in l'accuratezza non basta.
Dove si colloca Telli.sh: la revisione di nove minuti funziona solo se riassunto e fonte vivono nello stesso posto. Telli.sh tiene la trascrizione con timestamp e attribuzione dei parlanti accanto a un riassunto AI modificabile, così verificare un'affermazione è una ricerca e un clic invece di una caccia tra due sistemi; e quando in sala non si parla una lingua sola, la traduzione sta accanto all'originale invece di sostituirlo. Il riassunto arriva come una bozza da correggere, non come un risultato da accettare.
Fonti
- Tang et al., «TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization», NAACL 2024 (arXiv:2402.13249, 20 febbraio 2024)
- Koenecke et al., «Careless Whisper: Speech-to-Text Hallucination Harms», ACM FAccT 2024 (arXiv:2402.08021, 12 febbraio 2024)
- Bao et al., «FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs», Vectara (arXiv:2410.13210, 17 ottobre 2024)
- Hu et al., «MeetingBank: A Benchmark Dataset for Meeting Summarization», ACL 2023 (arXiv:2305.17529, 27 maggio 2023)
- Wang et al., «Analyzing and Evaluating Faithfulness in Dialogue Summarization», EMNLP 2022 (arXiv:2210.11777, 21 ottobre 2022)
- Pagina dell'immagine su Wikimedia Commons
