Tidak ada yang bilang September: sembilan menit peninjauan yang dibutuhkan setiap ringkasan rapat AI
Riset tentang peringkasan transkrip rapat menemukan 30,4% ringkasan yang dihasilkan dari sidang dewan kota mengandung setidaknya satu kesalahan faktual, dengan tujuh jenis kesalahan bernama di baliknya. Panduan praktis meninjau catatan rapat buatan AI terhadap transkripnya sendiri: apa yang diperiksa, dalam urutan apa, dan apa yang perlu diucapkan di ruang rapat agar peninjauan cukup sembilan menit, bukan tiga puluh.
Ringkasan itu tiga paragraf, tersusun rapi, dan salah tepat di satu kalimat: tim sepakat merilis migrasi pada bulan September.
Tidak ada yang menyepakati itu. Seseorang berkata September kemungkinan bisa dikejar kalau vendor membalas tepat waktu — sebuah kalimat bersyarat, diucapkan sekali, di tengah pembicaraan yang sedang melenceng ke hal lain. Model membuang syaratnya, menaikkan dugaan menjadi keputusan, dan catatan itu terkirim ke sebelas orang yang tidak ada di ruangan. Dua di antaranya mulai menyusun rencana berdasarkan September.
Tidak ada yang aneh dari kejadian ini. Ini salah satu perilaku sistem peringkas otomatis yang paling terdokumentasi, punya nama sendiri dalam literatur riset, dan tidak akan hilang hanya karena model berikutnya lebih besar. Tulisan ini memberi tiga hal: tujuh cara sebuah ringkasan menyimpang dari apa yang benar-benar diucapkan, peninjauan sembilan menit yang menangkap ketujuhnya, dan beberapa kalimat yang diucapkan saat rapat yang membuat peninjauan itu lebih singkat.
Ringkasnya:
- Dalam tolok ukur TofuEval (NAACL 2024), 30,4% ringkasan yang dihasilkan dari transkrip sidang dewan kota sungguhan mengandung setidaknya satu kesalahan faktual; untuk topik pinggiran — pembicaraan yang melenceng — angkanya naik ke 43,6%.
- Kesalahannya bukan derau acak. Peneliti mengelompokkannya menjadi tujuh jenis bernama, dan dua yang paling merugikan rapat adalah menyajikan pendapat sebagai fakta dan pergeseran kala dan modalitas — persis titik ketika "kita mungkin bisa" berubah menjadi "kita akan".
- Pemeriksaannya juga tidak bisa dikembalikan ke model: pada FaithBench (Oktober 2024), detektor halusinasi terbaik hanya mencapai akurasi sekitar 50%, dan dalam TofuEval para penilai berbasis model bahasa kalah oleh metrik khusus yang lebih kecil.
Foto: Shixart1985, Wikimedia Commons, CC BY 2.0. Kacamatanya justru intinya. Pada akhirnya tetap ada yang harus membaca.
Perekaman sudah beres. Pemeriksaan belum pernah dimulai.
Hitung saja peralatan catatan rapat yang diluncurkan di Hacker News dalam enam bulan terakhir: sedikitnya lima belas antara 1 Maret dan 13 Agustus 2026. Transkriber yang jalan di perangkat sendiri, notepad tanpa bot masuk ke panggilan, pengimpor untuk Obsidian, klon Granola sumber terbuka. Semuanya membawa dua fitur yang sama: rekam audio, hasilkan ringkasan.
Tidak satu pun membawa langkah ketiga, satu-satunya langkah yang memerlukan pertimbangan. Ringkasan itu masuk ke kotak masuk Anda sudah rapi formatnya, sudah percaya diri, sudah terkirim ke seisi ruangan. Yang secara diam-diam diklaim alur kerja itu cuma satu: hasil ini sudah jadi.
Inilah intinya: ringkasan yang dihasilkan model bukan rekaman rapat. Ia adalah pernyataan tentang rapat, dibuat oleh sistem yang tidak bertanggung jawab atas kebenarannya, dan sepatutnya dibaca seperti keterangan tangan kedua mana pun — yakni diadu dengan bukti asalnya.
Untungnya bukti itu ada tepat di sebelahnya. Alat yang membuat ringkasan juga membuat transkripnya, dan mengadu keduanya memakan waktu lebih singkat daripada sesi perkenalan di awal rapat.
Angka yang seharusnya mengubah cara Anda membaca notulen
TofuEval, diterbitkan oleh peneliti Salesforce AI bersama kolaboratornya di NAACL 2024, adalah yang paling mendekati pengukuran terkendali yang kita punya untuk soal ini. Mereka mengambil dua korpus dialog — satu berisi wawancara berita, satu lagi bernama MeetingBank yang terdiri dari transkrip sidang dewan kota sungguhan di Amerika Serikat — meminta lima model bahasa menulis ringkasan per topik, lalu meminta ahli bahasa profesional menandai setiap kalimat ringkasan berdasarkan kesesuaiannya dengan sumber.
Pada transkrip rapat, rata-rata dari lima model, 30,4% ringkasan mengenai topik utama mengandung setidaknya satu ketidaksesuaian faktual, dan naik ke 43,6% untuk topik pinggiran. Makalahnya menyebutkan terus terang: kecuali GPT-3.5-Turbo, "sekitar 40–50% ringkasan mereka mengandung setidaknya satu ketidaksesuaian faktual".
Catatan jujurnya: kelima model itu dari 2023 — Vicuna, tiga ukuran WizardLM, dan GPT-3.5-Turbo — dan model terdepan hari ini jelas lebih baik soal kesetiaan pada fakta. Namun ada dua temuan dari makalah yang sama yang tetap bertahan terhadap keberatan itu, dan justru dua itulah yang menyentuh hari Selasa Anda.
Pertama, skala tidak menyelesaikannya secara andal. Pada data rapat, tingkat kesalahan WizardLM-30B hanya 3,8 poin persentase lebih rendah dari WizardLM-7B, padahal ukurannya lebih dari empat kali lipat; pada sebagian perbandingan, model yang lebih besar dalam keluarga yang sama justru menghasilkan lebih banyak kesalahan. Kedua, jumlah kesalahan tidak berhubungan berarti dengan panjang ringkasan (korelasi Pearson ρ = 0,18). Ringkasan yang lebih panjang dan rinci bukan berarti lebih aman. Menunggu model yang lebih besar bukanlah proses peninjauan.
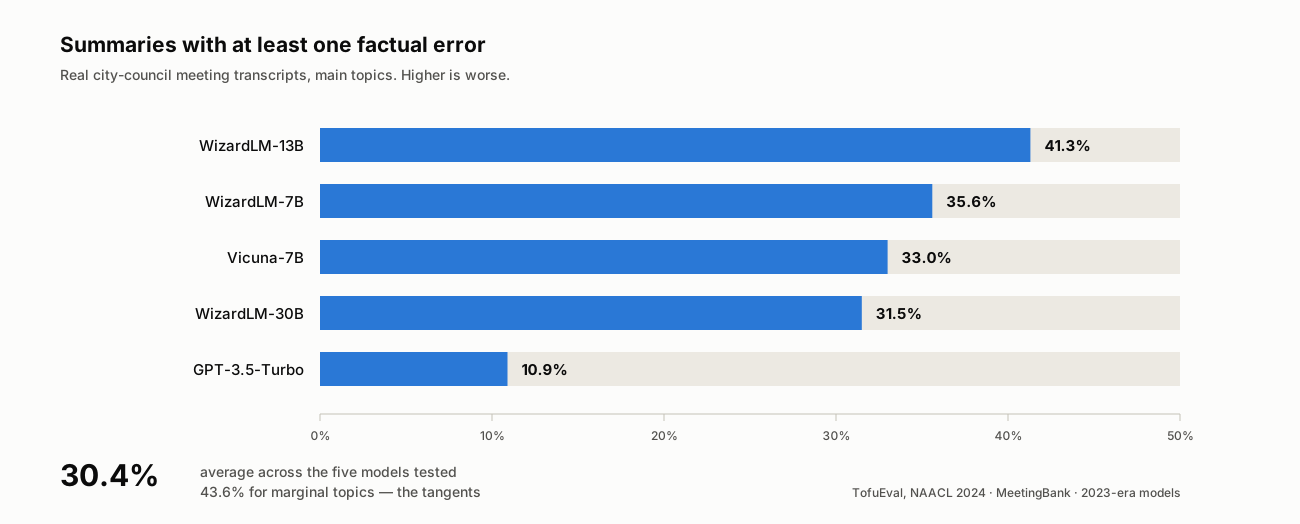
Proporsi ringkasan dari transkrip sidang dewan kota sungguhan yang mengandung setidaknya satu kesalahan faktual, khusus topik utama. Sumber: TofuEval, Tang dkk., NAACL 2024 (arXiv:2402.13249). Model yang diuji dari generasi 2023; jenis-jenis kesalahan di bawah ini berumur lebih panjang daripada model-model itu.
Tujuh cara ringkasan menyimpang dari ruang rapat
Yang paling berguna dari makalah itu bukan angka persentasenya, melainkan taksonominya: tujuh jenis kesalahan bernama yang diturunkan para penandai dari ribuan kalimat bermasalah, sebagai perluasan taksonomi terdahulu yang dibangun atas dialog pendek.
Baca sekali saja, lalu Anda akan mulai melihatnya di catatan Anda sendiri. Sebab ini bukan gangguan acak, melainkan jalur spesifik dan berulang di mana pemampatan ucapan menjadi prosa menghapus pembeda yang justru diandalkan oleh ruang rapat.
| Jenis kesalahan (TofuEval) | Wujudnya dalam catatan rapat | Cara menangkapnya |
|---|---|---|
| Informasi ekstrinsik | Detail yang muncul di ringkasan dan tidak ada di audio mana pun — sebuah angka, nama klien, alasan yang tak pernah diberikan siapa pun | Cari nama diri atau angka itu di transkrip; kalau nihil, berarti dikarang |
| Salah rujuk | Keputusan yang benar dilekatkan pada orang yang salah, atau keberatan si A tercatat sebagai milik si B | Lompat ke penanda waktunya dan lihat siapa yang sedang bicara |
| Pendapat jadi fakta | "Perubahan harga akan menaikkan angka berhenti berlangganan" padahal seseorang hanya mengkhawatirkan kemungkinannya | Cari kata pelunak di sumbernya: mengira, khawatir, menduga |
| Kesalahan penalaran | Hitungan meleset, atau hubungan sebab-akibat yang tak pernah ditarik di ruangan | Hitung ulang setiap angka; tanyakan apakah "karena" itu diucapkan atau disimpulkan |
| Kala / aspek / modalitas | "Kita mungkin bisa rilis September" menjadi "kita akan rilis September" | Adu setiap kata kerja bentuk mendatang dengan modalitas aslinya |
| Kontradiksi | Penyangkalan yang hilang: "kita tidak menggeser tenggat" menjadi "kita menggeser tenggat" | Cari tidak, jangan, kecuali di sekitar pernyataan itu |
| Pergeseran makna halus | "memberikan rekomendasi" ditulis ulang menjadi "mengajukan permintaan" | Bandingkan kata kerja di ringkasan dengan kata kerja di sumber |
Tiga di antaranya paling mudah dikenali kalau dilihat wujudnya. Berikut masing-masing, dengan transkrip dan kalimat ringkasan diletakkan bersebelahan.
Penyangkalan yang hilang — kesalahan kontradiksi. Yang diucapkan di ruangan:
DANIEL (00:31:12): Jadi tanggal peluncuran tidak kita geser. Apa pun
yang berubah, tanggal itu tetap.
Yang ditulis ringkasan:
Tim sepakat menggeser tanggal peluncuran.
Satu kata hilang, dan kalimat itu kini memerintahkan tindakan sebaliknya. Ia pun sempurna secara tata bahasa, justru karena itulah membaca ulang meleset darinya, sementara mencari kata "tidak" di dekat keputusan menangkapnya dalam empat detik.
Salah menempelkan orang — kesalahan salah rujuk. Yang diucapkan di ruangan:
PRIYA (00:18:40): Saya menolak harga per kursi. Kuartal lalu dua
pelanggan enterprise bilang ke kita, model itu bikin dealnya batal.
MINA (00:18:55): Iya, setuju.
Yang ditulis ringkasan:
Mina menolak harga per kursi dengan merujuk masukan pelanggan enterprise.
Setiap fakta dalam kalimat itu ada di transkrip. Orangnya yang tidak. Di situlah letak seluruh kesulitannya: kesalahan ini tak bisa ditangkap dengan bertanya apakah pernyataannya benar, hanya dengan bertanya apakah pernyataan itu memang milik orang yang dilekati.
Dugaan yang dinaikkan pangkat — kesalahan modalitas. Yang diucapkan di ruangan:
SAM (00:44:02): September kemungkinan bisa dikejar, kalau vendor
membalas ke kita tepat waktu.
Yang ditulis ringkasan:
Tim sepakat merilis migrasi pada bulan September.
Dua pembatas makna dibuang — kata "kemungkinan" dan seluruh anak kalimat bersyarat — lalu sebuah dugaan bersama berubah menjadi komitmen bertanggal. Tak seorang pun perlu berbohong untuk itu terjadi. Pemampatanlah yang melakukannya.
Dua di antaranya patut diperhatikan khusus, karena keduanya benar-benar merugikan tim secara finansial.
Pendapat jadi fakta adalah persis insiden September di awal tulisan ini. Dalam rapat, sebagian besar kalimat dilunakkan — orang sedang berpikir dengan bersuara, dan kata pelunak itulah yang memikul seluruh maknanya. Model peringkas membuang pelunak karena memang begitu rancangannya: itulah yang pertama dipangkas saat memampatkan teks. Hasilnya terbaca lebih tegas daripada keadaan ruangan sebenarnya, dan justru karena itulah tak ada yang mempertanyakannya.
Pergeseran modalitas melakukan kerusakan yang sama pada tanggal. "Mungkin", "sebaiknya", "kemungkinan besar", dan "kalau vendor membalas" adalah pembeda antara rencana dan komitmen, sekaligus kata yang paling murah untuk dibuang. Ringkasan yang menyatakan tim akan melakukan sesuatu pada September telah diam-diam memproduksi tenggat yang tak seorang pun memilikinya.
Perhatikan kesamaan keduanya. Model tidak mengarang fakta dari kehampaan: ia menghapus pembatas makna. Itu suntingan paling tak kentara yang bisa ia lakukan, dan yang tak mungkin dideteksi pembaca tanpa sumbernya di depan mata.
Karangan muncul di percakapan yang melenceng
Ada pola kedua dalam data yang persis menempel pada cara rapat berlangsung.
Ringkasan topik pinggiran — hal-hal yang disinggung sekilas alih-alih dibahas panjang — jauh lebih buruk: 43,6% berbanding 30,4% pada korpus rapat. Peneliti menjelaskan mekanismenya: ketika sebuah topik nyaris tak tercakup di sumber, model "bersandar pada pengetahuannya sendiri untuk menarik kesimpulan tentang topik itu, sehingga membawa informasi tanpa dasar ke dalam ringkasan". Tempat yang buktinya tipis ditambal dengan pengetahuan umum, dan tambalan itu tak bisa dibedakan nadanya dari bagian yang memang berdasar.
Rapat Anda penuh topik pinggiran: dua menit soal tinjauan keamanan, vendor yang disebut sekali saja, angka yang diingat setengah-setengah oleh seseorang. Baris-baris itulah yang paling sedikit dibahas dan paling mungkin keliru — dan terbaca semulus bagian lainnya.
Lapisan di bawahnya berbentuk sama. Dalam "Careless Whisper", yang dipresentasikan di ACM FAccT 2024, Koenecke dan rekan menemukan sekitar 1% transkripsi Whisper mengandung frasa atau kalimat halusinasi utuh yang tidak ada dalam bentuk apa pun di audio aslinya, dan 38% halusinasi itu membawa bahaya eksplisit: kaitan yang dikarang, otoritas palsu, kekerasan yang direka. Pemicunya bagian yang menarik: halusinasi muncul secara tidak proporsional pada penutur dengan durasi tanpa suara yang lebih panjang.
Dengan kata lain, keheningan. Dan rapat memang terbuat dari keheningan: jeda untuk berpikir, seseorang membuka mute, layar bersama yang sedang dimuat, empat detik setelah pertanyaan sulit. Itulah bahan mentah yang paling mungkin diisi model transkripsi dengan sesuatu yang tak pernah diucapkan. Ini juga berarti kesalahan transkrip dan kesalahan ringkasan tidak berdiri sendiri-sendiri: satu baris karangan di transkrip adalah masukan yang "berdasar sempurna" bagi peringkas.
Pemeriksaan tidak bisa dikembalikan ke model
Ide yang paling gampang terpikir adalah menyuruh model kedua memverifikasi model pertama. Hasil pengukurannya tidak menggembirakan.
Dalam studi TofuEval yang sama, penulis menguji model bahasa sebagai penilai biner atas kesesuaian faktual dan menemukan bahwa semuanya, termasuk GPT-4, "berkinerja buruk dalam mendeteksi kesalahan pada ringkasan buatan model bahasa" — kalah oleh metrik faktualitas non-model-bahasa yang lebih kecil dan dibangun khusus untuk tugas itu. Bahkan ketika GPT-4 menandai sebuah kalimat dengan benar, penjelasan mengapa-nya hanya tepat sekitar 80% dari waktu; untuk penilai lain, sekitar separuhnya.
FaithBench, yang dirilis Vectara pada Oktober 2024, memberi angka pada langit-langit ini. Ia mengumpulkan halusinasi dari sepuluh model bahasa modern dari delapan keluarga yang membuat detektor-detektor yang ada saling berbeda pendapat, lalu melaporkan bahwa bahkan detektor halusinasi terbaik pun hanya mencapai akurasi mendekati 50%. Lempar koin, tepat pada kasus-kasus yang penting.
Jadi peninjauan itu tugas Anda. Terdengar seperti beban, sampai Anda menyadari ketimpangannya: detektor harus menilai teks sembarang terhadap dokumen yang asing baginya, sedangkan Anda ada di ruangan itu. Anda sudah tahu pernyataan mana yang terasa janggal. Tinggal diperiksa saja.
Tiga artefak, tiga tugas berbeda
Sebagian besar perdebatan "catatan AI versus catatan sungguhan" adalah salah kategori. Sebuah rapat menghasilkan tiga artefak, ketiganya tidak saling menggantikan, dan tim yang hanya menyimpan satu selalu kehilangan sesuatu yang spesifik.
| Transkrip mentah | Ringkasan AI | Log keputusan | |
|---|---|---|---|
| Menjaga kata-kata persisnya | Ya — kata demi kata | Tidak — dimampatkan, pelunak berguguran | Tidak |
| Siapa yang mengucapkannya | Ya, jika penutur dipisahkan | Kadang; salah rujuk adalah jenis kesalahan bernama | Ya — penanggung jawab justru intinya |
| Kapan diucapkan | Ya — bertanda waktu | Jarang | Hanya tenggatnya |
| Keputusan dengan penanggung jawab dan tanggal | Terkubur dalam sekitar 9.000 kata | Sebagian, dan tidak bisa diandalkan | Ya — ini satu-satunya tugasnya |
| Apa yang dicoret dan mengapa | Ya, kalau ada yang mengucapkannya | Biasanya dibuang karena dianggap mubazir | Ya, dalam satu baris |
| Terbaca dalam 60 detik | Tidak | Ya | Ya |
| Bisa diadu dengan bukti | Ia adalah buktinya | Hanya jika transkripnya tersisa | Hanya jika keduanya tersisa |
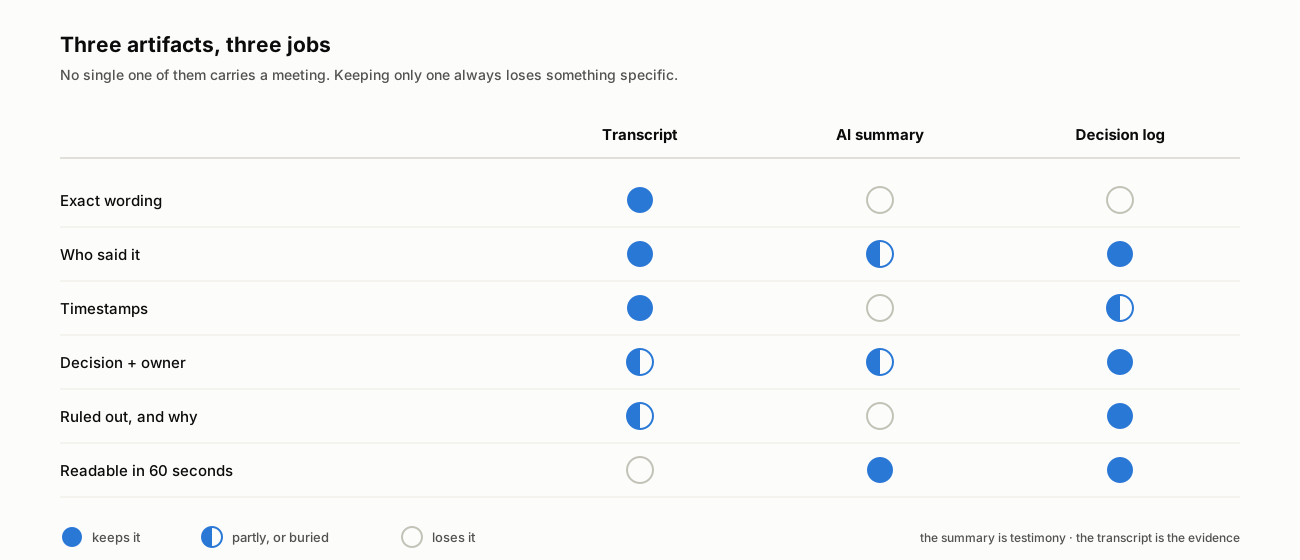
Apa yang disimpan, disimpan separuh, atau hilang pada tiap artefak. Baris paling bawah itulah yang menentukan apakah dua lainnya ada gunanya.
Baris paling bawah itu seluruh argumennya. Ringkasan tanpa transkrip yang tersisa tidak bisa dibantah maupun dibuktikan: ketika rekan berkata "bukan itu yang kita sepakati", yang Anda punya adalah dua pendapat dan nol rekaman. Justru di sinilah catatan AI lebih rapuh dibanding catatan manusia: notulen tulisan orang membawa kekeliruannya secara kasatmata, dan semua orang membacanya dengan curiga secukupnya. Prosa mesin datang dengan subjudul rapi dan kalimat pernyataan yang mantap, meminjam otoritas yang tak pernah ia peroleh.
Sebut saja apa adanya: ringkasan itu kesaksian, transkrip itu bukti. Kesaksian itu berguna. Kesaksian juga hal yang mesti diperiksa.
Peninjauan sembilan menit, berurutan
Ini prosedur yang kami sarankan, dengan waktu untuk rapat 60 menit. Urutannya penting: pemeriksaan dengan ongkos kesalahan tertinggi diletakkan di depan, sehingga bila Anda terputus di menit keempat, kesalahan yang mahal sudah tertangkap.
- 0:00–1:30 — Baca hanya kalimat keputusan. Pada babak pertama, abaikan sama sekali ringkasan naratifnya. Cari setiap kalimat yang menyatakan hasil, komitmen, atau tanggal. Dalam rapat 60 menit yang lazim, jumlahnya tiga sampai enam. Hanya baris-baris itu yang akan dikerjakan orang.
- 1:30–3:00 — Pulihkan modalitasnya. Untuk tiap kalimat itu, lompat ke titiknya di transkrip dan periksa kata kerjanya. Apakah tadi diucapkan akan, atau mungkin, sebaiknya, kemungkinan besar? Kalau aslinya dilunakkan, tulis ulang baris ringkasannya dengan pelunak itu dikembalikan — atau lebih baik lagi, tandai sebagai pertanyaan terbuka dengan penanggung jawab.
- 3:00–4:30 — Periksa setiap nama diri dan angka. Nama orang, perusahaan, versi, harga, tanggal, persentase. Cari satu per satu di transkrip. Yang tidak muncul di sana adalah informasi ekstrinsik: hapus atau konfirmasi di luar rapat. Ini pekerjaan kotak pencarian, bukan pekerjaan membaca.
- 4:30–5:30 — Verifikasi siapa mengucapkan apa. Untuk tiap keputusan dan tiap keberatan, pastikan siapa yang berbicara di penanda waktu itu. Salah rujuk adalah kesalahan yang lebih mungkin menimbulkan masalah antarorang ketimbang masalah jadwal, dan paling cepat diperiksa.
- 5:30–6:30 — Buru penyangkalan yang hilang. Cari di transkrip kata tidak, bukan, jangan, kecuali, dan alih-alih di sekitar tiap keputusan. Kesalahan kontradiksi membalik makna sambil membiarkan kalimatnya tetap sempurna secara tata bahasa, jadi membaca ulang tak akan menemukannya — mencari akan.
- 6:30–8:00 — Tanyakan apa yang hilang. Inilah langkah yang tak bisa dikerjakan alat apa pun untuk Anda, sebab ringkasan tidak bisa menandai kelalaiannya sendiri. Dua pertanyaan: apa yang kita coret, dan mengapa? Lalu pertanyaan mana yang gagal kita jawab? Keduanya tidak selamat dari pemampatan, dan keduanya pula yang membuat catatan itu berguna enam bulan lagi.
- 8:00–9:00 — Tulis log keputusan dan kirim. Tiga sampai enam baris, masing-masing memuat apa yang diputuskan, siapa yang memegang langkah berikutnya, dan sampai kapan. Tautkan ke transkrip. Tautan itulah yang membuat seluruh peninjauan bisa diperiksa ulang orang lain.
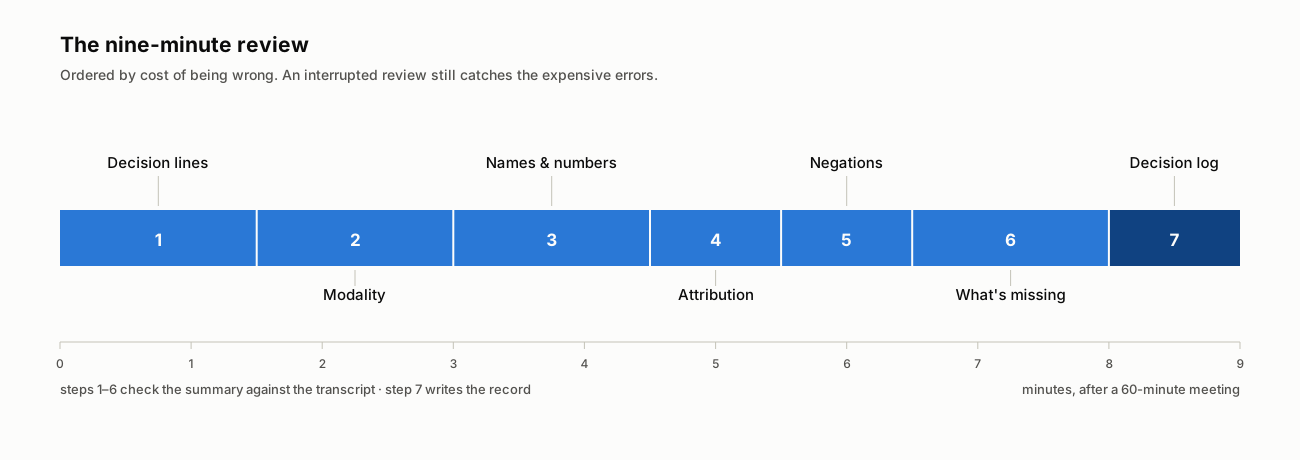
Urutannya adalah rancangannya: modalitas dan detail karangan lebih dulu, kelalaian paling belakang. Peninjauan yang terputus pun tetap menangkap kesalahan yang mahal.
Dua catatan agar ini bisa dijalankan rutin. Kalau rapatnya 30 menit, ini pekerjaan empat menit. Dan kalau Anda mengerjakannya di dalam alat yang menyimpan ringkasan sekaligus transkrip bertanda waktu, langkah 2 sampai 5 menjadi soal mencari dan mengeklik alih-alih berpindah jendela — dan di situlah beda antara kebiasaan yang bertahan di minggu sibuk dan yang tidak.
Sepuluh detik di rapat menghemat lima menit peninjauan
Peninjauan menjadi jauh lebih singkat kalau informasinya memang sudah ada di rekaman sejak awal. Model tidak bisa memulihkan apa yang tak pernah diucapkan siapa pun, dan sebagian besar hal yang membuat catatan ambigu memang tak pernah ada di audio.
- Buka dengan pertanyaannya, diucapkan lantang. "Hari ini kita memutuskan apakah migrasi dirilis sebelum atau sesudah konferensi." Pertanyaan yang diucapkan memberi model sebuah topik utama alih-alih setumpuk topik pinggiran — dan topik pinggiran itulah kasus 43,6%.
- Ucapkan keputusannya dalam satu kalimat, lengkap dengan nama dan tanggal, sebelum ada yang pergi. "Keputusan: Mina memegang tindak lanjut ke vendor, dan tanggal September kita pastikan sebelum tanggal 25." Setiap alat catatan di pasaran menangkap kalimat itu dengan sempurna. Tak satu pun akan mengarangnya untuk Anda.
- Ucapkan penyangkalan secara eksplisit. "Kita tidak menggeser tanggal peluncuran" lebih aman daripada mengangkat bahu lalu mengangguk, sebab penyangkalan yang hilang adalah jenis kesalahan yang terdokumentasi — dan penyangkalan yang tak pernah diucapkan mustahil hilang.
- Sebutkan apa yang ditolak dan mengapa, dalam satu baris. "Kita sempat mempertimbangkan harga per kursi tapi kita tolak karena kuartal lalu dua pelanggan enterprise keberatan." Kalimat inilah yang mencegah perdebatan yang sama dibuka lagi enam bulan kemudian.
- Ejakan sekali nama diri yang tidak lazim. Nama vendor, nama sandi internal, dan singkatan justru itulah yang dirusak transkrip lalu diulang ringkasan dengan penuh percaya diri.
- Jangan biarkan keheningan yang berbicara. Kalau ruangan mendadak sunyi karena semua sedang membaca dokumen, katakan begitu. Rentang panjang tanpa suara adalah kondisi ketika model transkripsi paling banyak berhalusinasi.
Tak satu pun dari ini adalah sandiwara rapat. Ini mendiktekan isi ke dalam rekaman — keterampilan yang justru makin berharga sejak rekaman mulai menulis dirinya sendiri.
Intinya
Ringkasan rapat buatan AI bukanlah rekaman. Ia kesaksian tentang sebuah rekaman, disampaikan dengan lancar, oleh saksi yang tak punya kepentingan atas ketepatan dan punya kecenderungan terdokumentasi untuk menjatuhkan kata "kemungkinan".
Pembingkaian ulang itu menyelesaikan perdebatan manual-lawan-AI, yang memang tak pernah jadi perdebatan sungguhan. Simpan rekamannya, karena itu satu-satunya bukti. Biarkan model menulis ringkasan, karena ia lebih cepat dari Anda dan tak pernah bosan di menit keempat puluh. Lalu habiskan sembilan menit untuk satu bagian yang menuntut kehadiran: mengadu kalimat-kalimat yang terdengar yakin itu dengan apa yang sungguh diucapkan, dan menuliskan tiga baris yang harus dikerjakan seseorang.
Tim yang bakal terbakar pada 2026 bukanlah tim yang melewatkan alat catatan AI, melainkan tim yang membaca keluarannya seolah itu transkrip padahal itu parafrase — dan tidak menyimpan transkrip yang bisa memperlihatkan bedanya. Versi lebih lengkap tentang apa yang harus dimuat sebuah catatan yang baik ada di enam hal yang tetap dibutuhkan catatan rapat, sedangkan alasan tingkat kesalahan kata nyaris tak mengatakan apa pun soal kelayakan pakai sebuah transkrip ada di akurasi saja tidak cukup.
Di mana Telli.sh berperan: peninjauan sembilan menit hanya berhasil kalau ringkasan dan sumbernya tinggal di tempat yang sama. Telli.sh menaruh transkrip bertanda waktu berikut identitas penutur tepat di sebelah ringkasan AI yang bisa disunting, sehingga memeriksa sebuah pernyataan cukup dengan mencari dan mengeklik alih-alih berburu di dua sistem — dan ketika isi ruangan tidak berbicara dalam satu bahasa, terjemahannya berdiri di samping teks aslinya, bukan menggantikannya. Ringkasan datang sebagai draf yang Anda koreksi, bukan keluaran yang harus Anda terima.
Sumber
- Tang dkk., "TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization", NAACL 2024 (arXiv:2402.13249, 20 Februari 2024)
- Koenecke dkk., "Careless Whisper: Speech-to-Text Hallucination Harms", ACM FAccT 2024 (arXiv:2402.08021, 12 Februari 2024)
- Bao dkk., "FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs", Vectara (arXiv:2410.13210, 17 Oktober 2024)
- Hu dkk., "MeetingBank: A Benchmark Dataset for Meeting Summarization", ACL 2023 (arXiv:2305.17529, 27 Mei 2023)
- Wang dkk., "Analyzing and Evaluating Faithfulness in Dialogue Summarization", EMNLP 2022 (arXiv:2210.11777, 21 Oktober 2022)
- Halaman gambar di Wikimedia Commons
