共用笔记本能离线朗读一节契维语课吗?
Africa TTS 0.5.0 为 92 种非洲语言和英语提供默认语音。一次实用的离线语音试验应该测些什么?
想象一个社区学习中心,只有一台共用笔记本,网络时断时续。老师有一份简短的契维语阅读练习,想让学生听两遍,答题前一遍,对答案时一遍。录音是最直接的办法。讲稿经常修改、老师需要不同版本的练习,或者还没有经过审核的录音时,文本转语音工具就有了用处。
AfriSpeech 于 2026 年 11 月 8 日发布了 Africa TTS 0.5.0。据发布说明,该软件包可将 92 种非洲语言和英语的文本合成为语音,每种语言都有默认声音。它可以用 CPU 运行,下载并缓存模型后能离线合成。维护者还公开了在线演示和试听样例。花时间安装前,可以先听一听需要用到的语言。PyPI 版本发布 · 官方试听样例
学习中心真正需要回答的问题,比语言数量更具体。听者能不能在共用笔记本上,用自己熟悉的语言变体听清要说的词,并跟上材料?这需要同时测试听感与设备。两项检查都最好从中心平时使用的句子开始。
2017 年拍摄的加纳广播录音室背景照片,摄影 Joy Agyepong。依据 CC BY-SA 4.0 调整尺寸。原始照片

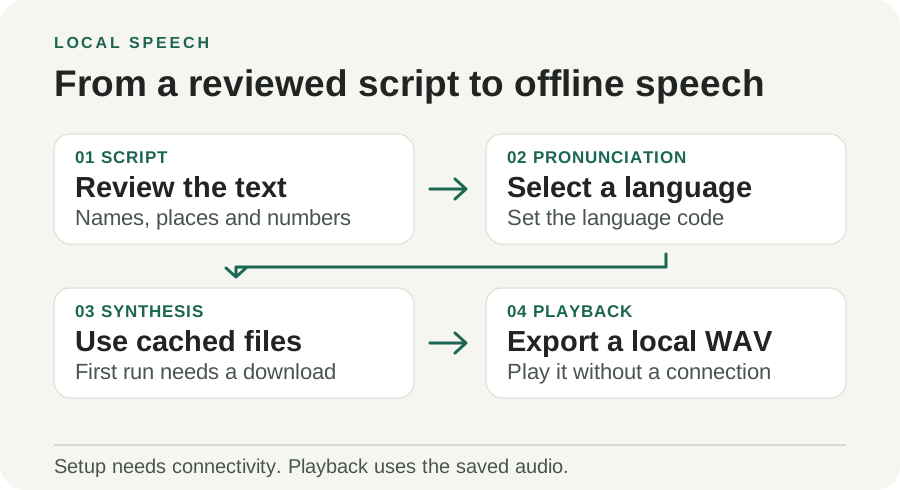
Telli.sh 原创图解。模型在设置时下载。所需文件缓存后,试听流程可以留在设备上。
默认声音降低了第一堂课的准备成本
首次使用的路径很直接。提供一段文字和三个字母的 ISO 语言代码,如契维语 twi、斯瓦希里语 swh 或约鲁巴语 yor。软件包用默认声音生成语音并保存为音频文件。老师可以把它放进离线课程,也可以直接播放,并提供原文作为对照。
输入文字应当已经是听者要听的语言。斯瓦希里语广播需要斯瓦希里语讲稿。原稿若是另一种语言,翻译与母语审核应分别进行。告诉译者听众使用的地名、单位和日期写法。把审过的讲稿放在生成音频旁边,方便定位理解错误是从哪里开始的。
先选容易做小幅修正的材料。老师可以生成几段难度相近的阅读材料,让两位使用该语言的人不看原文先听。培训中心可以为书面步骤配上语音,再检查学员是否明白先后顺序。两种场景中,遇到合成语音说不好的人名或罕见表达,都可以由工作人员录一段简短的更正。
简短的公开通知也适合尝试。比如学习中心更改活动时间,同时张贴文字通知,在本地终端播放语音。替换昨天的文件之前,先让一位使用该语言的人听新时间。如果主体听得懂,唯独时间含糊,就重录那一句,并保留可见的文字说明。时间这个细节比一次生成全篇的便利更重要。
把音频放上共用设备之前,先定好更新办法。一种做法是把标明日期和语言的纯文本主讲稿与审核过的 WAV 放在一起。工作人员修改课程后,旧文件保留到听者批准替换为止。在断网设备上,两份旧文件听起来都可能可信。课程界面显示一个简短版本标记,老师不用翻制作文件夹也能知道会播哪一版。
发音在语音模型之前就开始了
AfriSpeech 的模型文档介绍了一个六层学生模型,包括音频编解码器在内有 1.1 亿参数,由 24 层基础模型蒸馏而来。训练让小模型接近大模型在引导生成中的输出。这是软件包能够面向 CPU 运行的原因之一。对共用电脑来说,更有用的数据是,一边开着课程、一边生成可用文件需要多久。模型细节
模型通过针对不同语言的文本前端接收国际音标(IPA)。前端把文字映射为语音模型预期的声音单位。项目对支持的非洲语言使用 Africa G2P 转换器,英语则使用文档所述的 eSpeak NG。这能解释为什么输出听起来流畅,陌生的拼写、借词和人名仍可能读错。声学生成之前出了错,模型也能非常流畅地把错误读出来。模型与发音前端
维护者建议把数字写成文字,并采用目标听众常用的写法。测试真实材料会出现的形式,包括日期、时间、范围、缩写和数量。打印或显示的原文与为发音调整的版本不同,就分别存放。这样屏幕上仍能用原文,合成稿也有清楚的改动记录。
一句话中途换语言的讲稿也值得单测。文档允许调用者选择一种语言,因此应检查主要使用一种语言的文本中夹带的人名和引语。一次生成的结果出乎意料时,可以把相关文字拆成经过审核的片段。教材需要保留外语术语、又要在不同课次中统一读法时,这尤其有用。
训练覆盖范围提供了试验起点
模型卡报告训练数据有 897 小时语音。按语言列出,英语约 322.6 小时,斯瓦希里语 27.0 小时,契维语 24.0 小时,约鲁巴语 15.3 小时。训练时数描述的是数据集。它无法说明一个班使用哪种地方变体、某个短语在训练中出现多少次,或听者能否认出一个合成的人名。模型卡与语言表
发布还介绍了一份包含 657 种未训练语言的实验列表,采用最接近的已训练语言来朗读。把它当成单独的研究路径。主要文档中明确支持的语言,和借用另一种语言生成的情况,有不同的证据。如果试验面向依赖音频的人,从已训练语言开始,再判断实验路径是否能得到足够的母语审核。实验性语言说明
维护者给了两项需要结合条件看的结果。第一,他们报告四个 vCPU 的云机器上生成速度是实时的 2.4 倍。第二,在一组留出的对比数据中,用 Omnilingual ASR 转写合成语音。公开比较的 27 种语言中,Africa TTS 在 21 种上优于 MMS-TTS。两项数据都由项目提供。教室有不同口音、设备、背景噪音和扬声器。转写分数可以间接衡量清晰度,课程最终要检查的是听者怎样理解句子。发布基准 · 评估方法
| 测试 | 在实际试验设备上测什么 | 为什么重要 |
|---|---|---|
| 首次启动 | 设置用时、下载量、缓存后的空间占用 | 共用笔记本的磁盘和高速连接可能有限 |
| 缓存后生成 | 保持课程打开,从请求到 WAV 完成的耗时 | 后台应用会改变普通 CPU 的实际速度 |
| 关键信息 | 听者能否正确复述姓名、时间、数字和指令 | 文章可能听着自然,却有一个重要词读错 |
| 地方变体 | 母语者对目标短语和口音的判断 | 同一个语言代码可以包含多种说法 |
| 失败恢复 | 文字或工作人员录音能否支撑课程继续 | 模型或音频设备可能在需要当天出故障 |
先配置离线流程,再断网测试
- 选择一段经审核的短稿。 写一句问候、一段代表性练习和一段含姓名或数字的内容。合成前请该语言使用者核对拼写和措辞。
- 创建隔离的 Python 环境。 0.5.0 指定 Python 3.10 至 3.14。启用适合操作系统的虚拟环境,再安装固定版本。
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- 安排首次模型下载。 版本文档称,默认模型首次下载约 440 MB。在配置时用获准网络下载,或发起一次合成请求并按提示接受下载。测试包括英语时,安装文档列出的 eSpeak NG 依赖。换平台或后端前,先查软件包说明。
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- 配置后关闭网络,再试一次。 使用课程所用的同一账户和缓存路径。生成新 WAV,在目标设备上打开,把生成耗时与播放时长分开记录。
- 先听后读。 用实际授课时的音量播放,让两位使用者或听众复述关键信息。保存讲稿版本、模型版本和意见。如果有人听错,修改文字或更换音频,再重复检查。
考虑 Android 的团队也可以这样试。AfriSpeech 介绍了带 C 前端与 Android 封装的 sherpa-onnx 套件。移动套件与默认桌面运行环境使用不同后端,因此要单独测实际手机版本。在有代表性的设备上使用完整段落,比较冷启动时间、存储、音质和电池表现。桌面命令能证明一套环境可用,手机仍需自己跑一次。端侧部署说明
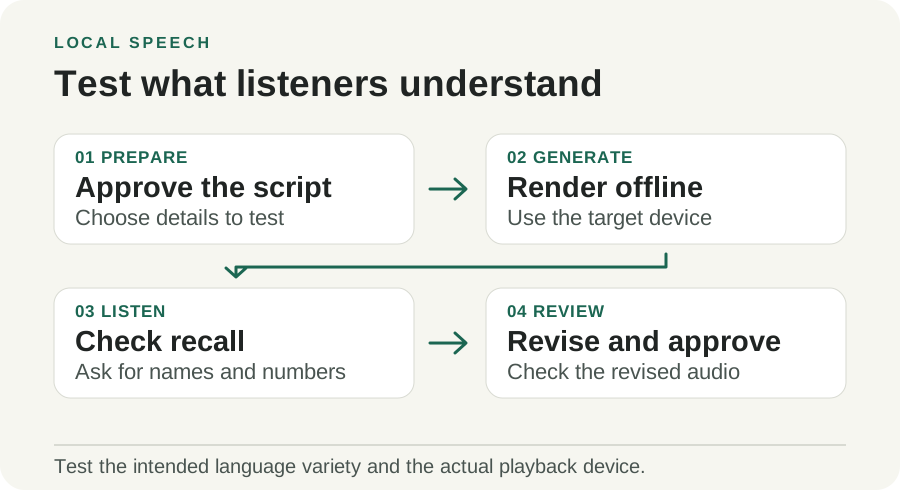
Telli.sh 原创图解。请听众在看原稿前复述关键信息,有助于找出文字校对容易漏掉的发音问题。
代码和声音都要查许可证
Python 软件包的代码使用 MIT 许可。0.5.0 发布称,模型和默认声音采用 CC BY-NC 4.0。英语前端依赖 eSpeak NG 有自己的 GPL 条款。准备分发工具、语音文件或依赖它们的服务时,分别检查这些部分。公开下载方便试用,一些商业用途仍可能需要换模型或单独申请许可。发布许可证说明 · CC BY-NC 4.0 条款
软件包还可以使用提供的声音样本。学校试验使用默认声音更简单,因为无需收集某个人的参考录音。如果应用需要特定声音,应取得说话人对拟议用途的同意,并约定参考音频和生成文件保存在哪里。学习中心也可以让工作人员在同意后用自己的声音录制修正片段,再用默认模型生成练习变体,由此不用提交参考录音。
离线合成可以把讲稿和声音资料留在团队的设备上,托管演示走的是另一条路径。向网页服务提交讲稿或参考片段,是独立的数据共享决定。测试托管演示时从公开试句开始。受学校或组织政策约束的材料则使用本地流程。
能否通过,听众说了算
Africa TTS 让语音工具里很少看到自己语言的人,也有机会听到第一份语音草稿。有效的发布试验可以小到只靠耳朵就能验收。挑一段实际会播放的内容,断网生成,让听众复述其中最重要的细节。回答是否正确,比语言菜单有多少选项更能说明试验结果。
来源
- Africa TTS 0.5.0 发布,2026 年 11 月 8 日
- AfriSpeech 模型卡与训练覆盖范围
- AfriSpeech 评估方法
- AfriSpeech 公开试听示例
- CC BY-NC 4.0 许可证
- Joy Agyepong 拍摄的加纳录音室背景照片,CC BY-SA 4.0
想把工作背后的讨论和决定保存为可搜索的记录,可以创建 Telli.sh 账户。