Um notebook compartilhado consegue ler uma aula em twi sem internet?
O Africa TTS 0.5.0 traz vozes padrão para 92 idiomas africanos e inglês. Veja o que testar em um piloto de voz offline.
Imagine um centro comunitário de ensino com um notebook compartilhado e uma internet instável. Uma professora tem um exercício curto de leitura em twi e quer que os alunos o ouçam duas vezes, antes de responder e durante a correção. Uma gravação é a solução óbvia. A síntese de voz ajuda quando o roteiro muda com frequência, quando a professora quer variações para praticar ou quando a gravação aprovada ainda não existe.
A AfriSpeech publicou o Africa TTS 0.5.0 em 8 de novembro de 2026. Segundo o lançamento, o pacote converte texto em fala em 92 idiomas africanos e inglês, com uma voz padrão para cada idioma. Roda na CPU e pode sintetizar offline depois de baixar e colocar o modelo no cache. Os responsáveis oferecem demonstração online e amostras de áudio. Elas permitem ouvir os idiomas de interesse antes de gastar tempo com a instalação. Versão no PyPI · Amostras oficiais de áudio
A pergunta do centro é mais específica que a contagem de idiomas. O público consegue identificar as palavras e acompanhar o material no notebook compartilhado, na variante que fala? Isso exige uma avaliação por ouvintes e outra no aparelho. As duas ficam mais úteis quando partem das frases que o centro usa.
Foto de contexto de um estúdio de rádio em Gana, tirada em 2017 por Joy Agyepong e redimensionada sob CC BY-SA 4.0. Fotografia original

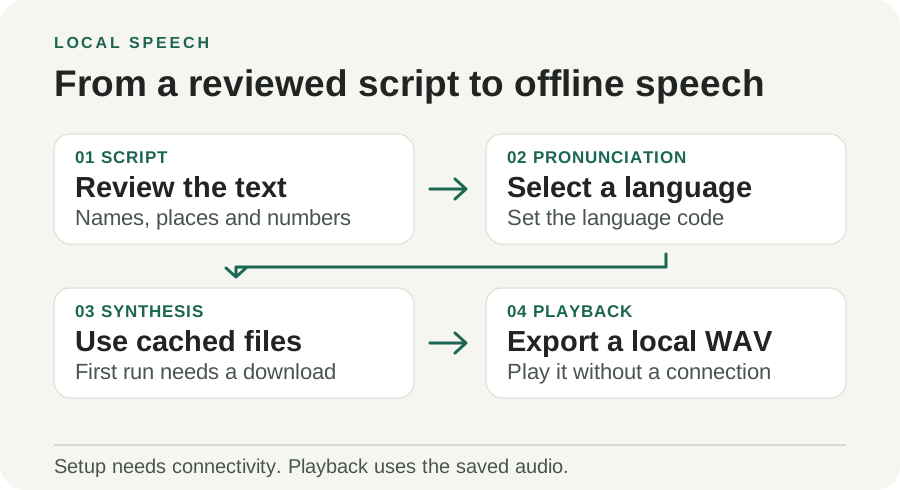
Ilustração original da Telli.sh. O modelo é baixado durante a preparação. Depois do cache dos arquivos necessários, a síntese e a reprodução podem ficar no aparelho.
Uma voz padrão reduz o trabalho de preparar a primeira aula
O lançamento oferece um caminho direto para a primeira tentativa. Informe a frase e um código ISO de três letras, como twi para twi, swh para suaíli ou yor para iorubá. O pacote escolhe a voz padrão e grava a fala em um arquivo. A professora pode incluí-lo numa aula offline ou tocá-lo diretamente, com o texto disponível para comparação.
O texto de entrada já deve estar no idioma esperado. Um aviso em suaíli exige roteiro em suaíli. Se começou em outro idioma, tradução e revisão por um falante nativo são etapas separadas. Informe à pessoa tradutora os nomes de lugares, as unidades e as datas usados pelo público. Mantenha o roteiro revisado junto do áudio para que o ouvinte veja onde começou um mal-entendido.
Comece com material fácil de corrigir. Uma professora pode gerar trechos de dificuldade semelhante e pedir a dois falantes que ouçam sem ler. Um centro de formação pode criar uma versão falada das instruções e conferir se a turma entendeu a ordem das etapas. Nos dois casos, alguém da equipe pode gravar uma correção curta se a fala sintética tropeçar num nome ou numa expressão pouco comum.
Um aviso público curto é outra possibilidade. Pense em mudar o horário de uma oficina e oferecer texto impresso e áudio num quiosque local. Peça a alguém que ouça o novo horário antes de substituir o arquivo anterior. Se a voz sintética lê bem o aviso, mas deixa a hora ambígua, grave de novo aquela frase e mantenha a alternativa escrita visível. Preservar a hora importa mais que gerar o arquivo inteiro de uma só vez.
Defina como o áudio será atualizado antes de colocá-lo num aparelho compartilhado. Uma opção é guardar um roteiro mestre em texto com data e idioma ao lado do WAV aprovado. Se a equipe mudar a aula, a versão antiga permanece até que alguém aprove a nova. Num aparelho sem conexão, duas cópias desatualizadas podem soar convincentes. Um identificador de revisão na interface permite ver qual vai tocar sem abrir a pasta de produção.
A pronúncia começa antes do modelo de voz
A documentação descreve um modelo aluno de seis camadas e 110 milhões de parâmetros, incluindo o codec de áudio, destilado de um modelo-base de 24 camadas. O treinamento fez o menor aproximar a saída da geração guiada do maior. É um dos motivos pelos quais o pacote pode rodar na CPU. No computador compartilhado, interessa quanto tempo leva para gerar um arquivo usável com a aula aberta. Detalhes do modelo
O modelo recebe IPA, o Alfabeto Fonético Internacional, por um processamento de texto específico do idioma. Essa etapa converte a escrita nas unidades de som que o modelo espera. O projeto usa o Africa G2P nos idiomas africanos compatíveis e documenta o eSpeak NG para inglês. Isso explica por que uma grafia pouco comum, um empréstimo linguístico ou um nome pode falhar mesmo com áudio fluente. Um erro antes da etapa acústica pode levar o modelo a pronunciar com naturalidade a coisa errada. Modelo e processamento de pronúncia
Os responsáveis recomendam escrever números por extenso. Siga a convenção do público. Teste a forma que aparece no material real, incluindo datas, horários, intervalos, abreviações e quantidades. Guarde separadamente o texto digitado e a forma ajustada para a pronúncia. Assim, a versão de leitura continua boa na tela, e o roteiro de síntese registra o que mudou.
Roteiros que alternam idiomas dentro da frase merecem teste próprio. A documentação deixa escolher um idioma. Confira nomes e citações numa passagem que usa principalmente esse idioma. Se a síntese de uma só vez produzir algo estranho, experimente separar os trechos e revisar cada um. Isso ajuda em materiais didáticos nos quais um termo estrangeiro precisa ser preservado e lido da mesma forma em várias aulas.
A cobertura do treinamento dá um ponto de partida
O cartão informa 897 horas de voz nos dados de treinamento. A tabela por idioma registra cerca de 322,6 horas de inglês, 27,0 de suaíli, 24,0 de twi e 15,3 de iorubá. As horas descrevem o conjunto de dados. Elas não identificam a variante falada pela turma, a frequência de uma frase no treinamento ou se o público reconhece um nome sintetizado. Cartão e tabela de idiomas
O lançamento descreve ainda uma lista experimental de 657 idiomas sem treinamento, lidos por meio do idioma treinado mais próximo disponível. Trate isso como uma linha de pesquisa separada. Um idioma da lista principal e outro roteado por aproximação têm evidências diferentes. Num piloto para quem depende de áudio, comece com a lista treinada. Depois decida se a via experimental recebeu revisão nativa suficiente para o objetivo. Notas sobre idiomas experimentais
Os responsáveis relatam dois resultados que precisam de contexto. Primeiro, geração a 2,4 vezes o tempo real numa máquina em nuvem com quatro vCPUs. Segundo, uma comparação em dados reservados, na qual o Omnilingual ASR transcreveu as vozes sintetizadas. O Africa TTS superou o MMS-TTS em 21 dos 27 idiomas comparados. Os números vêm do projeto. Uma turma tem sotaques, aparelhos, ruído de fundo e caixas de som diferentes. A transcrição é uma indicação de inteligibilidade. Para a aula, vale o que a pessoa entendeu da frase. Testes do lançamento · Métodos de avaliação
| Teste | O que medir no aparelho do piloto | Por que importa |
|---|---|---|
| Primeira abertura | Tempo de preparação, tamanho do download e espaço após o cache | Um notebook compartilhado pode ter pouco disco ou acesso lento à rede |
| Geração com cache | Tempo até o WAV ficar pronto com a aula aberta | Aplicativos em segundo plano mudam o desempenho da CPU |
| Fatos essenciais | Se ouvintes repetem corretamente nomes, horas, números e instruções | Uma frase pode soar natural e errar a palavra que importa |
| Variante local | Avaliação por falantes nativos de frases e sotaques do público | O mesmo código de idioma cobre diferentes formas de falar |
| Recuperação de falha | Se a aula funciona com o texto ou uma gravação da equipe | O modelo ou o dispositivo de som pode falhar no dia de uso |
Prepare o uso offline e depois teste sem conexão
- Escolha uma passagem curta revisada. Escreva um cumprimento, um exercício típico e um trecho com nomes ou números. Peça a um falante que confira a grafia e a redação.
- Crie um ambiente Python isolado. A versão 0.5.0 indica Python 3.10 a 3.14. Ative um ambiente virtual adequado ao sistema e instale a versão datada.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Planeje o primeiro download. A documentação da versão indica cerca de 440 MB para o modelo padrão. Baixe numa rede aprovada durante a preparação ou inicie a síntese e confirme o download. Instale o eSpeak NG indicado se houver inglês. Confira as instruções antes de mudar de plataforma ou mecanismo de execução.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Repita sem rede depois de preparar. Use a conta e o cache que a aula usará. Gere um novo WAV, abra-o no aparelho e registre tempo de geração e duração de reprodução separadamente.
- Peça que ouçam antes de ler. Toque os clipes no volume previsto e peça a dois falantes ou ouvintes que repitam os fatos principais. Guarde versões do roteiro, do modelo e comentários. Corrija o texto ou troque o clipe quando alguém entender algo errado, e repita.
A sequência também ajuda equipes interessadas em Android. A AfriSpeech documenta um pacote sherpa-onnx com processamento em C e uma camada para Android. Teste a versão real do celular separadamente, porque o pacote móvel e a execução padrão no computador usam mecanismos diferentes. Compare inicialização a frio, armazenamento, qualidade e bateria em aparelhos representativos com trechos completos. Um comando funcional no computador comprova apenas um ambiente. O celular exige outro teste. Notas de implantação no aparelho
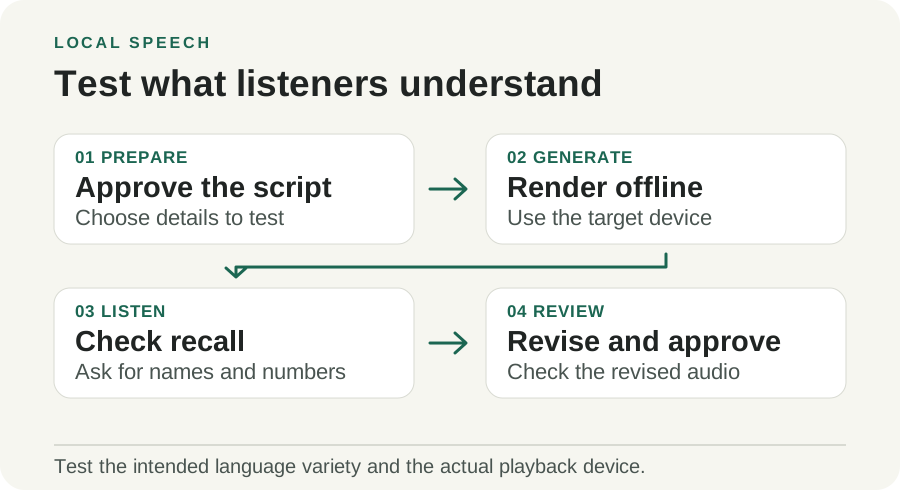
Ilustração original da Telli.sh. Peça a quem ouve que repita os fatos antes de ler, para detectar problemas de pronúncia que uma revisão escrita pode perder.
Confira a licença das vozes junto com a do código
O código do pacote Python usa a licença MIT. Segundo a versão 0.5.0, o modelo e as vozes padrão usam CC BY-NC 4.0. O eSpeak NG, dependência para inglês, tem seus próprios termos GPL. Avalie cada parte antes de distribuir ferramenta, vozes ou serviço. Um download público facilita testar, enquanto determinados usos comerciais podem exigir outro modelo ou autorização. Licenciamento da versão · Termos da CC BY-NC 4.0
O pacote também aceita uma amostra de voz fornecida. Uma voz padrão simplifica o piloto escolar porque dispensa coletar uma gravação de referência. Se o aplicativo precisar de uma voz específica, obtenha permissão para o uso e combine onde ficarão a referência e os arquivos gerados. Um centro pode evitar essa decisão gravando correções na voz de alguém da equipe com permissão e usando a voz padrão para variações de prática.
A síntese offline ajuda a manter roteiros e vozes no próprio aparelho. A demonstração hospedada é outra rota. Enviar roteiro ou referência a um serviço web exige uma decisão separada de compartilhamento. Use frase pública para testar a demonstração e o fluxo local para materiais sujeitos à política da escola ou organização.
O critério de aprovação está com quem ouve
O Africa TTS torna viável entregar um primeiro rascunho de áudio a pessoas que raramente encontram seu idioma numa ferramenta de fala. Um bom teste fica pequeno o suficiente para ser avaliado de ouvido. Escolha um trecho que o público realmente ouvirá, gere sem rede e peça que repita o detalhe importante. Uma resposta correta diz mais sobre o piloto que o número de opções do menu.
Fontes
- Africa TTS 0.5.0, versão de 8 de novembro de 2026
- Cartão do modelo e cobertura de treinamento da AfriSpeech
- Métodos de avaliação da AfriSpeech
- Amostras públicas de áudio da AfriSpeech
- Licença CC BY-NC 4.0
- Foto de contexto de estúdio de rádio em Gana, Joy Agyepong, CC BY-SA 4.0
Para guardar e pesquisar as conversas e decisões por trás do seu trabalho, crie uma conta na Telli.sh.