Kann ein gemeinsam genutzter Laptop eine Lektion auf Twi offline vorlesen?
Africa TTS 0.5.0 bringt Standardstimmen für 92 afrikanische Sprachen und Englisch. Das sollte ein Offline-Pilot für Sprachausgabe prüfen.
Stell dir ein Bildungszentrum mit einem gemeinsam genutzten Laptop und einer unzuverlässigen Internetverbindung vor. Eine Lehrerin hat eine kurze Leseübung auf Twi. Die Lernenden sollen sie zweimal hören, vor dem Beantworten und beim Vergleichen ihrer Antworten. Eine Aufnahme ist die naheliegende Lösung. Sprachausgabe aus Text hilft, wenn sich das Skript oft ändert, die Lehrerin Übungsvarianten erstellen möchte oder eine freigegebene Aufnahme noch fehlt.
AfriSpeech veröffentlichte Africa TTS 0.5.0 am 8. November 2026. Laut Release-Beschreibung kann das Paket Texte in 92 afrikanischen Sprachen und Englisch vertonen. Für jede Sprache gibt es eine Standardstimme. Es läuft auf einer CPU und kann offline synthetisieren, sobald das Modell heruntergeladen und im Cache liegt. Das Projekt bietet eine Online-Demo und Hörproben. Damit lässt sich vor der Installation schnell prüfen, wie die benötigten Sprachen klingen. Versioniertes Release auf PyPI · Offizielle Hörproben
Für das Bildungszentrum zählt eine konkretere Frage als die Sprachzahl. Erkennen die Lernenden auf dem gemeinsamen Laptop die vorgesehenen Wörter und folgen sie dem Text in ihrer Sprachvariante? Das erfordert einen Hörtest und einen Gerätetest. Für beide eignen sich die Sätze aus dem tatsächlichen Unterricht.
Kontextfoto aus einem Radiostudio in Ghana von 2017. Foto von Joy Agyepong, in der Größe geändert unter CC BY-SA 4.0. Originalfoto

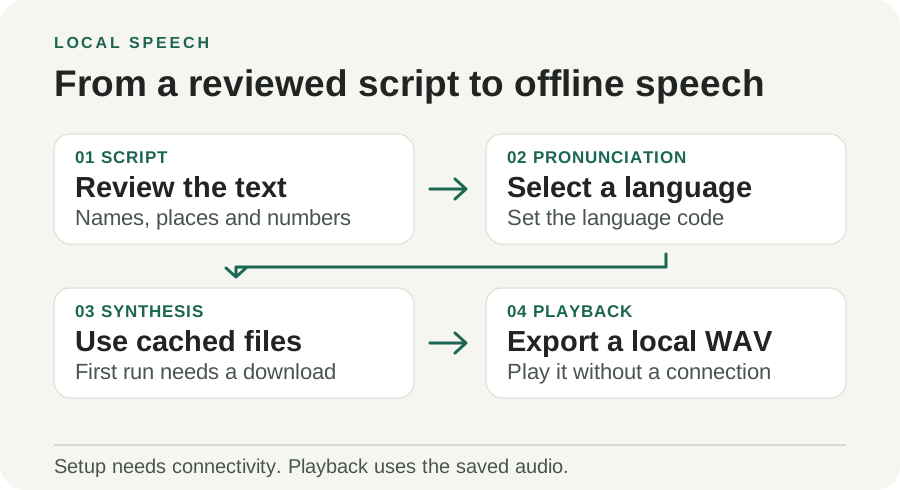
Eigene Illustration von Telli.sh. Das Modell wird bei der Einrichtung heruntergeladen. Sind die Dateien im Cache, kann der Hörablauf auf dem Gerät bleiben.
Eine Standardstimme vereinfacht die erste Lektion
Das Release bietet einen direkten Einstieg. Gib einen geschriebenen Satz und einen dreibuchstabigen ISO-Sprachcode an, etwa twi für Twi, swh für Suaheli oder yor für Yoruba. Das Paket wählt die Standardstimme und speichert die Sprache als Audiodatei. Eine Lehrerin kann die Datei in eine Offline-Lektion einfügen oder direkt abspielen und die Textfassung zum Vergleich bereithalten.
Der Eingabetext muss bereits in der erwarteten Sprache vorliegen. Eine Durchsage auf Suaheli braucht ein Skript auf Suaheli. Kommt sie aus einer anderen Sprache, sind Übersetzung und Prüfung durch Sprachkundige eigene Schritte. Gib der übersetzenden Person die Ortsnamen, Einheiten und Datumsformen, die das Publikum nutzt. Lege das geprüfte Skript neben die erzeugte Audiodatei, damit Zuhörer erkennen können, wo ein Missverständnis entstanden ist.
Beginne mit Material, das kleine Korrekturen erlaubt. Eine Lehrerin kann mehrere Leseabschnitte ähnlicher Schwierigkeit vorbereiten und zwei Sprecher bitten, sie ohne Blick auf den Text anzuhören. Ein Schulungszentrum kann schriftliche Anweisungen um eine Hörfassung ergänzen und prüfen, ob die Teilnehmenden die Reihenfolge verstehen. In beiden Fällen kann ein Teammitglied eine kurze Korrektur aufnehmen, wenn die synthetische Stimme an einem Namen oder einer ungewöhnlichen Formulierung scheitert.
Eine kurze öffentliche Mitteilung ist ein weiterer möglicher Einsatz. Ein Bildungszentrum verschiebt einen Workshop und bietet gedruckten Text sowie eine Hörfassung am örtlichen Kiosk. Lass eine Person die geänderte Uhrzeit überprüfen, bevor sie die alte Datei ersetzt. Ist der restliche Text verständlich, die Uhrzeit aber mehrdeutig, nimm diesen Satz neu auf und halte die Textfassung sichtbar. Die korrekte Uhrzeit ist wichtiger als die bequeme Erzeugung der ganzen Datei in einem Durchlauf.
Kläre vor der Ablage auf einem gemeinsam genutzten Gerät, wie das Audio aktualisiert wird. Eine Möglichkeit ist, neben der freigegebenen WAV-Datei ein Klartextskript mit Datum und Sprache zu speichern. Ändert jemand die Lektion, bleibt die alte Datei verfügbar, bis eine Person die neue abgehört und freigegeben hat. Auf einem Gerät ohne Netz können zwei veraltete Fassungen gleichermaßen überzeugend klingen. Eine kurze Versionsangabe in der Lektion zeigt der Lehrkraft, welche Fassung abgespielt wird, ohne den Produktionsordner zu öffnen.
Aussprache beginnt vor dem Sprachmodell
Die Modelldokumentation beschreibt ein Student-Modell mit sechs Schichten und 110 Millionen Parametern einschließlich Audiocodec. Es wurde aus einem Basismodell mit 24 Schichten destilliert. Im Training lernte die kleinere Fassung, die geführte Generierung des größeren Modells nachzuahmen. Das trägt dazu bei, dass das Paket für CPUs ausgelegt ist. Auf dem gemeinsamen Laptop zählt, wie lange eine brauchbare Datei braucht, während die Lektion ebenfalls läuft. Modelldetails
Das Modell erhält das Internationale Phonetische Alphabet, kurz IPA, über eine sprachspezifische Textvorverarbeitung. Diese ordnet geschriebenem Text die vom Sprachmodell erwarteten Lautformen zu. Für die unterstützten afrikanischen Sprachen nutzt das Projekt seinen Konverter Africa G2P. Für Englisch dokumentiert es eSpeak NG. Darum können eine ungewohnte Schreibweise, ein Lehnwort oder ein Name selbst bei flüssig klingender Ausgabe scheitern. Ein Fehler vor der akustischen Verarbeitung kann das falsche Wort sehr überzeugend klingen lassen. Modell und Aussprachevorverarbeitung
Die Projektverantwortlichen empfehlen, Zahlen auszuschreiben. Nutze dabei die Konventionen der vorgesehenen Zuhörer. Teste Datumsangaben, Uhrzeiten, Spannen, Abkürzungen und Mengen in der Form, in der sie im Material vorkommen. Unterscheiden sich der eingegebene Text und die für die Aussprache angepasste Form, bewahre sie getrennt auf. Der Text bleibt für die Anzeige brauchbar, während das Skript zur Audioerzeugung jede Änderung nachvollziehbar macht.
Texte mit Sprachwechseln innerhalb eines Satzes brauchen einen eigenen Test. Laut Dokumentation wählt der Aufrufer eine Sprache. Prüfe deshalb Namen und Zitate in ansonsten einsprachigem Material. Liefert ein Durchlauf unerwartete Ergebnisse, bereite die betreffenden Stellen als getrennte, geprüfte Abschnitte vor. Das ist besonders bei Lernmaterial nützlich, wenn ein fremdsprachiger Begriff erhalten bleiben und über mehrere Lektionen gleich ausgesprochen werden soll.
Die Trainingsabdeckung bietet einen Ausgangspunkt
Die Model Card nennt 897 Stunden Sprache in den Trainingsdaten. In der Tabelle stehen etwa 322,6 Stunden für Englisch, 27,0 für Suaheli, 24,0 für Twi und 15,3 für Yoruba. Trainingsstunden beschreiben den Datensatz. Sie zeigen weder, welche lokale Variante eine Klasse spricht, noch wie häufig ein Ausdruck im Training vorkam oder ob Zuhörer einen bestimmten Namen erkennen. Model Card und Sprachtabelle
Die Veröffentlichung beschreibt außerdem eine experimentelle Liste von 657 untrainierten Sprachen. Sie können über die jeweils ähnlichste verfügbare trainierte Sprache vorgelesen werden. Das ist ein eigener Forschungsweg. Für eine Sprache aus der regulären Liste und eine Sprache, die über eine Ersatzsprache läuft, gibt es unterschiedliche Belege. Beginne bei einem Pilotprojekt für Menschen, die auf Audio angewiesen sind, mit der trainierten Liste. Prüfe dann, ob der experimentelle Weg für seinen Zweck ausreichend von Sprachkundigen bewertet wurde. Hinweise zu experimentellen Sprachen
Zwei Projektergebnisse brauchen Kontext. Die Verantwortlichen berichten erstens von 2,4-facher Echtzeitgeschwindigkeit auf einem Cloud-Rechner mit vier vCPUs. Zweitens beschreiben sie einen Vergleich auf zurückgehaltenen Daten, in dem Omnilingual ASR die synthetische Sprache transkribierte. Africa TTS lag in 21 von 27 ausgewiesenen Sprachen vor MMS-TTS. Beide Zahlen stammen vom Projekt. Ein Raum mit Lernenden bringt andere Akzente, Geräte, Hintergrundgeräusche und Lautsprecher mit. Ein Transkriptionswert ist ein Anhaltspunkt für Verständlichkeit. Für die Lektion zählt, wie die Zuhörer den Satz tatsächlich verstehen. Release-Benchmarks · Evaluationsmethoden
| Test | Messung auf dem tatsächlichen Pilotgerät | Warum das zählt |
|---|---|---|
| Erster Start | Einrichtungszeit, Downloadgröße, Speicherbelegung nach dem Caching | Auf einem gemeinsamen Laptop können Speicher und Netz knapp sein |
| Erzeugung aus dem Cache | Zeit von der Anfrage bis zur fertigen WAV bei geöffneter Lektion | Eine Hintergrundanwendung beeinflusst die Geschwindigkeit einer normalen CPU |
| Wichtige Fakten | Ob Zuhörer Namen, Zeiten, Zahlen und Anweisungen richtig wiederholen | Ein Abschnitt kann natürlich klingen, obwohl ein wichtiges Wort falsch ist |
| Lokale Sprachvariante | Einschätzung von Muttersprachlern zu Zielsätzen und Akzenten | Ein Sprachcode kann mehrere Sprechweisen umfassen |
| Fehlerfall | Ob die Lektion mit Text oder einer Aufnahme weiterläuft | Modell oder Audiogerät können im entscheidenden Moment ausfallen |
Einmal einrichten und anschließend ohne Verbindung testen
- Einen kurzen geprüften Abschnitt wählen. Schreibe eine Begrüßung, eine typische Übung und einen Abschnitt mit Namen oder Zahlen. Lass vor der Erzeugung Rechtschreibung und Wortwahl von einer sprachkundigen Person bestätigen.
- Eine getrennte Python-Umgebung anlegen. Release 0.5.0 nennt Python 3.10 bis 3.14. Aktiviere eine für dein Betriebssystem geeignete virtuelle Umgebung und installiere die angegebene Version.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Den ersten Modelldownload einplanen. Die versionierte Dokumentation nennt rund 440 MB für den ersten Download des Standardmodells. Lade es während der Einrichtung in einem freigegebenen Netzwerk herunter oder starte eine Synthese und akzeptiere den Download bei der Abfrage. Installiere bei Englisch die dokumentierte Abhängigkeit eSpeak NG. Prüfe die Paketdokumentation vor einem Plattform- oder Backend-Wechsel.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Nach der Einrichtung ohne Netz wiederholen. Verwende dasselbe Konto und denselben Cache wie die Lektion. Erzeuge eine neue WAV-Datei, öffne sie auf dem Zielgerät und erfasse Erzeugungszeit und Abspieldauer getrennt.
- Erst hören lassen, dann lesen. Spiele die fertigen Clips in der vorgesehenen Lautstärke ab und bitte zwei Sprecher oder Zuhörer, wichtige Fakten zu wiederholen. Speichere Skriptversion, Modellversion und Anmerkungen. Wird ein Detail falsch verstanden, korrigiere den Text oder ersetze den Clip und wiederhole die Prüfung.
Die Abfolge hilft auch Teams mit Interesse an Android. AfriSpeech dokumentiert ein sherpa-onnx-Paket mit C-Frontend und Android-Wrapper. Teste den tatsächlichen Smartphone-Build separat, da das mobile Paket und die Standard-Desktoplaufzeit verschiedene Backends verwenden. Vergleiche Kaltstart, Speicherbedarf, Audioqualität und Akkuverhalten auf typischen Geräten mit vollständigen Abschnitten. Ein funktionierender Desktop-Befehl zeigt die Eignung für eine Umgebung. Das Smartphone braucht einen eigenen Test. Hinweise zur Ausführung auf dem Gerät
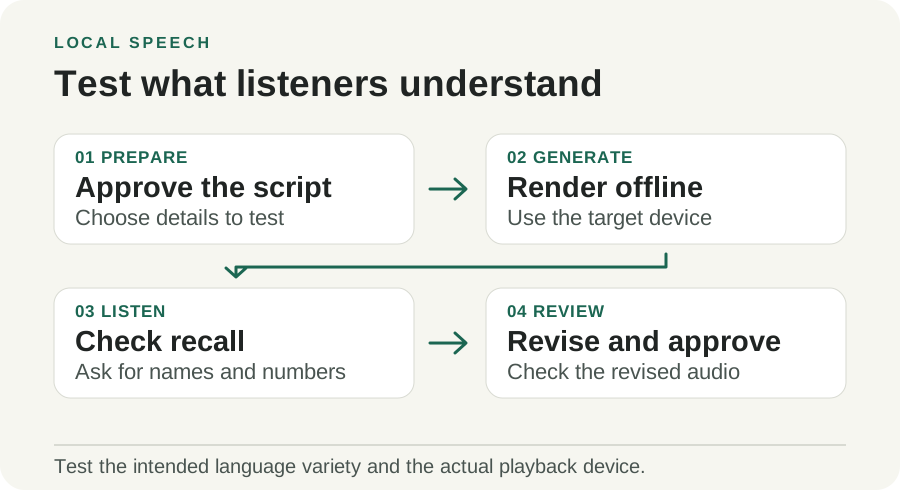
Eigene Illustration von Telli.sh. Lass Zuhörer wichtige Fakten wiederholen, bevor sie das Skript sehen. So fallen Ausspracheprobleme auf, die beim Lesen unbemerkt bleiben.
Die Stimme hat eigene Lizenzbedingungen
Der Code des Python-Pakets steht unter MIT-Lizenz. Laut Release 0.5.0 stehen Modell und Standardstimmen unter CC BY-NC 4.0. Die englische Vorverarbeitung eSpeak NG hat eigene GPL-Bedingungen. Prüfe diese Bestandteile getrennt, wenn du das Werkzeug, Stimmdateien oder einen darauf beruhenden Dienst vertreiben willst. Ein öffentlicher Download lässt sich leicht ausprobieren. Manche kommerziellen Nutzungen erfordern ein anderes Modell oder eine eigene Erlaubnis. Lizenzangaben des Releases · Bedingungen von CC BY-NC 4.0
Das Paket kann auch eine mitgelieferte Stimmprobe nutzen. Eine Standardstimme vereinfacht den Schulversuch, weil niemand eine Referenzaufnahme abgeben muss. Braucht die Anwendung eine bestimmte Stimme, hole die Zustimmung für die geplante Nutzung ein und kläre, wo Referenz und erzeugte Dateien gespeichert werden. Ein Bildungszentrum kann Korrekturen mit Erlaubnis in der eigenen Stimme eines Teammitglieds aufnehmen und die Standardstimme für Übungsvarianten nutzen.
Offline-Synthese kann Skripte und Stimmproben auf dem eigenen Gerät halten. Die gehostete Demo ist ein anderer Weg. Wer dort ein Skript oder einen Referenzclip einreicht, trifft eine gesonderte Entscheidung über die Weitergabe. Teste einen Webdienst zunächst mit einem öffentlichen Beispielsatz und nutze für Material unter Schul- oder Organisationsregeln den lokalen Ablauf.
Ob der Test bestanden ist, entscheiden die Zuhörer
Mit Africa TTS lässt sich ein erster Audioentwurf für Menschen erzeugen, die ihre Sprache in solchen Werkzeugen selten finden. Ein sinnvoller Test bleibt klein genug, um ihn nach Gehör zu beurteilen. Nimm einen Abschnitt, den Menschen wirklich hören werden, lass ihn ohne Netz erzeugen und bitte sie, das entscheidende Detail zu wiederholen. Die richtige Antwort sagt mehr über den Pilotversuch als die Zahl der Optionen im Sprachmenü.
Quellen
- Africa TTS 0.5.0 vom 8. November 2026
- AfriSpeech Model Card und Trainingsabdeckung
- Evaluationsmethoden von AfriSpeech
- Öffentliche Hörproben von AfriSpeech
- Lizenz CC BY-NC 4.0
- Kontextfoto eines ghanaischen Radiostudios von Joy Agyepong, CC BY-SA 4.0
Um Gespräche und Entscheidungen hinter deiner Arbeit durchsuchbar festzuhalten, erstelle ein Telli.sh-Konto.