ห้าขั้นตอน สี่ผลลัพธ์: Telli.sh ถอดเสียงการประชุมและแปลการประชุมของคุณอย่างไร
พาเดินดูไปป์ไลน์ทั้งหมดของ Telli.sh ตั้งแต่การอัดสดหรืออัปโหลดไฟล์เสียง การถอดเสียงการประชุมด้วย AI พร้อมระบุตัวผู้พูด บริการแปลการประชุมแบบเรียลไทม์ไปยัง 44 ภาษาปลายทาง สรุปด้วย AI ใน 10 รูปแบบ และโน้ตที่แชร์ได้ พร้อมข้อจำกัดที่พูดตรง ราคาที่แน่นอน และสิ่งที่ความแม่นยำของการถอดเสียงการประชุมต้องการจริง ๆ
แปดคนยืนอยู่ในห้องหนึ่ง คนหนึ่งกำลังอธิบายว่าทำไมการย้ายระบบถึงเลื่อน อีกสองคนฟังแบบครึ่ง ๆ กลาง ๆ ใครสักคนที่ยืนอยู่ด้านหลังพูดประโยคที่จะสำคัญมากในอีกสามสัปดาห์ และไม่มีใครจดมันไว้
นั่นคือวัตถุดิบ บทความนี้พูดถึงสิ่งที่ระบบของเราทำกับวัตถุดิบนั้น ทีละขั้นตอน ตั้งแต่วินาทีที่เสียงเริ่มไหล จนถึงวินาทีที่คุณวางลิงก์ลงในแชนเนล
นี่คือบทความแนะนำการใช้งานผลิตภัณฑ์จากทีมผู้สร้าง Telli.sh โดยติดตามเส้นทางของเสียงตั้งแต่การบันทึกหรืออัปโหลด ผ่านการถอดเสียง การแปล และการปรับเกลา ไปจนถึงโน้ตที่แชร์ได้ พร้อมระบุโมเดล ข้อจำกัด และราคาไว้ตลอดทาง
สรุปสั้น:
- ไฟล์บันทึกหนึ่งไฟล์จะผ่านห้าขั้นตอนการประมวลผล และทิ้งผลลัพธ์ที่เก็บแยกกันไว้สี่อย่าง ได้แก่ ถอดเสียงดิบ แผนผังผู้พูด สคริปต์ที่เรียบเรียงแล้ว และบทสรุปหนึ่งชุดต่อหนึ่งรูปแบบที่คุณเลือกใช้
- การระบุตัวผู้พูดทำงานบน
pyannote/speaker-diarization-community-1โดยประมวลผลเป็นก้อน ๆ และส่งเวกเตอร์เสียงต่อไปเรื่อย ๆ เพื่อให้คนเดิมได้ป้ายชื่อเดิมตั้งแต่นาทีที่ 5 จนถึงนาทีที่ 50- การแปลรองรับรหัสภาษา 44 รหัส ตัวอินเทอร์เฟซเองมี 15 ภาษา ส่วนบทสรุปมี 10 รูปแบบสำเร็จรูป บวกกับรูปแบบที่คุณตั้งเองด้วยชื่อ คำสั่ง และรายการหัวข้อ
- ดูราคาปัจจุบัน สำหรับรายเดือน รายปี จำนวนนาที และฟีเจอร์แต่ละแผน ซึ่งอาจเปลี่ยนแปลง ตรวจสกุลเงิน ภาษี และเงื่อนไขตอนชำระเงิน บทความนี้ไม่ใช่ใบเสนอราคา
ภาพ: Klean Denmark, "Daily sprint meeting", Wikimedia Commons, CC BY-SA 2.0 คือการประชุมแบบที่ไปป์ไลน์ทั้งหมดนี้มีไว้เพื่อรับมือ
เสียงเข้ามาได้สองทาง และสองทางนั้นไม่เหมือนกัน
ช่องทางเข้ามีอยู่สองทางพอดี และความต่างระหว่างสองทางนี้กำหนดทุกอย่างที่ตามมา
ทางแรกคือ การอัดสด เบราว์เซอร์เปิด AudioContext ที่ตรึงอัตราสุ่มตัวอย่างไว้ที่ 16,000 Hz โหลด AudioWorklet แล้วบัฟเฟอร์เสียงจากไมโครโฟนเป็นก้อนละ 4,096 แซมเปิล ซึ่งที่ 16 kHz เท่ากับหนึ่งแพ็กเก็ตทุก 256 มิลลิวินาที แต่ละก้อนถูกแปลงจากทศนิยม 32 บิตเป็น PCM จำนวนเต็ม 16 บิต แล้วส่งผ่าน WebSocket ไปที่ /ws/audio/{sessionId} ส่วนซ็อกเก็ตที่สอง /ws/session/{id} ทำหน้าที่เป็นช่องควบคุม ทั้งการเปลี่ยนภาษา การอัปเดตบริบท คำสั่ง SUMMARIZE และคำสั่ง FINISH ที่ปิดเซสชันแล้วเขียนโน้ต
ทางที่สองคือ การอัปโหลดไฟล์ คุณลากไฟล์บันทึกลงในหน้าต่างอัปโหลด ไฟล์จะสตรีมไปยัง POST /upload และเซิร์ฟเวอร์ตอบกลับเป็น JSON แบ่งด้วยบรรทัด เป็นสตรีมไม่ใช่วงกลมหมุน ๆ อินเทอร์เฟซจึงแสดงความคืบหน้าจริงเป็นขั้นตอนที่มีชื่อ แทนที่จะเป็นเปอร์เซ็นต์ที่กุขึ้นมา ข้อจำกัดที่ตายตัวควรพูดกันตรง ๆ ว่า ไฟล์ละไม่เกิน 500 MB และตัวเลือกไฟล์รับเฉพาะ audio/* เท่านั้น ถ้าการประชุมของคุณติดอยู่ในไฟล์บันทึกหน้าจอ MP4 คุณต้องดึงแทร็กเสียงออกมาก่อน วันนี้เรายังไม่ได้ทำแทนคุณ
ทั้งสองเส้นทางไหลมารวมที่แกนประมวลผลเดียวกัน ตั้งแต่ขั้นที่ 1 เป็นต้นไป ไฟล์อัดสดกับไฟล์ที่อัปโหลดจะถูกปฏิบัติเหมือนกันทุกประการ
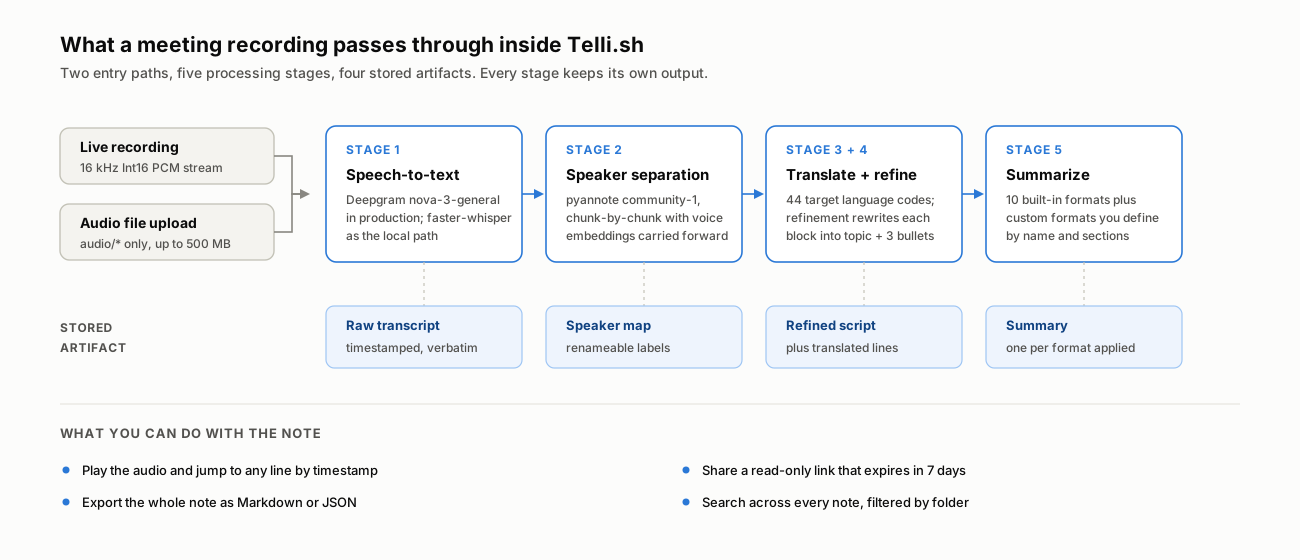
ทุกขั้นเก็บผลลัพธ์ของตัวเองไว้ ขั้นถัดไปไม่เขียนทับขั้นก่อนหน้า
ขั้นที่ 1 และ 2: ได้ยินคำพูด แล้วค่อยหาว่าเป็นคำของใคร
การรู้จำเสียงพูดทำงานก่อน บนระบบจริงทั้งเส้นทางแบบแบตช์และแบบสตรีมมิงใช้โมเดล nova-3-general ของ Deepgram ส่วนในโค้ดเบสยังมีเส้นทางที่รันในเครื่องทั้งหมดโดยอิงกับ faster-whisper สำหรับการติดตั้งเอง เลือกได้ด้วยการตั้งค่าผู้ให้บริการเพียงค่าเดียว การเลือกตรงนี้สำคัญน้อยกว่าที่หลายคนคาด ด้วยเหตุผลที่เราเขียนถึงไว้ยาวแล้วว่า โมเดลเสียงระดับนำในการวัดผลอิสระตอนนี้เกาะกลุ่มกันอยู่ในช่วงราว 1.5 จุดของอัตราความผิดพลาดระดับคำ เอนจินไม่ใช่จุดที่ความต่างด้านคุณภาพเกิดขึ้นอีกต่อไป
จุดนั้นคือการระบุตัวผู้พูด
การแยกผู้พูดทำงานบน pyannote/speaker-diarization-community-1 รายละเอียดการอิมพลีเมนต์ที่สำคัญจริง ๆ คือวิธีจัดการไฟล์บันทึกยาว ๆ แทนที่จะแยกผู้พูดทั้งไฟล์ในรอบเดียว ไปป์ไลน์จะประมวลผลเสียงเป็นก้อนและกำหนดผู้พูดทันทีหลังจบแต่ละก้อน แต่ก็เก็บพจนานุกรมเวกเตอร์เสียงของผู้พูดแต่ละคนสะสมไว้ แล้วระบุตัวใหม่เทียบกับชุดสะสมนั้นในทุกก้อนถัดไป กลไกนี้เองที่กันความล้มเหลวคลาสสิก ซึ่งไฟล์ยาวสองชั่วโมงค่อย ๆ เปลี่ยนชื่อคนเดิมจาก SPEAKER_00 เป็น SPEAKER_03 แล้วเป็น SPEAKER_07 ไปเรื่อย ๆ
เมื่อช่วงเสียงหนึ่งคาบเกี่ยวกับการพูดของสองคน ป้ายชื่อจะตกเป็นของฝ่ายที่ทับซ้อนมากกว่า ส่วนกรณีที่ทับซ้อนน้อยจะใช้ความคล้ายของเวกเตอร์เสียงเป็นตัวตัดสิน
สิ่งที่คุณได้คือป้ายชื่อกลาง ๆ อย่าง SPEAKER_00 และ SPEAKER_01 เพราะโมเดลไม่มีทางรู้ว่า SPEAKER_01 คือหัวหน้าฝ่ายวิศวกรรมของคุณ คุณเปลี่ยนชื่อครั้งเดียวในโน้ต แล้วการจับคู่นั้นจะถูกเก็บไว้กับโน้ตและใช้ทุกที่หลังจากนั้น รวมถึงในไฟล์ส่งออกและลิงก์แชร์ นี่คือการแบ่งงานที่ตรงไปตรงมา เครื่องแยกเสียงออกจากกัน คุณเป็นคนใส่ชื่อ
แต่ละขั้นทิ้งอะไรไว้จริง ๆ
กฎการออกแบบที่เรายึดคือ ไม่มีขั้นไหนทำลายผลลัพธ์ของขั้นก่อนหน้า คุณต้องย้อนกลับไปหาคำที่ถูกพูดจริง ๆ ได้เสมอ
ข้อมูลสี่กลุ่มคือตัวบทถอดเสียง ผังผู้พูด ข้อความเรียบเรียง และสรุป บรรทัดแปลแนบกับบทถอดเสียง แถวที่ห้าจึงไม่ใช่ผลลัพธ์อิสระชุดที่ห้า
| ผลลัพธ์ | สร้างโดยขั้น | มีอะไรอยู่ข้างใน | ใช้ทำอะไร |
|---|---|---|---|
| ถอดเสียงดิบ | ขั้นที่ 1 + 2 | บรรทัดคำต่อคำพร้อมเวลากำกับ และป้ายผู้พูดในทุกบรรทัด | ตรวจว่าพูดอะไรไว้ตามตัวอักษร คลิกบรรทัดเพื่อกระโดดไปยังเสียง |
| แผนผังผู้พูด | ขั้นที่ 2 (+ ที่คุณแก้) | การจับคู่ป้ายชื่อกับชื่อจริงในโน้ตนี้ | ทำให้มุมมองอื่นทั้งหมดอ่านรู้เรื่อง ใช้ทั้งในโน้ต ไฟล์ส่งออก และลิงก์แชร์ |
| สคริปต์ที่เรียบเรียง | ขั้นที่ 4 | แต่ละก้อนถูกเขียนใหม่เป็นหัวข้อตัวหนาหนึ่งบรรทัดกับไม่เกิน 3 ประเด็น | กวาดตาดูการประชุมยาว ๆ โดยไม่ต้องอ่านทั้งหมด |
| บรรทัดที่แปลแล้ว | ขั้นที่ 3 | คำแปลติดอยู่กับแต่ละบรรทัดข้างต้นฉบับ | อ่านการประชุมที่จัดด้วยภาษาที่คุณไม่ได้ใช้ทำงาน |
| บทสรุป | ขั้นที่ 5 | เอกสารที่มีโครงสร้างหนึ่งชุดต่อหนึ่งรูปแบบที่ใช้ | สิ่งที่คุณส่งให้คนอื่นจริง ๆ |
ในหน้าโน้ต สิ่งเหล่านี้ปรากฏเป็นแท็บสามประเภท ได้แก่ ประวัติ (ถอดเสียงดิบ) สคริปต์ (ฉบับเรียบเรียง) และอีกหนึ่งแท็บต่อหนึ่งรูปแบบบทสรุปที่คุณสร้าง ถ้าเสียงของไฟล์บันทึกถูกเก็บไว้ จะมีเครื่องเล่นอยู่ด้านบน และการคลิกบรรทัดใดก็ตามในถอดเสียงจะเลื่อนเสียงไปยังเวลานั้น
ขั้นที่ 3: ตัวเลขที่สำคัญของการแปลในการประชุมคือ 44
การแปลการประชุมแบบเรียลไทม์คือฟีเจอร์ที่ดึงผู้ใช้ยุคแรกมาหาเรามากที่สุด และขอบเขตของมันควรถูกพูดให้ชัด เพราะ "รองรับกว่า 100 ภาษา" คือข้อความที่ตรวจสอบได้ยากที่สุดในหมวดสินค้านี้
มีตัวเลขสองตัวที่ต่างกัน และไม่ใช่ตัวเดียวกัน
- รหัสภาษาปลายทางที่รับสำหรับการแปลมี 44 รหัส ชุดนี้ถูกระบุไว้อย่างชัดเจนในการตั้งค่าฝั่งแบ็กเอนด์ และแยก
zh-TWออกจากzhซึ่งมีน้ำหนักมากกว่าที่ฟังดู หากคุณทำงานคาบเกี่ยวระหว่างไต้หวันกับจีนแผ่นดินใหญ่ - ภาษาที่รองรับสำหรับตัวอินเทอร์เฟซเองและสำหรับภาษาที่ AI ใช้เขียนบทสรุปมี 15 ภาษา ได้แก่ อังกฤษ เกาหลี ญี่ปุ่น จีน เยอรมัน ฝรั่งเศส สเปน อิตาลี โปรตุเกส รัสเซีย โปแลนด์ เวียดนาม ไทย อินโดนีเซีย และมลายู
ในเซสชันสด การแปลเกิดขึ้นแบบทยอย ไม่ใช่รวบไว้ตอนจบ เมื่อขอบเขตเครื่องหมายวรรคตอนมาถึงในถอดเสียง คำแปลของช่วงนั้นจะไหลเข้ามาข้างต้นฉบับ และแคชระดับเซสชันจะป้องกันการแปลซ้ำข้อความที่ไม่ได้เปลี่ยน ส่วนการอัปโหลดไฟล์จะรวบบรรทัดเป็นชุดแทน เพราะเมื่อไม่มีใครนั่งจ้องหน้าจอ ปริมาณงานต่อเวลาสำคัญกว่าความหน่วง
นอกจากนี้ยังมี โหมดเวิร์กโฟลว์แปล ที่แยกจากโหมดโน้ต สำหรับกรณีที่คำแปลนั่นแหละคือผลลัพธ์ เช่นบทสนทนาสองภาษาที่คุณต้องตามให้ทันสด ๆ ไม่ใช่การประชุมที่ต้องการรายงานการประชุม
ขั้นที่ 4: ขั้นที่ไม่มีใครร้องขอ แต่ทุกคนต้องการ
ถึงตรงนี้บทความเปลี่ยนจากคำอธิบายเป็นความเห็น และเราจะไม่พูดให้อ่อนลง การเรียบเรียงคือขั้นที่ถูกประเมินค่าต่ำที่สุดในไปป์ไลน์นี้
ถอดเสียงคำต่อคำของคำพูดมนุษย์แทบอ่านไม่ได้ คนเราขึ้นประโยคใหม่กลางคัน ปล่อยประโยคค้าง พูดว่า "ครับ ครับ ใช่" สี่รอบ และฝังการตัดสินใจหนึ่งอย่างไว้ในเก้าสิบวินาทีของการกระแอม การถอดเสียงสิ่งนั้นให้ถูกทุกคำก็ยังเป็นเก้าสิบวินาทีของการกระแอมอยู่ดี
ขั้นเรียบเรียงจึงหยิบบทสนทนาแต่ละก้อนมาเขียนใหม่ภายใต้ข้อจำกัดที่รัดกุม ซึ่งนิยามอยู่ในเทมเพลตพรอมป์ไม่ใช่ในโค้ด เราจึงปรับได้โดยไม่ต้องดีพลอย แต่ละก้อนกลายเป็นหัวข้อตัวหนาหนึ่งบรรทัดที่กลั่นมาจากเนื้อหา ไม่ใช่จากชื่อบทบาท และไม่ใส่วงเล็บเหลี่ยม ตามด้วยหัวข้อย่อยไม่เกินสามข้อ โดยตั้งเป้าราว 300 ตัวอักษรต่อก้อน ชื่อผู้พูดและเวลากำกับถูกตัดออกอย่างจงใจ เพราะมีอยู่แล้วในถอดเสียงดิบ และการพูดซ้ำมีแต่ทำให้มุมมองที่ออกแบบมาให้กวาดตาดูนั้นกวาดตาได้ยากขึ้น
ข้อจำกัดหนึ่งในเทมเพลตนั้นควรถูกเอ่ยถึงเป็นพิเศษ โมเดลถูกสั่งให้ใช้ระดับภาษาให้ตรงกับสิ่งที่ได้ยิน และโดยเฉพาะอย่างยิ่งห้ามยัดโทนการประชุมธุรกิจใส่บทสนทนาสบาย ๆ การคุยกันตรงทางเดินที่ถูกสรุปราวกับรายงานการประชุมคณะกรรมการ เป็นผลลัพธ์ที่แย่กว่าการไม่มีบทสรุปเลย
เราเรียกผลลัพธ์นั้นว่า สคริปต์ ฉบับที่อ่านรวดเดียวจบ อยู่ห่างจากฉบับที่ยกไปอ้างอิงตอนมีข้อพิพาทได้เพียงหนึ่งแท็บ
ขั้นที่ 5: บทสรุปสิบรูปแบบ เพราะคำว่า "สรุป" ไม่ใช่สิ่งเดียว
ขั้นสุดท้ายผลิตเอกสารที่คุณส่งออกไปจริง ๆ การบอกโมเดลภาษาว่า "ช่วยสรุปให้หน่อย" จะได้บทสรุปของอะไรก็ไม่รู้ รูปแบบจึงเป็นตัวเลือกระดับหนึ่งในระบบนี้ ไม่ใช่ค่าตั้งต้นที่ซ่อนไว้
รูปแบบที่มีมาให้มีสิบแบบ ได้แก่ สรุปด้วย AI (ทั่วไป) รายงานการประชุม รายงานสรุปผู้บริหาร โน้ตบรรยาย เทศนา / การบรรยาย บันทึกการให้คำปรึกษา สรุปการโทร สัมภาษณ์ โน้ตไอเดีย และ โครงร่างงานนำเสนอ แต่ละแบบมีโครงสร้างหัวข้อของตัวเอง รายงานการประชุมให้ภาพรวม ประเด็นที่หารือ ข้อตัดสินใจ และขั้นตอนถัดไป ส่วนโครงร่างงานนำเสนอให้เค้าโครง ลำดับสไลด์ สารสำคัญ โน้ตผู้บรรยาย และการดำเนินการถัดไป ตัวหัวข้อเองถูกทำเป็นภาษาท้องถิ่นแยกตามภาษา ไม่ใช่แปลตอนสร้างเนื้อหา นั่นคือเหตุผลที่บทสรุปภาษาญี่ปุ่นอ่านเหมือนเอกสารญี่ปุ่น ไม่ใช่เอกสารอังกฤษที่ถูกแปล
เมื่อไม่มีแบบไหนในสิบแบบที่เข้าท่า คุณกำหนด รูปแบบของตัวเอง ได้ ทั้งชื่อ ชุดคำสั่ง และรายการหัวข้อที่ต้องการ บันทึกไว้แล้วใช้ซ้ำได้ "อัปเดตรายสัปดาห์ให้คณะกรรมการ พร้อมความเสี่ยงและข้อตัดสินใจที่ค้างอยู่" คือรูปแบบที่เขียนครั้งเดียวจบ
รูปแบบใดก็สามารถนำมาใช้กับโน้ตย้อนหลังได้ และแต่ละแบบจะสร้างแท็บของตัวเอง การสรุปไฟล์เดียวกันสามแบบสำหรับผู้อ่านสามกลุ่ม ที่นี่ถือเป็นการใช้งานปกติ ไม่ใช่การเลี่ยงข้อจำกัด
ความแม่นยำของการถอดเสียงการประชุมคือชั้นซ้อนกัน ไม่ใช่ตัวเลขเดียว
อัตราความผิดพลาดระดับคำเป็นเพียงส่วนหนึ่งของการประเมินบทถอดเสียงการประชุม ในบทความ ความแม่นยำของ STT อย่างเดียวไม่พอ เราอธิบายว่าทำไมการทำคำว่า "ไม่" หล่นไปเพียงคำเดียวจึงพลิกการตัดสินใจได้ ทั้งที่แทบไม่กระทบคะแนนโดยรวม
ฉบับใช้งานจริงคือ ความแม่นยำของการถอดเสียงที่รอดจากการประชุมจริงประกอบขึ้นจากห้าชั้น และโมเดลอะคูสติกเป็นเพียงชั้นล่างสุด
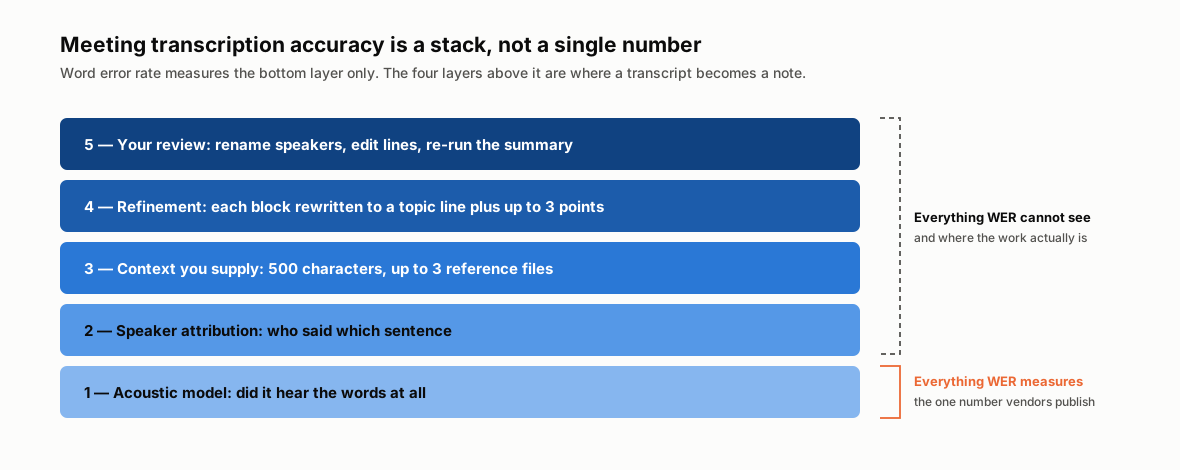
อัตราความผิดพลาดระดับคำวัดแค่ชั้นที่ 1 สิ่งที่ตัดสินว่าถอดเสียงนั้นใช้งานได้ไหมคือชั้นที่ 2 ถึง 5
ชั้นที่ 3 คือชั้นที่ผู้ใช้ควบคุมได้โดยตรงแต่คนส่วนใหญ่ข้ามไป ก่อนอัดหรืออัปโหลด คุณใส่ บล็อกบริบทได้ยาวไม่เกิน 500 ตัวอักษร ทั้งหัวข้อ ชื่อผู้เข้าร่วม รหัสสินค้า และตัวย่อ และแนบ ไฟล์อ้างอิงได้ไม่เกิน 3 ไฟล์ ทั้ง PDF รูปภาพ หรือไฟล์ข้อความ ซึ่งข้อความในไฟล์จะถูกดึงออกมาในเบราว์เซอร์แล้วรวมเข้าไปในโควตา 500 ตัวอักษรเดียวกัน บริบทนี้จะถูกส่งต่อไปยังขั้นตอนที่ใช้ AI
ชื่อเฉพาะให้ข้อมูลมากแต่พบได้น้อยในข้อมูลฝึกทั่วไป ไม่ว่าจะเป็นชื่อโปรเจกต์ภายใน นามสกุลที่ไม่คุ้น หรือรหัสสินค้า การเพิ่มบริบท เช่น ระบุว่า "Kestrel" เป็นผลิตภัณฑ์และ "Ravi" เป็นบุคคล ช่วยให้ระบบรู้จำคำเหล่านี้ได้ ก่อนบันทึกเสียง ให้กรอกชื่อและคำศัพท์ที่ระบบอาจไม่รู้จักลงในช่องบริบท
จากศูนย์ถึงบันทึกการประชุมที่แชร์ได้ ในสิบเอ็ดขั้น
ว่ากันตรง ๆ ตั้งแต่การรันครั้งแรกจนถึงผลลัพธ์ที่แชร์ได้
- สมัครใช้งาน ดูราคาปัจจุบัน สำหรับรายเดือน รายปี จำนวนนาที และฟีเจอร์แต่ละแผน ซึ่งอาจเปลี่ยนแปลง ตรวจสกุลเงิน ภาษี และเงื่อนไขตอนชำระเงิน บทความนี้ไม่ใช่ใบเสนอราคา
- เลือกเส้นทาง จะเริ่มอัดสด หรือเปิดหน้าต่างอัปโหลดแล้วลากไฟล์เสียงเข้าไป (
audio/*ขนาดต่ำกว่า 500 MB) - ตั้งคู่ภาษา ภาษาต้นทางปล่อยให้ตรวจจับอัตโนมัติได้ ส่วนภาษาปลายทางเป็นตัวกำหนดว่าคำแปลและบทสรุปจะออกมาเป็นภาษาอะไร
- กรอกช่องบริบท ทั้งหัวข้อ ชื่อ และตัวย่อ ภายใน 500 ตัวอักษร แนบไฟล์อ้างอิงได้ถึง 3 ไฟล์ถ้ามีสไลด์หรือวาระการประชุม
- เลือกโฟลเดอร์ถ้าต้องการเก็บโน้ตไว้ที่ใดที่หนึ่งโดยเฉพาะ ย้ายทีหลังก็ได้
- เริ่มอัด หรือรอสตรีมการอัปโหลด ในเซสชันสด ถอดเสียงจะทยอยขึ้นตามที่คนพูด พร้อมคำแปลไหลเข้ามาข้าง ๆ ถ้าตั้งภาษาปลายทางไว้ ระหว่างอัปโหลดคุณจะเห็นขั้นตอนที่มีชื่อ ได้แก่ รู้จำเสียงพูด วิเคราะห์ เรียบเรียง สรุป และปิดงาน
- จบเซสชัน การจบจะทริกเกอร์ข้อความควบคุม
FINISHซึ่งไล่ช่วงสุดท้ายออกให้หมด รอการเรียบเรียงที่ค้างอยู่ บันทึกเสียง สร้างบทสรุป แล้วเขียนโน้ต - เปลี่ยนชื่อผู้พูด SPEAKER_00 กลายเป็นชื่อคนหนึ่งครั้ง แล้วการจับคู่จะกระจายไปทุกมุมมองและทุกไฟล์ส่งออก
- อ่านแท็บ สคริปต์ เพื่อจับใจความว่าประชุมเรื่องอะไร แล้วลงไปที่ ประวัติ คลิกบรรทัดเพื่อฟังเสียงตรงจุดนั้นเมื่อเห็นว่ามีอะไรผิดปกติ
- สร้างบทสรุปรูปแบบเพิ่มเติมถ้าผู้อ่านกลุ่มหนึ่งต้องการรายงานการประชุม และอีกกลุ่มต้องการรายงานสรุปผู้บริหาร
- แชร์หรือส่งออก ลิงก์แชร์เป็นแบบอ่านอย่างเดียว หมดอายุใน 7 วัน และตั้งรหัสผ่านเพิ่มได้ ส่วนการส่งออกให้ไฟล์ Markdown หรือ JSON โดยมีบทสรุป ก้อนที่เรียบเรียงแล้ว และถอดเสียงเต็มอยู่ในไฟล์เดียว
อัปโหลดไฟล์บันทึกที่คุณมีอยู่แล้ว
ราคาที่เรียบง่ายและโปร่งใส
ดูราคาปัจจุบัน สำหรับรายเดือน รายปี จำนวนนาที และฟีเจอร์แต่ละแผน ซึ่งอาจเปลี่ยนแปลง ตรวจสกุลเงิน ภาษี และเงื่อนไขตอนชำระเงิน บทความนี้ไม่ใช่ใบเสนอราคา
ใบอนุญาตปัจจุบันสำหรับใช้ส่วนตัวที่ไม่ใช่เชิงพาณิชย์ อ่านข้อกำหนด ความปลอดภัย และความเป็นส่วนตัว สอบถาม [email protected] เรื่องการเก็บข้อมูลและฝึก AI ก่อนอัปโหลดข้อมูลอ่อนไหว
สิ่งที่ Telli.sh ไม่ทำ
บทความผลิตภัณฑ์ที่ไล่เรียงแต่ความสามารถคือโฆษณา นี่คือคอลัมน์อีกด้าน
ไม่รับไฟล์วิดีโอ ตัวอัปโหลดรับเฉพาะ audio/* กรุณาดึงแทร็กเสียงออกมาก่อน
ไม่เข้าร่วมประชุมออนไลน์แทนคุณ ไม่มีบอตที่โทรเข้า Zoom, Meet หรือ Teams แล้วนั่งอยู่ในรายชื่อผู้เข้าร่วม คุณต้องอัดเสียงในห้อง หรืออัดเสียงจากเครื่องของคุณเอง หรืออัปโหลดไฟล์หลังจบ
ไม่ซ่อมเสียงที่คุณภาพแย่ ไมโครโฟนรอบทิศทางของแล็ปท็อปตัวเดียวที่หัวโต๊ะสิบสองที่นั่ง ในห้องผนังแข็ง จะทำให้การแยกผู้พูดแย่ลงไม่ว่าจะรันโมเดลของเจ้าไหน เสียงพูดที่ทับกันและผู้พูดที่อยู่ไกลคือจุดที่การระบุตัวผู้พูดพังก่อนเพื่อน โทรศัพท์เครื่องเดียวที่วางกลางโต๊ะชนะแล็ปท็อปที่ปลายโต๊ะทุกครั้ง และไม่มีค่าใช้จ่าย
ไม่รู้จักศัพท์เฉพาะของคุณ ถ้าคุณไม่บอก ดูชั้นที่ 3 ข้างต้น คำนามเฉพาะที่ไม่คุ้นคือแหล่งข้อผิดพลาดที่พบบ่อยที่สุด และช่องบริบทคือทางแก้
ป้ายผู้พูดเริ่มจากชื่อกลาง ๆ ไม่มีระบบไหนเดาได้ว่า SPEAKER_01 คือปรียา เปลี่ยนชื่อครั้งเดียวต่อหนึ่งโน้ตก็พอ
ลิงก์แชร์มีอายุจำกัด เจ็ดวันแล้วลิงก์ตาย นี่คือค่าตั้งต้นที่ตั้งใจไว้สำหรับเนื้อหาการประชุม ไม่ใช่ฟีเจอร์ที่เราลืม แต่ก็แปลว่าลิงก์แชร์ไม่ใช่คลังเก็บถาวร ถ้าต้องการเก็บยาวให้ส่งออกเป็น Markdown
สรุปให้ตรงจุด
Telli.sh เป็นมากกว่าผลิตภัณฑ์ถอดเสียง การถอดเสียงเป็นขั้นแรกจากทั้งหมดห้าขั้น ตามด้วยการระบุผู้พูด การปรับเกลา การแปล และการสรุป
สิ่งที่เราสร้างจริง ๆ คือระยะห่างระหว่างไฟล์บันทึกกับการตัดสินใจ นั่นคือการรู้ว่าใครพูด การบีบเก้าสิบวินาทีของการกระแอมให้เหลือประโยคเดียวที่อยู่ข้างใน การส่งประโยคนั้นออกมาในภาษาที่คนอ่านใช้ทำงาน และการวางมันไว้ในที่ที่เพื่อนร่วมงานเปิดได้ ไฟล์บันทึกคือหลักฐาน ส่วนโน้ตคือสิ่งที่เปลี่ยนว่าอาทิตย์หน้าจะเกิดอะไรขึ้น
ถ้าคุณมีไฟล์บันทึกการประชุม ลองใช้เสียงของคุณเองกับเวิร์กโฟลว์นี้ แล้วตรวจโน้ตที่ได้เทียบกับบทถอดเสียง
แหล่งอ้างอิง
- ความแม่นยำของ STT อย่างเดียวไม่พอ — บล็อก Telli.sh วันที่ 4 สิงหาคม 2026 — ข้อโต้แย้งเรื่องอัตราความผิดพลาดระดับคำฉบับเต็ม พร้อมช่วงคะแนนบนกระดาน
- pyannote/speaker-diarization-community-1 — Hugging Face — โมเดลแยกผู้พูดที่ใช้ในไปป์ไลน์นี้
- เอกสารโมเดล Deepgram Nova-3 — โมเดลรู้จำเสียงพูดที่ใช้บนระบบจริง
- ราคา Telli.sh — โควตาและราคาปัจจุบัน
- หน้าภาพบน Wikimedia Commons — ภาพหัวบทความ Klean Denmark, CC BY-SA 2.0
