Cinque fasi, quattro artefatti: che cosa fa davvero Telli.sh con la registrazione di una riunione
Una guida completa alla pipeline di Telli.sh: registrazione dal vivo o caricamento audio, trascrizione delle riunioni con IA e identificazione dei parlanti, traduzione in tempo reale verso 44 lingue di destinazione, riassunti IA in 10 formati e una nota condivisibile. Con i limiti dichiarati, i prezzi esatti e ciò che l'accuratezza della trascrizione richiede davvero.
Otto persone in piedi in una stanza. Una spiega perché la migrazione è slittata. Due ascoltano a metà. Qualcuno in fondo pronuncia la frase che tra tre settimane conterà, e nessuno la annota.
Questa è la materia prima. Questo articolo racconta che cosa ne fa il nostro sistema, fase per fase, dal momento in cui l'audio inizia a scorrere fino a quando incolli un link in un canale.
Lo diciamo subito, così nessuno deve indovinare: questo è un articolo di prodotto su Telli.sh, scritto dal team che lo costruisce. Ne pubblichiamo periodicamente, accanto ai nostri approfondimenti di ricerca. Qui abbiamo provato a descrivere il meccanismo con abbastanza precisione da permettere a un lettore scettico di verificare — nomi reali dei modelli, numeri reali, limiti reali — invece della solita nebbia di «basato sull'IA».
In breve:
- Una registrazione attraversa cinque fasi di elaborazione e lascia quattro artefatti conservati separatamente: la trascrizione grezza, la mappa dei parlanti, lo script sintetizzato e un riassunto per ogni formato applicato.
- L'identificazione dei parlanti gira su
pyannote/speaker-diarization-community-1, blocco per blocco, portandosi dietro le impronte vocali perché la stessa persona mantenga la stessa etichetta dal minuto 5 al minuto 50.- La traduzione accetta 44 codici lingua; l'interfaccia esiste in 15 lingue; i riassunti arrivano in 10 formati integrati più i formati personalizzati che definisci con nome, istruzioni ed elenco di sezioni.
- Il piano gratuito è di 60 minuti al mese senza carta. Quelli a pagamento costano 5, 8 e 10 dollari al mese per 300, 500 e 1.000 minuti.
Immagine: Klean Denmark, «Daily sprint meeting», Wikimedia Commons, CC BY-SA 2.0. Esattamente il tipo di riunione per cui esiste tutta questa pipeline.
Due modi per far entrare l'audio, e non sono lo stesso
I punti di ingresso sono esattamente due, e la differenza tra loro determina tutto il resto.
Il primo è la registrazione dal vivo. Il browser apre un AudioContext fissato a 16.000 Hz, carica un AudioWorklet e accumula l'ingresso del microfono in blocchi da 4.096 campioni: a 16 kHz, un pacchetto ogni 256 millisecondi. Ogni blocco passa da virgola mobile a 32 bit a PCM intero a 16 bit e viaggia via WebSocket verso /ws/audio/{sessionId}. Un secondo socket, /ws/session/{id}, porta il canale di controllo: cambi di lingua, aggiornamenti del contesto, il comando SUMMARIZE e il comando FINISH, che chiude la sessione e scrive la nota.
Il secondo è il caricamento di file. Trascini una registrazione nella finestra di caricamento, questa viene inviata in streaming a POST /upload e la risposta arriva come JSON delimitato da righe — un flusso, non una rotellina — così l'interfaccia mostra un avanzamento reale con passaggi nominati invece di una percentuale inventata. I limiti vanno detti chiaramente: 500 MB per file, e il selettore accetta soltanto audio/*. Se la riunione è dentro una registrazione dello schermo in MP4, la traccia audio va estratta prima. Oggi non lo facciamo al posto tuo.
I due percorsi confluiscono nella stessa dorsale di elaborazione. Dalla fase 1 in poi, una registrazione dal vivo e un file caricato sono trattati in modo identico.
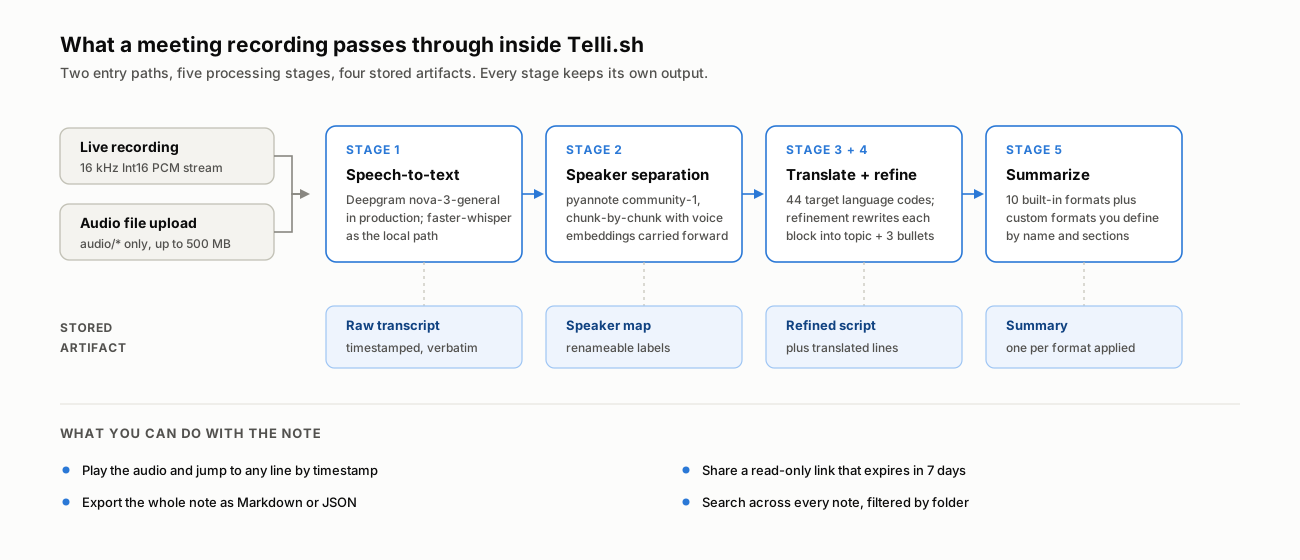
Ogni fase conserva il proprio output. Nulla viene sovrascritto dalla fase successiva.
Fasi 1 e 2: sentire le parole, poi capire di chi erano
Prima gira il riconoscimento vocale. In produzione, sia il percorso batch sia quello in streaming usano il modello nova-3-general di Deepgram; il codice include anche un percorso completamente locale basato su faster-whisper per installazioni self-hosted, selezionabile con una sola impostazione di provider. Quella scelta conta meno di quanto ci si aspetti, per un motivo su cui abbiamo scritto a lungo: i migliori modelli vocali nelle classifiche indipendenti si collocano oggi entro circa 1,5 punti percentuali di tasso di errore sulle parole. Il motore non è più il punto in cui nasce la differenza di qualità.
Nasce nell'identificazione dei parlanti.
La diarizzazione gira su pyannote/speaker-diarization-community-1. Il dettaglio implementativo che conta davvero è il modo in cui gestisce le registrazioni lunghe. Invece di diarizzare l'intero file in un colpo solo, la pipeline elabora l'audio a blocchi e assegna i parlanti subito dopo ciascun blocco, mantenendo però un dizionario cumulativo di impronte vocali per parlante e ri-identificando contro quell'insieme accumulato a ogni blocco successivo. È il meccanismo che impedisce il classico fallimento in cui una registrazione di due ore ribattezza silenziosamente la stessa persona SPEAKER_00, poi SPEAKER_03, poi SPEAKER_07 col passare della riunione.
Quando un segmento si sovrappone a due turni di parola, l'etichetta va al turno con la sovrapposizione maggiore, mentre la somiglianza delle impronte fa da spareggio nei casi di sovrapposizione minima.
Ricevi etichette generiche — SPEAKER_00, SPEAKER_01 — perché un modello non può sapere che SPEAKER_01 è la tua VP Engineering. Le rinomini una volta nella nota e la corrispondenza viene salvata insieme a essa e applicata ovunque dopo, anche nelle esportazioni e nei link di condivisione. Questa è la divisione onesta dei compiti: la macchina separa le voci, tu fornisci i nomi.
Che cosa lascia davvero ogni fase
La regola di progetto che rispettiamo è che nessuna fase distrugge l'output di quella precedente. Devi sempre poter tornare alle parole realmente pronunciate.
| Artefatto | Prodotto da | Contenuto | A che serve |
|---|---|---|---|
| Trascrizione grezza | Fasi 1 + 2 | Righe testuali con marca temporale ed etichetta del parlante su ciascuna | Verificare che cosa è stato detto alla lettera; cliccare una riga per posizionare l'audio |
| Mappa dei parlanti | Fase 2 (+ le tue modifiche) | La corrispondenza etichetta-nome della nota | Rende leggibili tutte le altre viste: si applica a nota, esportazioni e condivisioni |
| Script sintetizzato | Fase 4 | Ogni blocco riscritto come riga-argomento in grassetto più al massimo 3 punti | Scorrere una riunione lunga senza leggerla |
| Righe tradotte | Fase 3 | Una traduzione accanto a ciascuna riga originale | Leggere una riunione tenuta in una lingua che non usi |
| Riassunto | Fase 5 | Un documento strutturato per ogni formato applicato | La cosa che invii davvero alle persone |
Nell'interfaccia della nota compaiono come tre tipi di schede: Cronologia (trascrizione grezza), Script (versione sintetizzata) e una scheda per ogni formato di riassunto generato. Se l'audio della registrazione è stato salvato, sopra compare un lettore e cliccando una qualsiasi riga della trascrizione l'audio si posiziona su quella marca temporale.
Fase 3: nella traduzione il numero che conta è 44
La traduzione in tempo reale delle riunioni è la funzione che ha portato da noi la maggior parte dei primi utenti, e vale la pena precisarne l'ambito: «supporta oltre 100 lingue» è l'affermazione meno verificabile di questa categoria.
Ci sono due numeri diversi, e non sono lo stesso:
- Per la traduzione sono accettati 44 codici lingua di destinazione. Quell'insieme è elencato in modo esplicito nella configurazione del backend e distingue
zh-TWdazh, cosa che pesa più di quanto sembri se lavori tra Taiwan e la Cina continentale. - Le lingue supportate per l'interfaccia e per la lingua in cui l'IA scrive il riassunto sono 15: inglese, coreano, giapponese, cinese, tedesco, francese, spagnolo, italiano, portoghese, russo, polacco, vietnamita, thai, indonesiano e malese.
In una sessione dal vivo la traduzione è incrementale, non raccolta alla fine. Quando nella trascrizione arrivano confini di punteggiatura, la traduzione di quel segmento scorre accanto all'originale e una cache per sessione evita di ritradurre testo invariato. Nel caricamento di file le righe vengono invece raggruppate in lotti: quando nessuno guarda uno schermo, conta più il throughput della latenza.
Esiste inoltre una modalità di flusso traduzione, distinta dalla modalità nota, per i casi in cui la traduzione è il risultato: una conversazione bilingue da seguire in diretta, non una riunione da cui ricavare un verbale.
Fase 4: la fase che nessuno chiede e di cui tutti hanno bisogno
Qui si passa dalla descrizione all'opinione, e non la attenueremo: la sintesi è la fase più sottovalutata di questa pipeline.
Una trascrizione letterale del parlato umano è quasi illeggibile. Le persone ricominciano le frasi, lasciano cadere la voce, dicono «sì, sì, esatto» quattro volte e seppelliscono una decisione dentro novanta secondi di schiarimenti di gola. Trascriverli senza sbagliare una parola resta novanta secondi di schiarimenti di gola.
Perciò la fase di sintesi prende ogni blocco di conversazione e lo riscrive con vincoli stretti, definiti in un template di prompt e non nel codice, così possiamo regolarli senza un rilascio. Ogni blocco diventa una riga-argomento in grassetto derivata dal contenuto — non da un nome di ruolo, non tra parentesi quadre — seguita da al massimo tre punti elenco, con circa 300 caratteri per blocco come obiettivo. Nomi dei parlanti e marche temporali vengono rimossi esplicitamente: sono già nella trascrizione grezza, e ripeterli rende solo meno scorrevole la vista fatta per scorrere.
Un vincolo di quel template merita di essere nominato: al modello si chiede di adeguarsi al registro di ciò che ha ascoltato e, in particolare, di non imporre un tono da riunione aziendale a una conversazione informale. Una chiacchierata in corridoio riassunta come un verbale del consiglio è un artefatto peggiore dell'assenza di riassunto.
Il risultato lo chiamiamo script: la versione leggibile a colpo d'occhio, a una scheda di distanza dalla versione citabile in caso di contestazione.
Fase 5: dieci formati di riassunto, perché «riassunto» non è una cosa sola
L'ultima fase produce il documento che invii davvero. Chiedere a un LLM «un riassunto» restituisce il riassunto di niente in particolare, quindi qui il formato è una scelta di primo livello e non un default nascosto.
I formati integrati sono dieci: Riassunto IA (generale), Verbale di riunione, Report di sintesi, Appunti di lezione, Sermone / Conferenza, Registro di colloquio, Riassunto di chiamata, Intervista, Note di idee e Traccia di presentazione. Ciascuno porta la propria struttura di sezioni: il verbale produce panoramica, punti discussi, decisioni e passi successivi; la traccia di presentazione produce scaletta, flusso delle slide, messaggi chiave, note del relatore e azioni successive. I titoli delle sezioni sono localizzati per lingua invece di essere tradotti al momento della generazione, ed è per questo che un riassunto in giapponese si legge come un documento giapponese e non come un testo inglese tradotto.
Quando nessuno dei dieci va bene, definisci un formato personalizzato: un nome, una serie di istruzioni e l'elenco di sezioni che vuoi, salvato e riutilizzabile. «Aggiornamento settimanale al consiglio con rischi e decisioni aperte» è un formato che si scrive una volta sola.
Qualsiasi formato può essere applicato a una nota in un secondo momento e genera la propria scheda. Riassumere la stessa registrazione in tre modi per tre destinatari qui è uso normale, non un espediente.
L'accuratezza della trascrizione è uno stack, non un numero
Se stai confrontando strumenti di questa categoria, questa è la sezione con cui discutere.
L'industria pubblica un numero — il tasso di errore sulle parole — e quel numero ha smesso di essere utile per scegliere tra prodotti, perché sono tutti ammassati vicino al pavimento. Abbiamo smontato quell'argomento in dettaglio in L'accuratezza dello STT non basta, compreso il caso in cui una singola negazione persa ribalta una decisione costando lo 0,016% del budget di accuratezza.
Versione pratica: l'accuratezza di trascrizione che sopravvive al contatto con una riunione vera è fatta di cinque strati, e il modello acustico è solo quello più in basso.
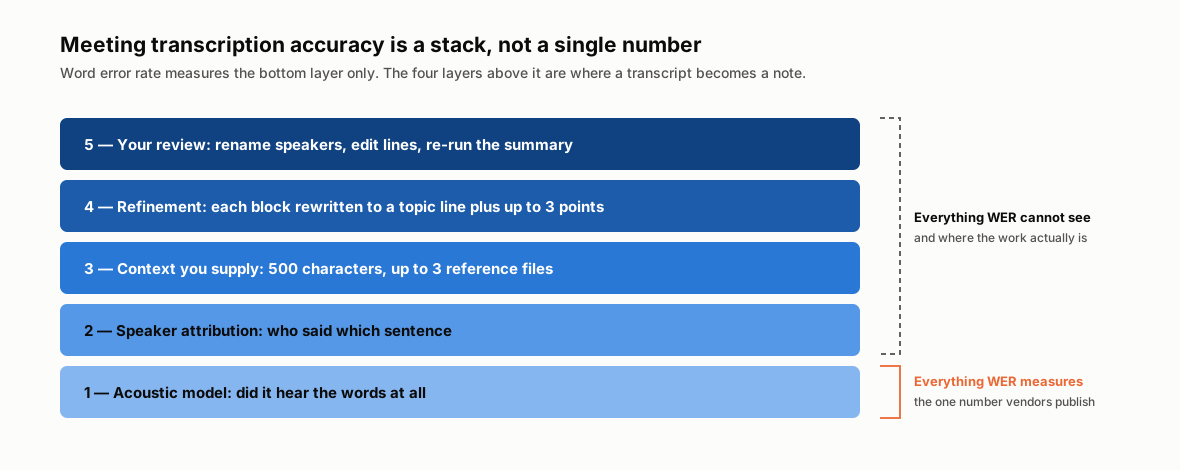
Il tasso di errore misura lo strato 1. Sono gli strati da 2 a 5 a decidere se la trascrizione è utilizzabile.
Lo strato 3 è quello che gli utenti controllano direttamente e che quasi tutti saltano. Prima di registrare o caricare puoi fornire un blocco di contesto fino a 500 caratteri — argomento, nomi dei partecipanti, codici prodotto, acronimi — e allegare fino a 3 file di riferimento (PDF, immagine o testo), il cui testo viene estratto nel browser e ripiegato nello stesso budget. Quel contesto viene passato alle fasi di IA.
Non è un accessorio. I nomi propri sono insieme le parole con più informazione e minor frequenza di qualsiasi riunione: nomi di progetti interni, cognomi insoliti, codici prodotto. Dire in anticipo al sistema che «Kestrel» è un prodotto e «Ravi» una persona costa quindici secondi ed elimina gli errori che altrimenti correggeresti a mano per dieci minuti. Se dopo questo articolo cambi una cosa sola, compila il campo del contesto.
Da zero a una nota condivisa, in undici passi
In concreto, dalla prima esecuzione all'artefatto condivisibile:
- Registrati. Il piano gratuito è di 60 minuti al mese, senza carta di credito, e usa la stessa identica pipeline dei piani a pagamento: è una differenza di quota, non di funzioni.
- Scegli il percorso: avvia una registrazione dal vivo, oppure apri la finestra di caricamento e trascina un file audio (
audio/*, sotto i 500 MB). - Imposta la coppia di lingue. L'origine può restare su rilevamento automatico; la lingua di destinazione decide in che lingua escono traduzione e riassunto.
- Compila il campo del contesto: argomento, nomi, acronimi, fino a 500 caratteri. Allega fino a 3 file di riferimento se hai una presentazione o un ordine del giorno.
- Scegli una cartella se vuoi archiviare la nota in un punto preciso. Puoi spostarla più tardi.
- Registra, oppure aspetta il flusso di caricamento. In una sessione dal vivo la trascrizione compare mentre le persone parlano, con la traduzione che scorre accanto se hai impostato una lingua di destinazione. Durante un caricamento vedrai passaggi nominati: riconoscimento vocale, analisi, sintesi, riassunto, finalizzazione.
- Chiudi la sessione. Questo attiva il messaggio di controllo
FINISH, che svuota l'ultimo segmento, attende la sintesi in corso, salva l'audio, genera il riassunto e scrive la nota. - Rinomina i parlanti. SPEAKER_00 diventa un nome una volta sola, e la corrispondenza si propaga a ogni vista e a ogni esportazione.
- Leggi la scheda Script per capire di che cosa parlava la riunione; passa a Cronologia e clicca una riga per ascoltare l'audio in quel preciso momento quando qualcosa non torna.
- Genera altri formati di riassunto se un pubblico ha bisogno del verbale e un altro del report di sintesi.
- Condividi o esporta. Un link di condivisione è in sola lettura, scade dopo 7 giorni e può avere una password facoltativa. L'esportazione restituisce Markdown o JSON, con riassunto, blocchi sintetizzati e trascrizione completa in un unico file.
Carica una registrazione che hai già
Quanto costa, in numeri esatti
La quota si conta in minuti di audio elaborato, ed è l'unica cosa che separa i livelli.
| Piano | Minuti al mese | Mensile | Annuale | Costo effettivo per 100 min |
|---|---|---|---|---|
| Gratuito | 60 | USD 0 | — | — |
| Plus | 300 | USD 5,00 | USD 51,00 | USD 1,67 |
| Pro | 500 | USD 8,00 | USD 81,60 | USD 1,60 |
| Pro+ | 1.000 | USD 10,00 | USD 102,00 | USD 1,00 |
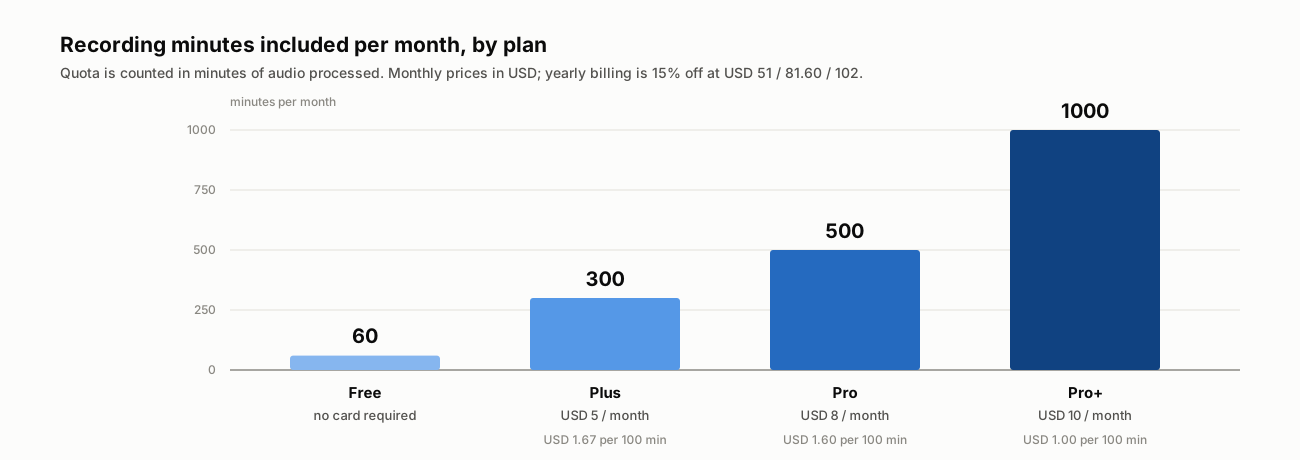
La fatturazione annuale è mensile × 12 × 0,85. Il costo al minuto migliora salendo di livello; la pipeline non cambia.
Sessanta minuti gratuiti sono una riunione lunga o tre stand-up. Bastano a rispondere all'unica domanda che conta: produce una nota che manderesti davvero? Sul tuo audio, non su una demo del fornitore.
Registra dal vivo la tua prossima riunione
Che cosa Telli.sh non fa
Un articolo di prodotto che elenca solo capacità è una pubblicità. Ecco l'altra colonna.
Non accetta file video. Il caricatore accetta audio/*. Estrai prima la traccia audio.
Non partecipa alle tue chiamate. Non c'è alcun bot che si colleghi a Zoom, Meet o Teams per comparire nella lista dei partecipanti. Registri la stanza, o l'audio del tuo computer, oppure carichi il file dopo.
Non aggiusta l'audio scadente. È il confine onesto dell'intera categoria. Un microfono omnidirezionale di portatile a un capo di un tavolo da dodici persone, in una stanza dalle pareti dure, produrrà una diarizzazione peggiore qualunque modello giri: parlato sovrapposto e parlanti lontani sono il primo punto in cui l'attribuzione cede. Un telefono al centro del tavolo batte ogni volta il portatile in fondo, e non costa nulla.
Non conosce il tuo lessico se non glielo dici. Vedi lo strato 3 qui sopra. I nomi propri inconsueti sono la fonte di errore più comune, e il campo del contesto è il rimedio.
Le etichette dei parlanti partono generiche. Nessun sistema può indovinare che SPEAKER_01 è Priya. Si rinomina una volta per nota.
I link di condivisione hanno una scadenza. Sette giorni, poi il link muore. È un default deliberato per contenuti di riunione, non una funzione dimenticata — ma significa anche che un link di condivisione non è un archivio. Esporta il Markdown se ti serve permanenza.
In conclusione
L'errore che abbiamo fatto all'inizio è stato pensarlo come un prodotto di trascrizione. Non lo è. La trascrizione è la fase uno di cinque, ed è quella più vicina a essere risolta.
Quello che costruiamo davvero è la distanza tra una registrazione e una decisione: sapere chi ha parlato, ridurre i novanta secondi di schiarimenti di gola all'unica frase che contengono, restituire quella frase nella lingua in cui lavora chi legge, e metterla dove un collega possa aprirla. La registrazione è una prova. La nota è ciò che cambia quello che succederà la settimana prossima.
Se in questo momento hai una registrazione di riunione sul computer, quello è l'unico benchmark che valga. Il nostro ha richiesto sessanta secondi di configurazione e ha prodotto una nota che abbiamo mandato a quattro persone.
Avvia una sessione dal vivo con traduzione
Fonti
- L'accuratezza dello STT non basta — blog Telli.sh, 4 agosto 2026 — l'argomento completo sul tasso di errore, con la dispersione della classifica
- pyannote/speaker-diarization-community-1 — Hugging Face — il modello di diarizzazione usato in questa pipeline
- Documentazione del modello Deepgram Nova-3 — il modello di riconoscimento vocale usato in produzione
- Prezzi di Telli.sh — le quote e i prezzi citati sopra
- Pagina dell'immagine su Wikimedia Commons — immagine di testata, Klean Denmark, CC BY-SA 2.0
