Lima tahap, empat artefak: apa yang sebenarnya Telli.sh lakukan pada rekaman rapat
Panduan menyeluruh atas seluruh pipeline Telli.sh: rekaman langsung atau unggah audio, transkripsi rapat berbasis AI dengan identifikasi pembicara, terjemahan rapat real-time ke 44 bahasa tujuan, ringkasan AI dalam 10 format, dan catatan yang bisa dibagikan. Lengkap dengan batasan yang jujur, harga persis, dan apa yang sebenarnya dituntut oleh akurasi transkripsi.
Delapan orang berdiri di sebuah ruangan. Satu orang menjelaskan kenapa migrasinya mundur. Dua orang mendengarkan setengah hati. Seseorang di belakang mengucapkan kalimat yang tiga minggu lagi akan jadi penting, dan tidak ada yang mencatatnya.
Itulah bahan mentahnya. Tulisan ini tentang apa yang sistem kami lakukan terhadap bahan itu, tahap demi tahap, sejak audio mulai mengalir sampai Anda menempelkan tautan ke sebuah kanal.
Kami sampaikan di depan supaya tidak perlu ditebak: ini tulisan produk tentang Telli.sh, ditulis oleh tim yang membangunnya. Kami menerbitkan tulisan semacam ini secara berkala, berdampingan dengan artikel riset kami. Yang kami usahakan di sini adalah menjelaskan mesinnya cukup presisi sehingga pembaca yang skeptis bisa memeriksa sendiri klaimnya — nama model yang nyata, angka yang nyata, batasan yang nyata, alih-alih kabut kata "bertenaga AI".
Ringkasnya:
- Satu rekaman melewati lima tahap pemrosesan dan meninggalkan empat artefak yang disimpan terpisah: transkrip mentah, peta pembicara, skrip yang sudah diringkas, dan satu ringkasan untuk tiap format yang Anda terapkan.
- Identifikasi pembicara berjalan di atas
pyannote/speaker-diarization-community-1, potongan demi potongan, sambil membawa sidik suara ke depan agar orang yang sama tetap memakai label yang sama dari menit ke-5 sampai menit ke-50.- Terjemahan menerima 44 kode bahasa; antarmukanya sendiri tersedia dalam 15 bahasa; ringkasan hadir dalam 10 format bawaan ditambah format khusus yang Anda tentukan lewat nama, instruksi, dan daftar bagian.
- Paket gratis adalah 60 menit per bulan tanpa kartu. Paket berbayar seharga 5, 8, dan 10 dolar per bulan untuk 300, 500, dan 1.000 menit.
Gambar: Klean Denmark, "Daily sprint meeting", Wikimedia Commons, CC BY-SA 2.0. Persis jenis rapat yang membuat seluruh pipeline ini ada.
Audio masuk lewat dua jalur, dan keduanya tidak sama
Titik masuknya tepat dua, dan perbedaan keduanya membentuk semua yang terjadi setelahnya.
Yang pertama adalah rekaman langsung. Peramban membuka AudioContext yang dipatok pada laju sampel 16.000 Hz, memuat AudioWorklet, lalu menyangga masukan mikrofon dalam blok 4.096 sampel — pada 16 kHz berarti satu paket tiap 256 milidetik. Tiap blok dikonversi dari float 32-bit menjadi PCM bilangan bulat 16-bit dan dikirim lewat WebSocket ke /ws/audio/{sessionId}. Soket kedua, /ws/session/{id}, membawa kanal kontrol: pergantian bahasa, pembaruan konteks, perintah SUMMARIZE, serta perintah FINISH yang menutup sesi dan menulis catatan.
Yang kedua adalah unggah berkas. Anda menjatuhkan rekaman ke jendela unggah, berkasnya dialirkan ke POST /upload, dan jawabannya kembali sebagai JSON berpembatas baris — aliran, bukan lingkaran berputar — sehingga antarmuka bisa menampilkan kemajuan nyata lewat langkah bernama, bukan persentase karangan. Batas kerasnya layak disebut apa adanya: 500 MB per berkas, dan pemilih berkas hanya menerima audio/*. Kalau rapat Anda terkurung di dalam rekaman layar MP4, jalur audionya harus dikeluarkan lebih dulu. Hari ini kami belum melakukannya untuk Anda.
Kedua jalur bertemu di tulang punggung pemrosesan yang sama. Sejak tahap satu, rekaman langsung dan berkas unggahan diperlakukan identik.
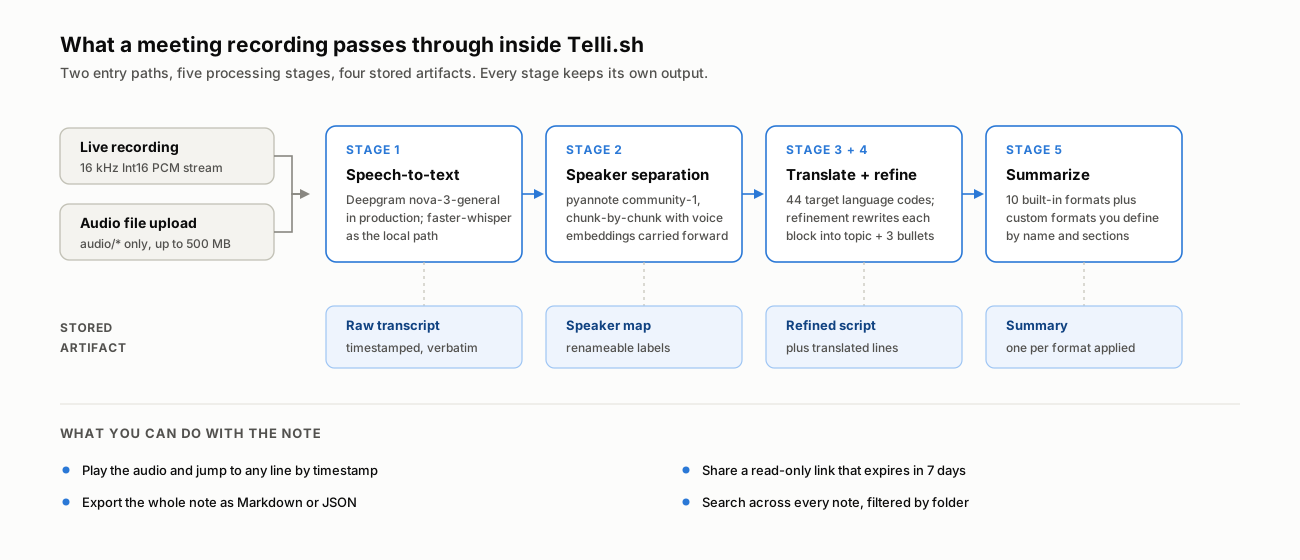
Tiap tahap menyimpan keluarannya sendiri. Tidak ada yang ditimpa oleh tahap sesudahnya.
Tahap 1 dan 2: mendengar kata-katanya, lalu memastikan itu kata siapa
Pengenalan suara berjalan lebih dulu. Di produksi, baik jalur batch maupun jalur streaming memakai model nova-3-general dari Deepgram; basis kodenya juga menyertakan jalur sepenuhnya lokal berbasis faster-whisper untuk pemasangan mandiri, dipilih lewat satu setelan penyedia. Pilihan itu tidak sepenting yang orang kira, dengan alasan yang sudah kami tulis panjang lebar: model-model suara teratas di tolok ukur independen kini berdesakan dalam rentang sekitar 1,5 poin persentase tingkat kesalahan kata. Mesin bukan lagi tempat perbedaan kualitas itu lahir.
Tempatnya ada di identifikasi pembicara.
Diarisasi berjalan di atas pyannote/speaker-diarization-community-1. Detail implementasi yang benar-benar berpengaruh adalah cara menangani rekaman panjang. Alih-alih mendiarisasi seluruh berkas dalam satu lintasan, pipeline memproses audio per potongan dan menetapkan pembicara segera setelah tiap potongan — sambil tetap memelihara kamus kumulatif sidik suara per pembicara, lalu mengenali ulang terhadap himpunan terkumpul itu pada setiap potongan berikutnya. Mekanisme inilah yang mencegah kegagalan klasik ketika rekaman dua jam diam-diam mengganti nama orang yang sama menjadi SPEAKER_00, lalu SPEAKER_03, lalu SPEAKER_07 seiring rapat berlarut.
Ketika satu segmen bertumpang tindih dengan dua giliran bicara, labelnya jatuh ke giliran yang tumpang tindihnya lebih besar, dengan kemiripan sidik suara sebagai penentu untuk kasus tumpang tindih kecil.
Anda menerima label generik — SPEAKER_00, SPEAKER_01 — karena model tidak mungkin tahu bahwa SPEAKER_01 adalah kepala teknik di kantor Anda. Anda menamainya sekali di catatan, dan pemetaan itu tersimpan bersama catatan lalu berlaku di mana pun sesudahnya, termasuk pada ekspor dan tautan berbagi. Itulah pembagian kerja yang jujur: mesin memisahkan suara, Anda yang memberi nama.
Apa yang benar-benar ditinggalkan tiap tahap
Aturan desain yang kami pegang: tidak ada tahap yang menghancurkan keluaran tahap sebelumnya. Anda harus selalu bisa kembali ke kata-kata yang betul-betul diucapkan.
| Artefak | Dihasilkan oleh | Isinya | Gunanya |
|---|---|---|---|
| Transkrip mentah | Tahap 1 + 2 | Baris kata per kata bercap waktu, dengan label pembicara di tiap baris | Memeriksa apa yang persis diucapkan; mengeklik baris untuk melompat ke audionya |
| Peta pembicara | Tahap 2 (+ suntingan Anda) | Pemetaan label ke nama pada catatan ini | Membuat semua tampilan lain terbaca — berlaku di catatan, ekspor, dan tautan berbagi |
| Skrip ringkas | Tahap 4 | Tiap blok ditulis ulang jadi satu baris topik tebal plus maksimal 3 poin | Menyisir rapat panjang tanpa membacanya |
| Baris terjemahan | Tahap 3 | Terjemahan yang menempel pada tiap baris asli | Membaca rapat yang berlangsung dalam bahasa yang bukan bahasa kerja Anda |
| Ringkasan | Tahap 5 | Satu dokumen terstruktur untuk tiap format yang diterapkan | Barang yang benar-benar Anda kirim ke orang lain |
Di antarmuka catatan, semuanya muncul sebagai tiga jenis tab: Riwayat (transkrip mentah), Skrip (versi ringkas), dan satu tab untuk tiap format ringkasan yang Anda buat. Jika audio rekamannya tersimpan, sebuah pemutar duduk di atasnya, dan mengeklik baris transkrip mana pun akan memindahkan audio ke cap waktu itu.
Tahap 3: dalam penerjemahan, angka yang penting adalah 44
Terjemahan rapat real-time adalah fitur yang paling banyak menarik pengguna awal kami, dan cakupannya pantas dinyatakan dengan tepat, sebab "mendukung lebih dari 100 bahasa" adalah klaim paling sulit diverifikasi di kategori ini.
Ada dua angka berbeda, dan keduanya bukan angka yang sama:
- 44 kode bahasa tujuan diterima untuk penerjemahan. Himpunan itu didaftar secara eksplisit di konfigurasi backend dan memisahkan
zh-TWdarizh— hal yang lebih berbobot daripada kedengarannya kalau Anda bekerja lintas Taiwan dan Tiongkok daratan. - 15 bahasa didukung untuk antarmukanya sendiri dan untuk bahasa yang dipakai AI menulis ringkasan Anda: Inggris, Korea, Jepang, Mandarin, Jerman, Prancis, Spanyol, Italia, Portugis, Rusia, Polandia, Vietnam, Thai, Indonesia, dan Melayu.
Dalam sesi langsung, penerjemahan berjalan bertahap, bukan dikumpulkan di akhir. Begitu batas tanda baca tiba di transkrip, terjemahan segmen itu mengalir di samping teks aslinya, dan cache per sesi mencegah teks yang tidak berubah diterjemahkan ulang. Pada unggah berkas, baris justru dikelompokkan per batch: ketika tidak ada yang menatap layar, keluaran per satuan waktu lebih penting daripada latensi.
Ada pula mode alur kerja terjemahan, terpisah dari mode catatan, untuk kasus ketika terjemahannya sendiri yang jadi hasil akhir — percakapan dwibahasa yang harus Anda ikuti langsung, bukan rapat yang perlu notulen.
Tahap 4: tahap yang tak diminta siapa pun tapi dibutuhkan semua orang
Di sini uraian berubah jadi pendapat, dan pendapat ini tidak akan kami lunakkan: peringkasan adalah tahap yang paling diremehkan di pipeline ini.
Transkrip kata per kata dari ucapan manusia nyaris tidak terbaca. Orang mengulang kalimat, menggantungkan ujungnya, mengucap "iya, iya, betul" empat kali, dan mengubur satu keputusan di dalam sembilan puluh detik dehaman. Menyalin itu tanpa satu pun salah kata tetap saja sembilan puluh detik dehaman.
Karena itu tahap peringkasan mengambil tiap blok percakapan dan menulisnya ulang di bawah batasan ketat, yang didefinisikan dalam templat prompt alih-alih di kode, sehingga bisa disetel tanpa penerapan ulang. Tiap blok menjadi satu baris topik tebal yang diturunkan dari isinya — bukan dari nama peran, tanpa kurung siku — diikuti paling banyak tiga butir, dengan target sekitar 300 karakter per blok. Nama pembicara dan cap waktu dihapus secara eksplisit: keduanya sudah ada di transkrip mentah, dan mengulanginya hanya membuat tampilan untuk penyisiran jadi lebih sulit disisir.
Satu batasan dalam templat itu pantas disebut namanya: model diminta menyesuaikan ragam bahasa dengan apa yang didengarnya, dan secara khusus tidak memaksakan nada rapat bisnis pada obrolan santai. Obrolan lorong yang diringkas seolah notulen rapat direksi adalah artefak yang lebih buruk daripada tidak ada ringkasan sama sekali.
Hasilnya kami sebut skrip — versi yang bisa dibaca sekilas, berjarak satu tab dari versi yang bisa dikutip saat terjadi perselisihan.
Tahap 5: sepuluh format ringkasan, karena "ringkasan" bukan satu hal
Tahap terakhir menghasilkan dokumen yang benar-benar Anda kirim. Meminta "sebuah ringkasan" kepada LLM akan memberi Anda ringkasan tentang tidak ada yang khusus, jadi format di sini adalah pilihan kelas satu, bukan nilai bawaan yang tersembunyi.
Sepuluh format tersedia bawaan: Ringkasan AI (umum), Notulen Rapat, Laporan Ringkas, Catatan Kuliah, Khotbah / Ceramah, Catatan Konseling, Ringkasan Panggilan, Wawancara, Catatan Ide, dan Kerangka Presentasi. Masing-masing membawa struktur bagiannya sendiri: notulen menghasilkan gambaran umum, poin diskusi, keputusan, dan langkah berikutnya; kerangka presentasi menghasilkan kerangka, alur slide, pesan kunci, catatan pembicara, dan tindakan lanjutan. Judul bagiannya sendiri dilokalkan per bahasa alih-alih diterjemahkan saat dihasilkan — itu sebabnya ringkasan berbahasa Jepang terbaca seperti dokumen Jepang, bukan teks Inggris hasil terjemahan.
Kalau tak satu pun dari sepuluh itu cocok, Anda mendefinisikan format khusus: sebuah nama, seperangkat instruksi, dan daftar bagian yang Anda inginkan, tersimpan dan bisa dipakai ulang. "Pembaruan mingguan untuk dewan dengan risiko dan keputusan terbuka" adalah format yang cukup ditulis sekali.
Format apa pun bisa diterapkan ke catatan setelahnya, dan masing-masing membuat tabnya sendiri. Meringkas rekaman yang sama dengan tiga cara untuk tiga pembaca di sini adalah pemakaian normal, bukan akal-akalan.
Akurasi transkripsi rapat adalah tumpukan, bukan satu angka
Kalau Anda sedang membandingkan perkakas di kategori ini, bagian inilah yang layak Anda bantah.
Industri menerbitkan satu angka — tingkat kesalahan kata — dan angka itu sudah tidak berguna untuk memilih antarproduk, karena semuanya berdesakan dekat lantai. Kami membongkar argumen itu secara rinci di Akurasi STT saja tidak cukup, termasuk kasus ketika satu kata "tidak" yang hilang membalik sebuah keputusan sambil hanya memakan 0,016% anggaran akurasi.
Versi praktisnya: akurasi transkripsi yang bertahan saat berhadapan dengan rapat sungguhan dibangun dari lima lapisan, dan model akustik hanyalah lapisan paling bawah.
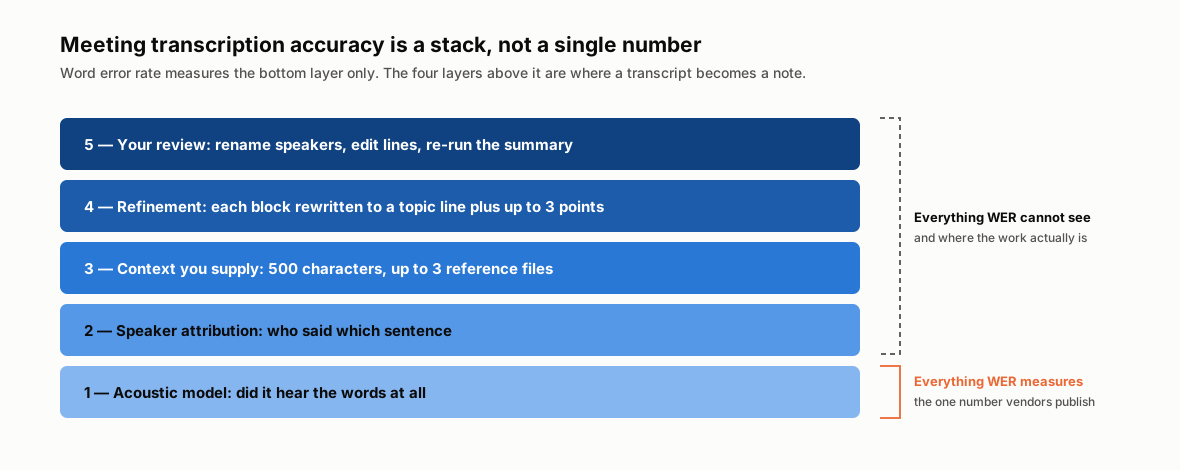
Tingkat kesalahan kata mengukur lapisan 1. Lapisan 2 sampai 5 yang menentukan transkrip itu berguna atau tidak.
Lapisan 3 adalah lapisan yang dikendalikan pengguna secara langsung dan justru paling sering dilewati. Sebelum merekam atau mengunggah, Anda bisa memberikan blok konteks hingga 500 karakter — topik, nama peserta, kode produk, akronim — dan melampirkan hingga 3 berkas rujukan (PDF, gambar, atau teks) yang teksnya diekstrak di peramban lalu dilipat ke dalam anggaran karakter yang sama. Konteks itu diteruskan ke tahap-tahap AI.
Ini bukan pemanis. Nama diri sekaligus merupakan kata dengan muatan informasi tertinggi dan frekuensi terendah di rapat mana pun: nama proyek internal, marga yang jarang, kode produk. Memberi tahu sistem lebih dulu bahwa "Kestrel" adalah produk dan "Ravi" adalah orang memakan lima belas detik, dan menghapus kesalahan yang jika tidak akan Anda perbaiki manual selama sepuluh menit. Kalau setelah tulisan ini Anda hanya mengubah satu hal, isilah kotak konteks.
Dari nol ke catatan yang dibagikan, dalam sebelas langkah
Konkretnya, dari percobaan pertama sampai artefak yang bisa dibagikan:
- Daftar. Paket gratisnya 60 menit per bulan, tanpa kartu kredit, dan menjalankan pipeline yang persis sama dengan paket berbayar — ini beda kuota, bukan beda fitur.
- Pilih jalurnya: mulai rekaman langsung, atau buka jendela unggah dan jatuhkan berkas audio (
audio/*, di bawah 500 MB). - Tetapkan pasangan bahasa. Sumber boleh dibiarkan pada deteksi otomatis; bahasa tujuan menentukan terjemahan dan ringkasan keluar dalam bahasa apa.
- Isi kotak konteks — topik, nama, akronim, sampai 500 karakter. Lampirkan hingga 3 berkas rujukan kalau Anda punya materi atau agenda.
- Pilih folder kalau catatan ingin diarsipkan di tempat tertentu. Bisa dipindah belakangan.
- Rekam, atau tunggu aliran unggahan. Dalam sesi langsung, transkrip muncul seiring orang berbicara, dengan terjemahan mengalir di sebelahnya bila bahasa tujuan sudah diatur. Selama unggahan Anda akan melihat langkah bernama: pengenalan suara, analisis, peringkasan, ringkasan, penyelesaian.
- Akhiri sesi. Itu memicu pesan kontrol
FINISH, yang mengeluarkan segmen terakhir, menunggu peringkasan yang sedang berjalan, menyimpan audio, menghasilkan ringkasan, dan menulis catatan. - Ganti nama pembicara. SPEAKER_00 berubah jadi sebuah nama satu kali, lalu pemetaannya menyebar ke setiap tampilan dan setiap ekspor.
- Baca tab Skrip untuk tahu rapat itu tentang apa; turun ke Riwayat dan klik satu baris untuk mendengar audionya persis di momen itu ketika ada yang terasa janggal.
- Buat format ringkasan tambahan kalau satu pembaca butuh notulen dan pembaca lain butuh laporan ringkas.
- Bagikan atau ekspor. Tautan berbagi bersifat baca-saja, kedaluwarsa dalam 7 hari, dan bisa diberi kata sandi opsional. Ekspor memberi Anda Markdown atau JSON, dengan ringkasan, blok ringkas, dan transkrip lengkap dalam satu berkas.
Unggah rekaman yang sudah Anda miliki
Berapa biayanya, dalam angka persis
Kuota dihitung dalam menit audio yang diproses, dan hanya itu yang membedakan tiap tingkat.
| Paket | Menit per bulan | Bulanan | Tahunan | Biaya efektif per 100 menit |
|---|---|---|---|---|
| Gratis | 60 | USD 0 | — | — |
| Plus | 300 | USD 5,00 | USD 51,00 | USD 1,67 |
| Pro | 500 | USD 8,00 | USD 81,60 | USD 1,60 |
| Pro+ | 1.000 | USD 10,00 | USD 102,00 | USD 1,00 |
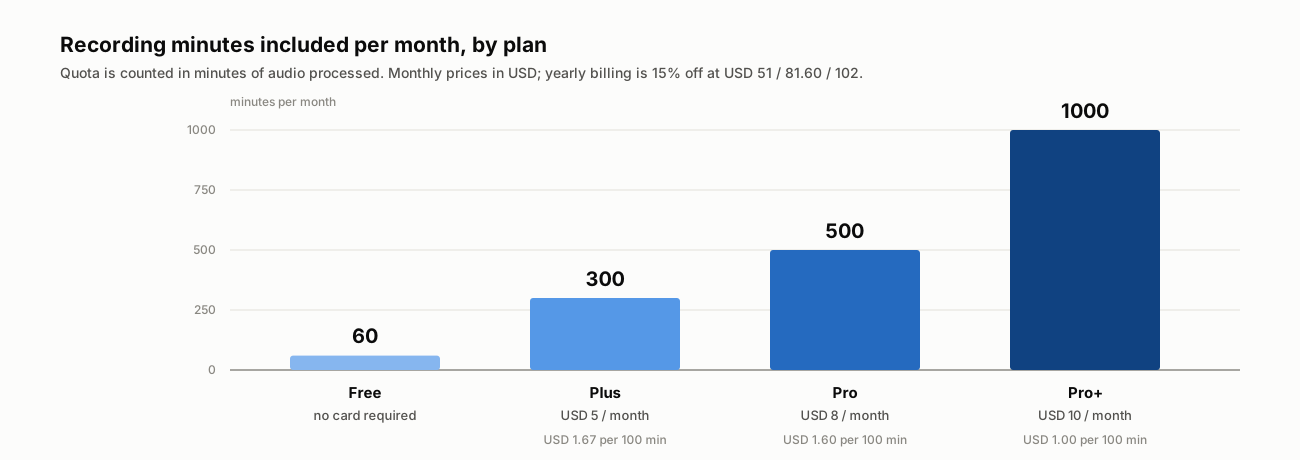
Penagihan tahunan adalah bulanan × 12 × 0,85. Tarif per menit membaik seiring naiknya tingkat; pipeline-nya tidak berubah.
Enam puluh menit gratis setara satu rapat panjang atau tiga stand-up. Cukup untuk menjawab satu-satunya pertanyaan yang penting: apakah ini menghasilkan catatan yang benar-benar akan Anda kirim? Dengan audio Anda sendiri, bukan demo vendor.
Rekam rapat Anda berikutnya secara langsung
Yang tidak dilakukan Telli.sh
Tulisan produk yang hanya mendaftar kemampuan adalah iklan. Ini kolom sebelahnya.
Tidak menerima berkas video. Pengunggah menerima audio/*. Keluarkan dulu jalur audionya.
Tidak ikut bergabung ke panggilan Anda. Tidak ada bot yang menelepon masuk ke Zoom, Meet, atau Teams lalu duduk di daftar peserta. Anda merekam ruangannya, atau audio mesin Anda sendiri, atau mengunggah berkasnya setelahnya.
Tidak memperbaiki audio yang buruk. Ini batas jujur dari seluruh kategori. Satu mikrofon omnidirectional laptop di ujung meja berisi dua belas orang, di ruangan berdinding keras, akan menghasilkan diarisasi yang menurun apa pun model yang berjalan — ucapan yang bertumpang tindih dan pembicara yang jauh adalah tempat atribusi pertama kali patah. Sebuah ponsel di tengah meja mengalahkan laptop di ujung meja setiap saat, dan biayanya nol.
Tidak tahu kosakata Anda kalau tidak diberi tahu. Lihat lapisan 3 di atas. Nama diri yang tidak lazim adalah sumber kesalahan paling umum, dan kotak konteks adalah obatnya.
Label pembicara dimulai dari nama generik. Tidak ada sistem yang bisa menebak SPEAKER_01 adalah Priya. Ganti nama sekali per catatan.
Tautan berbagi ada batas waktunya. Tujuh hari, lalu tautannya mati. Ini nilai bawaan yang disengaja untuk konten rapat, bukan fitur yang kelupaan — tapi artinya tautan berbagi bukan arsip. Ekspor Markdown-nya kalau Anda butuh sesuatu yang permanen.
Intinya
Kesalahan kami di awal adalah menganggap ini produk transkripsi. Bukan. Transkripsi adalah tahap satu dari lima, dan justru tahap yang paling dekat dengan selesai.
Yang sebenarnya kami bangun adalah jarak antara sebuah rekaman dan sebuah keputusan: tahu siapa yang berbicara, memampatkan sembilan puluh detik dehaman menjadi satu kalimat di dalamnya, menyajikan kalimat itu dalam bahasa kerja pembacanya, lalu menaruhnya di tempat yang bisa dibuka rekan kerja. Rekaman adalah bukti. Catatan adalah hal yang mengubah apa yang terjadi minggu depan.
Kalau sekarang ada rekaman rapat di komputer Anda, itulah satu-satunya tolok ukur yang layak dijalankan. Punya kami butuh enam puluh detik penyiapan dan menghasilkan catatan yang kami kirim ke empat orang.
Mulai sesi langsung dengan terjemahan
Sumber
- Akurasi STT saja tidak cukup — blog Telli.sh, 4 Agustus 2026 — argumen lengkap soal tingkat kesalahan kata, termasuk sebaran papan peringkat
- pyannote/speaker-diarization-community-1 — Hugging Face — model diarisasi yang dipakai di pipeline ini
- Dokumentasi model Deepgram Nova-3 — model pengenalan suara yang dipakai di produksi
- Harga Telli.sh — kuota dan harga yang dikutip di atas
- Halaman gambar di Wikimedia Commons — foto utama, Klean Denmark, CC BY-SA 2.0
