Google แปลการประชุมภาษาเวียดนามให้คุณแบบเรียลไทม์ได้ แต่ไม่ถอดเสียงการประชุมให้แม้แต่คำเดียว
คำบรรยายแปลของ Google Meet ครอบคลุม 69 ภาษารวมถึงภาษาเวียดนาม และ Live translate ของ Google Translate ครอบคลุม 74 ภาษา ทว่าฟีเจอร์ Transcripts ของ Meet และผู้ช่วยจดบันทึก Gemini รองรับเพียง 8 ภาษาเท่ากันทั้งคู่ และไม่มีภาษาเวียดนามอยู่ในรายการใดเลย ส่วน DeepL Voice ถอดเสียงพูดภาษาเวียดนามได้ผ่านผู้ให้บริการภายนอกเท่านั้น ซึ่งผู้ดูแลระบบต้องเปิดใช้งานเองและใช้การตรวจจับภาษาอัตโนมัติไม่ได้ บทวิเคราะห์ว่าการแปลในการประชุมแบบเรียลไทม์ให้อะไรกับทีมเวียดนามในปี 2026 จริง ๆ และการถอดเสียงการประชุมยังขาดอะไร — และอะไรที่มันไม่เคยให้เลย
ลองพิมพ์คำว่าการแปลเสียงพูดแบบสดลงใน Google เป็นภาษาเวียดนาม แล้วคุณจะได้คำตอบที่ดีจริง ๆ ฟีเจอร์ Live translate ของ Google Translate รองรับ 74 ภาษา โดยมีภาษาเวียดนามรวมอยู่ด้วย ทั้งบน Android และ iOS มันทำงานได้ทั้งแบบใส่และไม่ใส่หูฟัง ยังทำงานต่อเนื่องแม้ล็อกหน้าจอ และมีโหมดพูดคุยแบบเห็นหน้าที่แบ่งจอโทรศัพท์ออกเป็นสองซีก ให้ผู้พูดแต่ละฝ่ายอ่านซีกของตัวเอง
มันใช้งานได้จริง แต่นั่นไม่ใช่ประเด็นที่น่าสนใจ
ประเด็นที่น่าสนใจคือสิ่งที่เกิดขึ้นบนแพลตฟอร์มเดียวกันในอีกสี่ชั่วโมงต่อมา ตอนที่คุณอยากรู้ว่าตกลงกันไว้ว่าอย่างไร ฟีเจอร์ Transcripts ของ Google Meet ซึ่งเป็นตัวที่สร้าง Google Doc ที่เก็บไว้ได้ถาวร รองรับเพียงแปดภาษาเท่านั้น และไม่มีภาษาเวียดนามอยู่ในนั้น อีกทั้งยังไม่อยู่ในแปดภาษาที่ «Take notes for me» ของ Meet รองรับด้วย โดยหน้าช่วยเหลือของฟีเจอร์นี้ยังระบุเพิ่มว่ามัน «รองรับได้ครั้งละหนึ่งภาษา» และ «ยังไม่รองรับการพูดหลายภาษาในการประชุมเดียวกัน»
TL;DR
- ภาษาเวียดนามได้รับการรองรับในทุกฟีเจอร์ของ Google ที่ทำหน้าที่ฟัง ได้แก่ Live translate (74 ภาษา) และคำบรรยายแปลของ Meet (69 ภาษา) แต่ไม่ได้รับการรองรับในฟีเจอร์ที่ทำหน้าที่เขียน เลยสักตัว ทั้ง Meet Transcripts และผู้ช่วยจดบันทึก Gemini ของ Meet ซึ่งรองรับอย่างละ 8 ภาษา
- DeepL Voice แสดงคำบรรยายเป็นภาษาเวียดนามได้ แต่ถอดเสียงพูดภาษาเวียดนามด้วยโมเดลของตัวเองไม่ได้ ภาษาเวียดนามถูกจัดอยู่ในชั้นของผู้ให้บริการภายนอกที่ผู้ดูแลระบบต้องเปิดใช้งานเอง และใช้การตรวจจับภาษาอัตโนมัติไม่ได้
- ตารางเปรียบเทียบด้านล่างแสดงว่าภาษาเวียดนามรองรับบนแพลตฟอร์มหลักแต่ละรายตรงไหน ณ วันที่ 31 สิงหาคม 2026 ตามด้วยหกขั้นตอนสำหรับการประชุมเวียดนาม–อังกฤษที่ยังเหลือบันทึกไว้
ช่องว่างแบบเดียวกันนี้กระทบภาษาอื่นด้วย ดังที่เราอธิบายไว้ในภาพรวมเรื่องคำแปลที่หายไปหลังจบบทสนทนา สำหรับทีมที่ใช้ภาษาเวียดนาม ประเด็นนี้ชัดเจนยิ่งกว่า: ฟีเจอร์สำหรับเก็บบันทึกการประชุมไม่ได้รองรับภาษาเวียดนาม
วันนี้ «การแปลเสียงพูดแบบสด» ให้อะไรกับภาษาเวียดนามบ้าง
เริ่มจากการตีแผ่ตามจริง เพราะเครื่องมือฟรีของ Google ทำงานที่มันถูกสร้างมาให้ทำได้ดีมาก
ตามหน้าช่วยเหลือฝั่ง Android ที่เข้าถึงเมื่อวันที่ 31 สิงหาคม 2026 ฟีเจอร์ Live translate ของ Google Translate มาพร้อมสี่โหมด ได้แก่ Listening (แนบโทรศัพท์ไว้ที่หูหรือใส่หูฟังเพื่อแปลคำพูดของอีกฝ่ายแบบเรียลไทม์), Conversation (เล่นเสียงคำแปลออกลำโพง ผู้พูดผลัดกันพูด), Text only (อ่านอย่างเดียว ไม่มีเสียง) และ Custom settings นอกจากนี้ยังมีโหมด Face to face แยกต่างหาก ซึ่งจะแบ่งหน้าจอออกเป็นสองส่วน ให้ผู้พูดแต่ละฝ่ายเห็นทั้งข้อความถอดเสียงและคำแปลของภาษาตัวเองบนซีกของตน ไมโครโฟนจะตรวจจับเองโดยอัตโนมัติว่าภาษาหนึ่งจบลงและอีกภาษาเริ่มต้นเมื่อใด จึงไม่มีใครต้องคอยกดปุ่มระหว่างประโยค
มีรายละเอียดสองอย่างที่สมควรได้รับเครดิตมากกว่าที่เป็นอยู่ อย่างแรก เซสชันอยู่รอดจากการทำงานหลายอย่างพร้อมกัน เอกสารของ Google ระบุว่าการแปล «ดำเนินต่อไปอย่างราบรื่นเมื่อคุณสลับแอป ย่อหน้าต่างแอปพลิเคชัน หรือเมื่อหน้าจอล็อก» อย่างที่สอง ภาษาเวียดนามดาวน์โหลดมาใช้แบบออฟไลน์ได้ และแพ็กภาษาที่ดาวน์โหลดแล้วยังอัปเกรดเป็นเวอร์ชันคุณภาพสูงกว่าได้จากหน้าจอเดียวกัน ซึ่งสำคัญมากในประเทศที่การออกไปหน้างานหรือเข้าโรงงานไม่ได้การันตีว่าจะมีสัญญาณเสมอไป
มีข้อจำกัดหนึ่งที่ควรพูดตรง ๆ เพราะหลายคนประหลาดใจ นี่คือฟีเจอร์บนมือถือ หน้าช่วยเหลือของ Google สำหรับเวอร์ชันเว็บระบุไว้ในประโยคเดียวว่า «คุณไม่สามารถพูดและแปลไปพร้อมกันได้บน Google Translate สำหรับเว็บ» ถ้าการประชุมสองภาษาของคุณเกิดขึ้นบนแล็ปท็อป Live translate ก็ไม่ได้อยู่ในห้องนั้นด้วยเลย
สำหรับการนั่งแท็กซี่ ไปพบผู้ขาย หรือคุยกันตามทางเดินกับลูกค้าที่มาเยี่ยม Live translate เป็นตัวเลือกฟรีที่มีความสามารถ ช่องว่างจะปรากฏเมื่อการประชุมต้องการบันทึกที่คงอยู่และค้นหาได้หลังจบบทสนทนา
Gemini 3.5 Live Translate พา Meet จากห้าภาษาไปสู่มากกว่าเจ็ดสิบภาษา
การรองรับการแปลสดของ Google กำลังขยายเกินกว่าฟีเจอร์บนโทรศัพท์และคำบรรยายที่มีอยู่ ณ เวลาที่บทความนี้เผยแพร่
วันที่ 9 มิถุนายน 2026 Google ประกาศเปิดตัว Gemini 3.5 Live Translate โมเดลแปลเสียงเป็นเสียงที่ครอบคลุมมากกว่า 70 ภาษา ตามรายงานของ Slator เมื่อวันที่ 16 มิถุนายน 2026 โมเดลนี้กำลังทยอยเปิดให้ใช้ผ่าน Gemini Live API และ Google AI Studio ในสถานะพรีวิวสาธารณะ เข้าสู่พรีวิวแบบส่วนตัวใน Google Meet สำหรับลูกค้า Workspace บางกลุ่ม และปล่อยใช้งานทั่วโลกในแอป Google Translate บนมือถือทั้ง Android และ iOS
ตัวเลขที่มีความหมายต่อ Meet คือการเปรียบเทียบก่อนและหลัง การแปลเสียงพูดใน Meet เคยถูกจำกัดไว้ที่ห้าภาษาที่รองรับ และแปลได้เฉพาะจากและเป็นภาษาอังกฤษเท่านั้น Gemini 3.5 Live Translate ขยายขอบเขตนั้นเป็นมากกว่า 70 ภาษา และคู่ภาษามากกว่า 2,000 คู่ โดยมีแผนเปิดใช้งานในวงกว้างขึ้นภายในปี 2026 สำหรับทีมที่ใช้ภาษาเวียดนาม ระบบห้าภาษาที่ต้องผ่านภาษาอังกฤษเป็นตัวกลางแทบเท่ากับไม่มีระบบเลย ส่วนคู่ภาษา 2,000 คู่คือผลิตภัณฑ์คนละตัว
Google วางตำแหน่งโมเดลนี้ไว้อย่างจำกัดขอบเขต ซึ่งเป็นสัญญาณที่ดีมากกว่าสัญญาณร้าย ตามรายงานของ Slator เอกสารประกอบเปรียบเทียบ Live Translate กับความสามารถ Live Agent ที่กว้างกว่าของ Gemini โดยระบุว่ามันทำหน้าที่เป็นไปป์ไลน์การแปลแบบเรียลไทม์ รับเฉพาะอินพุตเสียง และตัดฟังก์ชันคอลลิง การอ้างอิงผลค้นหา เครื่องมือ และคำสั่งระบบออกไปโดยตั้งใจ มันคือล่าม ไม่ใช่ผู้ช่วย ซึ่งเป็นเส้นแบ่งเดียวกับที่ OpenAI ขีดไว้ตอนอธิบาย GPT-Realtime-Translate นอกจากนี้ Google ยังเพิ่มโหมดการฟังบน Android ที่ส่งเสียงคำแปลผ่านลำโพงหูฟังของเครื่อง ทำให้คุณติดตามคำแปลได้โดยไม่ต้องใส่หูฟังให้เห็นชัดในที่ประชุม
ชั้นการทำงานแบบสดสำหรับภาษาเวียดนามจึงกำลังดีขึ้นอย่างรวดเร็วและจากหลายทิศทางพร้อมกัน ทีนี้มาถึงอีกคำถามหนึ่ง
เส้นแบ่งของการถอดเสียงการประชุม: จุดที่ภาษาเวียดนามหยุดลง
ทุกแพลตฟอร์มมีเส้นแบ่งเส้นหนึ่ง ฝั่งหนึ่งคือฟีเจอร์ที่ช่วยให้คุณเข้าใจคำพูดในขณะที่มันกำลังเกิดขึ้น อีกฝั่งคือฟีเจอร์ที่เปลี่ยนคำพูดให้กลายเป็นสิ่งที่คุณยังหยิบมาใช้ได้ในสัปดาห์หน้า เรียกมันว่าเส้นแบ่งการบันทึก และสำหรับภาษาเวียดนาม นั่นคือจุดที่การรองรับหายไปพอดี
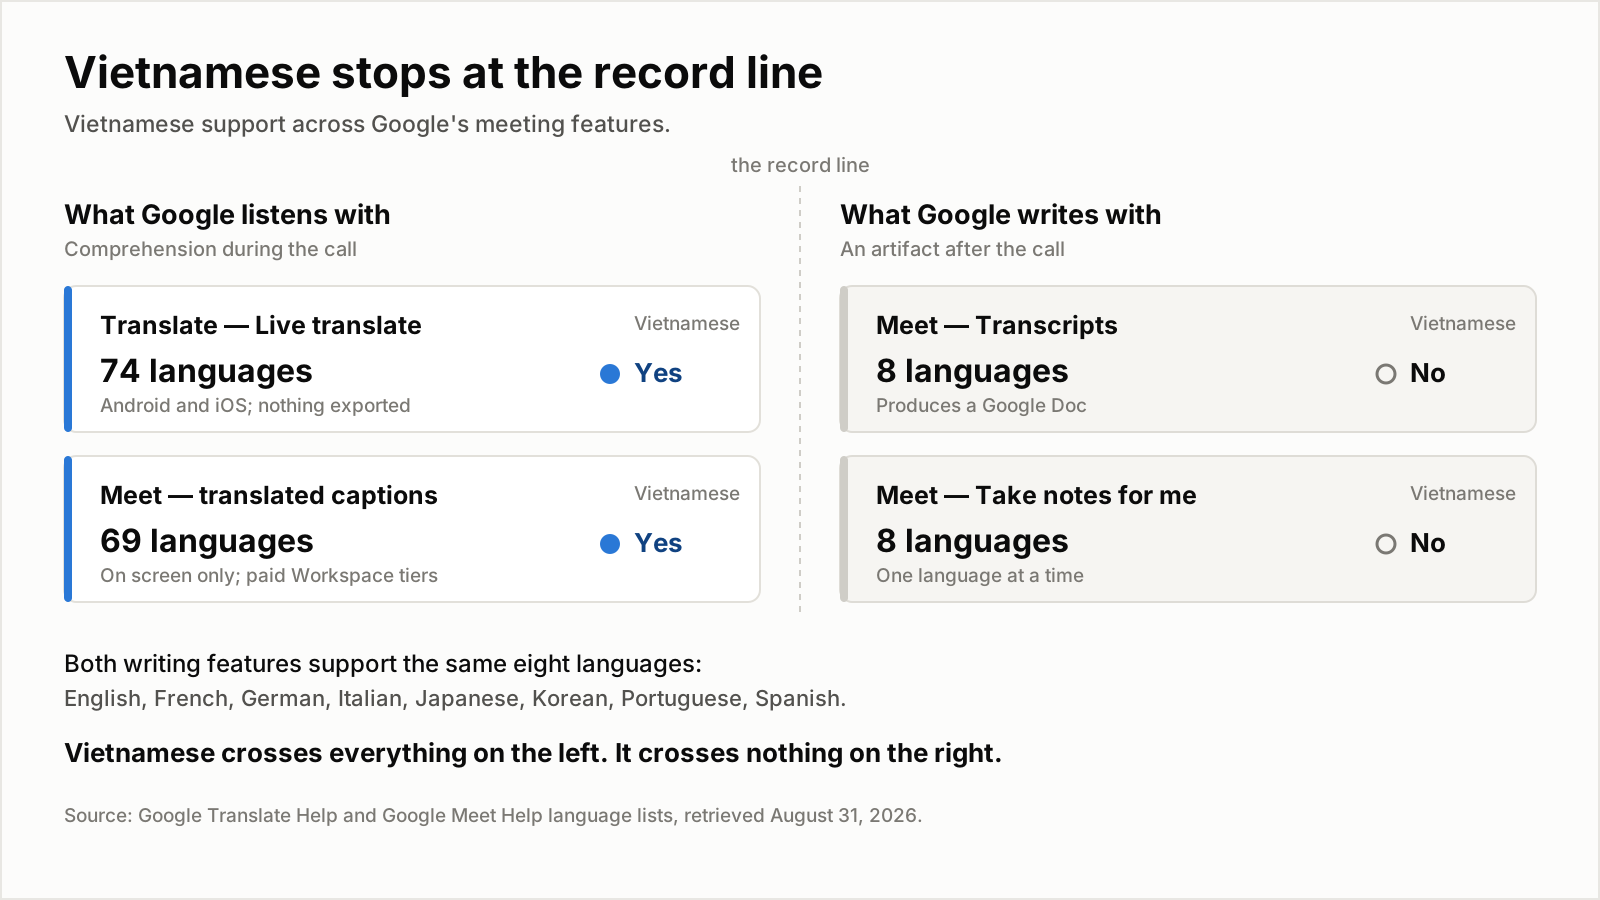
จำนวนภาษาเป็นตัวเลขของ Google เอง จากหน้าช่วยเหลือสี่หน้าที่เข้าถึงเมื่อวันที่ 31 สิงหาคม 2026 ภาษาเวียดนามปรากฏในฟีเจอร์ฝั่งการฟังทั้งสองตัว และไม่ปรากฏในฟีเจอร์ฝั่งการเขียนเลยสักตัว
การเปรียบเทียบแยกตามฟีเจอร์ทำให้เห็นขอบเขตนี้ชัดเจน:
| ฟีเจอร์ของ Google | รองรับภาษาเวียดนามไหม | จำนวนภาษา | ทิ้งหลักฐานไว้หลังจบสายไหม |
|---|---|---|---|
| Google Translate — Live translate | รองรับ | 74 | ไม่ |
| Google Meet — คำบรรยายแปล | รองรับ | 69 | แสดงบนหน้าจอเท่านั้น หากเปิด Record captions จะฝังลงในไฟล์บันทึก |
| Google Meet — Transcripts | ไม่รองรับ | 8 | ใช่ เป็น Google Doc |
| Google Meet — «Take notes for me» | ไม่รองรับ | 8 ครั้งละหนึ่งภาษา | ใช่ บันทึกใน Google Docs พร้อมสรุปส่งทางอีเมล |
| Google Meet — Gemini 3.5 Live Translate | กำลังทยอยเปิดใช้ | 5 ในวันนี้ และ 70+ ในพรีวิวแบบส่วนตัว | ไม่ได้ระบุ |
ข้อมูลทุกแถวมาจากหน้าช่วยเหลือของ Google และรายงานของ Slator วันที่ 16 มิถุนายน 2026 เข้าถึงเมื่อวันที่ 31 สิงหาคม 2026
แปดภาษาที่ Transcripts และ «Take notes for me» ใช้ร่วมกันนั้นเหมือนกันทุกประการ ได้แก่ อังกฤษ ฝรั่งเศส เยอรมัน อิตาลี ญี่ปุ่น เกาหลี โปรตุเกส และสเปน มันคือรายการเดียวกันสองครั้ง และเป็นรายการของตลาดขนาดใหญ่ในยุโรปกับเอเชียตะวันออก ภาษาเวียดนามซึ่งมีผู้พูดราว 97 ล้านคนตามตัวเลขที่ Samsung ระบุเองในบทความปี 2024 อยู่นอกรายการนั้น เช่นเดียวกับภาษาไทย อินโดนีเซีย ฮินดี และอาหรับ
ยังมีข้อจำกัดอีกข้อหนึ่งที่กระทบทีมสองภาษาโดยตรง และมีผลแม้กระทั่งกับทีมที่ทำงานด้วยภาษาที่รองรับทั้งหมด หน้าช่วยเหลือของ Google สำหรับ «Take notes for me» ระบุว่าฟีเจอร์นี้รองรับได้ครั้งละหนึ่งภาษา และยังไม่รองรับการพูดหลายภาษาในการประชุมเดียวกัน การประชุมระหว่างเวียดนามกับสหรัฐฯ ที่สลับไปมาระหว่างภาษาเวียดนามกับภาษาอังกฤษจึงถูกตัดสิทธิ์ถึงสองชั้น ชั้นแรกเพราะเป็นภาษาเวียดนาม ชั้นที่สองเพราะมีการสลับภาษา
คำบรรยายแปลของ Meet มีช่องทางเก็บไว้ได้จำกัด: เลือก Record captions เพื่อฝังคำบรรยายลงในวิดีโอที่บันทึก และยังย้อนดูคำบรรยายระหว่างเซสชันได้ อย่างไรก็ตาม คำบรรยายที่ฝังในวิดีโอไม่ใช่บทถอดเสียงที่ค้นหาและแก้ไขได้ อีกทั้งไม่มีข้อความสำหรับนำไปสร้างบทสรุป คำบรรยายแปลของ Meet จำกัดอยู่ใน Workspace แบบเสียเงิน ได้แก่ Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter (ใช้ได้ถึงวันที่ 30 มิถุนายน 2025) และ Google AI Pro for Education
DeepL แสดงคำบรรยายภาษาเวียดนามให้คุณได้ แต่การถอดเสียงพูดภาษาเวียดนามเป็นอีกชั้นหนึ่ง
DeepL Voice เป็นอีกทางเลือกหนึ่ง แต่เอกสารของบริษัทแยกภาษาที่ใช้ในการรู้จำเสียงพูดออกจากภาษาที่แสดงในคำบรรยาย
DeepL แยกการรองรับภาษาออกเป็นสองรายการ Spoken languages คือภาษาที่ตัวรู้จำเสียงรับได้ ส่วน Translation languages คือภาษาที่คำบรรยายแสดงผลได้ ภาษาเวียดนามปรากฏอยู่ในรายการภาษาแปล ซึ่งมีทั้งหมด 41 ภาษา ทีนี้ลองมองอีกฝั่ง โมเดลของ DeepL เองถอดเสียงพูดได้ 18 ภาษา ได้แก่ จีน (แมนดาริน) เช็ก ดัตช์ อังกฤษ ฝรั่งเศส เยอรมัน อินโดนีเซีย อิตาลี ญี่ปุ่น เกาหลี โปแลนด์ โปรตุเกส โรมาเนีย รัสเซีย สเปน สวีเดน ตุรกี และยูเครน ไม่มีภาษาเวียดนามอยู่ในนั้น
ภาษาเวียดนามใช้เป็นภาษาพูดได้จริง แต่อยู่ในชั้นที่สองเท่านั้น คือกลุ่ม 20 ภาษาที่ถอดเสียงโดยผู้ให้บริการภายนอกอย่าง Speechmatics และมีเงื่อนไขพ่วงมาสามข้อ ทั้งหมดมีบันทึกไว้ในหน้าช่วยเหลือของ DeepL ที่เข้าถึงเมื่อวันที่ 31 สิงหาคม 2026
- ผู้ดูแลระบบของทีมต้องเปิดใช้งานการประมวลผลโดยบุคคลที่สาม ในบัญชีผู้ดูแลขององค์กรก่อน มิฉะนั้นภาษาเหล่านี้จะใช้งานไม่ได้เลย
- การตรวจจับภาษาอัตโนมัติใช้ไม่ได้ ในถ้อยคำของ DeepL เอง «ภาษาของบุคคลที่สามใช้ร่วมกับ Auto-detect language ไม่ได้ ต้องเลือกเป็น Spoken language ด้วยตนเอง»
- หากต้องการให้ผู้เข้าร่วมเลือกภาษาพูดของตัวเองได้ ผู้จัดประชุมต้องเปิดใช้รหัสเข้าร่วม ตอนเชื่อมการประชุมเข้ากับ DeepL Voice
ไม่มีข้อไหนที่ไร้เหตุผล DeepL ระบุว่า Speechmatics ดำเนินงานภายใต้ข้อตกลงไม่เก็บรักษาข้อมูล ดังนั้นข้อมูลการถอดเสียงจะถูกลบออกจากเซิร์ฟเวอร์ของพวกเขาทันทีที่ประมวลผลเสร็จ แต่เมื่อนำเงื่อนไขทั้งหมดมาซ้อนกัน ผลในทางปฏิบัติคือ ผู้พูดภาษาเวียดนามที่เข้าร่วมการประชุมซึ่งติดตั้ง DeepL ไว้ อยู่ห่างจากการไม่ถูกถอดเสียงเลยเพียงแค่การตั้งค่าของผู้ดูแลระบบหนึ่งช่องที่ไม่ได้ติ๊ก และไม่อาจหวังพึ่งให้ระบบสังเกตเห็นเขาโดยอัตโนมัติ ขณะเดียวกันท่าทีเรื่องการเก็บรักษาข้อมูลก็เป็นแบบเดียวกับที่เราเขียนถึงเมื่อเช้านี้ คำถามที่พบบ่อยของ DeepL ระบุว่าข้อมูลการประชุมถูก «ประมวลผลชั่วคราวในหน่วยความจำและถูกลบทิ้งเมื่อสายจบลง»
Samsung คือตัวอย่างตรงข้ามที่ควรเอ่ยชื่อ ภาษาเวียดนามเป็นหนึ่งใน 16 ภาษาแรกที่ Galaxy AI เปิดตัว และสถาบันวิจัยและพัฒนา Samsung ประเทศเวียดนามได้เผยแพร่บทความที่ตรงไปตรงมาผิดปกติเมื่อวันที่ 23 พฤษภาคม 2024 ว่าทำไมงานนี้ถึงยาก ภาษาเวียดนามมีวรรณยุกต์ที่แตกต่างกันหกเสียง ตัวอย่างในบทความคือ ma, mả และ má ซึ่งแปลว่าผี หลุมศพ และแม่ ต่างกันที่วรรณยุกต์เพียงอย่างเดียว Bui Ngoc Tung หัวหน้าฝ่าย ASR ของสถาบันอธิบายว่าโมเดลต้องแยกแยะเฟรมเสียงขนาด «ราว 20 มิลลิวินาที» เพื่อตัดสินว่าเฟรมชุดหนึ่งเป็นของคำใด เมื่อผู้ผลิตมือถือสัญชาติเกาหลียอมลงทุนกับการสร้างแบบจำลองวรรณยุกต์ภาษาเวียดนาม ขณะที่บริษัทแปลสัญชาติยุโรปส่งงานนั้นต่อให้ผู้รับเหมาช่วง นั่นบอกอะไรบางอย่างเกี่ยวกับวิธีที่ตลาดตีราคาภาษานี้
ในด้านการรู้จำเสียง เอกสาร Nova-3 ของ Deepgram ระบุภาษาเวียดนามเป็น vi (เข้าถึงเมื่อวันที่ 31 สิงหาคม 2026) ซึ่งเป็นหนึ่งใน 58 ภาษาที่กล่าวถึงในบทวิเคราะห์ว่าคำว่า «รองรับ» ซ่อนอะไรไว้ในความครอบคลุมของระบบรู้จำเสียงพูด
ไม่มีผู้ให้บริการรายใดเผยแพร่อัตราความผิดพลาดของเสียงพูดภาษาเวียดนามในการประชุม และคลังข้อมูลอธิบายว่าทำไม
คะแนนการรู้จำเสียงพูดที่เผยแพร่ยังไม่บอกทีมต่าง ๆ ว่าการถอดเสียงภาษาเวียดนามในการประชุมที่เกิดขึ้นอย่างเป็นธรรมชาติจะมีประสิทธิภาพเพียงใด ส่วนคลังข้อมูลที่มีอยู่ช่วยอธิบายช่องว่างนี้
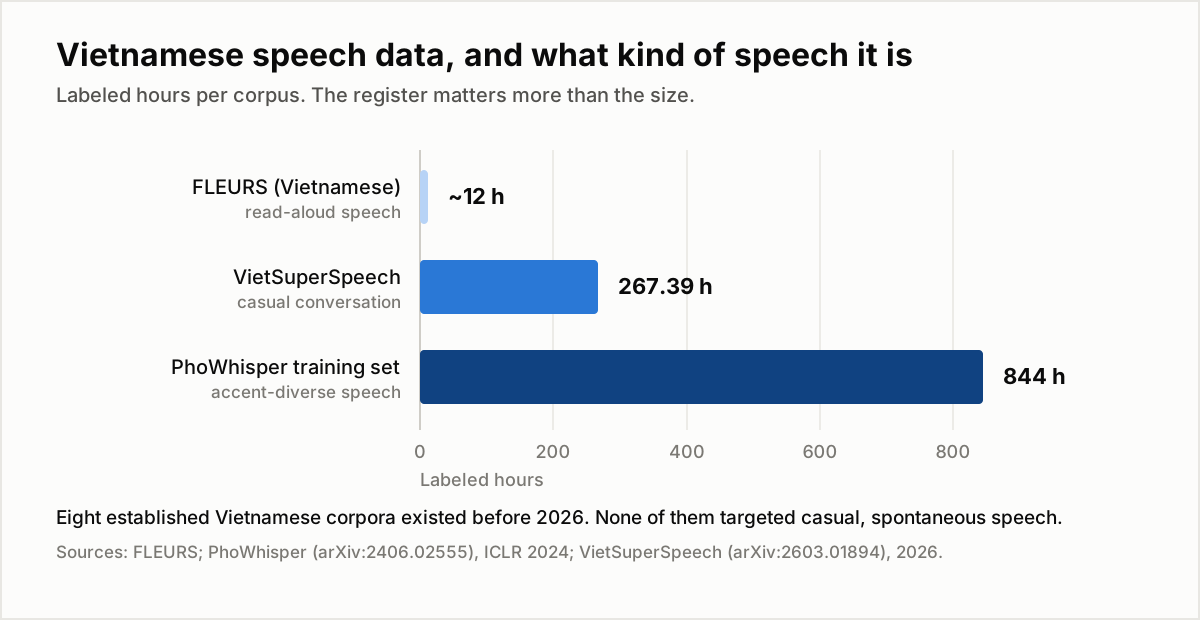
จำนวนชั่วโมงที่กำกับข้อมูลไม่ใช่เรื่องทั้งหมด ระดับภาษาต่างหากที่สำคัญ FLEURS คือเสียงอ่านออกเสียง ชุดฝึกของ PhoWhisper ครอบคลุมหลายสำเนียง ส่วน VietSuperSpeech เป็นคลังข้อมูลชุดแรกที่สร้างมาเพื่อบทสนทนาแบบไม่เป็นทางการโดยเฉพาะ แหล่งที่มาระบุวันที่ไว้ในรายการด้านล่าง
FLEURS ซึ่งเป็นเบนช์มาร์กภาษาเวียดนามที่มีการอ้างถึงบ่อย มีเสียงอ่านออกเสียงราว 12 ชั่วโมง PhoWhisper ที่นำเสนอในสาย ICLR 2024 Tiny Papers ปรับจูน Whisper ด้วยชุดข้อมูล 844 ชั่วโมงซึ่งคัดเลือกให้มีสำเนียงหลากหลาย ส่วน VietASR ซึ่งเผยแพร่เมื่อวันที่ 23 พฤษภาคม 2025 ใช้เสียงที่ไม่มีข้อมูลกำกับ 70,000 ชั่วโมงและข้อมูลที่กำกับแล้ว 50 ชั่วโมง พร้อมรายงานว่าทำได้ดีกว่า Whisper Large-v3 และระบบเชิงพาณิชย์บนข้อมูลจากโลกจริง
VietSuperSpeech ซึ่งเผยแพร่ในปี 2026 รวบรวมคู่เสียงกับข้อความ 52,023 คู่ รวม 267.39 ชั่วโมง ของบทสนทนาภาษาเวียดนามแบบไม่เป็นทางการ: 240.67 ชั่วโมงสำหรับฝึก และ 26.72 ชั่วโมงสำหรับประเมินผล ประกอบด้วยอักขระที่กำกับเครื่องหมายเสริมสัทอักษรครบถ้วน 13.8 ล้านตัว ผู้เขียนอธิบายช่องว่างที่ชุดข้อมูลนี้เข้ามาแก้ไว้ว่า:
«แม้คลังข้อมูลอย่าง VLSP2020, VIET_BUD500, VietSpeech, FLEURS, VietMed, Sub-GigaSpeech2-Vi, viVoice และ Sub-PhoAudioBook จะให้ความครอบคลุมอย่างกว้างขวางต่อภาษาทางการและเสียงอ่านออกเสียง แต่ไม่มีชุดใดเลยที่มุ่งเป้าไปยังระดับภาษาแบบไม่เป็นทางการและเกิดขึ้นเองโดยธรรมชาติ ซึ่งขาดไม่ได้สำหรับการใช้งาน AI เชิงสนทนา»
ชุดข้อมูลนี้มุ่งเก็บรูปแบบภาษาที่พบในการประชุม ได้แก่ การพูดแทรก การพูดอ้อมค้อม การใช้ชื่อผลิตภัณฑ์ภาษาอังกฤษในประโยคภาษาเวียดนาม และความคิดที่พูดค้างไว้ คะแนนจากเสียงอ่านเพียงอย่างเดียวไม่อาจยืนยันได้ว่าระบบจัดการบทสนทนาแบบนี้ได้แม่นยำเพียงใด
สำหรับทีมต่าง ๆ วิธีป้องกันในทางปฏิบัติคือมีบทถอดเสียงที่คนอ่านทบทวนและแก้ไขได้ แต่สิ่งนี้ต้องเริ่มจากฟีเจอร์การประชุมที่เลือกสามารถสร้างบทถอดเสียงภาษาเวียดนามได้ก่อน
วิธีจัดประชุมสองภาษาเวียดนาม–อังกฤษให้บันทึกการประชุมอยู่รอด
ตรวจสอบหกข้อนี้ก่อนและระหว่างการโทร:
- เมื่อจำเป็น ให้เลือกเครื่องมือแยกกันสำหรับการทำความเข้าใจและการเก็บบันทึก Google Translate หรือคำบรรยายของ Meet ช่วยให้เข้าใจภาษาเวียดนามแบบสดได้ แต่ฟีเจอร์ทั้งสองนี้ไม่ได้สร้างบทถอดเสียงภาษาเวียดนามที่เก็บไว้ตรวจทานได้ตามที่กล่าวถึงในบทความนี้
- ตั้งค่าภาษาเวียดนามเป็นภาษาพูดอย่างชัดเจน อย่าพึ่งการตรวจจับอัตโนมัติ บน DeepL นี่คือข้อบังคับ เพราะภาษาของบุคคลที่สามรวมถึงภาษาเวียดนามถูกตรวจจับอัตโนมัติไม่ได้ ส่วนในที่อื่นมันก็ยังเป็นทางเลือกที่ดีกว่าอยู่ดี เพราะการตรวจจับอัตโนมัติจะปักใจเดาภายในไม่กี่วินาทีแรก บนช่วงเสียงที่มีบริบทน้อยที่สุดของทั้งเซสชัน
- ดูรายการภาษาของฟีเจอร์บันทึก ไม่ใช่รายการภาษาของแพลตฟอร์ม กับดักที่บทความนี้มีอยู่เพื่ออธิบาย คือการเหมาว่าแพลตฟอร์มที่แปลภาษาเวียดนามได้ย่อมถอดเสียงภาษาเวียดนามได้ด้วย ใน Google Meet ตัวเลข 69 เทียบกับ 8 คือช่องว่างระหว่างข้อสมมติสองข้อนั้น
- ตั้งชื่อปัญหาการสลับภาษาให้ชัดก่อนเริ่มประชุม ถ้าทีมของคุณชอบแทรกชื่อผลิตภัณฑ์ภาษาอังกฤษ รหัสตั๋วงาน และตัวย่อลงในประโยคภาษาเวียดนาม ซึ่งทีมวิศวกรรมออฟชอร์ทุกทีมทำแบบนั้น ให้ตรวจสอบว่าเครื่องมือบันทึกของคุณรับได้กับสองภาษาในเซสชันเดียว ผู้ช่วยจดบันทึกของ Meet ระบุชัดว่ารับไม่ได้
- แก้คำนามเฉพาะภายในห้านาทีแรก แบบสด เครื่องหมายเสริมสัทอักษรของภาษาเวียดนามและชื่อรหัสผลิตภัณฑ์ภาษาอังกฤษคือสองจุดที่การถอดเสียงพังอย่างสม่ำเสมอ และเป็นสองจุดเดียวกันที่บรรทัดผิดหนึ่งบรรทัดสร้างความเสียหายมากที่สุดต่อบทสรุปทุกฉบับที่สร้างต่อยอดจากมัน การแก้ระหว่างประชุมใช้เวลาแค่ไม่กี่วินาที
- เก็บต้นฉบับภาษาเวียดนาม คำแปลภาษาอังกฤษ และบทสรุปไว้ในบันทึกเดียวกัน ไม่ใช่สามไฟล์ในสามเครื่องมือ การแปลเป็นทางเดียว ปีหน้าคุณแปลใหม่จากภาษาเวียดนามด้วยโมเดลที่ดีกว่าได้ แต่คุณกู้ภาษาเวียดนามคืนจากภาษาอังกฤษไม่ได้เลย
หากต้องการดูวิธีใช้ผลิตภัณฑ์ โปรดอ่านคู่มือเดือนมิถุนายนเรื่องการเปลี่ยนไฟล์บันทึกการประชุมสองภาษาให้เป็นโน้ต AI ที่ตรวจทานได้
บทสรุป ภาษาเวียดนามข้ามช่องว่างด้านความเข้าใจไปแล้ว แต่ยังไม่ข้ามช่องว่างด้านบันทึกการประชุม
การรองรับภาษาเวียดนามขยายไปสู่คำบรรยายสด เสียงล่าม และการรู้จำเสียงพูด ทำให้ทีมมีทางเลือกในการติดตามบทสนทนามากขึ้น แต่การประกาศรองรับภาษาไม่ได้แปลว่าบัญชีของคุณจะใช้ได้แล้ว การขยาย Gemini 3.5 Live Translate ใน Meet ยังเป็นตัวอย่างทดลองและทยอยเปิดให้ใช้ ไม่ใช่การแทนที่คู่ภาษาที่รองรับอยู่ในทุกบัญชี โปรดตรวจสอบฟีเจอร์ บัญชี และทิศทางภาษาเวียดนามที่ต้องใช้ก่อนประชุม
สิ่งที่ยังไม่ขยับคือการบันทึก ฟีเจอร์สองตัวของ Google ที่ผลิตหลักฐานเก็บได้ถาวรรองรับรวมกันแปดภาษา เป็นแปดภาษาชุดเดิม และไม่มีภาษาเวียดนามอยู่ในทั้งสองตัว ส่วน DeepL ใส่คำบรรยายเป็นภาษาเวียดนามให้ แต่ส่งงานถอดเสียงภาษานี้ต่อให้ผู้รับเหมาช่วงที่ซ่อนอยู่หลังสวิตช์ของผู้ดูแลระบบ ตลาดได้ตัดสินไปแล้วว่าภาษาเวียดนามคือภาษาที่ควรค่าแก่การได้ยิน แต่ยังไม่ใช่ภาษาที่ควรค่าแก่การจดบันทึก
ดังนั้นคำถามที่ควรถามผู้ให้บริการจึงไม่ใช่ว่าพวกเขารองรับภาษาเวียดนามหรือไม่ ตอนนี้แทบทุกรายตอบว่ารองรับ และแทบทุกรายหมายถึงครึ่งที่เป็นการฟังเท่านั้น คำถามที่ควรถามคือ ฟีเจอร์ตัวไหนของคุณที่รองรับภาษาเวียดนามหลังจากสายจบลงแล้ว และคุณเปิดรายการภาษาของฟีเจอร์ตัวนั้นให้ผมดูได้ไหม
Telli.sh อยู่ตรงไหน ชั้นการบันทึกคือชั้นที่เราสร้างขึ้นมา Telli.sh ถอดเสียงการประชุมด้วยภาษาที่ถูกพูดออกมาจริง แปลเป็นภาษาปลายทาง 44 ภาษารวมถึงภาษาเวียดนาม และเก็บหลักฐานทั้งสามชิ้นไว้ในโน้ตเดียวกัน ได้แก่ ต้นฉบับภาษาเวียดนาม คำแปลที่จัดเรียงตรงกับต้นฉบับ และบทสรุปที่สร้างต่อยอดขึ้นมา ตัวอินเทอร์เฟซเองมีให้ใช้ 15 ภาษา รวมถึงภาษาเวียดนาม ทีมในดานังกับลูกค้าในซิดนีย์จึงอ่านการประชุมเดียวกันในภาษาของตัวเองได้ โดยยังใช้บันทึกชุดเดียวกันที่แก้ไขได้ร่วมกัน
เริ่มสร้างโน้ตการประชุมพร้อมคำแปลแบบสด
แหล่งอ้างอิง
- Google Translate Help, "Hear live speech to speech translations with Live translate" (Android), เข้าถึงเมื่อ 31 สิงหาคม 2026 — รายชื่อ 74 ภาษาที่รวมภาษาเวียดนาม โหมดการแปลทั้งสี่ โหมดพูดคุยแบบเห็นหน้า และการทำงานต่อเนื่องเบื้องหลัง
- Google Translate Help, "Download languages to use offline" (Android), เข้าถึงเมื่อ 31 สิงหาคม 2026 — แพ็กภาษาออฟไลน์และการอัปเกรดเป็นเวอร์ชันคุณภาพสูงกว่า
- Google Meet Help, "Use translated captions in Google Meet", เข้าถึงเมื่อ 31 สิงหาคม 2026 — รายชื่อ 69 ภาษาที่รวมภาษาเวียดนาม รุ่น Workspace แบบเสียเงิน และ Record captions
- Google Meet Help, "Use Transcripts with Google Meet", เข้าถึงเมื่อ 31 สิงหาคม 2026 — แปดภาษาที่รองรับการถอดเสียง
- Google Meet Help, "'Take notes for me' in Google Meet", เข้าถึงเมื่อ 31 สิงหาคม 2026 — แปดภาษาชุดเดียวกัน และข้อจำกัดเรื่องครั้งละหนึ่งภาษา
- Slator, "Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate", 16 มิถุนายน 2026 — การประกาศเมื่อวันที่ 9 มิถุนายน, 70+ ภาษา, Meet ที่ขยับจากห้าภาษาไปเป็นคู่ภาษา 2,000+ คู่ และโหมดการฟัง
- DeepL Help Center, "DeepL Voice languages", เข้าถึงเมื่อ 31 สิงหาคม 2026 — 18 ภาษาพูดที่ DeepL ถอดเสียงเอง, 20 ภาษาพูดจากผู้ให้บริการภายนอกซึ่งรวมภาษาเวียดนาม, 41 ภาษาแปล, ข้อจำกัดของการตรวจจับอัตโนมัติ และข้อตกลงไม่เก็บรักษาข้อมูลของ Speechmatics
- Samsung Newsroom, "The Learning Curve, Part 3: Taking AI Data From Good to Great", 23 พฤษภาคม 2024 — ภาษาเวียดนามในกลุ่ม 16 ภาษาแรกของ Galaxy AI, วรรณยุกต์หกเสียง, ตัวอย่าง ma/mả/má และคำอธิบายเรื่องเฟรมเสียงราว 20 ms
- Deepgram, Models & Languages Overview, เข้าถึงเมื่อ 31 สิงหาคม 2026 — ภาษาเวียดนาม (
vi) ในรายชื่อภาษาของ Nova-3 - Le, Nguyen และ Nguyen, "PhoWhisper: Automatic Speech Recognition for Vietnamese", ICLR 2024 Tiny Papers — ชุดข้อมูลปรับจูน 844 ชั่วโมงที่หลากหลายด้านสำเนียง
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining", 23 พฤษภาคม 2025 — เสียงที่ไม่มีการกำกับข้อมูล 70,000 ชั่วโมง และข้อมูลที่กำกับแล้ว 50 ชั่วโมง
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset", 2026 — 52,023 คู่ข้อมูล, 267.39 ชั่วโมง และช่องว่างด้านระดับภาษาของคลังข้อมูลทั้งแปดชุด