ล่ามแปลต่อเนื่องทำให้การประชุมยาวขึ้นเท่าตัว ส่วนการแปลแบบเรียลไทม์ก็ไม่จดอะไรทิ้งไว้เลย: ทางเลือกของการแปลในการประชุมสำหรับทีมไทยปี 2026
บริการแปลการประชุมในกรุงเทพฯ ประกาศราคาแปลต่อเนื่องเริ่มต้น 3,000 บาทต่อชั่วโมง และแปลพร้อมเริ่มต้น 5,000 บาท ขณะที่การประชุมแปลต่อเนื่องทำให้เวลาประชุมยาวขึ้นราวเท่าตัว ด้าน Live translate ของ Google Translate รองรับ 74 ภาษารวมถึงภาษาไทย และคำบรรยายแปลของ Google Meet รองรับ 69 ภาษารวมถึงภาษาไทย แต่ฟีเจอร์ Transcripts และผู้ช่วยจดบันทึก Gemini ของ Meet รองรับเพียง 8 ภาษาเท่ากันทั้งคู่ และไม่มีภาษาไทย ส่วน Nova-3 ของ Deepgram ถอดเสียงภาษาไทยได้ในโค้ด th และ th-TH แต่ไม่รวมภาษาไทยไว้ในโหมดสลับภาษา 10 ภาษา ซึ่งคือประโยคไทยปนอังกฤษที่ประชุมของคุณประกอบขึ้นมาพอดี บทวิเคราะห์ทางเลือกทั้งหมดของการแปลในการประชุมสำหรับทีมไทย
จองล่ามแปลต่อเนื่องผ่านเอเจนซีในกรุงเทพฯ แล้วดูราคาที่ประกาศไว้ จะเริ่มต้นที่ 3,000 บาทต่อชั่วโมง ส่วนแปลพร้อมเริ่มต้นที่ 5,000 บาท ตัวเลขทั้งสองเป็นเรตที่ Sawadee Translations เผยแพร่เอง ดึงข้อมูลวันที่ 1 กันยายน 2026 แต่ค่าชั่วโมงไม่ใช่ส่วนที่แพงที่สุด
ส่วนที่แพงที่สุดคือเวลา ในการแปลต่อเนื่อง ผู้พูดจะพูดไปหนึ่งช่วง ซึ่งบทความอธิบายของ Acolad วันที่ 24 เมษายน 2026 ระบุว่าโดยทั่วไปยาวหนึ่งถึงห้านาที แล้วหยุด จากนั้นล่ามจึงพูดเนื้อหาเดิมซ้ำอีกครั้งในอีกภาษาหนึ่ง Acolad เขียนไว้ตรง ๆ ว่า "การประชุมแบบแปลต่อเนื่องจะใช้เวลาเพิ่มขึ้นราวเท่าตัว เพราะทุกประโยคถูกพูดสองรอบ" การรีวิวผลงานรายไตรมาสที่วางไว้ 90 นาทีจึงกลายเป็นสามชั่วโมง และคุณจ่ายค่าล่ามครบทั้งสามชั่วโมงนั้น
ในเวลาเดียวกัน Google ก็ทำงานคล้าย ๆ กันนี้ได้บนมือถือของเพื่อนร่วมทีมคนไทย ฟรี และใช้ได้ตั้งแต่ตอนนี้
สรุปสั้น
- ภาษาไทยผ่านทุกบททดสอบที่เกี่ยวกับการฟัง และตกทุกบททดสอบที่เกี่ยวกับการเขียน Live translate ของ Google Translate ระบุ 74 ภาษารวมถึงภาษาไทย คำบรรยายแปลของ Google Meet ระบุ 69 ภาษารวมถึงภาษาไทย แต่ Transcripts ของ Google Meet และผู้ช่วยจดบันทึก "Take notes for me" ระบุอย่างละ 8 ภาษา เป็นชุดเดียวกันทั้งคู่ และไม่มีภาษาไทยอยู่ในทั้งสองรายการ
- ประโยคไทยปนอังกฤษคือจุดพังที่เฉพาะเจาะจง Nova-3 ของ Deepgram ถอดเสียงภาษาไทยได้ในโค้ด
thและth-THแต่โหมดสลับภาษาmultiครอบคลุมพอดี 10 ภาษา และไม่มีภาษาไทย ส่วนผู้ช่วยจดบันทึกของ Meet ระบุตรง ๆ ว่ารองรับ "ครั้งละหนึ่งภาษา" - ล่ามมนุษย์ยังเป็นคำตอบที่ถูกต้องสำหรับบางห้องประชุม และบทความนี้บอกว่าห้องไหน พร้อมให้ขั้นตอนเจ็ดข้อสำหรับจัดประชุมไทย–อังกฤษให้เหลือบันทึกไว้จริง และวางเรตค่าล่ามภาษาไทยที่ประกาศจริงคู่กับค่าความผิดพลาดของการถอดเสียงภาษาไทยที่เผยแพร่จริง
บทความนี้เป็นตอนของประเทศไทยในซีรีส์เดียวกัน เราทำบัญชีชุดเดียวกันนี้ให้เวียดนามไปเมื่อวานและเจอรูปแบบที่แทบเหมือนกัน — Google แปลการประชุมภาษาเวียดนามให้คุณแบบเรียลไทม์ได้ แต่ไม่ถอดเสียงการประชุมให้แม้แต่คำเดียว — ส่วนเวอร์ชันทั่วไปของข้อโต้แย้งนี้อยู่ใน สิ่งที่เกิดขึ้นเมื่อคำแปลยอดเยี่ยมแต่หายไปก่อนมื้อเย็น ประเทศไทยต่างออกไปในจุดสำคัญหนึ่งจุด และจุดนั้นคือหัวข้อเรื่องการสลับภาษาด้านล่าง
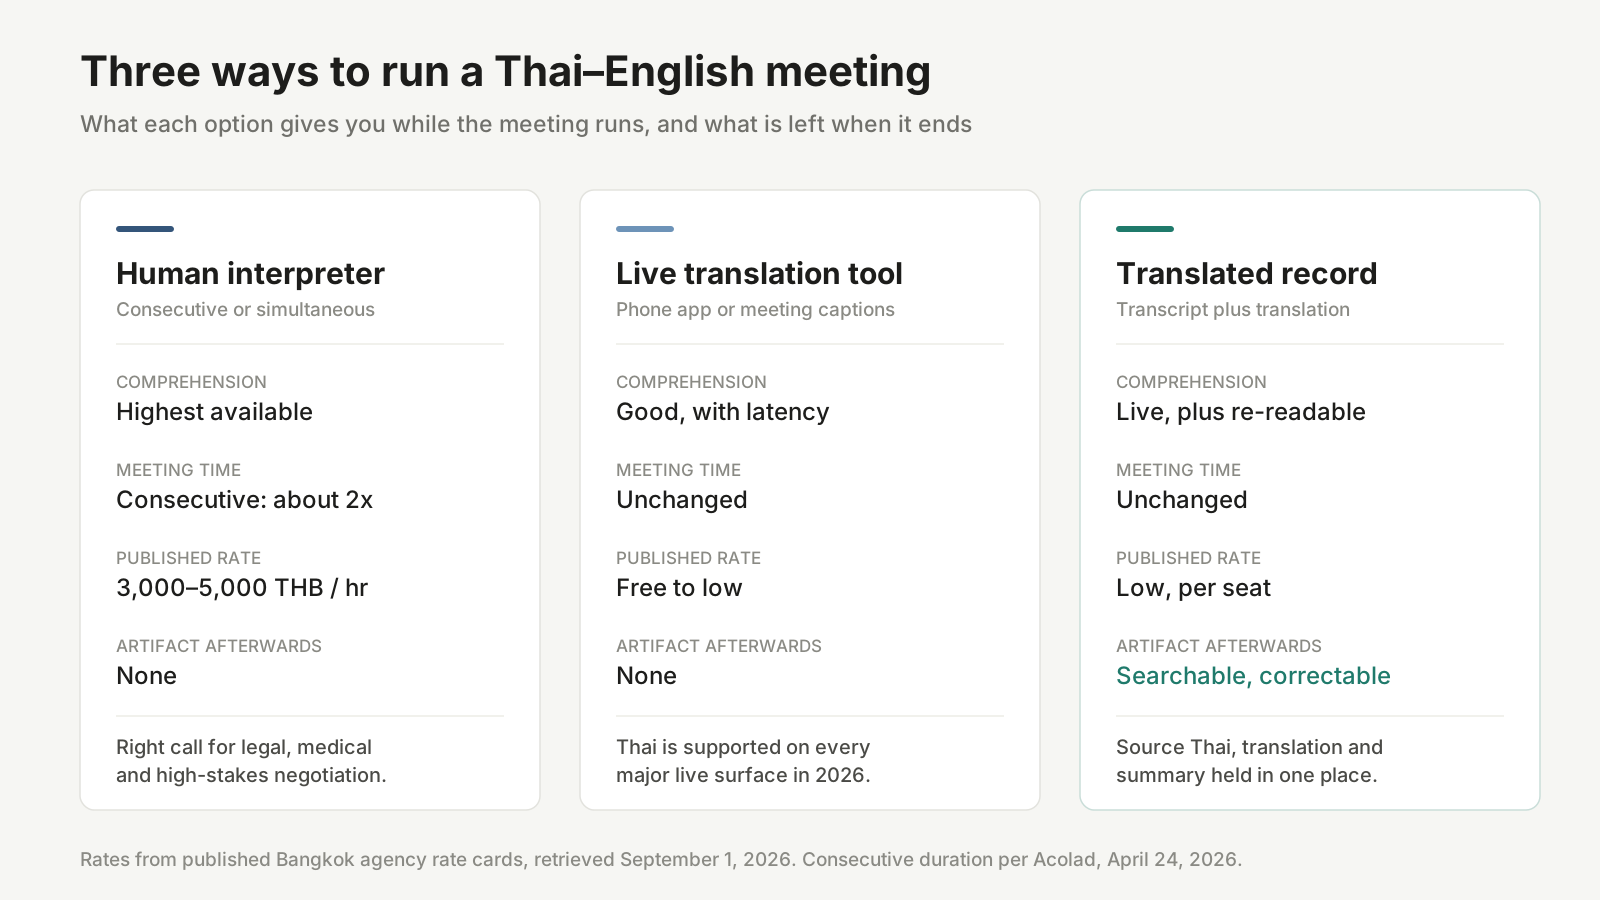
สามทางเลือกวางเรียงกัน ราคามาจากเรตการ์ดของเอเจนซีในกรุงเทพฯ ที่เผยแพร่ต่อสาธารณะ ดึงข้อมูลวันที่ 1 กันยายน 2026
แปลต่อเนื่องกับแปลพร้อมเป็นคนละบริการกัน และคนไทยค้นหาแบบแรกมากกว่า
เริ่มจากคำศัพท์ก่อน เพราะข้อมูลการค้นหาภาษาไทยชัดเจนกว่าที่คิดมาก คนในประเทศไทยไม่ได้พิมพ์คำว่า "แปลภาษา" ลงกูเกิลเวลาต้องจัดการเรื่องภาษาในห้องประชุม แต่พิมพ์ว่า การประชุมแปลต่อเนื่อง ซึ่งเป็นการขอโหมดการทำงานเฉพาะทางของวิชาชีพล่าม ไม่ใช่ความปรารถนากว้าง ๆ
การแปลต่อเนื่อง หมายความว่าล่ามรอ ผู้พูดพูดจบหนึ่งช่วง หยุด แล้วล่ามจึงถ่ายทอด ตาม Acolad โหมดนี้ไม่ต้องใช้ตู้ล่าม ไม่ต้องใช้เครื่องรับ ไม่ต้องใช้เครื่องส่ง อุปกรณ์ทั้งหมดที่ต้องมีคือสมุดจดหนึ่งเล่ม นั่นทำให้มันเป็นค่าตั้งต้นของการประชุมทวิภาคี การสืบพยานทางกฎหมาย การพบแพทย์ การเยี่ยมชมไซต์งาน และการเดินตรวจโรงงาน Sawadee Translations ระบุว่ากระบวนพิจารณาทางกฎหมายและการนัดหมายที่สถานทูตส่วนใหญ่ใช้การแปลต่อเนื่อง "เพราะความแม่นยำสำคัญกว่าความเร็ว และรูปแบบนี้เปิดช่องให้หยุดพักได้"
การแปลพร้อม หมายความว่าล่ามไม่รอ คำแปลถูกส่งออกขณะที่ผู้พูดยังพูดอยู่ โดยหน่วงหลังไม่กี่วินาที ราคาแพงกว่าด้วยเหตุผลเชิงโครงสร้าง รายการอุปกรณ์ของ Elite Asia ระบุว่าชุดมาตรฐานประกอบด้วยตู้ล่ามเก็บเสียง เครื่องรับพกพา หูฟัง หน่วยควบคุมกลาง เครื่องส่งสัญญาณหลายช่อง และโต๊ะล่ามพร้อมไมโครโฟน อีกทั้งล่ามแปลพร้อมมักทำงานเป็นคู่ สลับกันทุก 20 ถึง 30 นาที เพราะภาระทางความคิดไม่เอื้อให้ทำคนเดียวตลอดงาน
ประเด็นที่บทความเปรียบเทียบส่วนใหญ่มองข้ามคือ ส่วนต่างราคาระหว่างสองโหมดไม่ใช่ส่วนต่างต้นทุนที่แท้จริง แปลต่อเนื่องถูกกว่าเมื่อคิดต่อชั่วโมง และแพงกว่าเมื่อคิดต่อการประชุมหนึ่งครั้ง เพราะมันกินทรัพยากรอย่างเดียวที่ไม่มีใครตั้งราคาไว้ นั่นคือปฏิทินของทุกคน เราขอเรียกมันว่า ชั่วโมงที่ถูกแปล คือวาระการประชุม 60 นาทีที่กินเวลาในวันของทุกคนไป 120 นาที
บริการแปลการประชุมในไทยราคาเท่าไหร่ ดูจากเรตการ์ดที่เปิดเผยจริง
เรตการ์ดค่าล่ามภาษาไทยเปิดเผยต่อสาธารณะจริง ซึ่งหายากกว่าที่ควรจะเป็น ผู้ให้บริการในกรุงเทพฯ สองรายประกาศตัวเลขที่เราอ้างอิงตรง ๆ ได้
| ผู้ให้บริการ | โหมด | ราคาเริ่มต้นที่ประกาศ | หน่วย |
|---|---|---|---|
| Sawadee Translations | แปลต่อเนื่อง | เริ่มต้น 3,000 บาท | ต่อชั่วโมง |
| Sawadee Translations | แปลพร้อม | เริ่มต้น 5,000 บาท | ต่อชั่วโมง |
| Y LINK (Personnel Consultant) | แปลต่อเนื่อง แบบออนไลน์ | เริ่มต้น 2,000 บาท | ต่อ 60 นาที |
| Y LINK (Personnel Consultant) | แปลพร้อม แบบออนไลน์ | เริ่มต้น 3,000 บาท | ต่อ 60 นาที |
| Y LINK (Personnel Consultant) | ประชุม/เจรจาธุรกิจ ณ สถานที่ ระดับ A | เริ่มต้น 6,000 บาท | ครึ่งวัน (4 ชม.) |
| Y LINK (Personnel Consultant) | ประชุม/เจรจาธุรกิจ ณ สถานที่ ระดับ A | เริ่มต้น 9,600 บาท | เต็มวัน (8 ชม.) |
| Y LINK (Personnel Consultant) | แปลพร้อมหรือแปลกระซิบ ณ สถานที่ ระดับ A | เริ่มต้น 14,400 บาท | ครึ่งวัน (4 ชม.) |
| Y LINK (Personnel Consultant) | แปลพร้อมหรือแปลกระซิบ ณ สถานที่ ระดับ A | เริ่มต้น 21,600 บาท | เต็มวัน (8 ชม.) |
เรตการ์ดทั้งสองชุดดึงข้อมูลวันที่ 1 กันยายน 2026 หน้าบริการจัดส่งล่ามญี่ปุ่น–ไทย–อังกฤษของ Y LINK ยังระบุด้วยว่าการแปลระหว่างภาษาญี่ปุ่น ไทย และอังกฤษ "เริ่มต้นที่ 14,400 บาทต่อวัน"
อ่านตัวเล็กให้ครบ เพราะตรงนั้นคือจุดที่ชั่วโมงที่ถูกแปลกลายเป็นเงินจริง Y LINK นิยามครึ่งวันว่าสี่ชั่วโมงที่ "ไม่คร่อมเวลา 12:00" และเต็มวันว่าแปดชั่วโมงโดยไม่นับเวลาพักกลางวันของล่ามอีกหนึ่งชั่วโมง ค่าล่วงเวลาคำนวณตามกฎหมายแรงงานไทย คือเอาค่าจ้างรายวันตามสัญญาหารด้วย 8 แล้วคูณ 1.5 คิดเป็นช่วงละ 15 นาที และบันไดค่ายกเลิกก็ชันมาก คือ 100 เปอร์เซ็นต์ของค่าบริการหากยกเลิกภายใน 2 วันทำการ 80 เปอร์เซ็นต์ที่ 3–7 วัน 50 เปอร์เซ็นต์ที่ 8–14 วัน และ 20 เปอร์เซ็นต์ที่ 15–30 วัน
ดังนั้นการประชุมที่ลากยาวเกินไป 90 นาทีเพราะการแปลต่อเนื่องทำให้เวลาเป็นสองเท่า จึงไม่ได้ทำให้คุณเสียแค่ 90 นาที แต่เสียค่าล่วงเวลา 1.5 เท่าของเรตรายชั่วโมงที่ถัวเฉลี่ยแล้ว บวกกับวันที่คุณซื้อไว้อยู่แล้ว บวกกับต้นทุนปลายทางที่ทุกคนในห้องนั้นเสียเวลาไปทั้งบ่าย
ทั้งหมดนี้ไม่ได้แปลว่าล่ามไม่คุ้ม แต่แปลว่าล่ามคือการซื้อที่ต้องคิด ซึ่งเป็นมุมที่บทความนี้ใช้มองล่ามตลอดทั้งเรื่อง
ตอนนี้เครื่องมือฟรีทุกตัวพูดไทยได้ และดีกว่าชื่อเสียงที่มันมี
อีกครึ่งหนึ่งของตลาดสมควรได้รับการพิจารณาอย่างเป็นธรรม เพราะการรองรับภาษาไทยในงานแปลแบบเรียลไทม์เปลี่ยนจากกระท่อนกระแท่นมาเป็นครอบคลุมเร็วกว่าที่ทีมส่วนใหญ่ทันสังเกต
Live translate ของ Google Translate ระบุ 74 ภาษา และมีภาษาไทยอยู่ด้วย ใช้งานได้ทั้งแบบมีและไม่มีหูฟังบน Android และ iOS มีโหมด Listening, Conversation, Text only และ Custom รวมถึงโหมด Face to face ที่แบ่งครึ่งหน้าจอให้แต่ละฝ่ายอ่านฝั่งของตัวเอง โดยไมโครโฟนตรวจจับเองว่ากำลังพูดภาษาไหน เอกสารของ Google ระบุว่าการแปล "ทำงานต่อเนื่องเมื่อคุณสลับแอป ย่อแอป หรือเมื่อหน้าจอล็อก" ภาษาไทยยังดาวน์โหลดไว้ใช้แบบออฟไลน์ได้ ซึ่งสำคัญมากสำหรับการลงพื้นที่ที่ระยองหรือการตรวจโรงงานซัพพลายเออร์ที่สัญญาณไม่ใช่สิ่งที่การันตีได้
คำบรรยายแปลของ Google Meet ครอบคลุม 69 ภาษา รวมถึงภาษาไทย ฟีเจอร์นี้อยู่ในแพ็กเกจแบบเสียเงิน ได้แก่ Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter (ใช้ได้ถึง 30 มิถุนายน 2025) และ Google AI Pro for Education
Live translate และ Interpreter ของ Samsung รองรับภาษาไทยบนเครื่อง Galaxy โดยเป็นหนึ่งใน 20 ภาษาหลักที่ระบุอยู่ในหน้าสนับสนุนของ Samsung เคียงข้างภาษาเวียดนาม อินโดนีเซีย และฮินดี หน้าเดียวกันนั้นมีข้อควรระวังที่ควรอ่านสองรอบ ว่า "ควรมีเพียงคนเดียวที่ใช้ Live Translate ในแต่ละครั้ง มิฉะนั้นจะเกิดข้อผิดพลาดในการแปล หากภาษาที่เลือกไว้ไม่ตรงกับภาษาที่กำลังพูด บทสนทนาอาจถูกแปลผิด"
Nova-3 ของ Deepgram ซึ่งเป็นชั้นเอนจินที่อยู่ใต้เครื่องมือประชุมจำนวนมาก ระบุภาษาไทยไว้ในโค้ด th และ th-TH เมื่อนับโค้ดภาษาหลักที่ไม่ซ้ำกันในเอกสาร Models & Languages Overview ของ Deepgram วันที่ 1 กันยายน 2026 จะได้ 58 ภาษา และภาษาไทยอยู่ในนั้นทั้งในตาราง Nova-3 และตาราง Nova-2 รุ่นเก่า
นั่นคือชั้นการแปลแบบเรียลไทม์สำหรับภาษาไทยที่มีอยู่จริง มีเงินลงทุนจริง และทำงานได้จริง ถ้าโจทย์ของคุณคือการคุยกับซัพพลายเออร์ที่หน้าไลน์ผลิต มันแทบแก้จบแล้วและไม่มีค่าใช้จ่าย ความเห็นตรง ๆ ของเราคือ ถ้าต้องการแค่ความเข้าใจในบทสนทนาสองคน ให้ใช้เครื่องมือฟรีและข้ามใบแจ้งหนี้ไป
ภาษาไทยผ่านทุกรายการที่ฟัง และตกทุกรายการที่เขียน
ทีนี้มาถึงความไม่สมมาตร ซึ่งเป็นเหตุผลที่บทความนี้มีอยู่
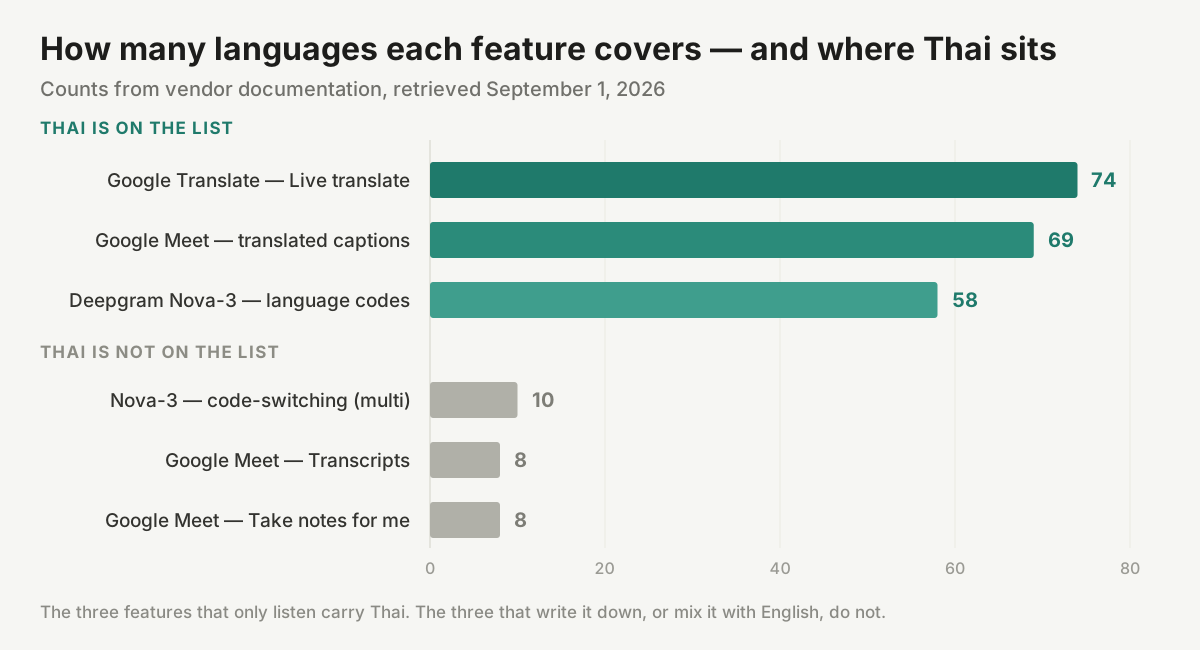
จำนวนภาษามาจากเอกสารของผู้ให้บริการ ดึงข้อมูลวันที่ 1 กันยายน 2026 ฟีเจอร์ที่ทำหน้าที่ฟังอย่างเดียวรองรับภาษาไทย ส่วนฟีเจอร์ที่ต้องเขียนหรือต้องผสมไทยกับอังกฤษไม่รองรับ
ฟีเจอร์ Transcripts ของ Google Meet ซึ่งเป็นตัวที่สร้าง Google Doc ที่อยู่ถาวร รองรับพอดี 8 ภาษา ได้แก่ อังกฤษ ฝรั่งเศส เยอรมัน อิตาลี ญี่ปุ่น เกาหลี โปรตุเกส และสเปน ส่วน "Take notes for me" ของ Google Meet ซึ่งเป็นผู้ช่วยจดบันทึก Gemini ที่บันทึกลง Google Docs และส่งสรุปทางอีเมลให้ผู้จัดประชุม รองรับ 8 ภาษาชุดเดียวกันเป๊ะ ภาษาไทยไม่อยู่ในทั้งสองรายการ นับเป็นสองครั้ง
| ฟีเจอร์ | รองรับภาษาไทยไหม | จำนวนภาษา | เหลืออะไรไว้หลังจบประชุมไหม |
|---|---|---|---|
| Google Translate — Live translate | รองรับ | 74 | ไม่เหลือ |
| Google Meet — คำบรรยายแปล | รองรับ | 69 | เห็นบนจอเท่านั้น หรือฝังลงไฟล์วิดีโอถ้าบันทึกคำบรรยาย |
| Deepgram Nova-3 — การถอดเสียง | รองรับ (th, th-TH) | 58 โค้ดหลัก | เหลือ ถ้าผลิตภัณฑ์ที่สร้างบนมันเก็บไว้ |
Deepgram Nova-3 — โหมดสลับภาษา multi | ไม่รองรับ | 10 | ไม่เกี่ยวข้อง |
| Google Meet — Transcripts | ไม่รองรับ | 8 | เหลือ เป็น Google Doc |
| Google Meet — "Take notes for me" | ไม่รองรับ | 8 ครั้งละหนึ่งภาษา | เหลือ เป็นบันทึกใน Docs และอีเมลสรุป |
ทุกแถวมาจากเอกสารของผู้ให้บริการ ดึงข้อมูลวันที่ 1 กันยายน 2026
คำบรรยายแปลของ Meet มีเส้นทางเก็บถาวรอยู่จริง และควรพูดถึง คือถ้าคุณบันทึกการประชุมและเลือก Record captions คำบรรยายจะถูกฝังลงในไฟล์วิดีโอ แต่คำบรรยายที่ฝังอยู่ในภาพไม่ใช่บันทึกในความหมายที่ใช้งานได้จริง คุณค้นหาในพิกเซลไม่ได้ แก้ชื่อซัพพลายเออร์ที่ถอดผิดไม่ได้ และสร้างสรุปจากมันไม่ได้ มันคือรูปถ่ายของบันทึกการประชุม ไม่ใช่บันทึกการประชุม
ประโยคไทยปนอังกฤษคือจุดที่เครื่องมือพังจริง ๆ
นี่คือส่วนที่ทำให้ประเทศไทยต่างจากกรณีเวียดนาม และควรพูดให้ตรงเท่าที่เอกสารเขาเขียนไว้
โหมดสลับภาษา multi ของ Deepgram ซึ่งเป็นการตั้งค่าที่ยอมให้เสียงสายเดียวมีสองภาษาอยู่ในประโยคเดียวกัน ครอบคลุมพอดี 10 ภาษา ได้แก่ อังกฤษ สเปน ฝรั่งเศส เยอรมัน ฮินดี รัสเซีย โปรตุเกส ญี่ปุ่น อิตาลี และดัตช์ ภาษาไทยไม่อยู่ในนั้น ทั้งที่ภาษาไทยได้รับการรองรับเต็มรูปแบบในฐานะภาษาเดี่ยว แปลว่า Nova-3 ถอดเสียงประชุมภาษาไทยได้ ถอดเสียงประชุมภาษาอังกฤษได้ แต่ไม่ได้ถูกออกแบบมาให้ถอดประโยคที่หัวหน้าฝ่ายปฏิบัติการพูดว่า "เลื่อน shipment ไปวันที่ 15 เพราะ QC report ขึ้น batch issue"
ประโยคแบบนั้นไม่ใช่กรณียกเว้นในประเทศไทย มันคือประโยคค่ากลางของออฟฟิศไทยที่มีบริษัทแม่เป็นต่างชาติ
ผู้ช่วยจดบันทึกของ Google บันทึกข้อจำกัดเดียวกันไว้ด้วยภาษาที่ตรงกว่า หน้าช่วยเหลือระบุว่าฟีเจอร์นี้รองรับ "ครั้งละหนึ่งภาษา" และ "ยังไม่รองรับกรณีที่มีการพูดหลายภาษาในการประชุมเดียวกัน" การประชุมกรุงเทพฯ–โตเกียวที่สลับไปมาระหว่างไทยกับอังกฤษจึงถูกตัดสิทธิ์สองชั้น ชั้นแรกเพราะภาษาไทยไม่อยู่ใน 8 ภาษา ชั้นที่สองเพราะการสลับภาษาไม่ได้รับการรองรับ แม้จะสลับระหว่างภาษาที่อยู่ในรายการก็ตาม
DeepL เพิ่มรูปแบบที่สามของปัญหาเดียวกัน DeepL Voice แยกการรองรับภาษาออกเป็นสองรายการ คือ ภาษาพูด ซึ่งคือสิ่งที่ตัวรู้จำเสียงรับได้ กับ ภาษาแปล ซึ่งคือสิ่งที่คำบรรยายแสดงผลได้ โมเดลของ DeepL เองถอดเสียงได้ 18 ภาษา และไม่มีภาษาไทย ภาษาไทยอยู่ในชั้นที่สอง คือ 20 ภาษาที่ถอดเสียงโดยผู้ให้บริการภายนอกชื่อ Speechmatics โดยมีเงื่อนไขพ่วงมาสามข้อ ทั้งหมดระบุอยู่ในหน้าช่วยเหลือของ DeepL ดึงข้อมูลวันที่ 1 กันยายน 2026
- ผู้ดูแลระบบของทีมต้องเปิดการประมวลผลข้อมูลผ่านซอฟต์แวร์ภายนอก ในบัญชีผู้ดูแลขององค์กรก่อน ไม่เช่นนั้นภาษาเหล่านี้จะใช้ไม่ได้เลย
- การตรวจจับภาษาอัตโนมัติใช้ไม่ได้ ตามถ้อยคำของ DeepL เอง "ภาษาจากผู้ให้บริการภายนอกใช้กับ Auto-detect language ไม่ได้ ต้องเลือกเป็น Spoken language ด้วยตนเอง"
- หากต้องการให้ผู้เข้าร่วมเลือกภาษาพูดของตัวเองได้ ผู้จัดประชุมต้องเปิดรหัสเข้าใช้งาน ตอนเชื่อมการประชุมเข้ากับ DeepL Voice
DeepL พูดถึงข้อตกลงนี้อย่างตรงไปตรงมา คือ Speechmatics ทำงานภายใต้ข้อตกลงไม่เก็บข้อมูล ข้อมูลการถอดเสียงจะถูกลบออกจากเซิร์ฟเวอร์ทันทีที่ประมวลผลเสร็จ และเงื่อนไขทั้งสามข้อก็ไม่ได้ไร้เหตุผลเมื่อดูทีละข้อ แต่พอวางซ้อนกันแล้วมันให้ผลลัพธ์ที่เฉพาะเจาะจงมาก คือคนไทยที่เข้าประชุมซึ่งติดตั้ง DeepL ไว้ อยู่ห่างจากการไม่ถูกถอดเสียงเลยแค่การตั้งค่าหนึ่งช่องที่ผู้ดูแลระบบยังไม่ได้ติ๊ก และไม่สามารถหวังให้ระบบสังเกตเห็นเขาเองได้
ไม่มีใครประกาศค่าความแม่นยำของการถอดเสียงประชุมภาษาไทย แต่ห้องแล็บไทยแห่งหนึ่งประกาศตัวเลขดิบไว้
เราไปตามหาค่าความผิดพลาดระดับคำสำหรับเสียงประชุมภาษาไทยที่ผู้ให้บริการเผยแพร่เอง ปรากฏว่าไม่มี สิ่งที่มีแทนกลับดีกว่า เพราะมันวัดจากเสียงธุรกิจภาษาไทยของจริง ไม่ใช่จากคนอ่านสคริปต์
ทีมวิจัย AI ของ Amity เผยแพร่ไวต์เปเปอร์เมื่อวันที่ 14 สิงหาคม 2025 บันทึกการปรับจูนโมเดลถอดเสียงภาษาไทยบนชุดข้อมูลภายในสองชุด คือชุดคอนแทกต์เซ็นเตอร์ 615 เซกเมนต์ และชุดประกันภัย 422 เซกเมนต์ แล้ววัดผลสี่ระบบบนทั้งสองชุด
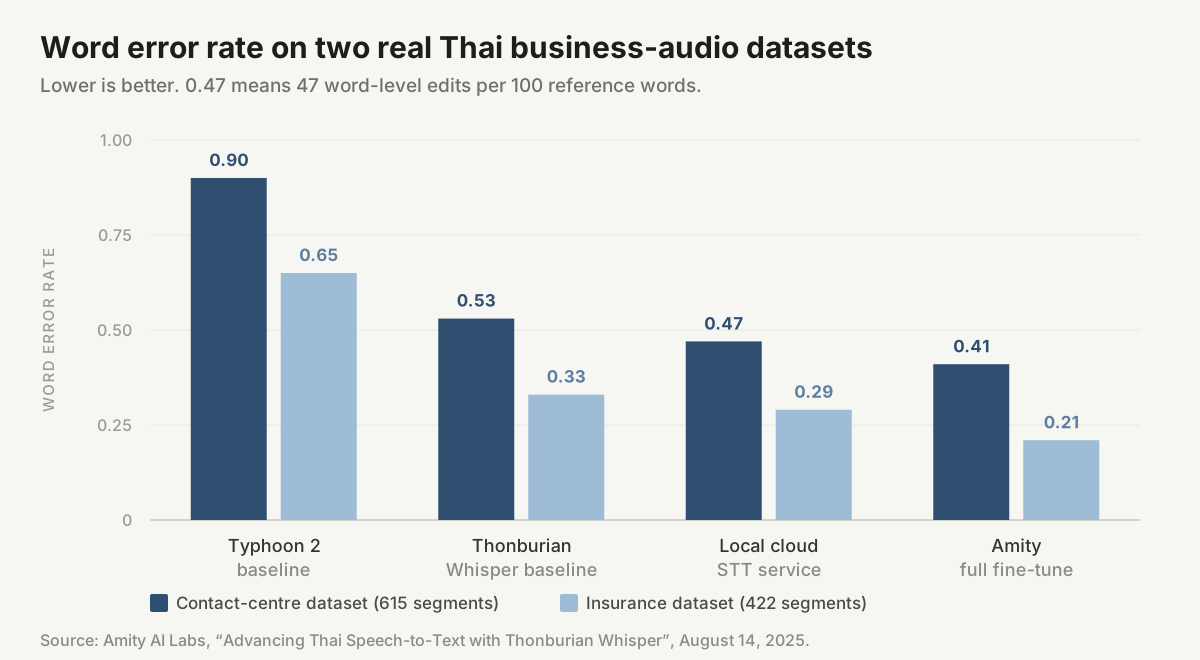
ค่าความผิดพลาดระดับคำจากไวต์เปเปอร์ของ Amity วันที่ 14 สิงหาคม 2025 ระบบสำเร็จรูปบนเสียงธุรกิจภาษาไทยของจริงอยู่ระหว่าง 0.29 ถึง 0.90
ตัวเลขคือข้อโต้แย้งในตัวมันเอง Typhoon 2 ได้ค่า 0.90 บนชุดคอนแทกต์เซ็นเตอร์ และ 0.65 บนชุดประกันภัย Thonburian Whisper ซึ่งเป็นการปรับจูน Whisper เฉพาะภาษาไทยอยู่แล้ว ได้ 0.53 และ 0.33 บริการถอดเสียงบนคลาวด์เชิงพาณิชย์ในประเทศได้ 0.47 และ 0.29 ส่วนโมเดลที่ Amity ปรับจูนเต็มรูปแบบเองได้ 0.41 และ 0.21
ค่าความผิดพลาดระดับคำที่ 0.47 หมายความว่าราวหนึ่งในสองคำต้องถูกแก้ นั่นคือสิ่งที่ระบบอเนกประสงค์ทำกับเสียงพูดธุรกิจภาษาไทยที่ไม่ได้ซ้อมมา มีเสียงรบกวน และผ่านแบนด์วิดท์โทรศัพท์ ลองอ่านหน้าโฆษณาที่เคลมว่า "แม่นยำ 99 เปอร์เซ็นต์ในภาษาไทย" เทียบกับตารางนั้นดู แล้วคุณจะได้เรียนรู้อะไรบางอย่างเกี่ยวกับหน้าโฆษณานั้น
การแยกผู้พูดก็เล่าเรื่องเดียวกัน Amity รายงานว่าไปป์ไลน์มาตรฐาน pyannote.audio เมื่อใช้กับเสียงชุดประกันภัยโดยไม่ปรับให้เข้ากับภาษาไทย ให้ค่า Diarization Error Rate ที่ 31.3 เปอร์เซ็นต์ โดยความผิดพลาดหลักอยู่ที่ "การแยกแยะผู้พูดที่พูดทับกันและผู้พูดที่สลับภาษา" เมื่อปรับส่วนหน้าของระบบแล้ว ค่า DER ลดลงเหลือ 8.13 เปอร์เซ็นต์ บนชุดประเมินเดียวกัน การสลับภาษาโผล่มาอีกครั้ง คราวนี้ในรูปของปัญหาการระบุตัวผู้พูด คือเครื่องไม่รู้ว่า ใคร พูดประโยคนั้น ทันทีที่คนคนนั้นสลับภาษากลางประโยค
คุณสมบัติเชิงโครงสร้างสองอย่างของภาษาไทยทำให้เรื่องนี้ยากกว่าปัญหาเดียวกันในภาษาอังกฤษ อย่างแรก อักษรไทยไม่ใช้ช่องว่างคั่นขอบเขตของคำ การตัดคำจึงเป็นสิ่งที่งานวิจัย AttaCut ของ ชอไม้ ประเสริฐสม และรัทเทอร์ฟอร์ด ซึ่งส่งเมื่อวันที่ 16 พฤศจิกายน 2019 เรียกว่า "ขั้นตอนเตรียมข้อมูลพื้นฐานสำหรับการประมวลผลภาษาธรรมชาติภาษาไทย" ตัวรู้จำเสียงต้องตัดสินก่อนว่าคำหนึ่งจบตรงไหน จึงจะตัดสินได้ว่าคำนั้นคือคำอะไร และความกำกวมนี้มีจริงมากพอที่วงการ NLP ภาษาไทยจะมีวรรณกรรมย่อยทั้งกองว่าด้วยตัวตัดคำที่แข่งกันเอง อย่างที่สอง ภาษาไทยเป็นภาษาที่มีวรรณยุกต์ ความหมายขี่อยู่บนเส้นเสียง ระบบที่ฟังวรรณยุกต์ผิดจึงไม่ได้คืนคำที่ผิดเพี้ยนเล็กน้อย แต่คืนคำที่ไม่เกี่ยวข้องกันเลย
ผลในทางปฏิบัติไม่ใช่ "อย่าใช้ระบบถอดเสียง" แต่คือ ให้ตั้งสมมติฐานว่าข้อความถอดเสียงภาษาไทยรอบแรกมีข้อผิดพลาด แล้วเลือกซื้อกระบวนการทำงานที่คนแก้ไขได้ ซึ่งต้องมีข้อความถอดเสียงอยู่ก่อน ต้องแก้ไขได้ และต้องยังอยู่ในวันพรุ่งนี้
วิธีจัดการประชุมไทย–อังกฤษให้ยังเหลือบันทึกไว้
เจ็ดขั้นตอน เรียงตามลำดับที่มันเกิดขึ้นจริง แต่ละข้อแก้จุดพังที่ระบุไว้ข้างบน
- ตัดสินใจเรื่องความเสี่ยงก่อนตัดสินใจเรื่องเครื่องมือ ถ้าประโยคที่แปลผิดสร้างความเสี่ยงทางกฎหมาย ทางการแพทย์ หรือทางสัญญา ให้จ้างล่ามมนุษย์ แล้วอ่านต่อ เพราะขั้นตอนเรื่องบันทึกด้านล่างใช้กับการประชุมนั้นด้วย ล่ามดูแลห้องประชุม แต่การจ้างล่ามไม่ได้ทำให้เกิดเอกสารขึ้นมาหลังจบ
- แยกงาน "ทำความเข้าใจ" ออกจากงาน "เก็บบันทึก" และยอมรับว่ามันคือคนละเครื่องมือ Google Translate หรือคำบรรยายของ Meet จัดการความเข้าใจภาษาไทยได้ในวันนี้ แต่ไม่มีตัวไหนสร้างบันทึกภาษาไทยที่อยู่ถาวร การเลือกเครื่องมือเดียวให้ทำทั้งสองอย่างคือวิธีที่ทำให้ทีมจบลงด้วยการไม่ได้ทั้งสองอย่าง
- ตั้งงบชั่วโมงที่ถูกแปลอย่างซื่อสัตย์ ถ้าจองการแปลต่อเนื่อง ให้จองเวลาเป็นสองเท่าของวาระ และบอกผู้เข้าร่วมด้วยเวลาเลิกจริง ครึ่งวัน 4 ชั่วโมงที่ราคา 6,000 บาท ครอบคลุมวาระได้สองชั่วโมง ไม่ใช่สี่
- ตั้งภาษาไทยเป็นภาษาพูดอย่างชัดเจน อย่าพึ่งการตรวจจับอัตโนมัติ บน DeepL Voice ข้อนี้บังคับ เพราะภาษาไทยเป็นภาษาจากผู้ให้บริการภายนอกและใช้การตรวจจับอัตโนมัติไม่ได้ ส่วนที่อื่นก็ยังเป็นทางเลือกที่ดีกว่าอยู่ดี เพราะการตรวจจับอัตโนมัติต้องเดาให้ได้ภายในไม่กี่วินาทีแรก บนช่วงเสียงที่มีบริบทน้อยที่สุดของทั้งการประชุม
- ตรวจรายการภาษาของฟีเจอร์ที่ทำหน้าที่เขียน ไม่ใช่ของแพลตฟอร์ม นี่คือกับดักที่บทความทั้งบทความมีไว้เพื่ออธิบาย Google Meet รองรับภาษาไทย แต่บันทึกถอดเสียงของ Google Meet ไม่รองรับ ตัวเลข 69 กับ 8 คือระยะห่างระหว่างสองประโยคนั้น
- ประกาศปัญหาการสลับภาษาออกมาดัง ๆ ก่อนเริ่มประชุม ถ้าทีมของคุณแทรกชื่อผลิตภัณฑ์ รหัสตั๋วงาน และรหัสชิ้นส่วนภาษาอังกฤษลงในประโยคภาษาไทย ซึ่งทีมไทยที่มีบริษัทแม่ต่างชาติทุกทีมทำ ให้ยืนยันก่อนว่าเครื่องมือเก็บบันทึกของคุณรับสองภาษาในการประชุมเดียวได้ โหมด
multiของ Nova-3 ไม่รวมภาษาไทย ส่วนผู้ช่วยจดบันทึกของ Meet ปฏิเสธการประชุมหลายภาษาตรง ๆ - แก้ชื่อและตัวเลขภายในห้านาทีแรก แบบสด ๆ คำนามเฉพาะภาษาไทยกับชื่อรหัสผลิตภัณฑ์ภาษาอังกฤษคือสองจุดที่การถอดเสียงพลาดเป็นประจำ และเป็นสองจุดเดียวกันที่บรรทัดผิดหนึ่งบรรทัดสร้างความเสียหายมากที่สุดต่อสรุปทุกฉบับที่สร้างทับมัน การแก้ระหว่างประชุมใช้เวลาไม่กี่วินาที การแก้สรุปในสัปดาห์ถัดไปใช้เวลาเถียงกันหนึ่งรอบ
ถ้าคุณอยากได้เวอร์ชันกระบวนการทำงานของข้อ 7 มากกว่าบทวิเคราะห์ตลาด คู่มือเดือนมิถุนายนของเราพาเดินผ่าน การเปลี่ยนการประชุมภาษาไทยให้เป็นรายการงานที่ตรวจทานได้ตั้งแต่ต้นจนจบ และหน้า โซลูชันการแปลการประชุมแบบเรียลไทม์ อธิบายว่าชั้นสดกับชั้นบันทึกเชื่อมกันอย่างไร
เมื่อไหร่ที่ยังควรจ้างล่ามมนุษย์ พูดกันตรง ๆ
เราจะไม่แกล้งทำเป็นว่าเครื่องมือชนะทุกห้องประชุม เพราะฉะนั้นนี่คือเส้นแบ่งที่เราขีดจริง
จ้างล่ามมืออาชีพเมื่อประโยคที่แปลผิดมีผลที่การแก้ทีหลังย้อนคืนไม่ได้ เช่น กระบวนพิจารณาของศาลและอนุญาโตตุลาการ การนัดหมายเรื่องตรวจคนเข้าเมืองและที่สถานทูต การพบแพทย์ การเจรจาควบรวมกิจการระดับบอร์ด การตรวจสอบตามกฎระเบียบ และทุกบทสนทนาที่อีกฝ่ายจะยกคำพูดของคุณไปอ้างในภายหลัง จ้างล่ามเมื่อห้องใหญ่พอที่หน้าจอมือถือไม่ใช่ช่องทางส่งมอบที่ใช้ได้ และจ้างล่ามเมื่อการไกล่เกลี่ยทางวัฒนธรรมสำคัญพอ ๆ กับความแม่นยำของถ้อยคำ เพราะภาษาไทยเชิงธุรกิจแบกเรื่องลำดับชั้นและการรักษาหน้าไว้ในแบบที่การแปลตรงตัวทำให้แบนราบ และล่ามที่ดีกำลังจัดการเรื่องนั้นอยู่แบบเรียลไทม์
ใช้เครื่องมือเมื่อการประชุมเป็นเรื่องภายใน เกิดซ้ำเป็นประจำ เป็นงานปฏิบัติการ และคงไม่มีทางเกิดขึ้นเลยถ้าต้องจองล่วงหน้าสามสัปดาห์พร้อมใบแจ้งหนี้ห้าหลัก นั่นคือการประชุมส่วนใหญ่ และเป็นกลุ่มที่บันทึกสำคัญที่สุด เพราะไม่มีใครตั้งใจจะจดรายงานการประชุมอยู่แล้ว
ล่ามกับบันทึกไม่ใช่ของที่ต้องเลือกซื้ออย่างใดอย่างหนึ่ง
บทความส่วนใหญ่ที่มาถึงจุดนี้จะนำเสนอทางเลือกแบบ "อย่างใดอย่างหนึ่ง" ซึ่งเป็นกรอบที่ผิด จุดยืนที่คมกว่าคือ ล่ามมนุษย์ บวก ผู้ช่วยจดบันทึก คือในการประชุมที่มีความเสี่ยงสูงซึ่งคุณควรจ้างมืออาชีพอย่างไม่ต้องสงสัย เครื่องก็ยังมีที่นั่งของตัวเอง โดยทำงานเงียบ ๆ อยู่ข้าง ๆ และรับผิดชอบสามหน้าที่ที่ล่ามไม่ได้มาเพื่อทำ
หนึ่ง: เป็นบันทึกอ้างอิง คำแปลของล่ามเป็นเสียงพูดและจบไปกับอากาศ ชั้นถอดเสียงจะเก็บเสียงภาษาต้นทางไว้ในรูปข้อความ วางคู่กับคำแปลของเครื่อง ประเด็นที่เถียงกันในอีกสามสัปดาห์ถัดมาจึงตรวจย้อนได้ว่าจริง ๆ แล้วพูดอะไรไว้เป็นภาษาไทย ไม่ใช่ตรวจกับความทรงจำของใครสักคนเกี่ยวกับเวอร์ชันภาษาอังกฤษของประโยคนั้น เรื่องนี้สำคัญที่สุดในบริบทเดียวกับที่ทำให้ต้องจ้างล่ามพอดี เพราะบริบทเหล่านั้นคือบริบทที่จะมีคนยกคำพูดในห้องประชุมมาอ้างกับคุณทีหลัง
สอง: เป็นผู้ช่วยของทุกคนในห้อง รวมถึงตัวล่ามเอง การแปลต่อเนื่องถูกบีบอัดเมื่อเวลากดดัน และสิ่งแรกที่หายไปคือรายละเอียดที่ไม่มีน้ำหนักทางไวยากรณ์แต่มีน้ำหนักทางปฏิบัติการทั้งหมด ได้แก่ รหัสชิ้นส่วน วันที่ เปอร์เซ็นต์ ชื่อบริษัท และศัพท์เทคนิคที่ไม่คุ้น นี่ไม่ใช่การตำหนิล่าม แต่เป็นรูปร่างของงานตามที่มีบันทึกไว้ การมีข้อความถอดเสียงที่เดินไปเรื่อย ๆ และตรวจทานได้ ทำให้ตัวเลขยังอยู่บนจอหลังจากประโยคที่มีตัวเลขนั้นผ่านไปแล้ว และผู้เข้าร่วมที่คิดว่าตัวเองฟังผิดว่า "วันที่ 15" ก็เลื่อนขึ้นไปดูได้ โดยไม่ต้องขัดจังหวะ
สาม: เป็นชั้นงานหลังการประชุม ล่ามไม่ได้เขียนรายงานการประชุม นั่นไม่ใช่งานของเขาและคุณไม่ควรขอ สรุป รายการงานที่ต้องทำ และบันทึกการตัดสินใจที่ค้นหาได้ คืองานที่เกิดขึ้นหลังล่ามกลับไปแล้ว และทุกวันนี้มันถูกทำด้วยมือโดยคนที่อาวุโสน้อยที่สุดในห้อง หรือไม่ก็ไม่ถูกทำเลย
แต่ต้องรักษาลำดับให้ซื่อสัตย์ เพราะลำดับนี้เดินทางเดียว คำแปลของเครื่องทำหน้าที่ช่วยและจัดเก็บ ไม่ได้ทำหน้าที่ลบล้างมืออาชีพที่อยู่ในห้อง เมื่อข้อความถอดเสียงกับล่ามขัดแย้งกันในบริบททางกฎหมายหรือทางการแพทย์ ล่ามคือผู้มีอำนาจตัดสิน และข้อความถอดเสียงคือสิ่งที่คุณเดินไปตรวจดู ให้มองบันทึกเป็นหลักฐานไว้เปิดดู ไม่ใช่ความเห็นที่สองที่มีน้ำหนักเท่ากัน
มีบริบทอีกชิ้นที่อธิบายว่าทำไมหมวดหมู่นี้ถึงมีอยู่ในประเทศไทยตั้งแต่แรก ในดัชนีความสามารถทางภาษาอังกฤษ EF ฉบับปี 2025 ประเทศไทยได้ 402 คะแนน เทียบกับค่าเฉลี่ยโลกที่ 488 อยู่อันดับที่ 116 และคะแนนย่อยด้านการพูดอยู่ที่ 377 ไม่ว่าคุณจะคิดอย่างไรกับระเบียบวิธีของดัชนีนี้ ทิศทางก็ไม่มีข้อโต้แย้ง คือการประชุมทางธุรกิจของคนไทยกับคู่ค้าต่างชาติจำนวนมากดำเนินด้วยภาษาที่อย่างน้อยฝ่ายหนึ่งกำลังฝืนใช้อยู่ ทุกคนในห้องนั้นต้องกลับมาอ่านซ้ำได้ว่าตกลงอะไรกันไว้ ในภาษาของตัวเอง หลังจากอะดรีนาลีนลดลงแล้ว
สรุป: ไทยแก้เรื่องฟังเข้าใจได้แล้ว แต่ข้ามเรื่องจำได้ไป
ตลอดสิบปีที่ผ่านมา คำบ่นเรื่องภาษาไทยในธุรกิจระหว่างประเทศคือเทคโนโลยีฟังไม่เข้าใจ ในปี 2026 คำบ่นนั้นหมดอายุไปแล้วเป็นส่วนใหญ่ ภาษาไทยอยู่ใน 74 ภาษาของ Live translate อยู่ใน 69 ภาษาของ Meet อยู่ใน 58 โค้ดของ Nova-3 อยู่ใน Interpreter ของ Samsung และอยู่ในภาษาคำบรรยายของ DeepL เรื่องฟังเข้าใจจัดการได้แล้ว และส่วนใหญ่ฟรีด้วย
สิ่งที่ไม่ขยับคือบันทึก ฟีเจอร์สองตัวของ Google ที่สร้างชิ้นงานถาวรรองรับรวมกัน 8 ภาษา เป็นชุดเดียวกัน และไม่มีภาษาไทยในทั้งสองตัว ส่วนโหมดเดียวที่สร้างมาเพื่อผสมสองภาษาในประโยคเดียวครอบคลุม 10 ภาษา และก็ไม่มีภาษาไทยอีกเช่นกัน ค่าความผิดพลาดระดับคำของภาษาไทยที่เผยแพร่จริงบนเสียงธุรกิจจริงอยู่ระหว่าง 0.21 ถึง 0.90 ขึ้นกับว่ามีใครลงแรงปรับโมเดลให้เข้ากับภาษาไทยหรือเปล่าล้วน ๆ และล่ามมนุษย์ ซึ่งแก้เรื่องความเข้าใจได้ดีกว่าทุกตัวที่ว่ามา ก็เดินออกจากห้องไปพร้อมกับการประชุมทั้งงานที่อยู่ในหัวของเขา
คำถามที่ควรถามผู้ให้บริการจึงไม่ใช่ "รองรับภาษาไทยไหม" เพราะแทบทุกเจ้าตอบว่ารองรับ และแทบทุกเจ้าหมายถึงครึ่งที่เป็นการฟัง คำถามที่ควรถามคือ ฟีเจอร์ไหนของคุณที่รองรับภาษาไทยหลังจบการประชุม ฟีเจอร์ไหนรอดจากประโยคภาษาไทยที่มีภาษาอังกฤษแทรกกลาง และขอดูรายการภาษาของฟีเจอร์เฉพาะเจาะจงเหล่านั้นได้ไหม
Telli.sh อยู่ตรงไหน: ชั้นบันทึกคือชั้นที่เราสร้าง Telli.sh ถอดเสียงการประชุมในภาษาที่พูดกันจริง แปลเป็น 44 ภาษาปลายทางรวมถึงภาษาไทย และเก็บชิ้นงานทั้งสามไว้ในโน้ตเดียวกัน คือข้อความต้นทางภาษาไทย คำแปลที่จัดเรียงตรงกับต้นทาง และสรุปที่สร้างทับอีกชั้น โดยแก้ไขได้ทั้งหมดเมื่อชื่อออกมาผิด ตัวอินเทอร์เฟซเองมี 15 ภาษา รวมภาษาไทย ทีมในกรุงเทพฯ กับลูกค้าที่โอซากาจึงอ่านการประชุมเดียวกันในภาษาของตัวเอง โดยยังใช้บันทึกฉบับเดียวที่แก้ไขได้ร่วมกัน
เริ่มบันทึกการประชุมพร้อมแปลแบบเรียลไทม์
แหล่งอ้างอิง
- Sawadee Translations, Interpreting Services ดึงข้อมูล 1 กันยายน 2026 — แปลต่อเนื่องเริ่มต้น 3,000 บาทต่อชั่วโมง แปลพร้อมเริ่มต้น 5,000 บาทต่อชั่วโมง และข้อสังเกตว่ากระบวนพิจารณาทางกฎหมายกับการนัดหมายที่สถานทูตส่วนใหญ่ใช้การแปลต่อเนื่อง
- Y LINK / Personnel Consultant, Interpretation (Japanese, English, Thai, Chinese) ดึงข้อมูล 1 กันยายน 2026 — ตารางเรตครึ่งวันและเต็มวัน ณ สถานที่ เรตออนไลน์แปลพร้อม 3,000 บาทต่อ 60 นาที และแปลต่อเนื่อง 2,000 บาทต่อ 60 นาที นิยามครึ่งวัน/เต็มวัน สูตรค่าล่วงเวลาตามกฎหมายแรงงานไทย และบันไดค่ายกเลิก
- Acolad, "Simultaneous vs Consecutive Interpreting: Which One Do You Need?" 24 เมษายน 2026 — ความยาวช่วงพูดหนึ่งถึงห้านาที และประโยค "การประชุมแบบแปลต่อเนื่องจะใช้เวลาเพิ่มขึ้นราวเท่าตัว เพราะทุกประโยคถูกพูดสองรอบ"
- Elite Asia, "Simultaneous vs. Consecutive Interpretation: How to Choose for Your Event" ดึงข้อมูล 1 กันยายน 2026 — รายการอุปกรณ์ของแต่ละโหมด
- Google Translate Help, "Hear live speech to speech translations with Live translate" ดึงข้อมูล 1 กันยายน 2026 — รายการ 74 ภาษารวมภาษาไทย สี่โหมด โหมด face to face และการทำงานต่อเนื่องเบื้องหลัง
- Google Meet Help, "Use translated captions in Google Meet" ดึงข้อมูล 1 กันยายน 2026 — รายการ 69 ภาษารวมภาษาไทย แพ็กเกจ Workspace แบบเสียเงิน และ Record captions
- Google Meet Help, "Use Transcripts with Google Meet" ดึงข้อมูล 1 กันยายน 2026 — แปดภาษาที่รองรับการถอดเสียง
- Google Meet Help, "'Take notes for me' in Google Meet" ดึงข้อมูล 1 กันยายน 2026 — แปดภาษาชุดเดียวกัน และข้อความ "รองรับครั้งละหนึ่งภาษา"
- Samsung, Call assist: Live translate calls on your Galaxy phone ดึงข้อมูล 1 กันยายน 2026 — ภาษาไทยในรายการภาษาที่รองรับ และข้อควรระวังเรื่องผู้ใช้ทีละคน
- Deepgram, Models & Languages Overview ดึงข้อมูล 1 กันยายน 2026 — ภาษาไทยในโค้ด
thและth-THในตาราง Nova-3 และ Nova-2, โค้ดภาษาหลักที่ไม่ซ้ำกัน 58 รายการ และรายการโหมดสลับภาษาmulti10 ภาษา - DeepL Help Center, "DeepL Voice languages" ดึงข้อมูล 1 กันยายน 2026 — 18 ภาษาพูดที่ DeepL ถอดเสียงเอง, 20 ภาษาพูดจากผู้ให้บริการภายนอกรวมภาษาไทย, สวิตช์ของผู้ดูแลระบบ, ข้อจำกัดการตรวจจับอัตโนมัติ, ข้อกำหนดรหัสเข้าใช้งาน และข้อตกลงไม่เก็บข้อมูลกับ Speechmatics
- Amity AI Labs, "Advancing Thai Speech-to-Text with Thonburian Whisper" 14 สิงหาคม 2025 — ชุดข้อมูลคอนแทกต์เซ็นเตอร์ 615 เซกเมนต์และประกันภัย 422 เซกเมนต์ ตารางค่าความผิดพลาดระดับคำ และผล DER จาก 31.3 เปอร์เซ็นต์ เหลือ 8.13 เปอร์เซ็นต์
- Chormai, Prasertsom และ Rutherford, "AttaCut: A Fast and Accurate Neural Thai Word Segmenter" ส่งเมื่อ 16 พฤศจิกายน 2019 — การตัดคำในฐานะขั้นตอนเตรียมข้อมูลพื้นฐานของ NLP ภาษาไทย
- EF Education First, EF English Proficiency Index — Thailand ฉบับปี 2025 ดึงข้อมูล 1 กันยายน 2026 — อันดับโลกที่ 116 คะแนน 402 เทียบค่าเฉลี่ยโลก 488 และคะแนนย่อยด้านการพูด 377