AnyDecisionModel и AnySpeechRecognizer разделяют слух и выбор Swift-приложения
Два сторонних Swift-пакета связывают распознавание речи и типизированные решения. Где помогает локальная работа, почему уверенность требует калибровки и как начать ограниченный пилот.
Запись разговора с поддержкой содержит две разные задачи. Сначала приложение должно восстановить сказанное клиентом. Затем оно должно решить, относится ли запрос к расчётам, технической поддержке или другой команде. Когда обе задачи превращаются в один разговор без ограничений, ответственность приложения становится менее заметной.
Разработчик Mattt представил AnySpeechRecognizer и AnyDecisionModel 29 октября 2026 года. Это сторонние Swift-пакеты для разработчиков платформ Apple: один предлагает выбор движков распознавания речи, другой возвращает типизированные варианты и распределения вероятностей. Они используют знакомые шаблоны Swift, но не являются анонсами продуктов Apple. Введение Mattt объясняет обе задачи на одном примере звонка в поддержку.
Интересное изменение — возможность выбирать и оценивать эти задачи отдельно. Это руководство объясняет вклад пакетов, влияние локальных и размещённых серверных частей на архитектуру приложения и причину, по которой числовой уверенности всё равно нужна окружающая продуктовая политика.
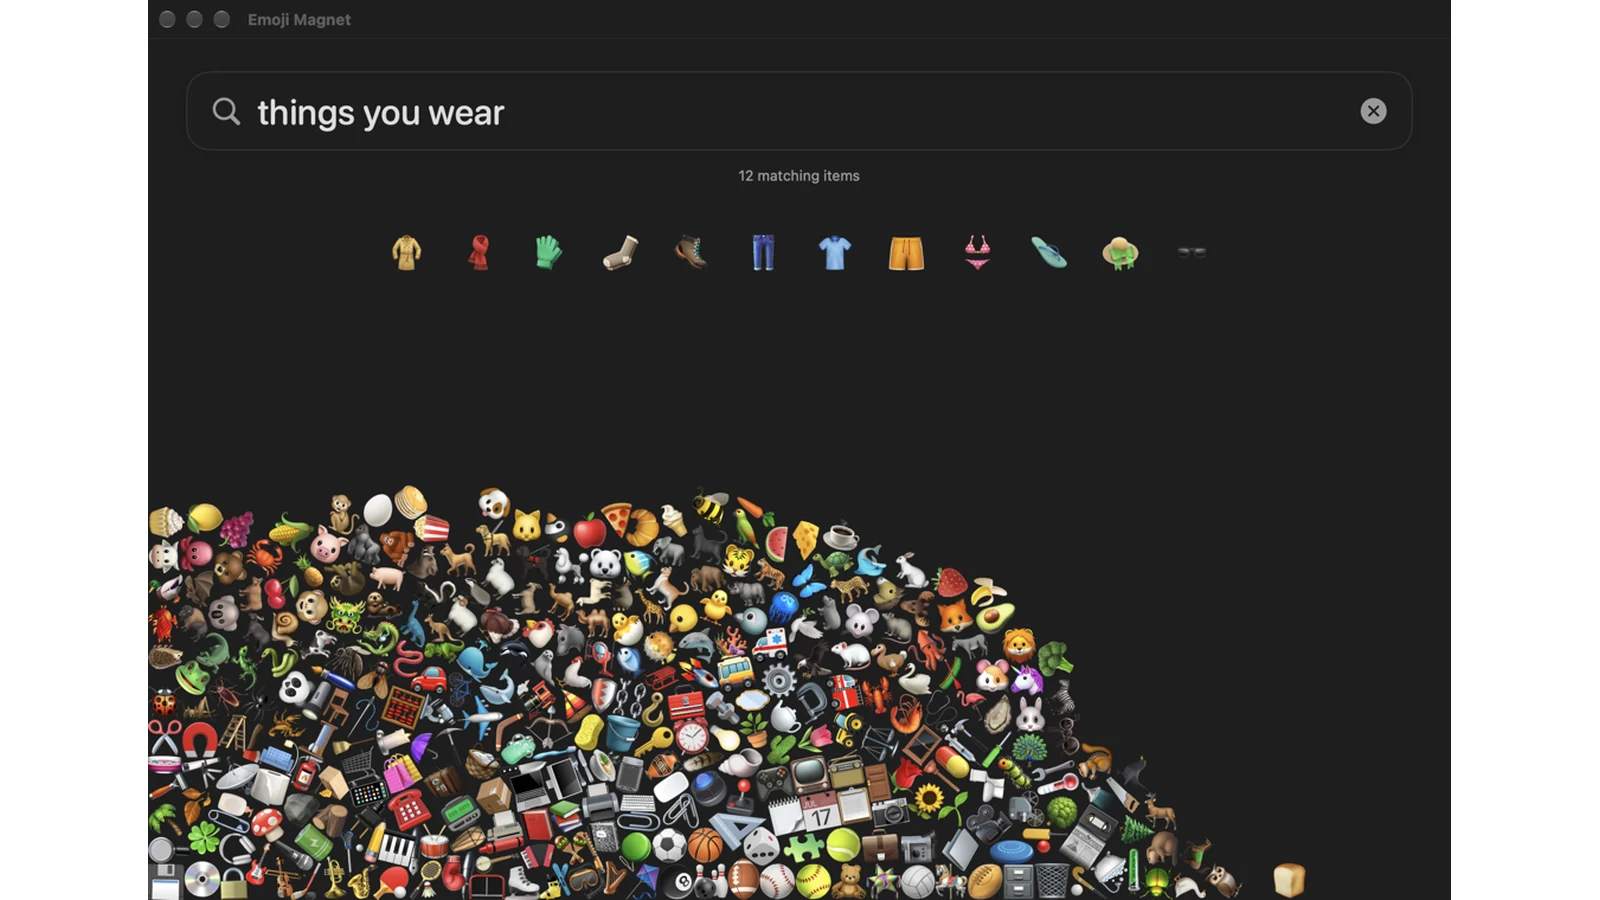 Пример приложения Emoji Magnet от Mattt использует AnyDecisionModel для сортировки эмодзи. Снимок экрана документации, предоставленный автором, Apache 2.0; размер изменён с добавлением полей. Источник изображения · Лицензия и сведения об изображении.
Расшифровке и решению о маршрутизации нужны отдельные приёмочные тесты
Представьте клиента, говорящего: «Счёт неверный, и я не могу войти, чтобы его скачать». Расшифровка может правильно воспроизвести предложение, пока политика распределения всё равно даёт сбой. Отправляет ли компания запрос в расчётный отдел из-за счёта, в техническую поддержку из-за входа или в общую очередь, поскольку присутствуют обе проблемы?
Ответ зависит от политики сервиса. Модель не может восполнить отсутствующее правило ответственности, просто вернув явно предпочитаемую категорию. До оценки любой серверной части запишите значение каждого разрешённого варианта и поведение, когда подходят несколько. Это даёт приложению более полезную цель, чем «результат выглядел разумно».
Разделение этапов также облегчает диагностику ошибок. Если распознаватель изменил название продукта, сохраните расшифровку и проверьте, изменилось бы решение при правильных словах. Если текст точен, но команда выбрана неверно, изучите определения вариантов и модель решений. Это разные задачи исправления, а их объединение скрывает источник сбоя.
Наша оценка: самая ценная абстракция здесь — граница между восприятием речи и выбором. Каждый этап должен создавать материал, который следующий может изучить. Тогда продуктовая команда может решить, какие этапы заслуживают автоматического выполнения, а какие должны оставаться предложениями человеку.
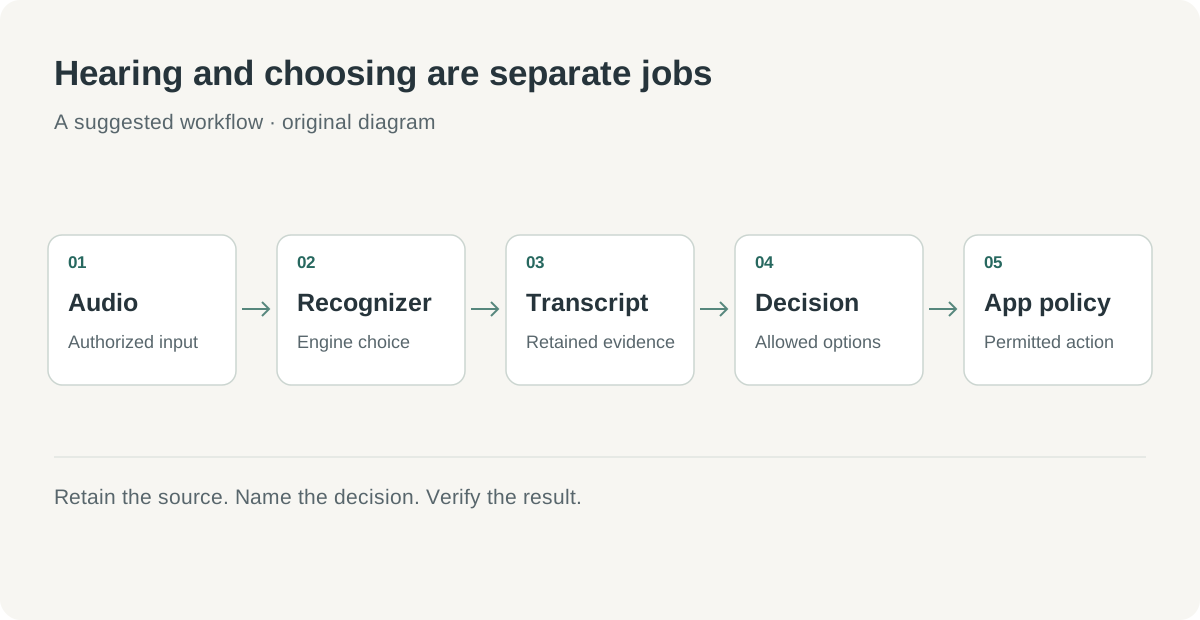 Авторская схема процесса: распознавание предоставляет доказательства; ограниченное решение — распределение; приложение определяет разрешённое действие.
Выбор движка важен, когда меняется аудио приложения
README AnySpeechRecognizer, проверенный 2 ноября, описывает API по образцу современного Speech framework Apple с вариантами Apple, Parakeet и Qwen3-ASR. Возможности движков различаются: опубликованное сравнение указывает живые предварительные результаты и временные метки слов для некоторых путей, тогда как Qwen3-ASR выдаёт сегменты без временных меток слов. Пакету нужны Swift 6.2 или новее и macOS либо iOS 26 или новее, с дополнительными аппаратными требованиями отдельных моделей.
Это различие видно в проектировании продукта. Живые субтитры выигрывают от текста до окончания речи, но должны показывать, что предварительные слова могут измениться. Импорт файла может отдавать приоритет финальному результату, позволяя пользователю дождаться обработки записи. Один экран расшифровки не должен притворяться, что оба режима имеют одинаковые временные свойства.
В иллюстративном приложении интервью метки слов могут быть необходимы, потому что нажатие на предложение должно переводить запись к нужному месту. В иллюстративном голосовом входящем ящике сегментной расшифровки может хватать, поскольку основная задача — просмотр короткого сообщения. Выбирайте движок после определения взаимодействия и проверяйте языки, акценты и условия записи, которыми действительно пользуется аудитория.
Поддержка языков заслуживает такого же подхода. Список языков — проверка применимости, а шумная клиентская запись — приёмочное испытание. Сохраняйте исходное аудио для уполномоченных проверяющих и давайте возможность исправить важные имена или числа. Эти исправления полезны при выборе между другой конфигурацией распознавателя и лучшим сценарием восстановления в продукте.
Пакет также оставляет захват аудио приложению. Это полезная граница ответственности: приложение продолжает отвечать за разрешение записи, выбор источника и жизненный цикл захвата. Библиотеку распознавания не следует считать целой функцией записи, особенно когда интерфейс должен обрабатывать прерывания, отмену и пользователя, заканчивающего раньше.
Типизированные решения уменьшают разбор текста, но не ответственность
README AnyDecisionModel, проверенный 2 ноября, документирует бинарные вероятности, выбор из разрешённых вариантов и оценки упорядоченных шкал. Он предлагает локальные пути MLX, Core AI и llama.cpp, а также серверные части Jev и Ollama. API возвращает структурированные результаты, не заставляя приложение извлекать категорию из объяснительного абзаца.
Это может значительно упростить приложение. Когда допустимый результат — отдел, код может явно обработать каждый отдел. Когда вопрос в необходимости проверки сообщения, результат может поступать в политику с состоянием проверки. Приложению всё ещё нужно определить, что означает «проверка» и кто отвечает за очередь.
Иллюстративное приложение отчётов об обслуживании делает различие ясным. Работник записывает описание, распознаватель создаёт текст, а слой решений предлагает одну из категорий оборудования. Приложение может показать предложение рядом с расшифровкой до сохранения. Оно не должно молча превращать предложение категории в заключение о безопасности, ремонтный заказ или разрешение эксплуатировать оборудование.
Упорядоченным оценкам нужны столь же конкретные определения. Если команда запрашивает срочность по трёхуровневой шкале, каждый уровень должен описывать действие или ожидание сервиса. «Низкая», «средняя» и «высокая» легко отображаются, но трудно оцениваются, когда проверяющие понимают их по-разному. Короткий письменный критерий делает разногласия видимыми до превращения в проблемы обучения модели или порогов.
| Подход | Что получает приложение | Когда полезен | Главный вопрос оценки |
|---|---|---|---|
| Свободная генерация | Текст, возможно с обоснованием | Пользователю нужны объяснение или черновик | Правильно ли содержимое и можно ли его использовать? |
| Ограниченный выбор | Выбранный разрешённый вариант и распределение | Приложение определило категории | Следует ли выбор политике категорий? |
| Упорядоченная оценка | Распределение по определённым уровням | У приложения есть содержательная шкала | Соответствуют ли уровни нужному действию? |
| Человеческая проверка | Записанное решение человека | Контекст неполон или последствия требуют суждения | Достаточно ли доказательств получил проверяющий? |
Сравнение касается проектирования интерфейса, а не утверждения, что один метод всегда побеждает. Некоторым экранам нужны и ограниченный выбор, и краткое объяснение. Отличайте объяснение от доказательств и сохраняйте возможность редактировать решение там, где процесс это допускает.
Уверенность описывает распределение, а не гарантирует точность
README AnyDecisionModel проводит необычно полезное различие: локальная уверенность измеряет концентрацию распределения ответов, а не вероятность правильности выбранного ответа. Он также предостерегает от сравнения уверенности разных серверных частей так, будто у них одна формула. Калибровку следует настраивать отдельно от оценочных данных. Документация проекта, проверено 2 ноября 2026 года.
Допустим, иллюстративный тест возвращает одному отделу вероятность 0,90, распределяя остаток между другими. Это говорит, что модель предпочла этот отдел при полученных вопросе и вариантах. Это не устанавливает историческую успешность в 90 % для такого клиентского сообщения. Определения категорий могут быть плохими, во входе может не хватать ключевого контекста или модель может систематически предпочитать один вариант.
Поэтому полезной продуктовой политике нужен явный путь «оставить на проверку». Сначала показывайте проверяющим все решения и собирайте исправления. Затем оцените, достаточно ли надёжен какой-либо поднабор для узко определённого автоматического действия. Порог — следствие наблюдавшихся ошибок и их стоимости, а не число, выбранное за уверенный вид.
Оценочная выборка должна содержать неоднозначные сообщения, незнакомые имена и случаи, когда ни один доступный отдел не подходит. Система может выглядеть сильной, когда каждый пример попадает в одну чистую категорию, а затем провалиться на смешанных запросах реальной поддержки. Пусть проверяющие записывают причину изменения выбора, чтобы команда отличала плохой ответ модели от отсутствующей политики.
Изучайте также стоимость каждого направления ошибки. Отправка обычного запроса на проверку тратит время; молчаливая передача чувствительного запроса неверной аудитории может иметь иные последствия. Один средний показатель скрывает различие. Сообщайте о случаях, важных владельцам продукта, и затем выбирайте политику действий, которую они могут объяснить пользователям и сопровождающим.
Поэтому смена серверной части — изменение продукта. Один Swift-вызов может скрывать разное поведение, смысл чисел и операционные зависимости. Повторите оценку до переноса старого порога в новую конфигурацию. Сохраняйте идентификатор модели, конфигурацию и определения вариантов с результатом, чтобы поздняя проверка объяснила происхождение решения.
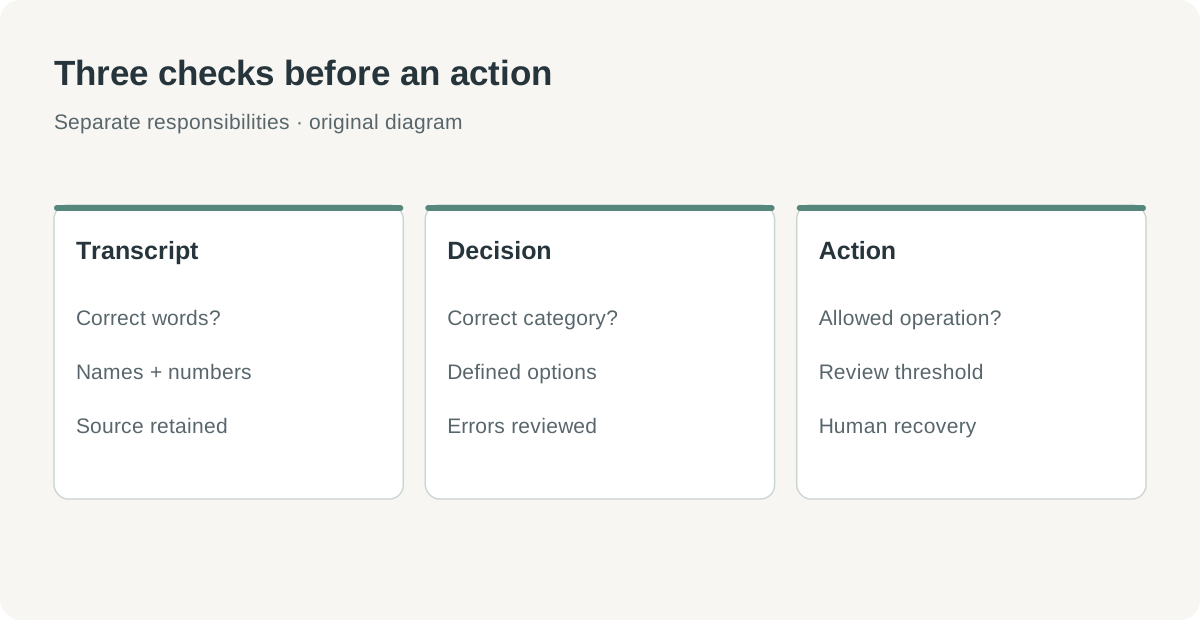 Авторская схема: сильное предпочтение не отменяет проверки правильности и определения политики действий. Уверенность и точность отвечают на разные вопросы.
Локальная работа меняет ответственность команды
Запуск модели на устройстве привлекателен для голосового ящика или автономного справочника. Команда может проектировать вокруг локально сохраняемых входов и предсказуемой сетевой границы. Но загрузки моделей, поддерживаемое оборудование, память и подготовка первого запуска становятся видимой частью пользовательского опыта. Обещание конфиденциальности должно описывать весь путь, включая размещённый этап, позднее добавленный в приложение.
Размещённая серверная часть решений переносит часть операционной работы на сервис, но добавляет в процесс сеть, доступы и доступность сервиса. Пользователю нужно понятное состояние при сбое или ожидании. Повтор должен сохранять исходную расшифровку и не повторять случайно последующее действие, уже завершившееся.
Текущая документация также отделяет испытанную совместимость от проверки живого сервиса. AnyDecisionModel говорит, что тесты протокольной совместимости Jev и Ollama используют фикстуры. Это ценное покрытие, но выпускаемое приложение всё равно должно проверить выбранную конфигурацию сервиса целиком. README AnyDecisionModel, проверено 2 ноября.
Не обещайте одинаковую производительность на Mac разработчика и самом слабом поддерживаемом телефоне. Целевая платформа указывает, где код предполагается запускать; она не даёт доказательств задержки, батареи или памяти для каждого устройства. Приложение может начать с обработки файлов на одной проверенной машине и расширять поддержку после прохождения целевого взаимодействия на дополнительном оборудовании.
Начните с файлового процесса, который легко проверить
Первый пилот должен делать ошибки удобными для изучения. Небольшое файловое приложение часто понятнее живого ассистента, потому что одно разрешённое аудио можно воспроизводить и сравнивать. Цель — доказать этапы и их передачу до добавления взаимодействия в реальном времени.
- Определите одну задачу с коротким списком допустимых решений и письменным правилом неоднозначных случаев. Включите вариант проверки в политику приложения.
- Проверьте текущие требования пакетов и добавьте нужную Swift-зависимость. Выберите один движок распознавания и одну серверную часть решений вместо одновременной проверки всех сочетаний.
- Импортируйте небольшую выборку разрешённых записей. Храните исходные файлы, ожидаемые расшифровки и решения проверяющих отдельными записями.
- Явно установите или подготовьте нужные модельные материалы по документации пакета. Покажите подготовку и обработку отдельными состояниями интерфейса.
- Выполните распознавание, сохраните окончательный текст и задайте о нём ограниченные вопросы. Покажите результат рядом с источником вместо немедленного внешнего действия.
- Проверьте ошибки по этапам, затем оцените отдельную выборку записей после изменений. Записывайте конфигурацию с каждым результатом.
- Добавьте поведение отмены, недоступной модели и сетевого сбоя до перехода к живой записи или автоматической маршрутизации.
Критерий успеха должен быть понятен владельцу продукта. Например, пилот голосового ящика мог бы требовать, чтобы проверяющий находил исходную запись, исправлял расшифровку и менял предложенную очередь без потери оригинальных материалов. Это полезный результат процесса ещё до решения об автоматизации.
Даже малым решениям нужно полное проектирование продукта
Пакеты предлагают привлекательную архитектуру: один компонент слышит, другой выбирает, а код приложения обеспечивает допустимое действие. Это создаёт места измерения качества и восстановления после сбоя. Также становится легче обсуждать ограничения числового ответа с людьми, которые должны ему доверять.
Стоит проверить ожидание сопровождаемости. Может ли команда заменить распознаватель без переписывания приложения? Может ли оценить новую серверную часть решений, не притворяясь, что старые пороги ещё применимы? Могут ли пользователи исправлять результат там, где ошибка действительно возникла?
Малая модель становится полезной, когда её работа ясна, а за результат отвечает конкретный владелец. Swift-абстракция связывает части; политика решений продукта даёт этим частям цель.
Источники
- Mattt: представляем AnySpeechRecognizer и AnyDecisionModel, 29 октября 2026 года.
- AnySpeechRecognizer: требования, сравнение движков и примеры, проверено 2 ноября 2026 года.
- AnyDecisionModel: серверные части, калибровка и ограничения, проверено 2 ноября 2026 года. Лицензии кода пакетов и отдельных моделей требуют раздельного рассмотрения.
- Mattt: документация Emoji Magnet и снимок экрана, документация Apache-2.0; проверено 2 ноября 2026 года.
Сохраняйте связь решения о реализации с источником
Telli.sh — один из вариантов хранения разрешённых исходных материалов и заметок, стоящих за решением о реализации. Создать пространство заметок.