Strata и Qwen3.8-Flash-Next: как запустить модель класса 180B на обычном ПК
Проверенный по источникам обзор архитектуры Strata, установки в Windows и Linux, отдельного экспериментального пути для Apple Silicon, опубликованных тестов и ограничений локального ИИ.
Модель примерно на 180 миллиардов параметров, работающая на настольном компьютере с видеокартой на 12 ГБ, звучит как противоречие. Strata делает такую возможность правдоподобной, но не за счёт размещения всех параметров в видеопамяти. Интереснее другое: разные части разреженной модели используют разные виды памяти и вычислений, а генерация каждого токена не превращается в узкое место из-за переноса данных.
Официальное название модели — Qwen3.8-Flash-Next, а не Qwen3.8-Next-Flash. В карточке Qwen указано ядро на 125B параметров, из которых активируются 6B, дополнительный компонент n-граммных эмбеддингов на 51B и 4B для предсказания нескольких токенов. Округлённая сумма 180B описывает хранящиеся компоненты, а не объём плотных вычислений для каждого токена. Карточка модели Qwen
Инструкции по настройке и сведения о производительности ниже относятся к версии Strata с коммитом fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Показатели бенчмарков опубликованы проектом; результаты на вашем оборудовании могут отличаться в зависимости от запроса, контекста и варианта модели.
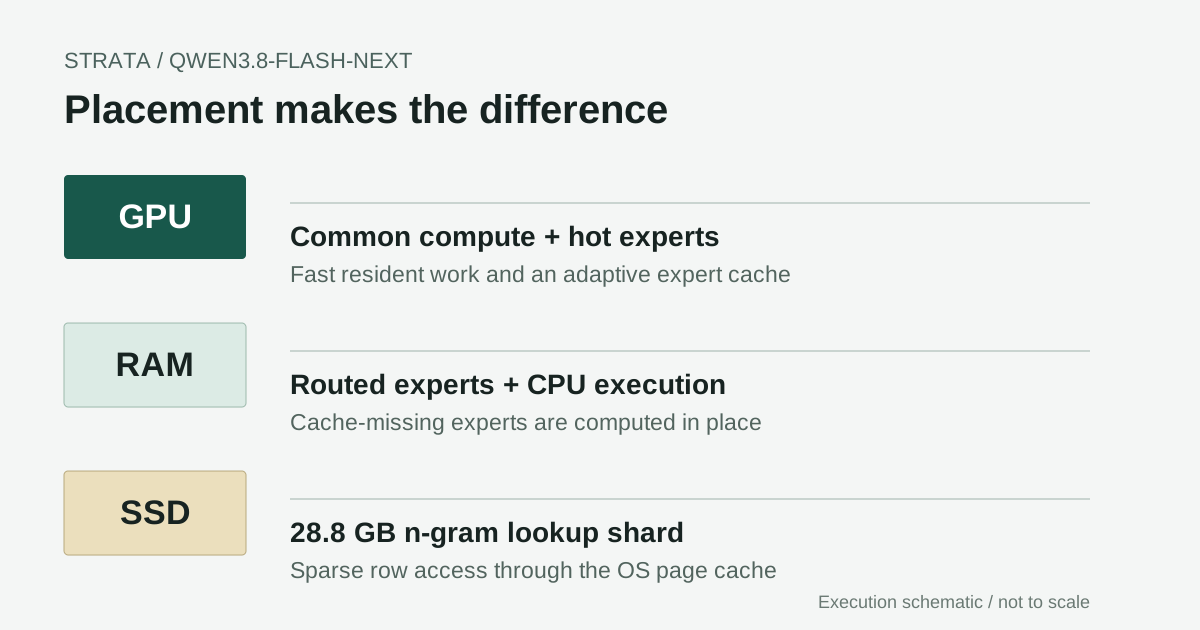
Авторская схема по описанной архитектуре выполнения. Масштаб уровней условный: размер загрузки, использование RAM и размещение в видеопамяти — разные величины.
Прорыв — в размещении, а не в уменьшении модели
Для необычно большой локальной модели важны три вопроса: сколько данных нужно хранить, сколько параметров активно для одного токена и где выполняются активные вычисления. Малое число активных параметров отвечает только на второй вопрос. Оно не отменяет необходимости где-то держать остальные веса в доступном виде.
Strata — разработанный сообществом движок инференса и приложение для локального обслуживания модели в репозитории Niko1221. В документации описаны установка в Windows и Linux, локальный чат-интерфейс, совместимые API и необязательный ввод изображений. Это отдельный проект сообщества, а не официальный настольный продукт Qwen. Репозиторий Strata
Полезный инженерный сдвиг — перестать считать ПК видеокартой с недостаточным объёмом памяти. У настольного компьютера есть также системная RAM, векторные блоки CPU и файловый кэш операционной системы. Для одних операций эти ресурсы медленнее видеопамяти, но это не делает их одинаково непригодными для любых задач. Для поиска по большой таблице и плотного умножения матриц не нужна одна и та же стратегия размещения.
Именно это различие делает заголовок интересным. Модель остаётся большой; меняется то, какой её объём среда выполнения должна держать в самой быстрой памяти в каждый конкретный момент. Так появляется практический путь к локальному инференсу, но это не доказывает, что любая обычная ноутбучная система справится с ним хорошо.
Разреженная архитектура открывает такую возможность
Архитектура Qwen объединяет блоки Gated DeltaNet рекуррентного типа с Qwen Sparse Attention, маршрутизируемыми экспертами и n-граммными эмбеддингами. В техническом отчёте объясняется, как эти компоненты помогают эффективнее масштабировать модель. Strata не создавала эти компоненты — она строит стратегию выполнения с учётом разных способов доступа к ним. Отчёт об архитектуре Qwen
Важна детализация маршрутизации. В каждом из 48 слоёв есть 512 маршрутизируемых экспертов; в каждом слое активируются 10 маршрутизируемых экспертов наряду с общим экспертом. Значит, во всех слоях хранится 24 576 маршрутизируемых экспертов. Это не означает, что при обработке токена во всей модели используются только 10 из этих 24 576 экспертов. Конфигурация архитектуры Qwen
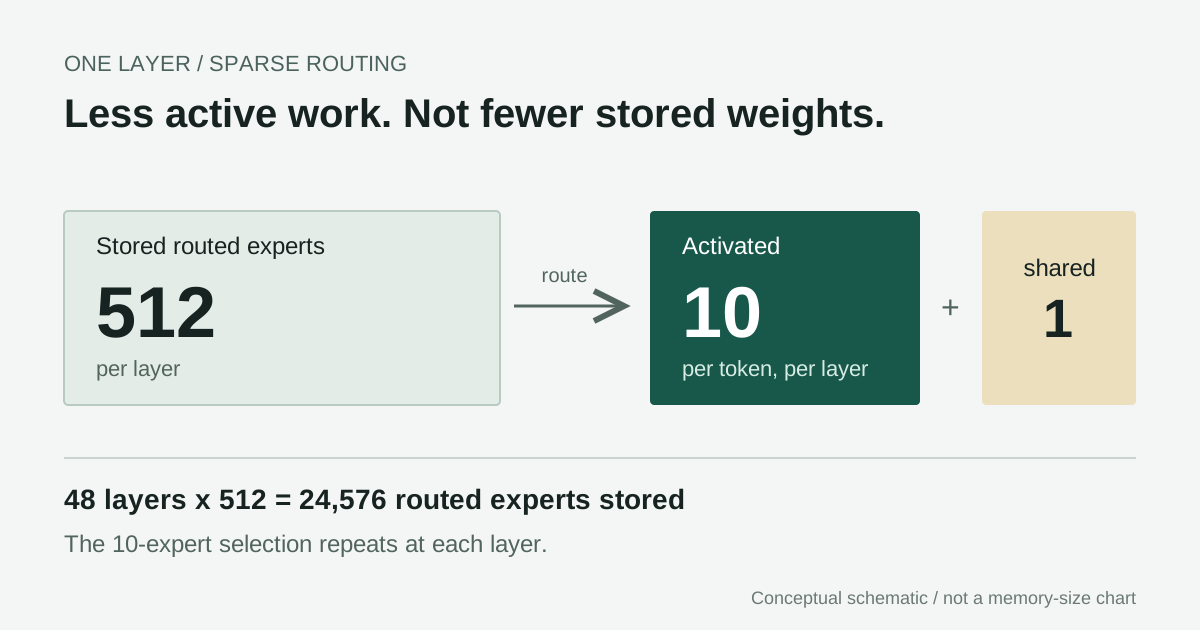
Выбор экспертов уменьшает объём активной работы, а не число хранимых весов. Схема показывает один слой, а не всю модель из 48 слоёв.
Рассмотрим последствия, не опираясь на заявления о скорости. Если эксперт выбирается редко, постоянно занимать им дорогую память ускорителя может быть нерационально. Если другой компонент используется на каждом шаге, его постоянное перемещение, вероятно, обойдётся дорого. Полезный планировщик должен различать эти случаи и обрабатывать неизбежные промахи кэша.
Поэтому разреженную модель класса 180B нельзя сравнивать с плотной моделью на 180B только по числу параметров. Но и называть её «моделью 6B» — значит умалчивать о хранении, маршрутизации, состоянии контекста и затратах на доступ к распределённым весам. Оба упрощения скрывают настоящую инженерную задачу.
GPU, RAM и SSD выполняют разные задачи
В описанной базовой конфигурации GPU хранит общие вычислительные компоненты и кэш часто используемых маршрутизируемых экспертов. Веса маршрутизируемых экспертов находятся в системной RAM, а CPU на месте вычисляет экспертов, отсутствующих в кэше GPU. Отдельная таблица n-грамм с отображением в память остаётся на SSD; нужные строки обслуживаются через кэш операционной системы. Обзор выполнения в Strata
Путь через CPU важнее, чем может показаться по общему слову «выгрузка». При декодировании промах кэша не обязательно означает, что каждый отсутствующий эксперт нужно сначала скопировать на GPU и лишь затем продолжать работу. Вычисления CPU и GPU могут идти параллельно. Обратная сторона в том, что возможности CPU и пропускная способность системной памяти напрямую влияют на скорость вывода.
У n-граммного компонента другой шаблон доступа. Поиск нескольких строк — не то же самое, что чтение всей таблицы подряд. Поэтому хранить на SSD квантованный поисковый сегмент размером 28.8 GB может быть практично: это не означает, что при генерации каждого токена вся модель считывается с диска. Однако медленный накопитель или сильная нагрузка на файловый кэш всё равно могут ухудшить отзывчивость.
Обработка начального запроса тоже отличается от декодирования. На этапе prefill обрабатываются более крупные пакеты, и перенос экспертов можно перекрывать с работой других слоёв. Генерация следующего токена, повторяющаяся шаг за шагом, чувствительна к задержке. В подробной документации проекта описаны отдельные ядра, планирование и поведение кэша для этих этапов. Одного показателя пропускной способности недостаточно, чтобы описать оба. Детали реализации Strata
На мой взгляд, инновация здесь — согласованная система, а не один трюк с компрессией. Квантизация уменьшает объём хранимых весов; кэш сокращает повторные обращения к востребованным весам; CPU обрабатывает промахи; разреженный поиск избавляет от необходимости загружать всю огромную таблицу целиком. Уберите любое из этих преимуществ — и настольный компьютер с умеренным объёмом памяти станет куда менее убедительной платформой.
Спекулятивное декодирование экономит работу, только если проверка принимает черновик
Strata также использует компонент предсказания нескольких токенов, чтобы предложить короткое продолжение и проверить его целевой моделью. Вместо полного прохода целевой модели для каждого отдельного выходного токена успешный черновик позволяет за один такой проход принять сразу несколько токенов. Согласно описанию в репозитории, путь MTP формирует черновики длиной до трёх токенов. Устройство и реализация MTP
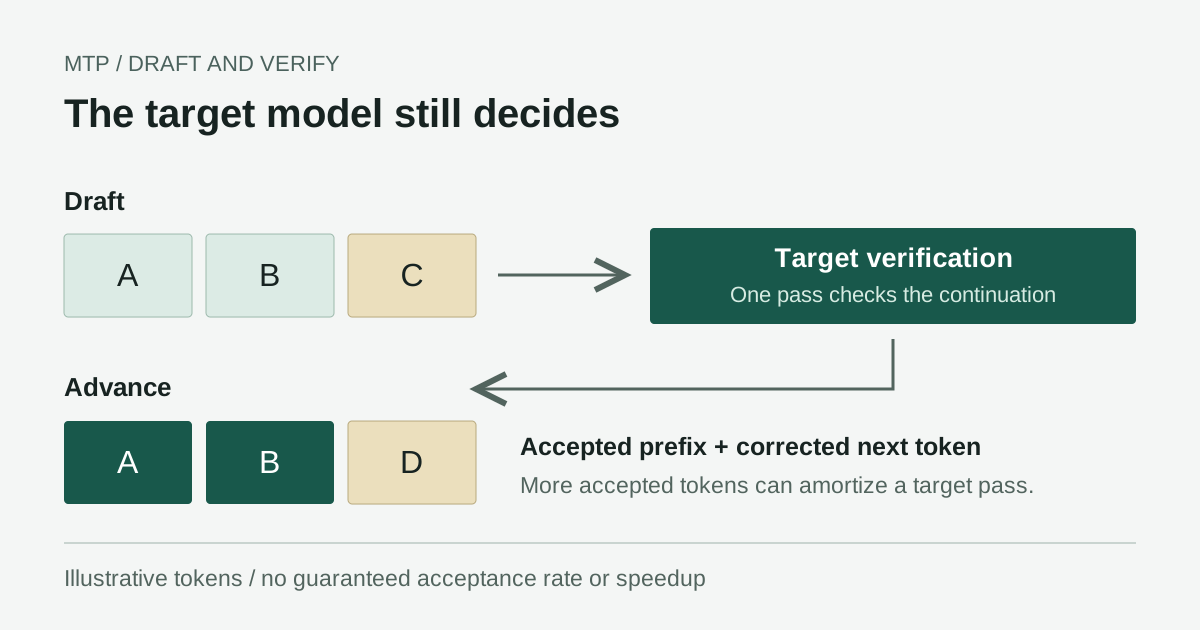
Пример иллюстрирует проверку, а не гарантированную долю принятых токенов или измеренное ускорение.
Такое ускорение условно. Предсказуемый код или повторяющийся текст легче черновым образом продолжить, чем незнакомый переход в рассуждении. На принятие могут влиять формулировка запроса, сэмплирование, длина вывода и вариант модели. Поэтому показатель, измеренный на одном запросе, нельзя автоматически переносить на другой язык или задачу.
Проверка выполняется именно той моделью, которая запущена. Она не восстанавливает информацию, утраченную при квантизации, и не доказывает эквивалентность исходным весам BF16. Важно не смешивать эти вопросы: спекулятивное выполнение и качество модели с пониженной точностью отвечают на разные вещи.
Есть и другое различие — повторное использование кэша. Неизменённый префикс разговора позволяет избежать повторной работы, но продолжение с прогретым кэшем и новый длинный запрос — это неравноценные тесты. Сравнивая результаты локального запуска, фиксируйте, переиспользовался ли префикс. Проект отдельно документирует кэширование на границах сообщений. Поведение кэша префиксов
«GPU на 12 GB» не означает установку размером 12 GB
Опубликованные квантованные варианты GGUF разделяют модель на основной сегмент и отдельный сегмент n-грамм фиксированного размера 28.8 GB. Размеры файлов ниже указаны в десятичных GB: это объём загрузки, а не требование к видеопамяти. Необязательный визуальный проектор добавляет около 0.91 GB; вспомогательные загрузки и временные файлы конвертации потребуют дополнительного места. Файлы квантования ISTA-DASLab
| Вариант | Среднее число бит на вес ядра | Основной сегмент | Сегмент n-грамм | Общий объём загрузки |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Одно название формата не описывает точно каждый тензор. В основном сегменте используются смешанные форматы, а для сегмента n-грамм — IQ4_NL. Выражение «двухбитная модель» удобно, но вводит в заблуждение, если понимать его так, будто вся загрузка использует ровно два бита на параметр. Методика квантования
Для первой пробы полной модели более реалистичная отправная точка — поддерживаемая видеокарта от 12 GB и 64 GB системной RAM, а не только впечатляющая цифра по видеопамяти. В репозитории также описаны варианты с меньшими требованиями к RAM и урезанный вариант Coder. Это другие конфигурации, а не доказательство того, что компьютер с 32 GB даст такой же опыт работы с полной моделью. Выбор модели в Strata
Перед экспериментами я бы освободил на SSD 100-150 GB. Это консервативный запас для планирования, а не фиксированное требование производителя: итог зависит от выбранной квантизации, вспомогательной модели MTP, необязательных файлов для зрения и кэшей сборки или конвертации. Для некоторых вариантов оптимизации Q2 на CPU может потребоваться значительная дополнительная копия экспертов. Проверяйте выбранный путь, а не полагайтесь на одну универсальную цифру для диска.
Прежде чем выбирать оборудование, определите нужную конфигурацию: полная или урезанная модель, короткий или длинный контекст, зрение или только текст, постоянная пропускная способность или редкое использование. Эти параметры влияют на узкое место, а бенчмарк ниже описывает конкретную систему.
Сначала зафиксируйте базовую версию, потом настраивайте
Документированный стандартный путь охватывает Windows 10/11 и Ubuntu 22.04/24.04, поддерживаемые видеокарты NVIDIA и отдельные GPU AMD. В инструкциях NVIDIA указан драйвер версии 580 или новее. Для macOS и других вариантов сборки из исходников действуют отдельные требования; приведённые ниже команды не являются универсальным способом установки. Официальное руководство по установке
В Windows сначала выполните проверку, а не загрузку
Если Git ещё не установлен, установите его из официального дистрибутива. В PowerShell клонируйте исходный репозиторий и зафиксируйте рассмотренную здесь ревизию:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Проверка позволяет избежать загрузки большой модели, но загрузчик может установить Python и подготовить отдельное окружение для её выполнения. Как работает проверка установки
Прежде чем продолжить, изучите отчёт об оборудовании и скрипты установки, а также проверьте свободное место. Затем запустите интерактивную настройку:
.\START-HERE.bat
Для первой пробы на системе с 64 GB разумно начать с IQ2_XS — одного из документированных вариантов. Выберите контекст 32,768 токенов, только текст и отключите Experimental Speed Projection. На такой базовой конфигурации проще выявлять причины сбоев, чем сразу включать максимальный контекст, зрение и все оптимизации.
Будьте готовы к загрузкам и установке зависимостей: это не крошечный автономный исполняемый файл. В зависимости от пути GPU настройка использует готовый движок или инструменты сборки. Внимательно проверяйте запросы на установку драйверов и компиляторов или на права администратора; не отключайте антивирус или защиту браузера ради принудительной установки. Нужный драйвер загружайте у производителя оборудования.
При следующих запусках используется тот же загрузчик. Чтобы вернуться к настройке или избежать конфликта портов:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
В Ubuntu используйте документированный скрипт настройки
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Выберите вариант бэкенда, соответствующий вашей видеокарте. Путь AMD ROCm и путь NVIDIA CUDA не взаимозаменяемы. Запросы пакетного менеджера или компилятора означают изменения в вашей системе и требуют проверки. Зафиксированная ревизия делает руководство воспроизводимым; в новых выпусках поддержка может улучшиться, поэтому перед намеренным обновлением читайте примечания к выпуску.
Сначала проверьте ответ, потом подключайте агента
После завершения загрузки откройте в локальном браузере http://127.0.0.1:8080 или выбранный альтернативный порт. Отправьте короткий вопрос без чувствительных данных и убедитесь, что ответ сформирован до конца. Только после этого пробуйте более длинный запрос, повторное использование кэша в продолжении разговора и нужный вам язык. Во время первой загрузки следите за использованием памяти и журналами сервера.
Среди документированных совместимых API — GET /v1/models и POST /v1/chat/completions. Получите идентификатор обслуживаемой модели, а не подставляйте в другой клиент предположительно правильный псевдоним:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Используйте возвращённый идентификатор при настройке совместимого клиента. Успешный запрос списка моделей подтверждает обнаружение модели, но не качество генерации; первый значимый тест — полностью полученный ответ чата. На время этой проверки отключите инструменты агента, которые записывают файлы или выполняют команды оболочки.
Если видеокарте не хватает памяти, сначала уменьшите контекст и отключите зрение. Если процесс завершился или система интенсивно использует файл подкачки, проверьте системную RAM, а не только VRAM. При отсутствии библиотек среды выполнения обращайтесь к инструкциям для конкретного бэкенда, а не устанавливайте случайные DLL. В проекте есть руководство, сгруппированное по симптомам. Устранение неполадок Strata
На Mac не путайте поддержку модели с поддержкой Strata
В Apple Silicon используется унифицированная память, а не раздельные VRAM видеокарты и системная RAM, как в настольном бенчмарке. В закреплённом установщике Strata не описан поддерживаемый путь для macOS; запрос на поддержку Mac не означает, что порт уже готов. Запрос на поддержку Mac в upstream
Под запуском на Mac могут подразумеваться два разных эксперимента. Форк Strata-macOS от сообщества сохраняет интерфейс и Python API и добавляет бэкенд Metal для моделей GGUF меньшего размера; в задокументированных проверках используется Qwen2.5, а не исходная конфигурация Flash-Next. В форке прямо сказано, что потоковая передача экспертов CUDA и путь MTP Strata не портированы. Не считайте этот форк установкой модели из данной статьи в один клик. Форк сообщества и его границы
Для запуска именно Qwen3.8-Flash-Next есть отдельный экспериментальный путь: совместимая сборка llama.cpp с Metal и разделённые файлы GGUF от издателя. Это не Strata на Mac, и приведённая ниже таблица скорости для Windows к этому пути не относится.
Соберите отдельную среду выполнения Metal
Понадобятся Mac с Apple Silicon, терминал в режиме ARM64, инструменты командной строки разработчика Apple, Git и CMake. Если CMake отсутствует, установите его из официального дистрибутива или через доверенный пакетный менеджер. В рассмотренной документации по сборке llama.cpp Metal на macOS включён по умолчанию. Фиксация версии движка также не позволит незаметному перемещению ветки изменить пример в будущем. Инструкции по сборке llama.cpp с Metal
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Загрузите оба сегмента IQ2_XS из списка файлов издателя в один каталог, сохранив исходные имена. Второй сегмент необходим, даже если строки поиска остаются на диске. Замените пример пути к модели ниже на фактический путь к первому сегменту на вашем Mac:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
Издатель документирует загрузку разделённых файлов и флаги mmap/lazy; в рассмотренном движке эти параметры доступны. Они позволяют обращаться к таблице n-грамм по мере необходимости, а не держать её целиком в памяти. Это параметры llama.cpp, а не загрузчика Strata. Пример загрузки GGUF
Объём памяти по-прежнему важен: основной сегмент IQ2_XS занимает 39.2 GB, не считая состояния среды выполнения и накладных расходов macOS. Поэтому Mac с 16 GB или 24 GB нельзя считать реалистичной базой для полного размещения модели в памяти в этом примере; даже 64 GB — лишь отправная точка для планирования, без гарантии успеха. Следите в «Мониторинге системы» за давлением на память и подкачкой, начните с контекста 4K и остановитесь, если давление на память остаётся высоким. Не меняйте лимиты памяти ядра, пытаясь принудительно запустить конфигурацию, которая не помещается.
Перед дальнейшими экспериментами убедитесь, что в журналах выбран Metal и завершилась связная текстовая генерация. Затем проверьте более длинные запросы, прежде чем добавлять спекулятивное декодирование или обработку изображений. Этот путь не охватывает компьютеры Mac с Intel, распределённое выполнение на нескольких Mac и преобразования в MLX. Здесь не приводится пропускная способность для Mac: результаты зависят от модели чипа, объёма унифицированной памяти, движка, квантизации и контекста.
Опубликованная скорость впечатляет, но задержка до первого токена рассказывает другую историю
Для воспроизводимого сравнения в таблице использован бенчмарк от 29 сентября 2026 года для движка версии 0.1.26, а не смешанные данные из более поздних заголовков README. Тестовая система: RTX 5070 12 GB с PCIe 5.0 x16, шестиядерный Ryzen 5 7600, 64 GB DDR5-5200 и Windows 10. Использовались жадная генерация, включённый MTP, отключённая обработка изображений и 256 генерируемых токенов. Условия бенчмарка
| Вариант | Декодирование короткого запроса, токенов/с | Декодирование длинного запроса, токенов/с | Prefill запроса средней длины, токенов/с | Время до первого токена для длинного запроса, секунд |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Короткий, средний и длинный запросы содержат соответственно 3,562, 31,566 и 128,478 токенов. Каждая ячейка — результат одного запуска, а не среднее значение с доверительным интервалом. В запуске IQ2_XS использовался документированный файн-тюн Swift 1.5, поэтому это не контролируемое сравнение только по квантизации с базовой моделью. Значения перенесены из опубликованной матрицы результатов. Данные измерений в машиночитаемом формате
Для длинного запроса с Q2_0 проходит 62.48 секунды до появления первого токена, хотя последующее декодирование идёт со скоростью 73.73 токена/с. Для человека, который ждёт обработки нового документа, важна и эта первая минута. В продолжающемся разговоре с повторно используемым контекстом впечатления могут быть другими. Нельзя скрывать ни один из этих аспектов за максимальной скоростью в токенах в секунду.
Эти цифры позволяют сделать узкий, но полезный вывод: на указанном автором настольном ПК выбранные квантованные конфигурации обеспечили интерактивную скорость генерации. Они не подтверждают такой же результат на системе с меньшей пропускной способностью памяти, на корейском языке, при сэмплировании рассуждений, включённом зрении или одновременной работе нескольких пользователей. Токены — не слова, а различия в токенизации языков дополнительно затрудняют поверхностные сравнения.
Заявленный для модели нативный контекст в 262,144 токена и поддержка расширенного контекста также не гарантируют, что выбранная конфигурация Strata будет комфортно обрабатывать такую длину. Важны состояние среды выполнения, размещение кэша и доступная RAM. Начинайте с малого и увеличивайте контекст только тогда, когда этого требует задача и оправданы дополнительные задержка и расход памяти.
Качество и функции «ускорения» нужно проверять отдельно
Издатель квантованных вариантов приводит полезные сравнения качества, но это не сквозные бенчмарки Strata. Например, результат LiveCodeBench v6 составляет 87.43 для BF16 и 81.14 для Q2_0. Это повод проверить интересующие вас задачи, а не объявлять все низкобитные варианты непригодными или все версии равноценными. Опубликованная оценка квантованных вариантов
К Experimental Speed Projection следует относиться особенно осторожно. Проект описывает эту необязательную функцию на основе управляющего вектора как изменение поведения модели, а не как незаметную арифметическую оптимизацию. Для базового теста оставьте её выключенной, а при сравнении обязательно сообщайте, если она была включена. Более быстрый ответ, полученный за счёт изменения содержания, — не то же самое, что более быстрое выполнение эквивалентной работы. Подробности экспериментальной функции
В собственной оценке фиксируйте коммит репозитория, версию движка, квантизацию и файн-тюн, GPU и VRAM, CPU, скорость RAM, SSD, драйвер, настройки контекста и включённые функции. Затем измерьте как минимум три новых запроса и три продолжения с кэшированным контекстом; приводите медиану и диапазон, а не выбирайте лучший запуск. Вместе со временем записывайте число токенов в запросе и ответе, задержку до первого токена, скорость декодирования и общее время выполнения.
Сочетайте проверку скорости с проверкой корректности для конкретной задачи: код в ответе скомпилируйте и протестируйте, ответ по документу сверьте с исходником, а в многоязычном выводе проверьте язык и терминологию. Записывайте ошибки, тайм-ауты и нехватку памяти вместе с успешными запусками.
Локальный запуск даёт контроль, но не устраняет все риски безопасности
Не меняйте адрес loopback по умолчанию. Доступ к локальному серверу модели из локальной сети или интернета меняет модель угроз, а совместимый API не становится автоматически аутентифицированным сервисом. В политике безопасности Strata описаны локальная привязка и границы безопасности; независимый внешний аудит безопасности там не заявлен. Политика безопасности Strata
Локальная генерация может уменьшить зависимость от облачного провайдера инференса, однако конфиденциальность зависит от всего рабочего процесса. Журналы чатов, клиентские приложения, веб-поиск, внешние инструменты и резервные копии могут передавать или хранить данные вне процесса модели. Прежде чем передавать агенту конфиденциальные документы, проверьте все эти каналы. «Работает локально» — полезный факт об архитектуре, но не полная сертификация приватности.
Лицензирование тоже состоит из нескольких уровней. Лицензия на код Strata не заменяет условия qwen-community-1.0 для модели. Квантованные веса не отменяют обязательства, связанные с исходной моделью. Прежде чем распространять модель или использовать её коммерчески, ознакомьтесь с соответствующими лицензиями и не исходите из того, что открытый репозиторий разрешает любые способы использования. Лицензия модели Qwen
Речь идёт о другом типе персонального ИИ-компьютера
Главный вывод не в том, что облачный инференс устарел. У настольного ПК остаются ограничения по одновременной обработке запросов, задержке до первого токена, энергопотреблению, обслуживанию и качеству модели. Облачная система по-прежнему может быть предпочтительнее, если доступность или большой поток запросов важнее контроля над средой выполнения.
Strata показывает, что возможности пользовательского инференса могут зависеть от оркестрации не меньше, чем от мощности GPU. Более эффективное использование CPU, RAM и разреженного доступа к хранилищу позволяет запускать класс моделей, который простой расчёт «всё на GPU» отверг бы. Пропускная способность системной памяти становится частью спецификации ИИ-компьютера, а не второстепенной деталью.
Это вывод из архитектуры и опубликованных результатов, а не гарантия для каждой будущей модели. Он зависит от того, есть ли в модели разреженные компоненты, которые можно кэшировать или обслуживать поиском и которые среда выполнения умеет использовать. Плотная модель с другими шаблонами доступа не получит того же преимущества только потому, что у неё похожее число параметров.
Для отдельного исследователя или разработчика реалистичный следующий шаг — ограниченный пилот: зафиксированная версия, короткий контекст, поддерживаемая система, несколько типичных задач и честная запись качества и задержек. Именно такое описание делает результат значимым. Очень большая модель стала правдоподобной нагрузкой для настольного компьютера благодаря продуманному размещению и проверке, а не исчезновению аппаратных ограничений.
Сохраняйте решения по настройке вместе с исследовательскими заметками
Сравнивая конфигурации локального ИИ, храните ссылки на источники, сведения об оборудовании, наблюдения и нерешённые вопросы вместе. Telli.sh поможет упорядочить заметки и сводки, но это не означает наличия встроенной интеграции со Strata. Создать аккаунт Telli.sh