Nova-3 vừa thêm ngôn ngữ thứ 58 trong tháng này. Chỉ 10 trong số đó chạy được trong cùng một câu.
Ngày 4 tháng 8 năm 2026, Deepgram thêm tiếng Punjab và tiếng Nepal vào Nova-3; ngày 7 tháng 8 hãng thêm tiếng Armenia và cải thiện tiếng Tamil, tiếng Indonesia, tiếng Belarus. Chín tháng trước mô hình phủ 31 ngôn ngữ — hôm nay tài liệu liệt kê 58. Nhưng chuyển mã ngôn ngữ vẫn chỉ chạy được đúng 10, và chính changelog tháng 8 cho thấy tiếng Indonesia chỉ cải thiện ở chế độ batch còn tiếng Belarus chỉ cải thiện ở chế độ streaming. Một cái nhìn về tốc độ mở rộng ngôn ngữ trong nhận dạng giọng nói, và về những gì chữ “được hỗ trợ” đang thực sự che giấu.
Ngày 4 tháng 8 năm 2026, Deepgram thêm tiếng Punjab và tiếng Nepal vào mô hình nhận dạng giọng nói Nova-3 của mình. Ba ngày sau, hãng thêm tiếng Armenia, kèm theo các mô hình đơn ngữ được cải thiện cho tiếng Tamil, tiếng Indonesia và tiếng Belarus.
Hai mục changelog, tổng cộng mười một dòng chữ, không thông cáo báo chí. Vậy mà với bất kỳ ai đang họp bằng những ngôn ngữ đó, đây là chuyện quan trọng nhất xảy ra với nhận dạng giọng nói trong tháng này.
Quy luật đằng sau hai mục đó còn đáng giá hơn chính hai mục đó. Tháng 12 năm 2025, release notes của chính Deepgram ghi Nova-3 hỗ trợ tổng cộng 31 ngôn ngữ. Đếm số mã ngôn ngữ gốc riêng biệt trong tài liệu Models & Languages Overview hôm nay, ngày 31 tháng 8 năm 2026, ta được 58. Đó là tốc độ mà cả ngành đang chạy, và nó đã âm thầm thay đổi những gì bạn nên kỳ vọng ở một bản ghi lời nói.
Bài viết này làm ba việc. Nó đặt con số và mốc ngày lên cuộc mở rộng đó bằng nguồn sơ cấp. Nó giải thích vì sao con số ngôn ngữ trên tiêu đề gần như vô dụng nếu đứng một mình — và ba câu hỏi bạn phải hỏi thay vào đó. Và nó phân tích cụ thể những bổ sung của tháng 8 thay đổi điều gì cho một cuộc họp có người nói tiếng Punjab, tiếng Nepal, tiếng Armenia, tiếng Tamil hay tiếng Indonesia trong phòng.
TL;DR:
- 58 so với 31. Tài liệu Nova-3 liệt kê tổng cộng 31 ngôn ngữ vào ngày 10 tháng 12 năm 2025 và 58 mã ngôn ngữ gốc riêng biệt vào ngày 31 tháng 8 năm 2026 — 39 ngôn ngữ được thêm qua chín mục changelog có ghi ngày.
- Độ phủ không phải một con số. Chế độ chuyển mã ngôn ngữ
language=multicủa Deepgram phủ đúng 10 ngôn ngữ (Anh, Tây Ban Nha, Pháp, Đức, Hindi, Nga, Bồ Đào Nha, Nhật, Ý, Hà Lan). 48 ngôn ngữ còn lại chỉ chạy được từng ngôn ngữ một.- Batch và streaming là hai sản phẩm riêng. Bản phát hành ngày 7 tháng 8 cải thiện tiếng Tamil ở cả hai, tiếng Indonesia chỉ ở batch, tiếng Belarus chỉ ở streaming. Cùng một mục changelog, ba kết quả khác nhau.
- Đơn ngữ vẫn thắng. Với 48 trong 58 ngôn ngữ của Nova-3, mô hình chuyên biệt không chỉ tốt hơn chế độ đa ngữ — nó là lựa chọn duy nhất tồn tại.
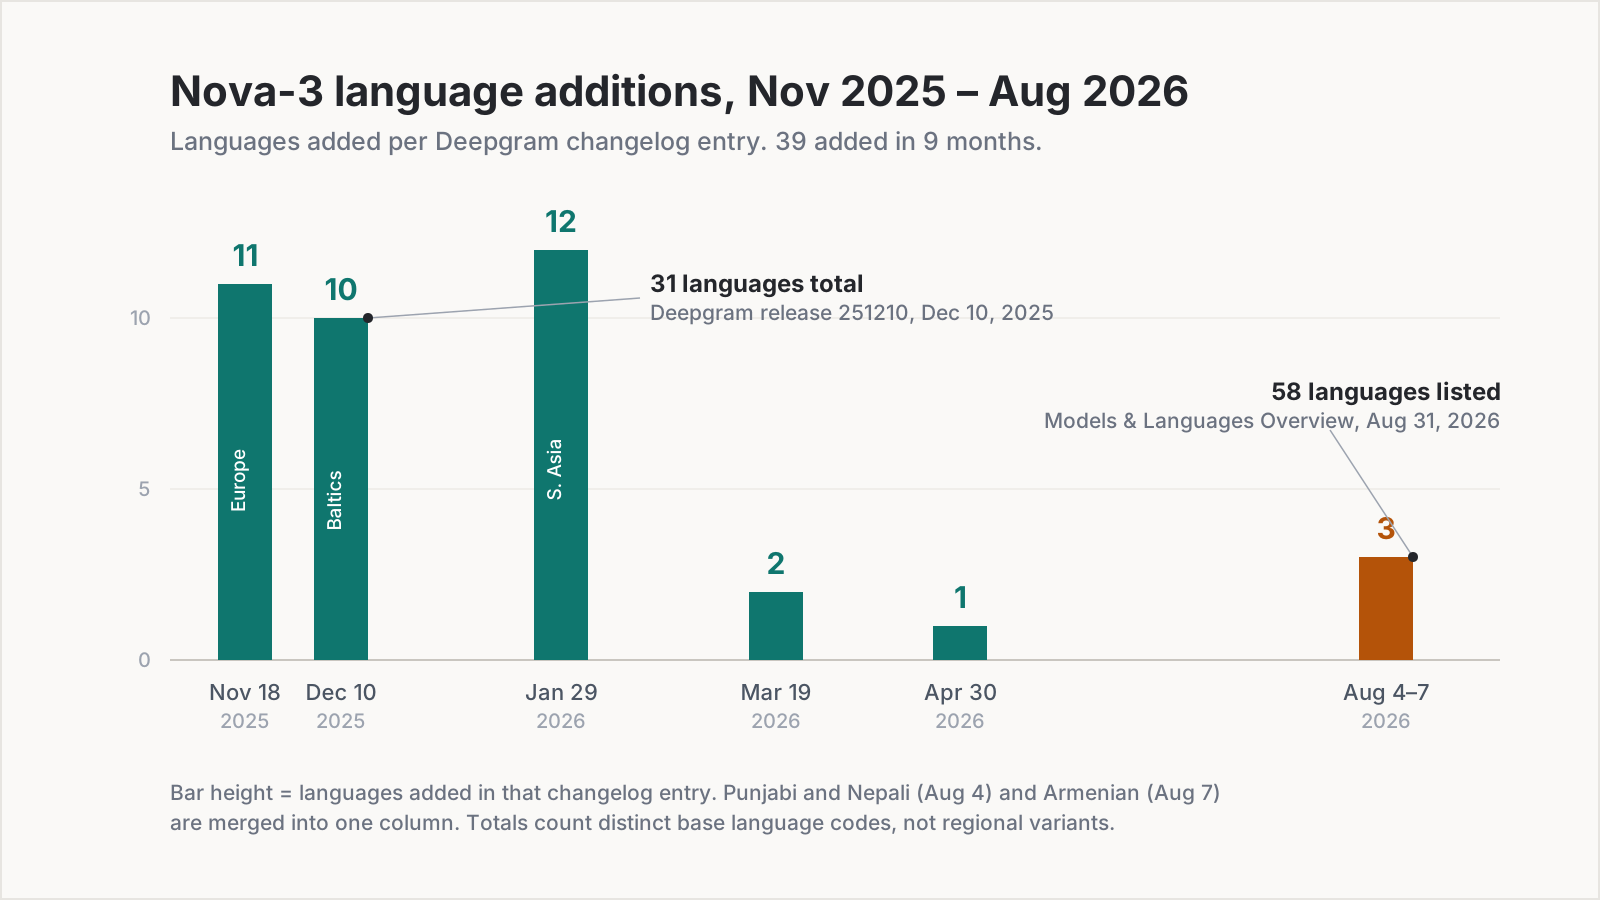
Biểu đồ: Telli.sh, dựng từ các mục changelog của Deepgram ghi ngày từ 18 tháng 11 năm 2025 đến 10 tháng 8 năm 2026, và tài liệu Models & Languages Overview truy xuất ngày 31 tháng 8 năm 2026.
Ba mươi mốt ngôn ngữ hồi tháng 12, năm mươi tám vào tháng 8
Các nhà cung cấp nhận dạng giọng nói hiếm khi công bố độ phủ ngôn ngữ theo cách họ công bố độ chính xác. Nó xuất hiện trong release notes, mỗi lần một nhúm, và hiệu ứng tích lũy rất dễ bị bỏ sót trừ khi bạn quay lại cộng dồn. Nên chúng tôi đã cộng.
Bản phát hành 251118 của Deepgram, ngày 18 tháng 11 năm 2025, mở rộng hỗ trợ đơn ngữ của Nova-3 thêm 11 ngôn ngữ mới — Bulgaria, Séc, Phần Lan, Hindi, Hungary, Nhật, Hàn, Ba Lan, Nga, Ukraina và Việt. Bản 251210, ba tuần sau đó vào ngày 10 tháng 12 năm 2025, thêm 10 ngôn ngữ nữa trải khắp Nam Âu, vùng Baltic và Đông Nam Á: Hy Lạp, Romania, Slovakia, Catalan, Litva, Latvia, Estonia, Vlaams, Đức Thụy Sĩ và Mã Lai. Chính release note đó chứa câu hữu ích nhất trong toàn bộ câu chuyện này: “Nova-3 hiện hỗ trợ tổng cộng 31 ngôn ngữ.”
Từ đó, các bổ sung cứ tiếp tục. Bản 260129 ngày 29 tháng 1 năm 2026 thêm 12 ngôn ngữ nữa, trong đó có tiếng Belarus, tiếng Bengal, tiếng Bosnia và tiếng Croatia. Bản 260319 ngày 19 tháng 3 năm 2026 mang tới tiếng Thái và tiếng Quảng Đông. Bản 260430 ngày 30 tháng 4 năm 2026 thêm tiếng Gujarat. Rồi đến tháng 8: tiếng Punjab và tiếng Nepal ngày mùng 4, tiếng Armenia ngày mùng 7.
Cộng toàn bộ các bổ sung có tài liệu từ ngày 18 tháng 11 năm 2025 đến ngày 10 tháng 8 năm 2026, bạn được 39 ngôn ngữ trong chưa đầy chín tháng. Tức là khoảng bảy ngày một ngôn ngữ mới, đều đặn, chỉ từ một nhà cung cấp.
Có một chi tiết đáng chú ý, vì nó nói lên cách những bản phát hành này thực sự đến tay bạn. Changelog bản cloud ghi ngày thêm tiếng Punjab và tiếng Nepal là 4 tháng 8 năm 2026. Bản self-hosted đóng gói chính những mô hình đó, 260812, lại ghi ngày 12 tháng 8. Tám ngày trễ giữa API được lưu trữ sẵn và image container. Nếu bạn chạy Deepgram trên phần cứng của mình, chữ “được hỗ trợ” đến với bạn muộn hơn mọi người khác hơn một tuần.
“Được hỗ trợ” không phải một thứ — nó là ba câu hỏi
Giờ đến phần mà những con số tiêu đề che đi. Khi một nhà cung cấp nói một ngôn ngữ được hỗ trợ, cụm từ đó đang gánh ít nhất ba nhiệm vụ, và chúng liên tục rời nhau ra.
Bạn dùng được theo thời gian thực, hay chỉ sau khi đã ghi xong? Phiên âm batch và phiên âm streaming chạy trên các mô hình khác nhau với ràng buộc khác nhau. Mô hình streaming phải chốt từ trước khi nghe hết câu; mô hình batch có nguyên bản ghi. Nhà cung cấp phát hành chúng riêng, và không phải lúc nào cũng phát hành cùng lúc.
Mô hình đó thực sự tốt đến đâu? “Được hỗ trợ” chỉ cho bạn biết mã ngôn ngữ sẽ được chấp nhận, chứ không phải kết quả dùng được cho một cuộc họp hội đồng quản trị. Một ngôn ngữ vừa thêm tháng trước và một ngôn ngữ đã qua bốn vòng cải thiện đều nằm trong cùng một ô bảng.
Nó có trộn được với ngôn ngữ khác không? Đây là câu gần như không ai kiểm tra cho tới khi hỏng. Phiên âm một cuộc họp mà mọi người đều nói tiếng Nepal là một bài toán kỹ thuật khác hẳn phiên âm một cuộc họp mà người ta nhảy qua lại giữa tiếng Nepal và tiếng Anh ngay giữa câu — và bài toán thứ hai mới chỉ được giải cho ít ngôn ngữ hơn nhiều.
Chính changelog tháng 8 là minh họa sạch sẽ nhất cho câu hỏi thứ nhất mà chúng tôi từng thấy trong một năm qua. Mục ngày 7 tháng 8 cải thiện bốn thứ, và không cải thiện chúng đồng đều.
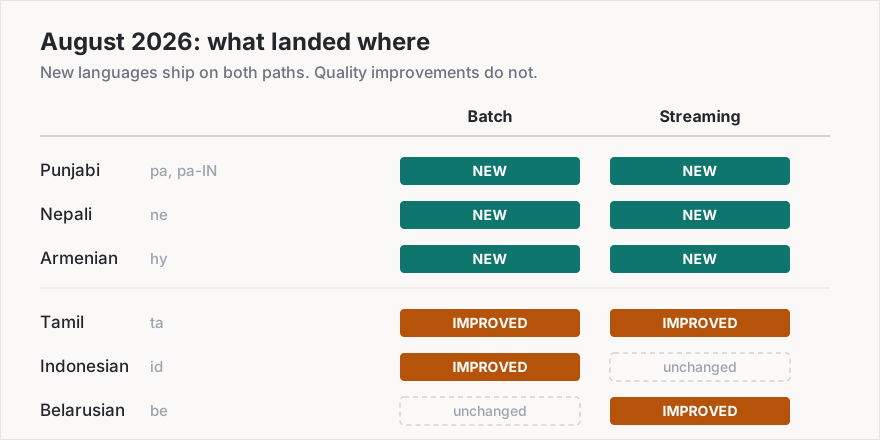
Biểu đồ: Telli.sh, từ các mục changelog của Deepgram ngày 4 và ngày 7 tháng 8 năm 2026.
Tiếng Punjab, tiếng Nepal và tiếng Armenia vào theo cả hai đường — Deepgram nói thẳng rằng “cả mô hình batch lẫn streaming đều có sẵn cho những ngôn ngữ này”. Tiếng Tamil được mô hình cải thiện ở cả batch và streaming. Tiếng Indonesia được mô hình batch cải thiện và không có gì mới cho streaming. Tiếng Belarus được mô hình streaming cải thiện và không có gì mới cho batch.
Nếu bạn đang phiên âm các cuộc phỏng vấn tiếng Indonesia đã ghi sẵn, ngày 7 tháng 8 là một ngày đẹp trời. Nếu bạn đang chạy họp trực tiếp bằng tiếng Indonesia, ngày 7 tháng 8 chẳng thay đổi gì. Cả hai sự thật nằm trong cùng một danh sách gạch đầu dòng, trong cùng một mục changelog, và không bản tóm tắt nào của mục đó nói cho bạn biết cái nào ứng với bạn.
Sự bất đối xứng ấy không phải cẩu thả. Nó phản ánh việc đây thật sự là những mô hình khác nhau, với ngân sách huấn luyện và kiểm định khác nhau — và đó là lập luận mạnh nhất cho việc đọc changelog của nhà cung cấp ở mức từng ngôn ngữ một, thay vì đọc tiêu đề.
Vách độ phủ: 58 ngôn ngữ, 10 cuộc trò chuyện
Giờ tới câu hỏi thứ ba, nơi khoảng trống thú vị nhất đang nằm.
Chế độ chuyển mã đa ngữ của Deepgram được bật bằng đúng một tham số, language=multi, và nó cho phép một request xử lý người nói nhảy qua lại giữa các ngôn ngữ ngay trong một câu. Nó thực sự hữu ích, và nó có trên Nova-2, Nova-3 và Flux Multilingual. Nó cũng hẹp hơn nhiều so với danh mục đơn ngữ.
Trên Nova-3, language=multi phủ đúng mười ngôn ngữ: Anh, Tây Ban Nha, Pháp, Đức, Hindi, Nga, Bồ Đào Nha, Nhật, Ý và Hà Lan. Trên Nova-2, cũng tham số ấy phủ hai — Tây Ban Nha và Anh.
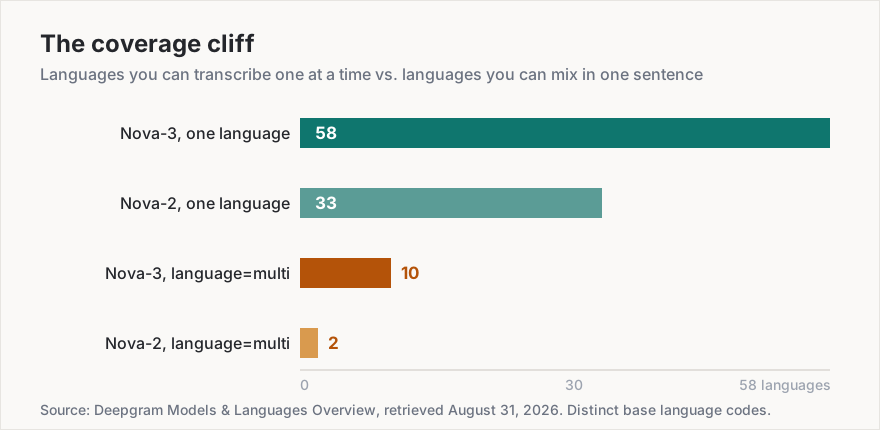
Biểu đồ: Telli.sh, từ tài liệu Deepgram Models & Languages Overview, truy xuất ngày 31 tháng 8 năm 2026. Số đếm là các mã ngôn ngữ gốc riêng biệt, không tính biến thể vùng miền và hệ chữ viết.
Cứ gọi đó là vách độ phủ: khoảng rơi giữa ngôn ngữ mà nhà cung cấp liệt kê và ngôn ngữ mà cuộc họp thật, lộn xộn, nửa tiếng Anh của bạn thực sự được xử lý. Năm mươi tám ngôn ngữ đứng trên đỉnh vách. Mười ngôn ngữ sống sót sau cú rơi.
Với 48 ngôn ngữ ở phía sai của vách — Punjab, Nepal, Armenia, Tamil, Bengal, Thái, Hàn, Việt, Mã Lai và phần còn lại — mô hình đơn ngữ chuyên biệt không đơn thuần là lựa chọn tốt hơn. Nó là lựa chọn duy nhất. Không có đường chuyển mã nào để đem ra so sánh.
Và đây là điểm mấu chốt, đi ngược lại trực giác rằng chế độ đa ngữ hẳn phải mạnh hơn: với phần lớn ngôn ngữ trên thế giới, mô hình đơn ngữ mới là lựa chọn cao cấp, chứ không phải phương án dự phòng. Một mô hình chuyên biệt được huấn luyện trên ngữ âm của một ngôn ngữ, phân bố từ vựng của một ngôn ngữ, cách đọc số và ngày tháng của một ngôn ngữ. Mô hình đa ngữ phải giữ mười hệ như vậy trong thế giằng co và quyết định, từng chữ một, nó đang nghe cái nào. Khi bạn đã biết cuộc họp diễn ra bằng tiếng Tamil, việc nói điều đó cho engine không phải là một giới hạn bạn chấp nhận — đó là cấu hình chính xác nhất mà bạn có.
language=multi (chuyển mã) | Mô hình ngôn ngữ chuyên biệt | |
|---|---|---|
| Độ phủ ngôn ngữ trên Nova-3 | 10 ngôn ngữ | 58 ngôn ngữ |
| Độ phủ ngôn ngữ trên Nova-2 | 2 ngôn ngữ (Tây Ban Nha + Anh) | 33 ngôn ngữ |
| Xử lý chuyển ngôn ngữ giữa câu | Có | Không — lời nói khác ngôn ngữ làm giảm chất lượng |
| Độ chính xác với một ngôn ngữ đã biết | Thấp hơn; mô hình phải phân xử giữa các ứng viên | Cao hơn; mô hình được chuyên biệt hóa |
| Keyterm prompting | Có trên Nova-3 Multi, tối đa 500 token (~100 từ), từ ngày 10 tháng 12 năm 2025 | Có |
| Thiết lập streaming được khuyến nghị | endpointing=100 theo hướng dẫn của Deepgram | Endpointing mặc định |
| Có cho tiếng Punjab, Nepal, Armenia, Tamil | Không | Có |
Cách đọc thực dụng của bảng trên: nếu cuộc họp của bạn thật sự trộn tiếng Anh và tiếng Tây Ban Nha theo từng câu, hãy dùng multi và chấp nhận đánh đổi độ chính xác. Nếu cuộc họp của bạn bằng tiếng Tamil với vài từ mượn tiếng Anh rải rác — vốn là bản chất của phần lớn cuộc họp “đa ngữ” — hãy đặt language=ta và để mô hình chuyên biệt làm việc của nó.
Ai thực sự có một cuộc họp tốt hơn trong tháng này
Đủ kiến trúc rồi. Sáu ngôn ngữ đổi trạng thái trong tháng 8 năm 2026, và đằng sau mỗi mã ngôn ngữ là một cộng đồng lâu nay vẫn phiên âm cuộc họp một cách tệ hại, hoặc không phiên âm gì cả.
| Ngôn ngữ | Mã | Người nói | Điều gì đã thay đổi trong tháng 8 năm 2026 |
|---|---|---|---|
| Tiếng Punjab | pa, pa-IN | ~125 triệu | Mới trên Nova-3, cả batch và streaming (4 tháng 8) |
| Tiếng Nepal | ne | ~16 triệu | Mới trên Nova-3, cả batch và streaming (4 tháng 8) |
| Tiếng Armenia | hy | ~6,7 triệu | Mới trên Nova-3, cả batch và streaming (7 tháng 8) |
| Tiếng Tamil | ta | ~75 triệu người bản ngữ | Mô hình cải thiện, cả batch và streaming (7 tháng 8) |
| Tiếng Indonesia | id | ~199 triệu tính cả người dùng như ngôn ngữ thứ hai | Chỉ cải thiện mô hình batch (7 tháng 8) |
| Tiếng Belarus | be | ~7,6 triệu | Chỉ cải thiện mô hình streaming (7 tháng 8) |
Số liệu người nói: thống kê Ethnologue được tổng hợp trên Wikidata (thuộc tính P1098), truy xuất ngày 31 tháng 8 năm 2026. Đã làm tròn.
Đó là khoảng 430 triệu người có ngôn ngữ được nhận dạng giọng nói tốt lên một cách đo đếm được chỉ trong một tuần, và khoảng 148 triệu trong số đó — những người nói tiếng Punjab, tiếng Nepal và tiếng Armenia — đi từ chỗ không có lựa chọn Nova-3 hạng nhất nào đến chỗ có nó trên cả batch lẫn streaming.
Hãy hình dung điều đó trong một căn phòng. Buổi standup của một đội kỹ thuật ở Chandigarh, trước đây hoặc phải nói bằng ngôn ngữ thứ hai cho vừa lòng công cụ, hoặc bị bỏ không phiên âm, giờ cho ra bản ghi theo thời gian thực. Buổi tổng kết hiện trường của một tổ chức phi chính phủ ở Kathmandu trở thành hồ sơ tìm kiếm được thay vì mấy trang ghi chép viết tay. Một lời khai pháp lý bằng tiếng Armenia có thể được phiên âm trực tiếp thay vì gửi đi gõ tay tính tiền theo phút.
Có một hiệu ứng bậc hai còn quan trọng hơn cả bản ghi. Một khi lời nói trong một ngôn ngữ trở nên máy đọc được theo thời gian thực, mọi thứ ở phía sau mở khóa cùng lúc: dịch trực tiếp cho người tham dự từ xa, tóm tắt tự động, trích xuất việc cần làm, tìm kiếm xuyên suốt cả năm họp hành. Nhận dạng giọng nói là nút thắt cổ chai. Mỗi ngôn ngữ vượt qua được nó sẽ thừa hưởng nguyên cả pipeline vốn được xây cho tiếng Anh.
Nếu bạn đang ở trong một đội mà ai đó theo thói quen chuyển sang tiếng Anh vì “công cụ không hỗ trợ tiếng của mình”, thì đây chính là bản cập nhật kết thúc sự thỏa hiệp đó.
Cách chọn thiết lập ngôn ngữ cho một cuộc họp đa ngữ
Những cải thiện của engine chỉ giúp được bạn nếu bạn cấu hình phiên làm việc cho đúng, mà mặc định thì thường sai với các đội đa ngữ. Năm bước, theo thứ tự:
- Xác định cuộc họp có một ngôn ngữ chủ đạo hay thực sự trộn lẫn. Vài từ mượn tiếng Anh rải rác trong cuộc họp tiếng Tamil vẫn là một ngôn ngữ. Luân phiên trọn câu giữa tiếng Tây Ban Nha và tiếng Anh mới là hai. Chỉ trường hợp thứ hai mới cần chuyển mã.
- Nếu chỉ có một ngôn ngữ, hãy khai báo ngôn ngữ đó tường minh. Dùng
model=nova-3với mã cụ thể —language=pacho tiếng Punjab,language=necho tiếng Nepal,language=hycho tiếng Armenia. Đừng để ở chế độ tự động nhận diện; bạn đã biết đáp án, và nói cho mô hình biết thì chẳng tốn gì. - Nếu thật sự trộn lẫn, hãy đối chiếu ngôn ngữ với danh sách mười. Chỉ đặt
language=multikhi mọi ngôn ngữ có mặt trong phòng đều nằm trong: Anh, Tây Ban Nha, Pháp, Đức, Hindi, Nga, Bồ Đào Nha, Nhật, Ý, Hà Lan. Nếu có ngôn ngữ nào không nằm trong đó,multisẽ không giúp gì, và mô hình ngôn ngữ chủ đạo là lựa chọn tốt nhất bạn có. - Với phiên trực tiếp dùng
multi, hãy đặtendpointing=100. Chính hướng dẫn chuyển mã của Deepgram khuyến nghị 100 ms riêng cho tình huống chuyển mã, thay vì giá trị mặc định cao hơn. Endpointing dài hơn khiến một cụm từ vừa chuyển ngôn ngữ bị hút vào nhầm phân đoạn. - Kiểm chứng batch và streaming riêng biệt trước khi hứa hẹn bất cứ điều gì. Như ngày 7 tháng 8 đã cho thấy, cải thiện ở bên này không phải là cải thiện ở bên kia. Chạy cùng một mẫu 10 phút qua cả hai đường rồi so sánh, thay vì mặc định rằng một mục changelog áp dụng cho đường của bạn.
Chúng tôi đã bàn một lát cắt khác của chủ đề này hồi tháng 6 — Deepgram's mid-year update on adaptive live sessions and diarization, bao gồm cả lệnh điều khiển UpdateListen cho phép một phiên đang chạy đổi gợi ý ngôn ngữ mà không cần kết nối lại. Bước 2 ở trên và khả năng đó ghép với nhau rất hợp: khai báo ngôn ngữ tường minh lúc bắt đầu, rồi chỉnh lại giữa cuộc họp nếu căn phòng thực sự đổi hướng.
Chốt lại: độ phủ đã thôi là một con số và trở thành một ma trận
Bản năng khi so sánh các engine giọng nói là đi tìm con số lớn nhất. Bộ tokenizer của Whisper (OpenAI) đã khai báo 100 token ngôn ngữ từ năm 2022 — gần gấp đôi con số 58 của Nova-3 — và phép so sánh đó gần như không nói lên điều gì, bởi Whisper không có đường streaming nguyên bản, và một token được khai báo không phải là một mô hình sản xuất đã được kiểm định. Nova-3 liệt kê ít ngôn ngữ hơn nhưng giao hàng thật: theo từng ngôn ngữ, theo từng chế độ, kèm bằng chứng có ghi ngày.
Con số mô tả độ phủ thật của một engine không phải là một phép đếm. Nó là một ma trận: ngôn ngữ × chế độ × mức chất lượng. Năm mươi tám ngôn ngữ, mỗi lần một. Mười trong số đó trộn được. Một ngôn ngữ cải thiện ở batch mà không ở streaming, một ngôn ngữ khác ở streaming mà không ở batch, trong cùng một bản phát hành, cùng một ngày.
Vậy câu hỏi nên mang tới lần đánh giá nhà cung cấp tiếp theo không phải là “các anh hỗ trợ bao nhiêu ngôn ngữ”. Mà là: với ngôn ngữ của tôi, trên đường xử lý của tôi, tính đến ngày nào?
Telli.sh nằm ở đâu trong chuyện này: tất cả những gì ở trên đều là chi tiết tầng engine, và chúng tôi cho rằng phần lớn các đội lẽ ra không cần phải biết chút nào. Telli.sh nằm trên tầng đó và ra những quyết định trong danh sách đánh số ở trên thay cho bạn — chọn mô hình chuyên biệt khi cuộc họp chỉ có một ngôn ngữ, giữ file tải lên và phiên trực tiếp đi đúng đường của chúng, và thừa hưởng các cải thiện engine như của tháng 8 ngay trong tuần chúng ra mắt thay vì đợi tới lần di chuyển hệ thống kế tiếp. Trên bản ghi lời nói, chúng tôi chạy dịch trực tiếp sang 44 ngôn ngữ đích và một giao diện 15 ngôn ngữ, nên người tham gia buổi standup tiếng Punjab của bạn từ Warsaw đọc nó bằng tiếng Ba Lan ngay khi nó đang diễn ra.
Bắt đầu một ghi chú cuộc họp có dịch trực tiếp
Nguồn tham khảo
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — tiếng Punjab (
pa,pa-IN) và tiếng Nepal (ne), có sẵn cả batch lẫn streaming - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — tiếng Armenia (
hy) mới; mô hình batch cải thiện cho tiếng Tamil và tiếng Indonesia; mô hình streaming cải thiện cho tiếng Tamil và tiếng Belarus - Deepgram Models & Languages Overview — bảng ngôn ngữ đầy đủ của Nova-3 và Nova-2 cùng danh sách ngôn ngữ
multi, truy xuất ngày 31 tháng 8 năm 2026 - Deepgram Multilingual Codeswitching guide — cách dùng
language=multivà khuyến nghịendpointing=100, truy xuất ngày 31 tháng 8 năm 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — “Nova-3 hiện hỗ trợ tổng cộng 31 ngôn ngữ”; keyterm prompting đa ngữ tối đa 500 token
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 ngôn ngữ mới, cùng mô hình nhận diện 36 ngôn ngữ
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 ngôn ngữ Nova-3 mới, gồm tiếng Belarus, Bengal, Bosnia, Croatia
- Deepgram Self-Hosted release 260319, March 19, 2026 — tiếng Thái và tiếng Quảng Đông
- Deepgram Self-Hosted release 260430, April 30, 2026 — tiếng Gujarat
- Deepgram Self-Hosted release 260812, August 12, 2026 — gói self-hosted của tiếng Nepal và tiếng Punjab, tám ngày sau mục changelog bản cloud
- OpenAI Whisper tokenizer language table — 100 token ngôn ngữ được khai báo, truy xuất ngày 31 tháng 8 năm 2026
- Wikidata property P1098 (number of speakers) — số người nói theo Ethnologue cho
pa,ne,hy,ta,id,be, truy xuất ngày 31 tháng 8 năm 2026 - Our June 2026 coverage of Deepgram's live-session and diarization updates </content>