Nova-3 получил в этом месяце 58-й язык. И только 10 из них работают в одном предложении.
4 августа 2026 года Deepgram добавил в Nova-3 панджаби и непальский, 7 августа — армянский, а также улучшил тамильский, индонезийский и белорусский. Девять месяцев назад модель покрывала 31 язык — сегодня в документации их 58. Но переключение языков внутри фразы по-прежнему работает ровно для 10, а августовский чейнджлог показывает: индонезийский улучшили в пакетном режиме, а белорусский — только в потоковом. Разбираем темп роста языкового покрытия в распознавании речи и то, что на самом деле прячется за словом «поддерживается».
4 августа 2026 года Deepgram добавил панджаби и непальский в свою модель распознавания речи Nova-3. Через три дня добавил армянский, а вместе с ним — улучшенные одноязычные модели для тамильского, индонезийского и белорусского.
Две записи в чейнджлоге, одиннадцать строк текста на двоих, ни одного пресс-релиза. И тем не менее для всех, кто проводит встречи на этих языках, это самое значимое событие месяца в распознавании речи.
Закономерность за этими записями важнее самих записей. В декабре 2025 года собственные release notes Deepgram указывали для Nova-3 31 язык. Если посчитать различные базовые языковые коды в Models & Languages Overview Deepgram сегодня, 31 августа 2026 года, получится 58. Это темп, в котором движется вся отрасль, и он тихо изменил то, чего вам стоит ожидать от расшифровки.
Для команд, выбирающих движок распознавания речи, число языков в заголовке — лишь отправная точка. Проверьте, когда стал доступен каждый язык, как обновлялась его модель и способна ли она обрабатывать переключение между языками в середине фразы. Августовские изменения наглядно показывают эти различия на примере встреч с носителями панджаби, непальского, армянского, тамильского, индонезийского или белорусского.
Коротко:
- 58 против 31. Документация Nova-3 показывала 31 язык на 10 декабря 2025 года и 58 различных базовых языковых кодов на 31 августа 2026 года — 39 языков добавлено в девяти датированных записях чейнджлога.
- Покрытие — не одно число. Режим переключения языков
language=multiу Deepgram покрывает ровно 10 языков (английский, испанский, французский, немецкий, хинди, русский, португальский, японский, итальянский, нидерландский). Остальные 48 — только по одному языку за раз.- Пакетный и потоковый режимы — разные продукты. Релиз от 7 августа улучшил тамильский в обоих, индонезийский — только в пакетном, белорусский — только в потоковом. Одна запись в чейнджлоге, три разных исхода.
- Одноязычная модель всё ещё выигрывает. Для 48 из 58 языков Nova-3 выделенная модель не просто лучше многоязычного режима — это единственный существующий вариант.
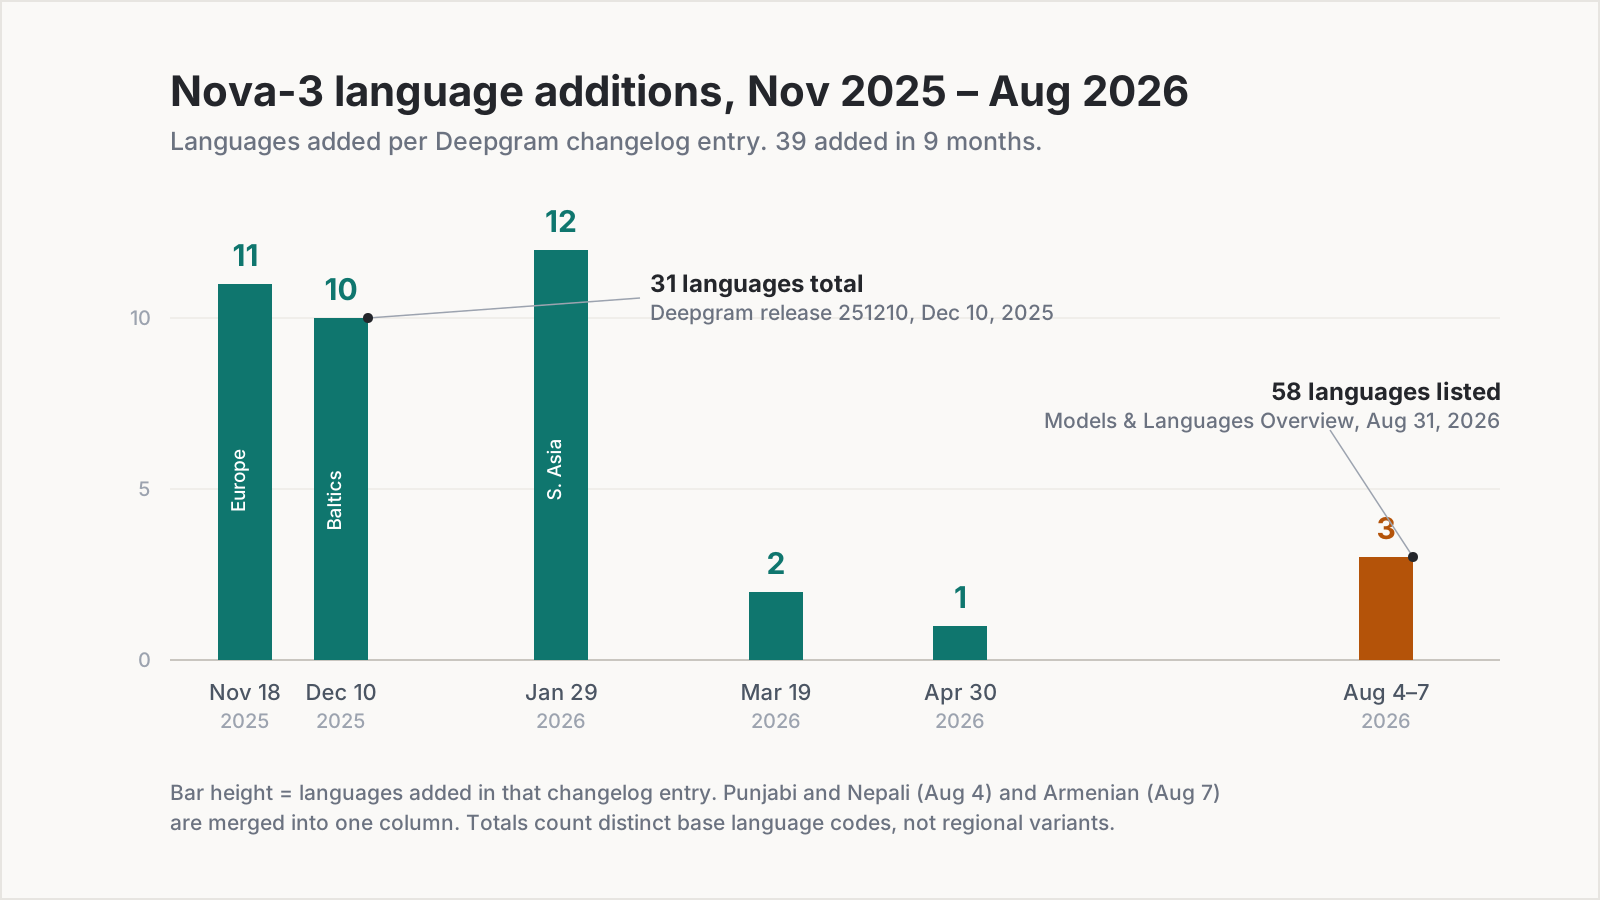
Диаграмма: Telli.sh, построена по записям чейнджлога Deepgram с 18 ноября 2025 года по 10 августа 2026 года и по Models & Languages Overview, полученному 31 августа 2026 года.
Тридцать один язык в декабре, пятьдесят восемь в августе
Поставщики распознавания речи часто добавляют языки в release notes небольшими порциями. Сопоставление датированных записей с текущей таблицей языков помогает увидеть совокупные изменения.
Релиз Deepgram 251118 от 18 ноября 2025 года расширил одноязычную поддержку Nova-3 на 11 новых языков — болгарский, чешский, финский, хинди, венгерский, японский, корейский, польский, русский, украинский и вьетнамский. Релиз 251210, три недели спустя, 10 декабря 2025 года, добавил ещё 10 языков Южной Европы, Балтии и Юго-Восточной Азии: греческий, румынский, словацкий, каталанский, литовский, латышский, эстонский, фламандский, швейцарский немецкий и малайский. В этих release notes есть самая полезная фраза во всей истории: «Nova-3 теперь поддерживает 31 язык».
Дальше добавления не прекращались. Релиз 260129 от 29 января 2026 года принёс ещё 12, включая белорусский, бенгальский, боснийский и хорватский. Релиз 260319 от 19 марта 2026 года — тайский и кантонский. Релиз 260430 от 30 апреля 2026 года — гуджарати. Затем август: панджаби и непальский 4-го, армянский 7-го.
Сложите задокументированные добавления с 18 ноября 2025 года по 10 августа 2026 года — получится 39 языков чуть менее чем за девять месяцев. Это примерно один новый язык каждые семь дней, без пауз, от одного поставщика.
Вот деталь, которую стоит заметить, потому что она говорит о том, как эти релизы доходят до вас на самом деле. Облачный чейнджлог датирует добавление панджаби и непальского 4 августа 2026 года. Self-hosted релиз с теми же моделями, 260812, датирован 12 августа. Восемь дней разрыва между размещённым API и образом контейнера. Если вы запускаете Deepgram на своём железе, «поддерживается» наступило больше чем на неделю позже, чем у всех остальных.
«Поддерживается» — это не одно, а три разных вопроса
Теперь то, что скрывают заголовочные числа. Когда поставщик говорит, что язык поддерживается, это одно слово выполняет как минимум три работы — и они постоянно расходятся.
Можно ли использовать язык в реальном времени или только постфактум? Пакетная и потоковая расшифровки работают на разных моделях с разными ограничениями. Потоковая модель обязана зафиксировать слова, ещё не услышав конца фразы; пакетная получает запись целиком. Поставщики выпускают их отдельно и далеко не всегда выпускают вместе.
Насколько модель хороша на самом деле? «Поддерживается» означает, что код языка примут, а не что результат годится для заседания совета директоров. Язык, добавленный месяц назад, и язык, прошедший четыре круга улучшений, стоят в одной и той же ячейке одной и той же таблицы.
Можно ли смешивать его с другим языком? Вот это почти никто не проверяет, пока не сломается. Расшифровать встречу, где все говорят на непальском, — техническая задача, отличная от расшифровки встречи, где люди переключаются между непальским и английским в середине фразы, и вторая задача решена для куда меньшего числа языков.
Чейнджлог от 7 августа показывает, почему поддержку пакетного и потокового режимов нужно проверять отдельно: улучшения применялись к ним неодинаково.
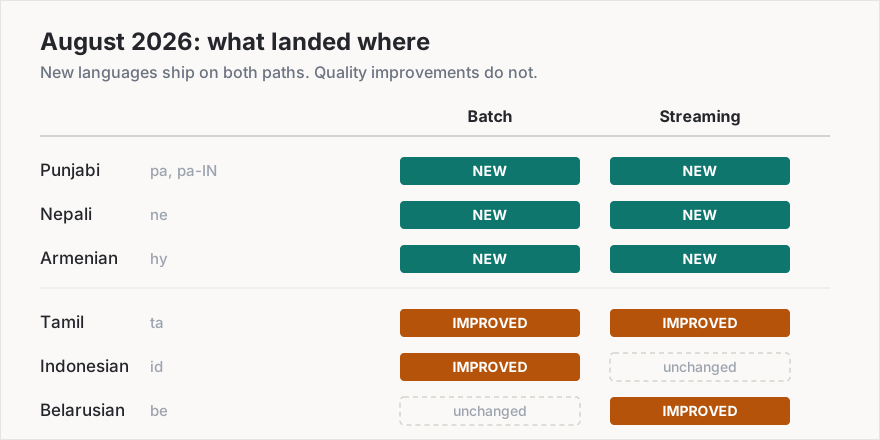
Диаграмма: Telli.sh, по записям чейнджлога Deepgram от 4 и 7 августа 2026 года.
Панджаби, непальский и армянский пришли по обоим путям — Deepgram прямо пишет, что «для этих языков доступны и пакетные, и потоковые модели». Тамильский получил улучшенную модель и в пакетном, и в потоковом режиме. Индонезийский получил улучшенную пакетную модель и ничего нового для потоковой. Белорусский получил улучшенную потоковую модель и ничего нового для пакетной.
Если вы расшифровываете записанные интервью на индонезийском, 7 августа был для вас хорошим днём. Если вы проводите живые встречи на индонезийском, 7 августа не изменило ничего. Оба факта живут внутри одного маркированного списка в одной записи чейнджлога, и никакой пересказ этой записи не скажет вам, какой из них про вас.
Пакетный и потоковый режимы используют отдельные модельные пути и обновляются отдельно. Проверяйте конкретный язык и режим в чейнджлоге, не предполагая, что улучшение относится к обоим.
Обрыв покрытия: 58 языков, 10 разговоров
Теперь третий вопрос — там и лежит самый интересный разрыв.
Многоязычный режим переключения языков у Deepgram включается одним параметром, language=multi, и позволяет одному запросу обрабатывать говорящих, которые меняют язык внутри фразы. Он по-настоящему полезен и доступен в Nova-2, Nova-3 и Flux Multilingual. Он же заметно уже одноязычного каталога.
В Nova-3 language=multi покрывает ровно десять языков: английский, испанский, французский, немецкий, хинди, русский, португальский, японский, итальянский и нидерландский. В Nova-2 тот же параметр покрывает два — испанский и английский.
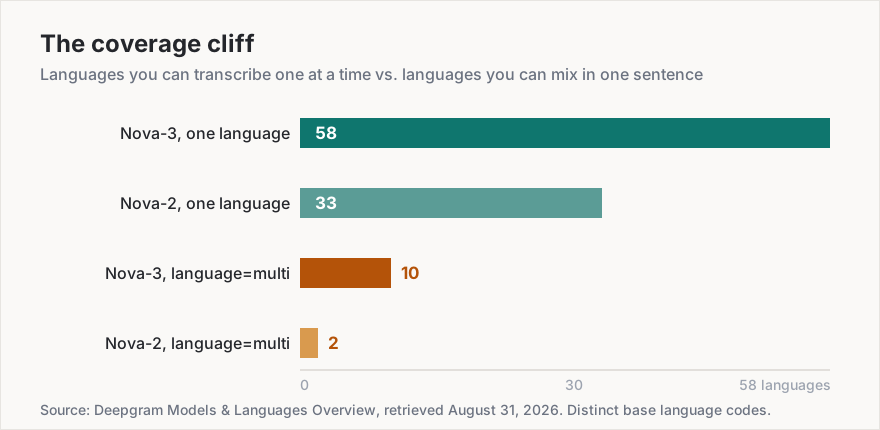
Диаграмма: Telli.sh, по Deepgram Models & Languages Overview, полученному 31 августа 2026 года. Подсчёт по различным базовым языковым кодам, без региональных вариантов и вариантов письменности.
Назовём это обрывом покрытия: перепад между языком, который поставщик перечисляет в списке, и языком, на котором обрабатывается ваша настоящая, сумбурная, наполовину английская встреча. На вершине обрыва стоят пятьдесят восемь языков. Падение переживают десять.
Для 48 языков не с той стороны — панджаби, непальского, армянского, тамильского, бенгальского, тайского, корейского, вьетнамского, малайского и прочих — выделенная одноязычная модель не просто лучший выбор. Это единственный выбор. Сравнивать её попросту не с чем: пути с переключением языков не существует.
Вот в чём суть, и она идёт вразрез с интуицией, будто многоязычный режим строго мощнее: для большинства языков мира одноязычная модель — это продвинутый вариант, а не запасной. Выделенная модель обучена на фонетике одного языка, на распределении лексики одного языка, на числах и датах одного языка. Многоязычной модели приходится удерживать десять таких систем в напряжении и решать пословно, какую из них она слышит. Когда вы знаете, что встреча идёт на тамильском, сказать об этом движку — не ограничение, с которым вы миритесь, а самая точная конфигурация из доступных вам.
language=multi (переключение языков) | Выделенная языковая модель | |
|---|---|---|
| Покрытие языков в Nova-3 | 10 языков | 58 языков |
| Покрытие языков в Nova-2 | 2 языка (испанский + английский) | 33 языка |
| Переключение внутри фразы | Да | Нет — иноязычная речь ухудшает результат |
| Точность на одном известном языке | Ниже; модель выбирает между кандидатами | Выше; модель специализирована |
| Keyterm prompting | Да в Nova-3 Multi, до 500 токенов (~100 слов), с 10 декабря 2025 года | Да |
| Рекомендуемая настройка для потока | endpointing=100 согласно руководству Deepgram | Endpointing по умолчанию |
| Доступно для панджаби, непальского, армянского, тамильского | Нет | Да |
Практическое прочтение таблицы: если ваша встреча действительно чередует английский и испанский фраза за фразой, используйте multi и примите потерю в точности. Если встреча идёт на тамильском с редкими английскими заимствованиями — а именно так выглядит большинство «многоязычных» встреч, — задайте language=ta и дайте выделенной модели сделать свою работу.
Кому в этом месяце действительно достанется встреча получше
Хватит архитектуры. В августе 2026 года шесть языков сменили статус, и за каждым кодом стоит население, которое расшифровывало встречи плохо — или не расшифровывало вовсе.
| Язык | Код | Носители | Что изменилось в августе 2026 года |
|---|---|---|---|
| Панджаби | pa, pa-IN | ~125 млн | Новый в Nova-3, пакетный и потоковый режимы (4 авг.) |
| Непальский | ne | ~16 млн | Новый в Nova-3, пакетный и потоковый режимы (4 авг.) |
| Армянский | hy | ~6,7 млн | Новый в Nova-3, пакетный и потоковый режимы (7 авг.) |
| Тамильский | ta | ~75 млн носителей как родного | Улучшенная модель, пакетный и потоковый режимы (7 авг.) |
| Индонезийский | id | ~199 млн вместе со вторым языком | Улучшена только пакетная модель (7 авг.) |
| Белорусский | be | ~7,6 млн | Улучшена только потоковая модель (7 авг.) |
Данные по числу носителей: оценки Ethnologue в агрегации Wikidata (свойство P1098), получены 31 августа 2026 года. Округлено.
По приведённым оценкам, на эти шесть языков приходится около 430 млн носителей. Для панджаби, непальского и армянского появилась новая поддержка Nova-3 в пакетном и потоковом режимах; для тамильского, индонезийского и белорусского улучшения затронули конкретные режимы, перечисленные выше.
Подумайте, что это значит внутри переговорки. Стендап инженерной команды в Чандигархе, который раньше либо вели на втором языке в угоду инструменту, либо оставляли без расшифровки, теперь даёт транскрипт в реальном времени. Полевой разбор НКО в Катманду становится записью с поиском вместо чьих-то рукописных заметок. Юридический допрос на армянском можно расшифровывать вживую, а не отправлять на ручную расшифровку по поминутному тарифу.
Есть эффект второго порядка, который важнее самого транскрипта. Как только речь на языке становится машиночитаемой в реальном времени, всё, что идёт дальше, открывается разом: живой перевод для удалённых участников, автоматические резюме, извлечённые задачи, поиск по встречам за год. Распознавание речи — узкое горлышко. Каждый язык, который его проходит, наследует весь конвейер, построенный для английского.
Если вы в команде, где кто-то по привычке переходит на английский, потому что «инструмент не умеет наш язык», — это то обновление, которое кладёт конец конкретно этому компромиссу.
Как выбрать языковую настройку для многоязычной встречи
Улучшения движка помогут, только если вы правильно настроите сессию, а значения по умолчанию для многоязычных команд часто неверны. Пять шагов по порядку:
- Определите, есть ли у встречи один доминирующий язык или она действительно смешанная. Редкие английские заимствования на тамильской встрече — это один язык. Чередование целых фраз между испанским и английским — два. Переключение языков нужно только во втором случае.
- Если язык один, задайте его явно. Используйте
model=nova-3с конкретным кодом —language=paдля панджаби,language=neдля непальского,language=hyдля армянского. Не оставляйте автоопределение: ответ вы и так знаете, а сообщить его модели ничего не стоит. - Если смешение настоящее, сверьте языки со списком из десяти. Ставьте
language=multi, только если каждый язык в комнате есть среди английского, испанского, французского, немецкого, хинди, русского, португальского, японского, итальянского и нидерландского. Если какого-то нет,multiвам не поможет, и модель доминирующего языка — ваш лучший доступный вариант. - Для живых сессий с
multiзадайтеendpointing=100. Собственное руководство Deepgram по переключению языков рекомендует именно 100 мс для code-switching, против более высокого значения по умолчанию. Более длинный endpointing позволяет фразе на другом языке уехать не в тот сегмент. - Проверяйте пакетный и потоковый режимы по отдельности, прежде чем что-то обещать. Как показало 7 августа, улучшение одного не означает улучшения другого. Прогоните один и тот же 10-минутный фрагмент по обоим путям и сравните, а не исходите из того, что запись в чейнджлоге относится к вашему пути.
Другой срез этой темы мы разбирали в июне — обновления Deepgram середины года про адаптивные живые сессии и диаризацию, включая управляющее сообщение UpdateListen, которое позволяет идущей сессии менять языковые подсказки без переподключения. Шаг 2 выше и эта возможность хорошо складываются: задайте язык явно в начале и скорректируйте его посреди встречи, если комната действительно переключилась.
Итог: покрытие перестало быть числом и стало матрицей
При сравнении речевых движков инстинкт велит искать число побольше. Токенизатор Whisper от OpenAI объявляет 100 языковых токенов с 2022 года — почти вдвое больше, чем 58 у Nova-3, — и это сравнение не говорит почти ни о чём, потому что у Whisper нет нативного потокового пути, а объявленный токен — не проверенная продакшен-модель. Nova-3 перечисляет меньше языков и поставляет их — по языку, по режиму, с датированными подтверждениями.
Число, описывающее реальное покрытие движка, — вовсе не число. Это матрица: язык × режим × уровень качества. Пятьдесят восемь языков по одному за раз. Десять из них смешиваемых. Один язык улучшен в пакетном режиме и не улучшен в потоковом, другой — в потоковом и не в пакетном, в одном релизе, в один день.
Так что вопрос, который стоит приносить на следующую оценку поставщика, — не «сколько языков вы поддерживаете». Он звучит так: для моего языка, на моём пути, по состоянию на какую дату?
Где здесь Telli.sh: всё вышесказанное — детали уровня движка, и мы считаем, что большинству команд знать их не нужно. Telli.sh находится над этим слоем и принимает решения из нумерованного списка выше за вас — выбирает выделенную модель, когда у встречи один язык, держит пакетные загрузки и живые сессии на их правильных путях и наследует улучшения движка вроде августовских на той же неделе, когда они выходят, а не к вашей следующей миграции. Поверх транскрипта мы даём живой перевод на 44 целевых языка и интерфейс на 15 языках, так что человек, подключившийся к вашему стендапу на панджаби из Варшавы, читает его по-польски прямо по ходу дела.
Начать заметку встречи с живым переводом
Источники
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — панджаби (
pa,pa-IN) и непальский (ne), доступны и пакетный, и потоковый режимы - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — новый армянский (
hy); улучшенные пакетные модели для тамильского и индонезийского; улучшенные потоковые модели для тамильского и белорусского - Deepgram Models & Languages Overview — полные языковые таблицы Nova-3 и Nova-2 и список языков
multi, получено 31 августа 2026 года - Deepgram Multilingual Codeswitching guide — использование
language=multiи рекомендацияendpointing=100, получено 31 августа 2026 года - Deepgram Self-Hosted release 251210, December 10, 2025 — «Nova-3 теперь поддерживает 31 язык»; многоязычный keyterm prompting до 500 токенов
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 новых языков плюс модель определения языка на 36 языков
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 новых языков Nova-3, включая белорусский, бенгальский, боснийский, хорватский
- Deepgram Self-Hosted release 260319, March 19, 2026 — тайский и кантонский
- Deepgram Self-Hosted release 260430, April 30, 2026 — гуджарати
- Deepgram Self-Hosted release 260812, August 12, 2026 — self-hosted сборка с непальским и панджаби, через восемь дней после облачной записи
- OpenAI Whisper tokenizer language table — 100 объявленных языковых токенов, получено 31 августа 2026 года
- Wikidata property P1098 (number of speakers) — оценки числа носителей на основе Ethnologue для
pa,ne,hy,ta,id,be, получено 31 августа 2026 года - Our June 2026 coverage of Deepgram's live-session and diarization updates