Nova-3 menambah bahasa ke-58 bulan ini. Hanya 10 daripadanya berfungsi dalam ayat yang sama.
Pada 4 Ogos 2026 Deepgram menambah bahasa Punjabi dan Nepal pada Nova-3; pada 7 Ogos pula bahasa Armenia, serta penambahbaikan untuk Tamil, Indonesia dan Belarus. Sembilan bulan lalu model ini merangkumi 31 bahasa — hari ini dokumentasinya menyenaraikan 58. Namun code-switching masih berfungsi dalam tepat 10 bahasa sahaja, dan changelog Ogos sendiri menunjukkan bahasa Indonesia bertambah baik dalam batch manakala Belarus hanya bertambah baik dalam streaming. Satu tinjauan tentang kelajuan liputan bahasa dalam pengecaman pertuturan, dan apa yang sebenarnya disembunyikan oleh perkataan “disokong”.
Pada 4 Ogos 2026, Deepgram menambah bahasa Punjabi dan Nepal pada model pengecaman pertuturan Nova-3. Tiga hari kemudian ia menambah bahasa Armenia, berserta model ekabahasa yang diperbaik untuk bahasa Tamil, Indonesia dan Belarus.
Dua catatan changelog, sebelas baris teks kesemuanya, tanpa sebarang kenyataan akhbar. Namun bagi sesiapa yang mengendalikan mesyuarat dalam bahasa-bahasa itu, inilah perkara paling penting yang berlaku kepada pengecaman pertuturan bulan ini.
Corak di sebalik catatan itu lebih bernilai daripada catatan itu sendiri. Pada Disember 2025, nota keluaran Deepgram sendiri meletakkan Nova-3 pada 31 bahasa kesemuanya. Kiraan kod bahasa asas yang berlainan dalam Models & Languages Overview milik Deepgram hari ini, 31 Ogos 2026, memberikan angka 58. Itulah kelajuan yang sedang dilalui seluruh industri, dan ia telah mengubah secara senyap apa yang sepatutnya anda harapkan daripada sesebuah transkrip.
Tulisan ini melakukan tiga perkara. Ia meletakkan angka dan tarikh pada pengembangan tersebut menggunakan sumber utama. Ia menjelaskan mengapa bilangan bahasa yang dipaparkan pada tajuk hampir tidak berguna jika berdiri sendiri — dan tiga soalan apa yang perlu anda tanya sebagai gantinya. Dan ia menghuraikan apa yang berubah secara konkrit bagi mesyuarat yang disertai penutur bahasa Punjabi, Nepal, Armenia, Tamil atau Indonesia.
Ringkasan pantas:
- 58 berbanding 31. Dokumentasi Nova-3 menyenaraikan 31 bahasa kesemuanya pada 10 Disember 2025 dan 58 kod bahasa asas yang berlainan pada 31 Ogos 2026 — 39 bahasa ditambah menerusi sembilan catatan changelog bertarikh.
- Liputan bukan satu angka. Mod code-switching
language=multiDeepgram merangkumi tepat 10 bahasa (Inggeris, Sepanyol, Perancis, Jerman, Hindi, Rusia, Portugis, Jepun, Itali, Belanda). Baki 48 bahasa lagi hanya boleh satu bahasa pada satu masa.- Batch dan streaming ialah dua produk berasingan. Keluaran 7 Ogos memperbaik Tamil dalam kedua-duanya, bahasa Indonesia dalam batch sahaja, dan Belarus dalam streaming sahaja. Satu catatan changelog, tiga hasil berbeza.
- Ekabahasa masih menang. Bagi 48 daripada 58 bahasa Nova-3, model khusus bukan sekadar lebih baik daripada mod berbilang bahasa — ia satu-satunya pilihan yang wujud.
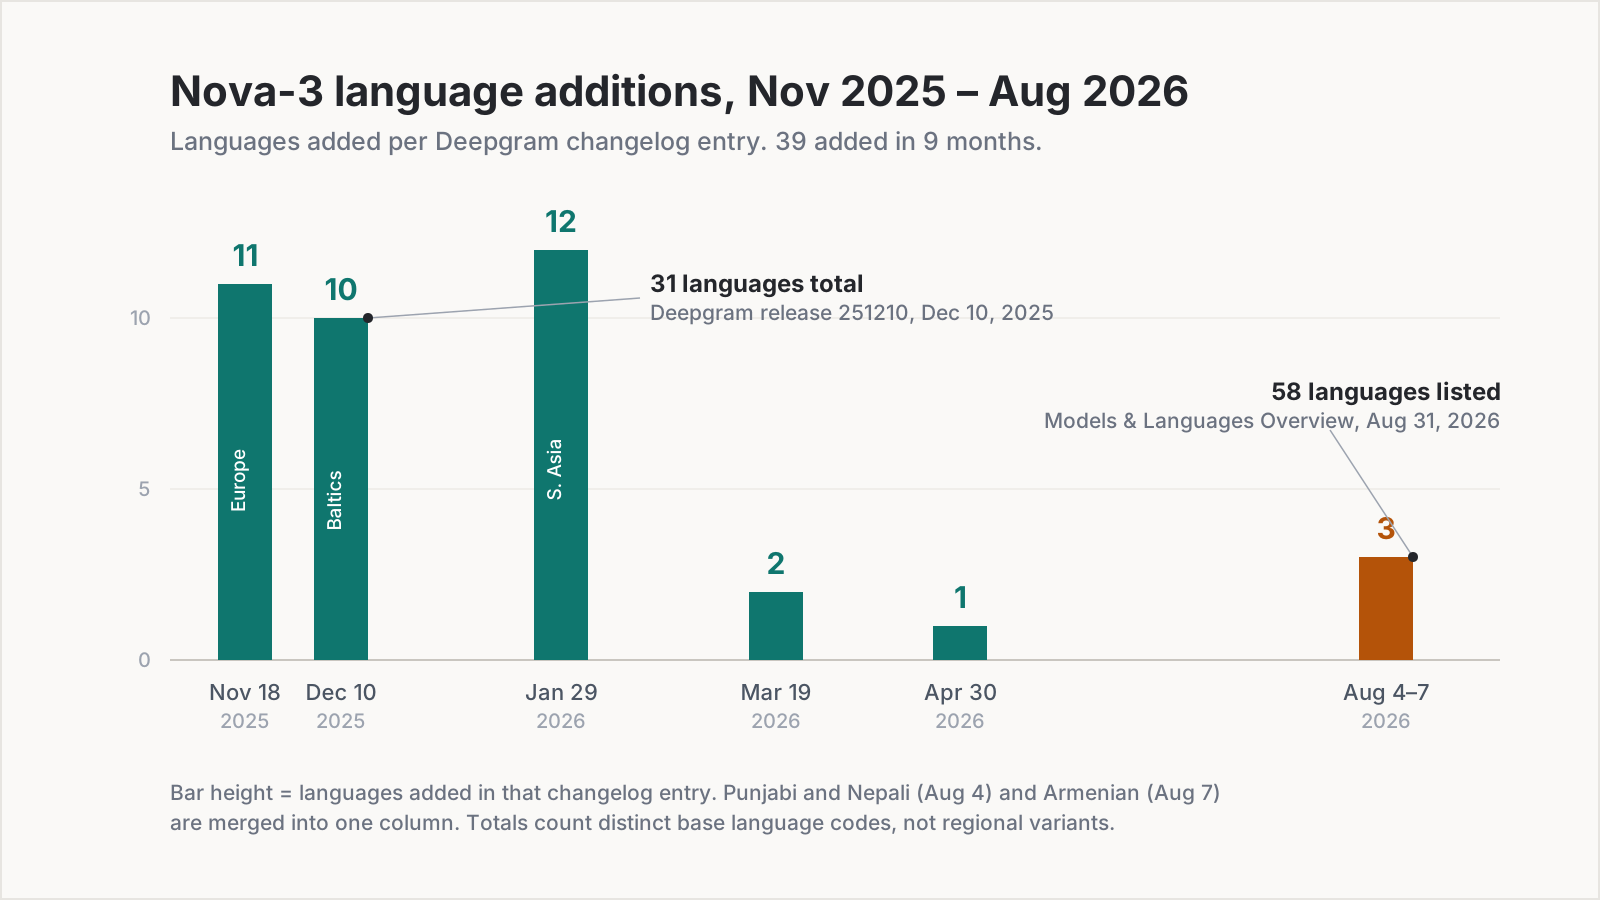
Carta: Telli.sh, disusun daripada catatan changelog Deepgram bertarikh 18 November 2025 hingga 10 Ogos 2026, serta Models & Languages Overview yang dicapai pada 31 Ogos 2026.
Tiga puluh satu bahasa pada Disember, lima puluh lapan pada Ogos
Vendor pengecaman pertuturan jarang mengumumkan liputan bahasa dengan cara yang sama seperti mereka mengumumkan ketepatan. Ia muncul dalam nota keluaran, beberapa bahasa pada satu masa, dan kesan terkumpulnya mudah terlepas pandang melainkan anda menoleh ke belakang dan menjumlahkannya. Jadi kami menjumlahkannya.
Keluaran Deepgram 251118, bertarikh 18 November 2025, meluaskan sokongan ekabahasa Nova-3 dengan 11 bahasa baharu — Bulgaria, Czech, Finland, Hindi, Hungary, Jepun, Korea, Poland, Rusia, Ukraine dan Vietnam. Keluaran 251210, tiga minggu kemudian pada 10 Disember 2025, menambah 10 lagi merentasi Eropah Selatan, negara Baltik dan Asia Tenggara: Yunani, Romania, Slovak, Catalan, Lithuania, Latvia, Estonia, Flemish, Jerman Swiss dan Melayu. Nota keluaran itu mengandungi satu ayat paling berguna dalam keseluruhan cerita ini: “Nova-3 kini menyokong 31 bahasa kesemuanya.”
Selepas itu penambahan terus berlaku. Keluaran 260129 pada 29 Januari 2026 menambah 12 lagi, termasuk Belarus, Bengali, Bosnia dan Croatia. Keluaran 260319 pada 19 Mac 2026 membawa bahasa Thai dan Kantonis. Keluaran 260430 pada 30 April 2026 menambah Gujarati. Kemudian Ogos: Punjabi dan Nepal pada 4 haribulan, Armenia pada 7 haribulan.
Campurkan semua penambahan yang berdokumen dari 18 November 2025 hingga 10 Ogos 2026 dan anda mendapat 39 bahasa dalam tempoh kurang sedikit daripada sembilan bulan. Itu lebih kurang satu bahasa baharu setiap tujuh hari, berterusan, daripada seorang vendor sahaja.
Ada satu butiran yang wajar diberi perhatian, kerana ia memberitahu anda bagaimana keluaran ini benar-benar sampai kepada anda. Changelog awan meletakkan tarikh 4 Ogos 2026 bagi penambahan Punjabi dan Nepal. Keluaran hos sendiri yang membungkus model yang sama, 260812, bertarikh 12 Ogos. Lapan hari jurang antara API terhos dengan imej bekas. Jika anda menjalankan Deepgram atas perkakasan sendiri, perkataan “disokong” tiba lebih seminggu lewat berbanding orang lain.
“Disokong” bukan satu perkara — ia tiga soalan
Kini bahagian yang disembunyikan oleh angka pada tajuk. Apabila seorang vendor berkata sesuatu bahasa disokong, satu perkataan itu sedang memikul sekurang-kurangnya tiga tugas, dan ketiga-tiganya kerap terpisah.
Bolehkah anda gunakannya secara masa nyata, atau selepas mesyuarat sahaja? Transkripsi batch dan transkripsi streaming menjalankan model berlainan dengan kekangan berlainan. Model streaming terpaksa memutuskan sesuatu perkataan sebelum mendengar penghujung ayat; model batch mendapat keseluruhan rakaman. Vendor menghantar kedua-duanya secara berasingan, dan mereka tidak semestinya menghantarnya serentak.
Sebaik mana sebenarnya model itu? Perkataan “disokong” hanya memberitahu anda bahawa sesuatu kod akan diterima, bukan bahawa keluarannya boleh dipakai untuk mesyuarat lembaga pengarah. Bahasa yang baharu ditambah bulan lepas dan bahasa yang sudah melalui empat pusingan penambahbaikan sama-sama tersenarai dalam sel jadual yang sama.
Bolehkah ia dicampur dengan bahasa lain? Inilah soalan yang hampir tiada siapa memeriksanya sehinggalah ia rosak. Mentranskripsikan mesyuarat yang semua orang bercakap bahasa Nepal adalah masalah teknikal yang berbeza daripada mentranskripsikan mesyuarat yang pesertanya bertukar antara Nepal dan Inggeris di tengah ayat, dan masalah kedua itu hanya terselesai untuk jauh lebih sedikit bahasa.
Changelog Ogos sendiri ialah gambaran paling jelas bagi soalan pertama yang kami lihat sepanjang setahun ini. Catatan 7 Ogos memperbaik empat perkara, dan ia tidak memperbaiknya secara sekata.
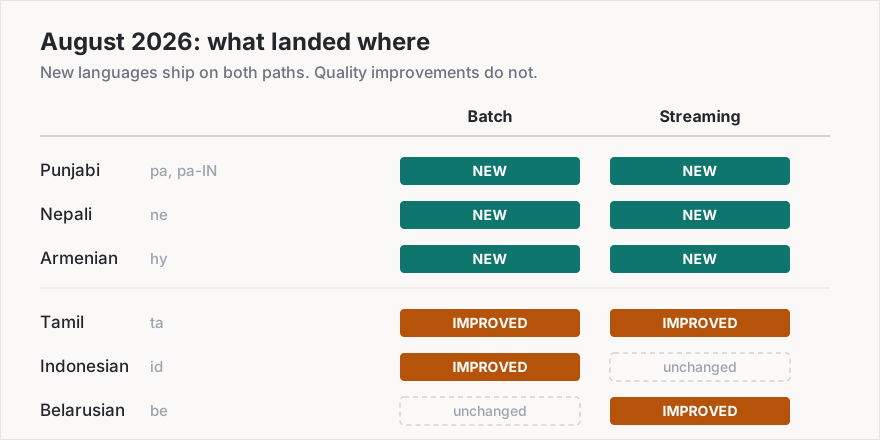
Carta: Telli.sh, daripada catatan changelog Deepgram bertarikh 4 dan 7 Ogos 2026.
Punjabi, Nepal dan Armenia tiba pada kedua-dua laluan — Deepgram menyatakan secara terus terang bahawa “model batch dan streaming kedua-duanya tersedia untuk bahasa-bahasa ini.” Tamil mendapat model yang diperbaik dalam batch dan streaming. Bahasa Indonesia mendapat model batch yang diperbaik dan tiada apa-apa yang baharu untuk streaming. Belarus mendapat model streaming yang diperbaik dan tiada apa-apa yang baharu untuk batch.
Jika anda mentranskripsikan rakaman temu bual dalam bahasa Indonesia, 7 Ogos ialah hari yang baik buat anda. Jika anda mengendalikan mesyuarat langsung dalam bahasa Indonesia, 7 Ogos tidak mengubah apa-apa. Kedua-dua fakta itu berada dalam satu senarai berbulet, dalam satu catatan changelog, dan tiada ringkasan catatan itu akan memberitahu anda yang mana satu terpakai kepada anda.
Ketidakseimbangan itu bukan kecuaian. Ia mencerminkan hakikat bahawa kedua-duanya memang model berlainan dengan peruntukan latihan dan pengesahan yang berlainan, dan itulah hujah tunggal terkuat untuk membaca changelog vendor pada peringkat setiap bahasa, bukan pada peringkat tajuk.
Tebing liputan: 58 bahasa, 10 perbualan
Kini soalan ketiga, dan di situlah jurang yang menarik itu berada.
Mod code-switching berbilang bahasa Deepgram diaktifkan dengan satu parameter sahaja, language=multi, dan ia membolehkan satu permintaan mengendalikan penutur yang bertukar bahasa di dalam satu ayat. Ia memang berguna, dan ia tersedia pada Nova-2, Nova-3 dan Flux Multilingual. Ia juga jauh lebih sempit daripada katalog ekabahasa.
Pada Nova-3, language=multi merangkumi tepat sepuluh bahasa: Inggeris, Sepanyol, Perancis, Jerman, Hindi, Rusia, Portugis, Jepun, Itali dan Belanda. Pada Nova-2, parameter yang sama merangkumi dua — Sepanyol dan Inggeris.
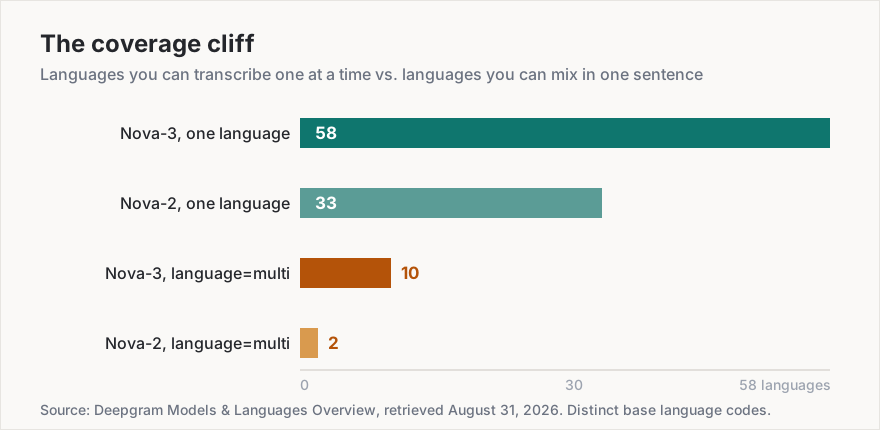
Carta: Telli.sh, daripada Deepgram Models & Languages Overview, dicapai pada 31 Ogos 2026. Kiraan menggunakan kod bahasa asas yang berlainan, tidak termasuk varian serantau dan varian tulisan.
Panggil ia tebing liputan: jurang antara bahasa yang disenaraikan oleh vendor dengan bahasa yang benar-benar dikendalikan dalam mesyuarat anda yang sebenar, bersepah dan separuh berbahasa Inggeris itu. Lima puluh lapan bahasa berdiri di atas tebing itu. Sepuluh daripadanya selamat sampai ke bawah.
Bagi 48 bahasa yang berada di sebelah yang salah — Punjabi, Nepal, Armenia, Tamil, Bengali, Thai, Korea, Vietnam, Melayu dan selebihnya — model ekabahasa khusus bukan sekadar pilihan yang lebih baik. Ia satu-satunya pilihan. Tiada laluan code-switching untuk dibandingkan dengannya.
Inilah intinya, dan ia bertentangan dengan gerak hati yang menganggap mod berbilang bahasa semestinya lebih berkemampuan: bagi kebanyakan bahasa di dunia, model ekabahasa ialah pilihan lanjutan, bukan pilihan sandaran. Model khusus dilatih pada fonetik satu bahasa, taburan perbendaharaan kata satu bahasa, angka dan tarikh satu bahasa. Model berbilang bahasa terpaksa memegang sepuluh perkara itu serentak dan memutuskan, perkataan demi perkataan, bahasa mana yang sedang didengarinya. Apabila anda tahu mesyuarat itu dalam bahasa Tamil, memberitahu enjin bukanlah satu batasan yang anda terima — ia konfigurasi paling tepat yang tersedia untuk anda.
language=multi (code-switching) | Model bahasa khusus | |
|---|---|---|
| Liputan bahasa Nova-3 | 10 bahasa | 58 bahasa |
| Liputan bahasa Nova-2 | 2 bahasa (Sepanyol + Inggeris) | 33 bahasa |
| Mengendalikan pertukaran di tengah ayat | Ya | Tidak — pertuturan di luar bahasa sasaran merosot |
| Ketepatan pada satu bahasa yang diketahui | Lebih rendah; model menimbang antara calon | Lebih tinggi; model dikhususkan |
| Keyterm prompting | Ya pada Nova-3 Multi, sehingga 500 token (~100 perkataan), sejak 10 Dis 2025 | Ya |
| Tetapan streaming yang disyorkan | endpointing=100 menurut panduan Deepgram | Endpointing lalai |
| Tersedia untuk Punjabi, Nepal, Armenia, Tamil | Tidak | Ya |
Bacaan praktikal jadual itu: jika mesyuarat anda benar-benar mencampurkan bahasa Inggeris dan Sepanyol ayat demi ayat, gunakan multi dan terima pertukaran ketepatannya. Jika mesyuarat anda dalam bahasa Tamil dengan sesekali kata pinjaman Inggeris — dan itulah rupa sebenar kebanyakan mesyuarat “berbilang bahasa” — tetapkan language=ta dan biarkan model khusus melakukan tugasnya.
Siapa yang benar-benar mendapat mesyuarat lebih baik bulan ini
Cukuplah tentang seni bina. Enam bahasa bertukar status pada Ogos 2026, dan di sebalik setiap kod itu ada populasi yang selama ini mentranskripsikan mesyuarat dengan teruk, atau tidak langsung.
| Bahasa | Kod | Penutur | Apa yang berubah pada Ogos 2026 |
|---|---|---|---|
| Punjabi | pa, pa-IN | ~125 juta | Baharu pada Nova-3, batch dan streaming (4 Ogos) |
| Nepal | ne | ~16 juta | Baharu pada Nova-3, batch dan streaming (4 Ogos) |
| Armenia | hy | ~6.7 juta | Baharu pada Nova-3, batch dan streaming (7 Ogos) |
| Tamil | ta | ~75 juta penutur asli | Model diperbaik, batch dan streaming (7 Ogos) |
| Indonesia | id | ~199 juta termasuk penutur bahasa kedua | Model batch sahaja yang diperbaik (7 Ogos) |
| Belarus | be | ~7.6 juta | Model streaming sahaja yang diperbaik (7 Ogos) |
Angka penutur: kiraan Ethnologue sebagaimana diagregat pada Wikidata (sifat P1098), dicapai pada 31 Ogos 2026. Dibundarkan.
Itu lebih kurang 430 juta orang yang bahasanya mendapat pengecaman pertuturan yang jelas lebih baik dalam masa seminggu, dan kira-kira 148 juta daripada mereka — penutur Punjabi, Nepal dan Armenia — beralih daripada langsung tiada pilihan Nova-3 kelas pertama kepada memilikinya pada batch dan streaming sekali gus.
Fikirkan apa maknanya di dalam sebuah bilik. Standup pasukan kejuruteraan di Chandigarh, yang sebelum ini sama ada dijalankan dalam bahasa kedua demi kepentingan perkakas atau dibiarkan tanpa transkrip, kini menghasilkan transkrip masa nyata. Taklimat lapangan sebuah NGO di Kathmandu menjadi rekod yang boleh dicari, bukan lagi catatan tulisan tangan seseorang. Pengambilan keterangan guaman dalam bahasa Armenia boleh ditranskripsikan secara langsung, bukan dihantar keluar untuk transkripsi manual pada kadar seminit.
Ada kesan susulan yang lebih penting daripada transkrip itu sendiri. Sebaik sahaja pertuturan dalam sesuatu bahasa boleh dibaca mesin secara masa nyata, semua yang di hiliran terbuka serentak: terjemahan langsung untuk peserta jarak jauh, ringkasan automatik, senarai tindakan yang diekstrak, carian merentasi setahun mesyuarat. Pengecaman pertuturan ialah peringkat yang menjadi sempadan botol. Setiap bahasa yang melepasinya mewarisi keseluruhan saluran kerja yang dibina untuk bahasa Inggeris.
Jika anda berada dalam pasukan yang seseorangnya lazim bertukar kepada bahasa Inggeris kerana “alat ini tidak menyokong bahasa kita”, inilah kemas kini yang menamatkan kompromi tersebut.
Cara memilih tetapan bahasa untuk mesyuarat berbilang bahasa
Penambahbaikan enjin hanya membantu jika anda mengkonfigurasi sesi dengan betul, dan tetapan lalai kerap tersilap untuk pasukan berbilang bahasa. Lima langkah, mengikut urutan:
- Pastikan dahulu sama ada mesyuarat mempunyai satu bahasa dominan atau benar-benar bercampur. Kata pinjaman Inggeris sesekali dalam mesyuarat berbahasa Tamil tetap satu bahasa. Bersilih ganti ayat penuh antara Sepanyol dan Inggeris bermakna dua. Hanya kes kedua memerlukan code-switching.
- Jika ia satu bahasa, tetapkan bahasa itu secara jelas. Gunakan
model=nova-3dengan kod khususnya —language=pauntuk Punjabi,language=neuntuk Nepal,language=hyuntuk Armenia. Jangan biarkan pada pengesanan automatik; anda sudah tahu jawapannya, dan memberitahu model itu tidak menelan sebarang kos. - Jika ia benar-benar bercampur, semak bahasa itu terhadap senarai sepuluh tadi. Tetapkan
language=multihanya jika setiap bahasa dalam bilik itu tersenarai dalam Inggeris, Sepanyol, Perancis, Jerman, Hindi, Rusia, Portugis, Jepun, Itali, Belanda. Jika ada satu pun yang tidak,multitidak akan membantu anda, dan model bahasa dominan ialah pilihan terbaik yang ada. - Untuk sesi langsung yang menggunakan
multi, tetapkanendpointing=100. Panduan code-switching Deepgram sendiri mengesyorkan 100 ms khusus untuk code-switching, berbanding nilai lalai yang lebih tinggi. Endpointing yang lebih panjang menyebabkan frasa dalam bahasa yang baru bertukar terserap ke dalam segmen yang salah. - Sahkan batch dan streaming secara berasingan sebelum anda menjanjikan apa-apa. Seperti yang ditunjukkan pada 7 Ogos, penambahbaikan pada satu bukanlah penambahbaikan pada satu lagi. Jalankan sampel 10 minit yang sama melalui kedua-dua laluan dan bandingkan, bukannya menganggap sesuatu catatan changelog terpakai kepada laluan anda.
Kami membincangkan sudut lain topik ini pada bulan Jun — kemas kini pertengahan tahun Deepgram tentang sesi langsung adaptif dan diarisasi, termasuk kawalan UpdateListen yang membolehkan sesi yang sedang berjalan menukar petunjuk bahasanya tanpa menyambung semula. Langkah 2 di atas dan keupayaan itu saling melengkapi: tetapkan bahasa secara jelas pada permulaan, dan laraskannya di tengah mesyuarat jika bilik itu benar-benar beralih.
Kesimpulannya: liputan bukan lagi satu nombor, ia sudah menjadi satu matriks
Naluri pertama ketika membandingkan enjin pertuturan ialah mencari nombor terbesar. Tokenizer Whisper milik OpenAI telah mengisytiharkan 100 token bahasa sejak 2022 — hampir dua kali ganda angka 58 milik Nova-3 — dan perbandingan itu hampir tidak memberitahu anda apa-apa, kerana Whisper tiada laluan streaming asli dan token yang diisytiharkan bukanlah model pengeluaran yang disahkan. Nova-3 menyenaraikan lebih sedikit bahasa tetapi benar-benar menghantarnya, setiap bahasa, setiap mod, dengan bukti bertarikh.
Nombor yang menggambarkan liputan sebenar sesebuah enjin bukanlah satu kiraan. Ia satu matriks: bahasa × mod × tahap kualiti. Lima puluh lapan bahasa satu demi satu. Sepuluh daripadanya boleh dicampur. Satu bahasa bertambah baik dalam batch tetapi tidak dalam streaming, satu lagi dalam streaming tetapi tidak dalam batch, dalam keluaran yang sama, pada hari yang sama.
Jadi soalan yang perlu anda bawa ke penilaian vendor seterusnya bukanlah “berapa banyak bahasa yang anda sokong.” Sebaliknya: untuk bahasa saya, pada laluan saya, setakat tarikh bila?
Di mana Telli.sh masuk: semua di atas ialah perincian lapisan enjin, dan kami berpendapat kebanyakan pasukan sepatutnya tidak perlu tahu satu pun daripadanya. Telli.sh duduk di atas lapisan itu dan membuat pilihan dalam senarai bernombor di atas bagi pihak anda — memilih model khusus apabila mesyuarat hanya menggunakan satu bahasa, mengekalkan muat naik batch dan sesi langsung pada laluan masing-masing yang betul, serta mewarisi penambahbaikan enjin seperti yang berlaku pada Ogos dalam minggu ia dihantar, bukannya menunggu migrasi anda yang seterusnya. Di atas transkrip itu kami menjalankan terjemahan langsung ke dalam 44 bahasa sasaran dan antara muka dalam 15 bahasa, jadi rakan yang menyertai standup berbahasa Punjabi anda dari Warsaw membacanya dalam bahasa Poland sementara ia sedang berlangsung.
Mulakan nota mesyuarat dengan terjemahan langsung
Sumber
- Deepgram changelog, 4 Ogos 2026 — Nova-3 Model Update — Punjabi (
pa,pa-IN) dan Nepal (ne), batch dan streaming kedua-duanya tersedia - Deepgram changelog, 7 Ogos 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — Armenia (
hy) baharu; model batch yang diperbaik untuk Tamil dan Indonesia; model streaming yang diperbaik untuk Tamil dan Belarus - Deepgram Models & Languages Overview — jadual bahasa penuh Nova-3 dan Nova-2 serta senarai bahasa
multi, dicapai pada 31 Ogos 2026 - Deepgram Multilingual Codeswitching guide — penggunaan
language=multidan syorendpointing=100, dicapai pada 31 Ogos 2026 - Deepgram Self-Hosted release 251210, 10 Disember 2025 — “Nova-3 kini menyokong 31 bahasa kesemuanya”; keyterm prompting berbilang bahasa sehingga 500 token
- Deepgram Self-Hosted release 251118, 18 November 2025 — 11 bahasa baharu, serta model pengesanan 36 bahasa
- Deepgram Self-Hosted release 260129, 29 Januari 2026 — 12 bahasa Nova-3 baharu termasuk Belarus, Bengali, Bosnia, Croatia
- Deepgram Self-Hosted release 260319, 19 Mac 2026 — Thai dan Kantonis
- Deepgram Self-Hosted release 260430, 30 April 2026 — Gujarati
- Deepgram Self-Hosted release 260812, 12 Ogos 2026 — bungkusan hos sendiri untuk Nepal dan Punjabi, lapan hari selepas catatan awan
- Jadual bahasa tokenizer OpenAI Whisper — 100 token bahasa yang diisytiharkan, dicapai pada 31 Ogos 2026
- Sifat Wikidata P1098 (bilangan penutur) — kiraan penutur terbitan Ethnologue untuk
pa,ne,hy,ta,id,be, dicapai pada 31 Ogos 2026 - Liputan kami pada Jun 2026 tentang kemas kini sesi langsung dan diarisasi Deepgram