Nova-3 ha aggiunto la sua 58ª lingua questo mese. Solo 10 funzionano nella stessa frase.
Il 4 agosto 2026 Deepgram ha aggiunto punjabi e nepalese a Nova-3; il 7 agosto ha aggiunto l'armeno e migliorato tamil, indonesiano e bielorusso. Nove mesi fa il modello copriva 31 lingue — oggi la documentazione ne elenca 58. Ma il code-switching funziona in esattamente 10, e il changelog di agosto mostra l'indonesiano migliorato in batch mentre il bielorusso è migliorato solo in streaming. Uno sguardo al ritmo della copertura linguistica nel riconoscimento vocale e a ciò che la parola «supportata» sta davvero nascondendo.
Il 4 agosto 2026 Deepgram ha aggiunto il punjabi e il nepalese al suo modello di riconoscimento vocale Nova-3. Tre giorni dopo ha aggiunto l'armeno, insieme a modelli monolingui migliorati per tamil, indonesiano e bielorusso.
Due voci di changelog, undici righe di testo in tutto, nessun comunicato stampa. Eppure, per chi tiene riunioni in quelle lingue, è la cosa più importante successa al riconoscimento vocale questo mese.
Lo schema dietro quelle voci vale più delle voci stesse. A dicembre 2025 le release notes di Deepgram collocavano Nova-3 a 31 lingue totali. Contando oggi, 31 agosto 2026, i codici lingua di base distinti nel Models & Languages Overview di Deepgram si arriva a 58. È il ritmo a cui si muove tutto il settore, e ha cambiato in silenzio ciò che dovresti aspettarti da una trascrizione.
Questo articolo fa tre cose. Mette numeri e date su quell'espansione usando fonti primarie. Spiega perché un conteggio di lingue da titolo è quasi inutile da solo — e quali tre domande devi porre al suo posto. E ricostruisce che cosa cambiano concretamente le aggiunte di agosto per una riunione con persone che parlano punjabi, nepalese, armeno, tamil o indonesiano.
In breve:
- 58 contro 31. La documentazione di Nova-3 elencava 31 lingue totali il 10 dicembre 2025 e 58 codici lingua di base distinti il 31 agosto 2026 — 39 lingue aggiunte in nove voci di changelog datate.
- La copertura non è un solo numero. La modalità di code-switching
language=multidi Deepgram copre esattamente 10 lingue (inglese, spagnolo, francese, tedesco, hindi, russo, portoghese, giapponese, italiano, olandese). Le altre 48 funzionano solo una lingua alla volta.- Batch e streaming sono prodotti separati. La release del 7 agosto ha migliorato il tamil in entrambi, l'indonesiano solo in batch e il bielorusso solo in streaming. Stessa voce di changelog, tre esiti diversi.
- Il monolingue vince ancora. Per 48 delle 58 lingue di Nova-3 un modello dedicato non è soltanto migliore della modalità multilingue: è l'unica opzione esistente.
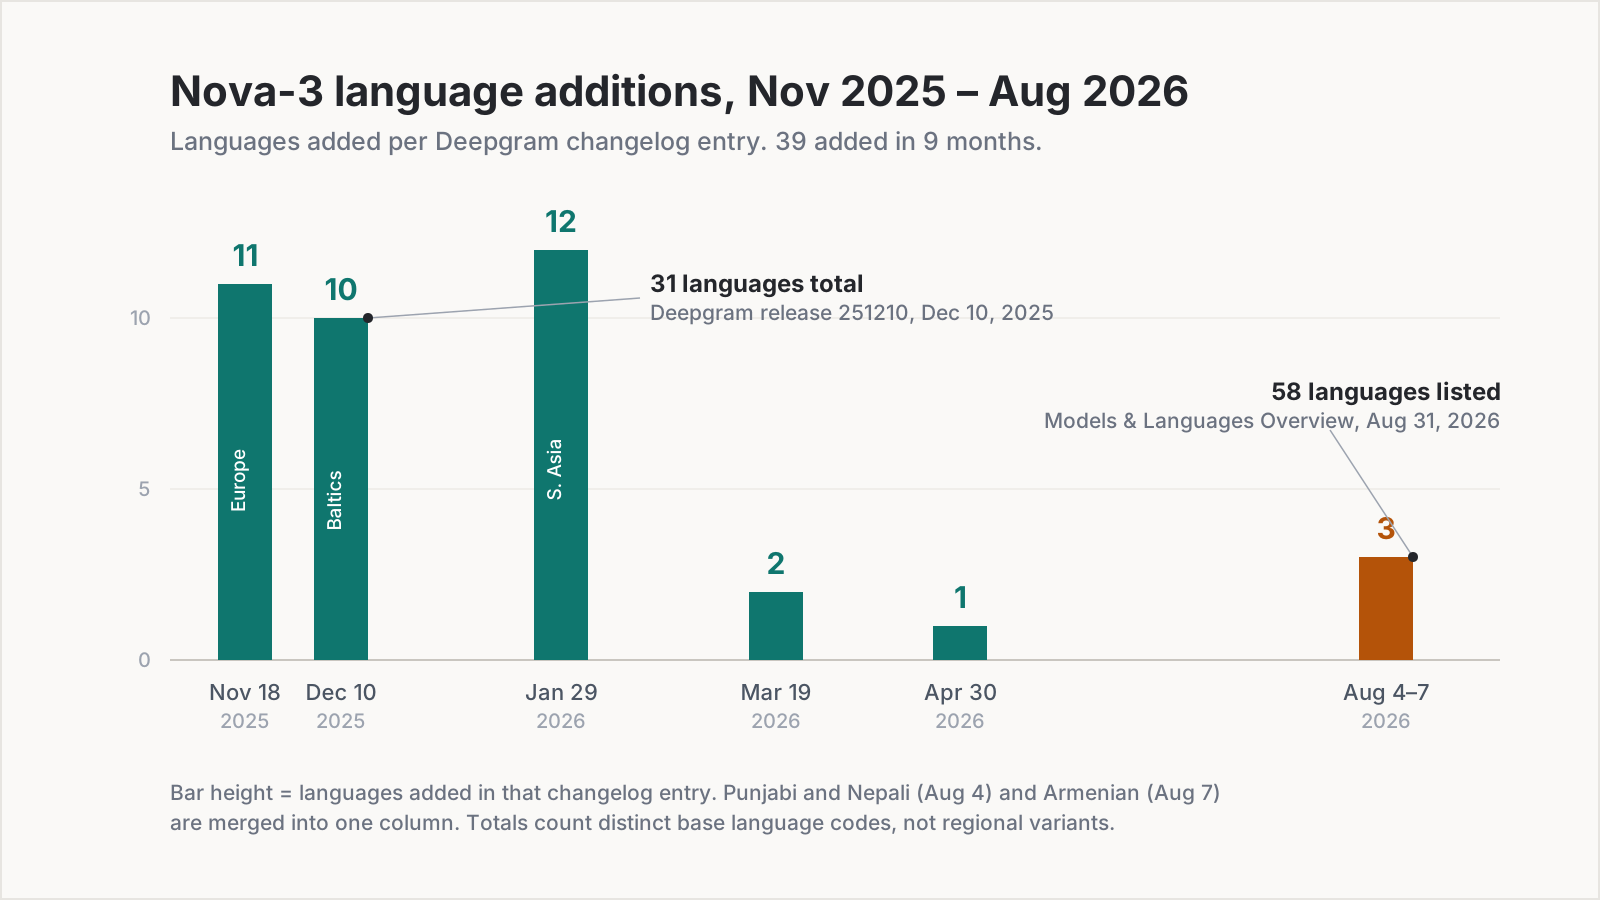
Grafico: Telli.sh, costruito dalle voci del changelog Deepgram datate dal 18 novembre 2025 al 10 agosto 2026 e dal Models & Languages Overview consultato il 31 agosto 2026.
Trentuno lingue a dicembre, cinquantotto ad agosto
I fornitori di riconoscimento vocale annunciano raramente la copertura linguistica come annunciano l'accuratezza. Arriva nelle release notes, una manciata alla volta, e l'effetto cumulativo è facile da perdere se non torni indietro a fare la somma. Così l'abbiamo fatta noi.
La release 251118 di Deepgram, datata 18 novembre 2025, ha esteso il supporto monolingue di Nova-3 con 11 nuove lingue: bulgaro, ceco, finlandese, hindi, ungherese, giapponese, coreano, polacco, russo, ucraino e vietnamita. La release 251210, tre settimane dopo, il 10 dicembre 2025, ne ha aggiunte altre 10 tra Europa meridionale, Baltico e Sud-est asiatico: greco, rumeno, slovacco, catalano, lituano, lettone, estone, fiammingo, tedesco svizzero e malese. Quella release note contiene la frase più utile di tutta questa storia: «Nova-3 ora supporta 31 lingue in totale».
Da lì le aggiunte non si sono fermate. La release 260129 del 29 gennaio 2026 ne ha aggiunte 12, tra cui bielorusso, bengalese, bosniaco e croato. La release 260319 del 19 marzo 2026 ha portato thai e cantonese. La release 260430 del 30 aprile 2026 ha aggiunto il gujarati. Poi agosto: punjabi e nepalese il giorno 4, armeno il giorno 7.
Somma le aggiunte documentate dal 18 novembre 2025 al 10 agosto 2026 e ottieni 39 lingue in poco meno di nove mesi. Sono circa una lingua nuova ogni sette giorni, in modo costante, da un solo fornitore.
C'è un dettaglio che vale la pena notare, perché dice qualcosa su come queste release ti raggiungono davvero. Il changelog cloud data l'aggiunta di punjabi e nepalese al 4 agosto 2026. La release self-hosted che impacchetta gli stessi modelli, la 260812, è datata 12 agosto. Otto giorni di ritardo tra l'API gestita e l'immagine del container. Se esegui Deepgram sul tuo hardware, «supportata» è arrivata più di una settimana dopo rispetto a tutti gli altri.
«Supportata» non è una cosa sola: sono tre domande
Ora la parte che i numeri da titolo nascondono. Quando un fornitore dice che una lingua è supportata, quella singola parola sta facendo almeno tre lavori, e si separano di continuo.
Puoi usarla in tempo reale o solo a posteriori? Trascrizione batch e trascrizione streaming usano modelli diversi con vincoli diversi. Un modello streaming deve impegnarsi sulle parole prima di aver sentito la fine della frase; un modello batch ha l'intera registrazione. I fornitori li rilasciano separatamente, e non sempre li rilasciano insieme.
Quanto è buono il modello, davvero? «Supportata» ti dice che un codice verrà accettato, non che l'output sia utilizzabile per un consiglio di amministrazione. Una lingua aggiunta il mese scorso e una lingua che ha ricevuto quattro cicli di miglioramento compaiono nella stessa cella della stessa tabella.
Può essere mescolata con un'altra lingua? Questa è quella che quasi nessuno controlla finché non si rompe. Trascrivere una riunione in cui tutti parlano nepalese è un problema tecnico diverso dal trascrivere una riunione in cui si passa dal nepalese all'inglese a metà frase, e il secondo problema è risolto per molte meno lingue.
Il changelog di agosto è l'illustrazione più pulita della prima domanda che abbiamo visto in un anno. La voce del 7 agosto ha migliorato quattro cose, e non le ha migliorate in modo uniforme.
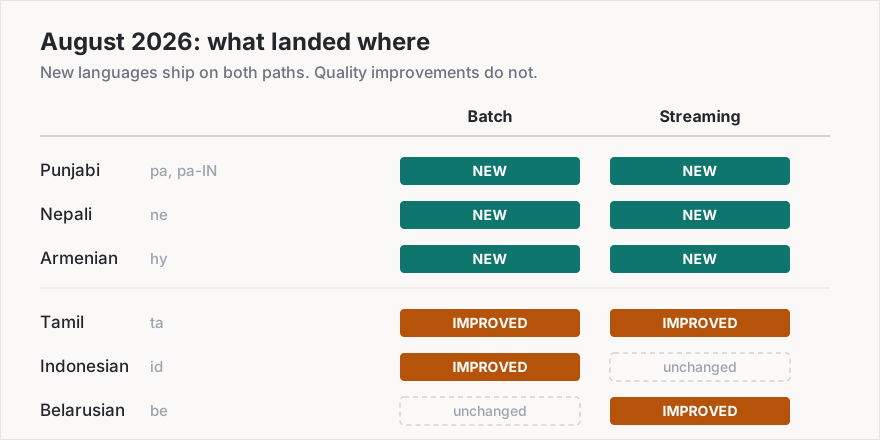
Grafico: Telli.sh, dalle voci del changelog Deepgram del 4 e del 7 agosto 2026.
Punjabi, nepalese e armeno sono arrivati su entrambi i percorsi — Deepgram afferma senza giri di parole che «i modelli batch e streaming sono entrambi disponibili per queste lingue». Il tamil ha ricevuto un modello migliorato sia in batch sia in streaming. L'indonesiano ha ricevuto un modello batch migliorato e nulla di nuovo per lo streaming. Il bielorusso ha ricevuto un modello streaming migliorato e nulla di nuovo per il batch.
Se trascrivi interviste registrate in indonesiano, il 7 agosto è stata una buona giornata per te. Se conduci riunioni dal vivo in indonesiano, il 7 agosto non ha cambiato nulla. Entrambi i fatti stanno dentro un unico elenco puntato di un'unica voce di changelog, e nessun riassunto di quella voce ti dirà quale dei due riguarda te.
Quell'asimmetria non è sciatteria. Riflette il fatto che si tratta davvero di modelli diversi, con budget di addestramento e validazione diversi, ed è l'argomento più forte per leggere i changelog dei fornitori al livello della singola lingua invece che del titolo.
Il dirupo della copertura: 58 lingue, 10 conversazioni
Passiamo alla terza domanda, dove sta il divario interessante.
La modalità multilingue di code-switching di Deepgram si attiva con un solo parametro, language=multi, e permette a una singola richiesta di gestire chi passa da una lingua all'altra dentro la stessa frase. È genuinamente utile ed è disponibile su Nova-2, Nova-3 e Flux Multilingual. Ed è anche molto più stretta del catalogo monolingue.
Su Nova-3 language=multi copre esattamente dieci lingue: inglese, spagnolo, francese, tedesco, hindi, russo, portoghese, giapponese, italiano e olandese. Su Nova-2 lo stesso parametro ne copre due: spagnolo e inglese.
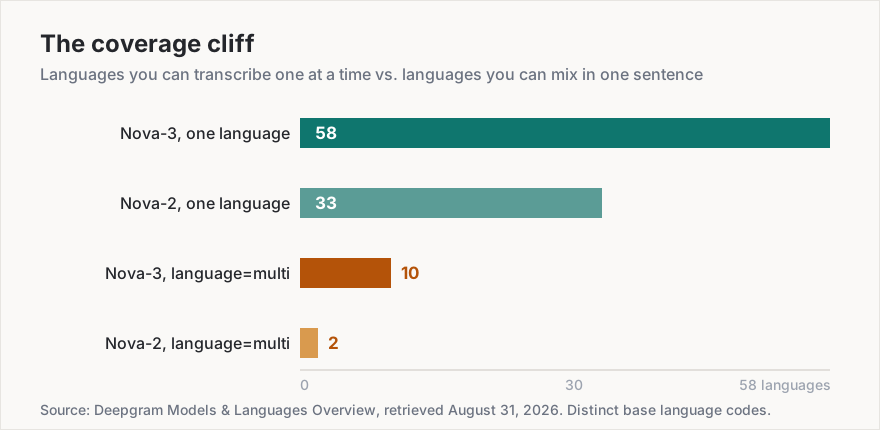
Grafico: Telli.sh, dal Models & Languages Overview di Deepgram, consultato il 31 agosto 2026. I conteggi sono di codici lingua di base distinti, esclusi varianti regionali e di scrittura.
Chiamiamolo il dirupo della copertura: il salto tra la lingua che un fornitore elenca e la lingua in cui la tua riunione vera, disordinata e mezza in inglese viene effettivamente gestita. Cinquantotto lingue stanno in cima a quel dirupo. Dieci sopravvivono alla caduta.
Per le 48 lingue sul lato sbagliato — punjabi, nepalese, armeno, tamil, bengalese, thai, coreano, vietnamita, malese e le altre — il modello monolingue dedicato non è semplicemente la scelta migliore. È l'unica scelta. Non esiste alcun percorso di code-switching con cui confrontarlo.
Ecco il punto, e va contro l'intuizione che una modalità multilingue sia in assoluto più capace: per la maggior parte delle lingue del mondo il modello monolingue è l'opzione avanzata, non il ripiego. Un modello dedicato è addestrato sulla fonetica di una lingua, sulla distribuzione lessicale di una lingua, sui numeri e sulle date di una lingua. Il modello multilingue deve tenerne dieci in tensione e decidere, parola per parola, quale sta sentendo. Quando sai che la riunione è in tamil, dirlo al motore non è un limite che accetti: è la configurazione più accurata a tua disposizione.
language=multi (code-switching) | Modello linguistico dedicato | |
|---|---|---|
| Copertura linguistica Nova-3 | 10 lingue | 58 lingue |
| Copertura linguistica Nova-2 | 2 lingue (spagnolo + inglese) | 33 lingue |
| Gestisce il cambio a metà frase | Sì | No — il parlato fuori lingua degrada |
| Accuratezza su una singola lingua nota | Più bassa; il modello arbitra tra i candidati | Più alta; il modello è specializzato |
| Keyterm prompting | Sì su Nova-3 Multi, fino a 500 token (~100 parole), dal 10 dic. 2025 | Sì |
| Impostazione streaming consigliata | endpointing=100 secondo la guida di Deepgram | Endpointing predefinito |
| Disponibile per punjabi, nepalese, armeno, tamil | No | Sì |
La lettura pratica di quella tabella: se la tua riunione mescola davvero inglese e spagnolo frase dopo frase, usa multi e accetta il calo di accuratezza. Se la tua riunione è in tamil con qualche prestito occasionale dall'inglese — che è ciò che sono in realtà quasi tutte le riunioni «multilingui» — imposta language=ta e lascia lavorare il modello dedicato.
Chi ottiene davvero riunioni migliori questo mese
Basta architettura. Sei lingue hanno cambiato stato ad agosto 2026, e dietro ogni codice c'è una popolazione che finora trascriveva male le proprie riunioni, o non le trascriveva affatto.
| Lingua | Codice | Parlanti | Cosa è cambiato ad agosto 2026 |
|---|---|---|---|
| Punjabi | pa, pa-IN | ~125 milioni | Nuova su Nova-3, batch e streaming (4 ago.) |
| Nepalese | ne | ~16 milioni | Nuova su Nova-3, batch e streaming (4 ago.) |
| Armeno | hy | ~6,7 milioni | Nuova su Nova-3, batch e streaming (7 ago.) |
| Tamil | ta | ~75 milioni madrelingua | Modello migliorato, batch e streaming (7 ago.) |
| Indonesiano | id | ~199 milioni incl. seconda lingua | Solo modello batch migliorato (7 ago.) |
| Bielorusso | be | ~7,6 milioni | Solo modello streaming migliorato (7 ago.) |
Dati sui parlanti: conteggi Ethnologue aggregati su Wikidata (proprietà P1098), consultati il 31 agosto 2026. Arrotondati.
Sono circa 430 milioni di persone la cui lingua ha ottenuto un riconoscimento vocale misurabilmente migliore nell'arco di una settimana, e circa 148 milioni di loro — chi parla punjabi, nepalese e armeno — sono passate dal non avere alcuna opzione Nova-3 di prima classe ad averne una sia in batch sia in streaming.
Pensa a che cosa significa dentro una stanza. Lo standup di un team di ingegneria a Chandigarh, prima condotto in una seconda lingua per comodità degli strumenti oppure lasciato senza trascrizione, ora produce una trascrizione in tempo reale. Il debriefing sul campo di una ONG a Kathmandu diventa un archivio ricercabile invece degli appunti a mano di qualcuno. Una deposizione legale in armeno può essere trascritta dal vivo invece di essere affidata a una trascrizione manuale pagata al minuto.
C'è un effetto di secondo ordine che conta più della trascrizione stessa. Nel momento in cui il parlato in una lingua diventa leggibile dalla macchina in tempo reale, tutto ciò che sta a valle si sblocca insieme: traduzione dal vivo per chi partecipa da remoto, riassunti automatici, azioni estratte, ricerca su un anno di riunioni. Il riconoscimento vocale è lo stadio collo di bottiglia. Ogni lingua che lo supera eredita l'intera pipeline costruita per l'inglese.
Se lavori in un team in cui qualcuno passa abitualmente all'inglese perché «lo strumento non fa la nostra lingua», questo è l'aggiornamento che chiude quel particolare compromesso.
Come scegliere l'impostazione della lingua per una riunione multilingue
I miglioramenti del motore servono solo se configuri correttamente la sessione, e i valori predefiniti sono spesso sbagliati per i team multilingui. Cinque passi, in ordine:
- Stabilisci se la riunione ha una lingua dominante o se mescola davvero. Qualche prestito occasionale dall'inglese in una riunione in tamil è una lingua. Alternare frasi intere tra spagnolo e inglese sono due. Solo il secondo caso ha bisogno del code-switching.
- Se è una sola lingua, impostala esplicitamente. Usa
model=nova-3con il codice specifico:language=paper il punjabi,language=neper il nepalese,language=hyper l'armeno. Non lasciarlo sul rilevamento automatico; la risposta la conosci già, e dirla al modello non costa nulla. - Se mescola davvero, confronta le lingue con l'elenco delle dieci. Imposta
language=multisolo se ogni lingua presente nella stanza compare tra inglese, spagnolo, francese, tedesco, hindi, russo, portoghese, giapponese, italiano e olandese. Se una manca,multinon ti aiuterà, e il modello della lingua dominante è la migliore opzione disponibile. - Per le sessioni dal vivo con
multi, impostaendpointing=100. La guida al code-switching di Deepgram raccomanda 100 ms proprio per il code-switching, contro il valore predefinito più alto. Un endpointing più lungo fa assorbire nel segmento sbagliato una frase pronunciata nell'altra lingua. - Verifica batch e streaming separatamente prima di promettere qualcosa. Come ha dimostrato il 7 agosto, un miglioramento su uno non è un miglioramento sull'altro. Fai passare lo stesso campione di 10 minuti su entrambi i percorsi e confronta, invece di dare per scontato che una voce di changelog riguardi il tuo percorso.
Abbiamo trattato un'altra fetta di questo tema a giugno — l'aggiornamento di metà anno di Deepgram su sessioni dal vivo adattive e diarizzazione, incluso il controllo UpdateListen che permette a una sessione in corso di cambiare i suoi suggerimenti di lingua senza riconnettersi. Il passo 2 qui sopra e quella funzione si combinano bene: imposta la lingua esplicitamente all'inizio e correggila a metà riunione se la stanza cambia davvero.
In conclusione: la copertura ha smesso di essere un numero ed è diventata una matrice
L'istinto, quando si confrontano i motori vocali, è cercare il numero più grande. Il tokenizer Whisper di OpenAI dichiara 100 token di lingua dal 2022 — quasi il doppio dei 58 di Nova-3 — e quel confronto non ti dice quasi nulla, perché Whisper non ha un percorso streaming nativo e un token dichiarato non è un modello validato in produzione. Nova-3 elenca meno lingue e le consegna, lingua per lingua, modalità per modalità, con prove datate.
Il numero che descrive la copertura reale di un motore non è un conteggio. È una matrice: lingua × modalità × livello di qualità. Cinquantotto lingue una alla volta. Dieci mescolabili. Una lingua migliorata in batch e non in streaming, un'altra in streaming e non in batch, nella stessa release, lo stesso giorno.
Quindi la domanda da portare alla prossima valutazione di un fornitore non è «quante lingue supportate». È: per la mia lingua, sul mio percorso, a quale data?
Dove si inserisce Telli.sh: tutto quanto sopra è dettaglio del livello motore, e pensiamo che la maggior parte dei team non debba conoscerne nulla. Telli.sh sta sopra quel livello e prende per te le decisioni dell'elenco numerato qui sopra: sceglie il modello dedicato quando la riunione ha una sola lingua, tiene i caricamenti batch e le sessioni dal vivo sui rispettivi percorsi corretti, ed eredita i miglioramenti del motore come quelli di agosto nella settimana in cui escono, non alla tua prossima migrazione. Sopra la trascrizione facciamo girare la traduzione dal vivo verso 44 lingue di destinazione e un'interfaccia in 15 lingue, così chi si collega da Varsavia al tuo standup in punjabi lo legge in polacco mentre accade.
Avvia una nota di riunione tradotta dal vivo
Fonti
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — punjabi (
pa,pa-IN) e nepalese (ne), disponibili sia in batch sia in streaming - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — armeno (
hy) nuovo; modelli batch migliorati per tamil e indonesiano; modelli streaming migliorati per tamil e bielorusso - Deepgram Models & Languages Overview — tabelle complete delle lingue Nova-3 e Nova-2 e l'elenco delle lingue
multi, consultato il 31 agosto 2026 - Deepgram Multilingual Codeswitching guide — uso di
language=multie la raccomandazioneendpointing=100, consultato il 31 agosto 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — «Nova-3 ora supporta 31 lingue in totale»; keyterm prompting multilingue fino a 500 token
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 nuove lingue, più il modello di rilevamento a 36 lingue
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 nuove lingue Nova-3 tra cui bielorusso, bengalese, bosniaco e croato
- Deepgram Self-Hosted release 260319, March 19, 2026 — thai e cantonese
- Deepgram Self-Hosted release 260430, April 30, 2026 — gujarati
- Deepgram Self-Hosted release 260812, August 12, 2026 — il bundle self-hosted di nepalese e punjabi, otto giorni dopo la voce cloud
- OpenAI Whisper tokenizer language table — 100 token di lingua dichiarati, consultato il 31 agosto 2026
- Wikidata property P1098 (number of speakers) — conteggi dei parlanti derivati da Ethnologue per
pa,ne,hy,ta,id,be, consultati il 31 agosto 2026 - La nostra copertura di giugno 2026 sugli aggiornamenti Deepgram per sessioni dal vivo e diarizzazione