Nova-3 menambahkan bahasa ke-58 bulan ini. Hanya 10 di antaranya yang bekerja dalam satu kalimat.
Pada 4 Agustus 2026 Deepgram menambahkan bahasa Punjabi dan Nepali ke Nova-3; pada 7 Agustus giliran bahasa Armenia, plus peningkatan untuk Tamil, Indonesia, dan Belarusia. Sembilan bulan lalu model ini mencakup 31 bahasa — hari ini dokumentasinya mencantumkan 58. Tetapi code-switching tetap hanya jalan di 10 bahasa, dan changelog Agustus sendiri menunjukkan bahasa Indonesia membaik di jalur batch sementara Belarusia hanya membaik di streaming. Menelusuri laju perluasan cakupan bahasa pada pengenalan suara, dan apa yang sebenarnya disembunyikan kata “didukung”.
Pada 4 Agustus 2026, Deepgram menambahkan bahasa Punjabi dan Nepali ke model pengenalan suara Nova-3. Tiga hari kemudian giliran bahasa Armenia, disertai model monolingual yang ditingkatkan untuk bahasa Tamil, Indonesia, dan Belarusia.
Dua entri changelog, sebelas baris teks di antara keduanya, tanpa satu pun siaran pers. Padahal, bagi siapa saja yang menjalankan rapat dalam bahasa-bahasa itu, inilah hal paling berdampak yang terjadi pada pengenalan suara bulan ini.
Pola di balik kedua entri itu jauh lebih berharga daripada entrinya sendiri. Pada Desember 2025, catatan rilis Deepgram sendiri menempatkan Nova-3 di angka 31 bahasa. Menghitung kode bahasa dasar yang berbeda di Models & Languages Overview milik Deepgram hari ini, 31 Agustus 2026, hasilnya 58. Itulah kecepatan yang sedang ditempuh seluruh industri, dan diam-diam hal itu sudah mengubah apa yang pantas Anda harapkan dari sebuah transkrip.
Tulisan ini mengerjakan tiga hal. Pertama, memberi angka dan tanggal pada perluasan tersebut memakai sumber primer. Kedua, menjelaskan mengapa jumlah bahasa di judul hampir tidak berguna kalau berdiri sendiri — dan tiga pertanyaan apa yang harus Anda ajukan sebagai gantinya. Ketiga, menguraikan apa yang secara konkret berubah bagi rapat yang diikuti penutur bahasa Punjabi, Nepali, Armenia, Tamil, atau Indonesia.
Ringkasan:
- 58 lawan 31. Dokumentasi Nova-3 mencantumkan 31 bahasa pada 10 Desember 2025 dan 58 kode bahasa dasar yang berbeda pada 31 Agustus 2026 — 39 bahasa bertambah lewat sembilan entri changelog bertanggal.
- Cakupan bukan satu angka. Mode code-switching
language=multimilik Deepgram mencakup tepat 10 bahasa (Inggris, Spanyol, Prancis, Jerman, Hindi, Rusia, Portugis, Jepang, Italia, Belanda). Sisanya, 48 bahasa, hanya bisa satu bahasa dalam satu waktu.- Batch dan streaming adalah dua produk terpisah. Rilis 7 Agustus meningkatkan Tamil di keduanya, bahasa Indonesia hanya di batch, dan Belarusia hanya di streaming. Satu entri changelog, tiga hasil berbeda.
- Monolingual tetap menang. Untuk 48 dari 58 bahasa Nova-3, model khusus bukan sekadar lebih baik daripada mode multibahasa — itu satu-satunya pilihan yang ada.
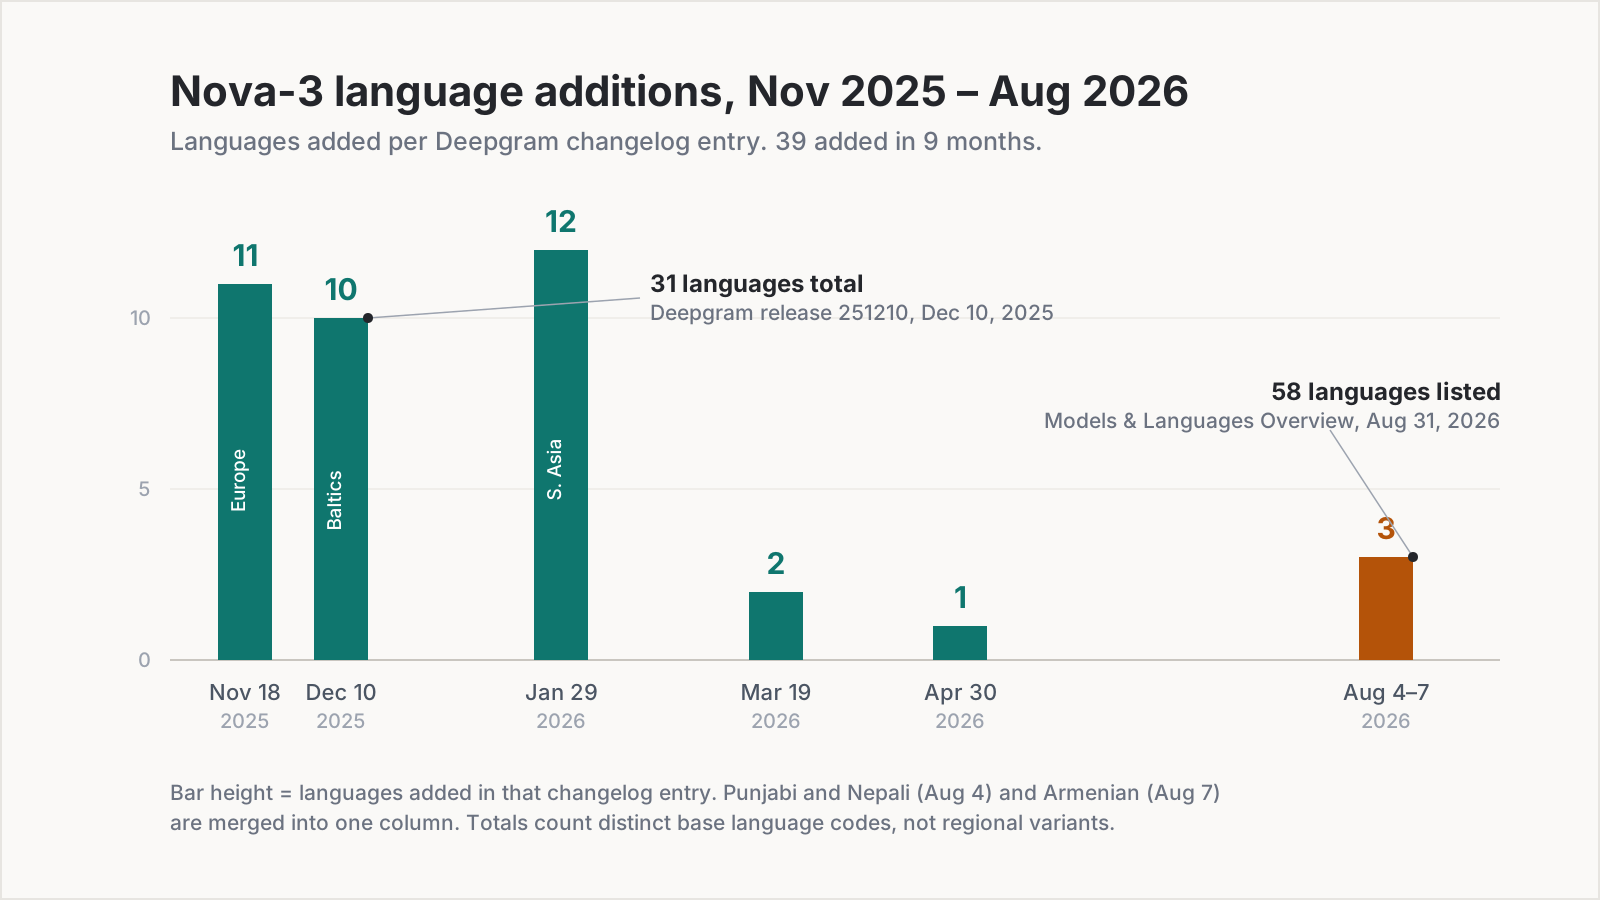
Grafik: Telli.sh, disusun dari entri changelog Deepgram bertanggal 18 November 2025 hingga 10 Agustus 2026, serta Models & Languages Overview yang diambil pada 31 Agustus 2026.
Tiga puluh satu bahasa di Desember, lima puluh delapan di Agustus
Vendor pengenalan suara jarang mengumumkan cakupan bahasa dengan gaya yang sama seperti mereka mengumumkan akurasi. Informasinya datang lewat catatan rilis, beberapa bahasa sekali jalan, dan efek kumulatifnya mudah terlewat kecuali Anda menengok ke belakang dan menjumlahkannya sendiri. Jadi kami menjumlahkannya.
Rilis Deepgram 251118, bertanggal 18 November 2025, memperluas dukungan monolingual Nova-3 dengan 11 bahasa baru — Bulgaria, Ceko, Finlandia, Hindi, Hungaria, Jepang, Korea, Polandia, Rusia, Ukraina, dan Vietnam. Rilis 251210, tiga minggu berikutnya pada 10 Desember 2025, menambahkan 10 bahasa lagi dari Eropa Selatan, kawasan Baltik, dan Asia Tenggara: Yunani, Rumania, Slovakia, Katalan, Lituania, Latvia, Estonia, Flandria, Jerman Swiss, dan Melayu. Catatan rilis itu memuat satu kalimat paling berguna dalam seluruh cerita ini: “Nova-3 kini mendukung 31 bahasa secara total.”
Setelah itu penambahan terus mengalir. Rilis 260129 pada 29 Januari 2026 menambah 12 bahasa, termasuk Belarusia, Bengali, Bosnia, dan Kroasia. Rilis 260319 pada 19 Maret 2026 membawa bahasa Thai dan Kanton. Rilis 260430 pada 30 April 2026 menambahkan Gujarat. Lalu Agustus: Punjabi dan Nepali pada tanggal 4, Armenia pada tanggal 7.
Jumlahkan semua penambahan terdokumentasi dari 18 November 2025 sampai 10 Agustus 2026 dan Anda mendapat 39 bahasa dalam waktu kurang dari sembilan bulan. Itu kira-kira satu bahasa baru setiap tujuh hari, terus-menerus, dari satu vendor saja.
Ada satu detail yang layak diperhatikan, karena ia menjelaskan bagaimana rilis-rilis ini benar-benar sampai ke tangan Anda. Changelog cloud memberi tanggal 4 Agustus 2026 untuk penambahan Punjabi dan Nepali. Rilis self-hosted yang memaketkan model yang sama, 260812, bertanggal 12 Agustus. Delapan hari jeda antara API terkelola dan image container. Kalau Anda menjalankan Deepgram di perangkat keras sendiri, kata “didukung” baru tiba lebih dari seminggu setelah orang lain menikmatinya.
“Didukung” bukan satu hal — melainkan tiga pertanyaan
Sekarang bagian yang disembunyikan oleh angka di judul. Ketika vendor bilang sebuah bahasa didukung, satu kata itu sedang mengerjakan setidaknya tiga tugas sekaligus, dan ketiganya terus-menerus terpisah satu sama lain.
Bisakah dipakai secara real-time, atau hanya setelah rapat selesai? Transkripsi batch dan transkripsi streaming berjalan di model berbeda dengan batasan berbeda. Model streaming harus memutuskan sebuah kata sebelum mendengar akhir kalimat; model batch mendapat seluruh rekaman. Vendor merilisnya secara terpisah, dan tidak selalu merilis keduanya bersamaan.
Seberapa bagus modelnya, sebenarnya? Kata “didukung” hanya memberi tahu Anda bahwa sebuah kode akan diterima, bukan bahwa keluarannya layak dipakai untuk rapat direksi. Bahasa yang baru ditambahkan bulan lalu dan bahasa yang sudah melewati empat putaran perbaikan sama-sama tercantum di sel tabel yang sama.
Bisakah dicampur dengan bahasa lain? Inilah pertanyaan yang nyaris tidak pernah dicek orang sampai akhirnya bermasalah. Mentranskripsikan rapat yang seluruhnya berbahasa Nepali adalah persoalan teknis yang berbeda dari mentranskripsikan rapat yang pesertanya berpindah antara Nepali dan Inggris di tengah kalimat, dan persoalan kedua baru terpecahkan untuk jauh lebih sedikit bahasa.
Changelog Agustus sendiri adalah ilustrasi paling jernih untuk pertanyaan pertama yang kami lihat sepanjang tahun ini. Entri 7 Agustus memperbaiki empat hal, dan tidak memperbaikinya secara merata.
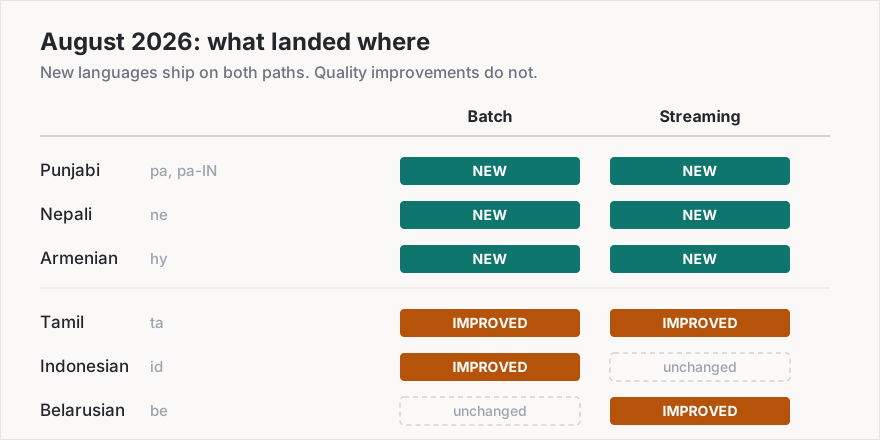
Grafik: Telli.sh, dari entri changelog Deepgram tanggal 4 dan 7 Agustus 2026.
Punjabi, Nepali, dan Armenia hadir di kedua jalur — Deepgram menyatakan terus terang bahwa “model batch dan streaming keduanya tersedia untuk bahasa-bahasa ini.” Tamil mendapat model yang ditingkatkan di batch sekaligus streaming. Bahasa Indonesia mendapat model batch yang ditingkatkan dan tidak ada yang baru untuk streaming. Belarusia mendapat model streaming yang ditingkatkan dan tidak ada yang baru untuk batch.
Kalau Anda mentranskripsikan rekaman wawancara berbahasa Indonesia, 7 Agustus adalah hari baik buat Anda. Kalau Anda menjalankan rapat berbahasa Indonesia secara langsung, 7 Agustus tidak mengubah apa pun. Kedua fakta itu hidup di dalam satu daftar poin, di dalam satu entri changelog, dan tidak ada ringkasan entri itu yang akan memberi tahu Anda mana yang berlaku untuk kasus Anda.
Ketimpangan itu bukan kecerobohan. Ia mencerminkan kenyataan bahwa keduanya memang model berbeda dengan anggaran pelatihan dan validasi yang berbeda, dan inilah argumen tunggal terkuat untuk membaca changelog vendor pada level bahasa per bahasa, bukan pada level judul.
Jurang cakupan: 58 bahasa, 10 percakapan
Sekarang pertanyaan ketiga, dan di situlah celah yang menarik itu berada.
Mode code-switching multibahasa Deepgram diaktifkan dengan satu parameter saja, language=multi, dan mode ini membuat satu permintaan mampu menangani penutur yang berpindah bahasa di dalam satu kalimat. Fiturnya benar-benar berguna, dan tersedia di Nova-2, Nova-3, serta Flux Multilingual. Ia juga jauh lebih sempit daripada katalog monolingual.
Di Nova-3, language=multi mencakup tepat sepuluh bahasa: Inggris, Spanyol, Prancis, Jerman, Hindi, Rusia, Portugis, Jepang, Italia, dan Belanda. Di Nova-2, parameter yang sama mencakup dua — Spanyol dan Inggris.
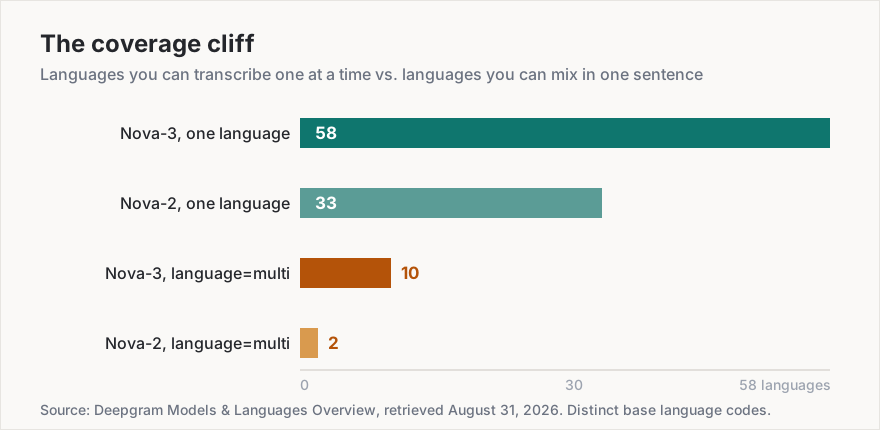
Grafik: Telli.sh, dari Deepgram Models & Languages Overview, diambil 31 Agustus 2026. Perhitungan memakai kode bahasa dasar yang berbeda, tanpa memasukkan varian regional dan varian aksara.
Sebut saja ini jurang cakupan: selisih antara bahasa yang dicantumkan vendor dan bahasa yang benar-benar tertangani di rapat Anda yang berantakan dan setengah berbahasa Inggris itu. Lima puluh delapan bahasa berdiri di bibir jurang. Sepuluh di antaranya selamat sampai ke dasar.
Untuk 48 bahasa yang berada di sisi keliru — Punjabi, Nepali, Armenia, Tamil, Bengali, Thai, Korea, Vietnam, Melayu, dan sisanya — model monolingual khusus bukan sekadar pilihan yang lebih baik. Ia satu-satunya pilihan. Tidak ada jalur code-switching yang bisa dijadikan pembanding.
Inilah intinya, dan ini berlawanan dengan intuisi bahwa mode multibahasa pasti lebih hebat: untuk sebagian besar bahasa di dunia, model monolingual adalah opsi tingkat lanjut, bukan opsi cadangan. Model khusus dilatih pada fonetik satu bahasa, distribusi kosakata satu bahasa, angka dan tanggal satu bahasa. Model multibahasa harus menahan sepuluh hal itu sekaligus dan memutuskan, kata demi kata, bahasa mana yang sedang ia dengar. Ketika Anda tahu rapatnya berbahasa Tamil, memberi tahu mesin bukanlah keterbatasan yang Anda terima — itu justru konfigurasi paling akurat yang tersedia untuk Anda.
language=multi (code-switching) | Model bahasa khusus | |
|---|---|---|
| Cakupan bahasa Nova-3 | 10 bahasa | 58 bahasa |
| Cakupan bahasa Nova-2 | 2 bahasa (Spanyol + Inggris) | 33 bahasa |
| Menangani pergantian di tengah kalimat | Ya | Tidak — ucapan di luar bahasa target menurun kualitasnya |
| Akurasi pada satu bahasa yang sudah diketahui | Lebih rendah; model menimbang antar-kandidat | Lebih tinggi; model terspesialisasi |
| Keyterm prompting | Ya di Nova-3 Multi, hingga 500 token (~100 kata), sejak 10 Des 2025 | Ya |
| Pengaturan streaming yang disarankan | endpointing=100 sesuai panduan Deepgram | Endpointing bawaan |
| Tersedia untuk Punjabi, Nepali, Armenia, Tamil | Tidak | Ya |
Cara membaca tabel itu secara praktis: kalau rapat Anda memang mencampur bahasa Inggris dan Spanyol kalimat demi kalimat, pakai multi dan terima konsekuensi akurasinya. Kalau rapat Anda berbahasa Tamil dengan sesekali kata serapan Inggris — dan itulah wujud sebenarnya dari kebanyakan rapat “multibahasa” — setel language=ta dan biarkan model khusus bekerja.
Siapa yang benar-benar mendapat rapat lebih baik bulan ini
Cukup soal arsitektur. Enam bahasa berubah status pada Agustus 2026, dan di balik setiap kode ada populasi yang selama ini mentranskripsikan rapat dengan buruk, atau tidak sama sekali.
| Bahasa | Kode | Penutur | Yang berubah pada Agustus 2026 |
|---|---|---|---|
| Punjabi | pa, pa-IN | ~125 juta | Baru di Nova-3, batch dan streaming (4 Agu) |
| Nepali | ne | ~16 juta | Baru di Nova-3, batch dan streaming (4 Agu) |
| Armenia | hy | ~6,7 juta | Baru di Nova-3, batch dan streaming (7 Agu) |
| Tamil | ta | ~75 juta penutur asli | Model ditingkatkan, batch dan streaming (7 Agu) |
| Indonesia | id | ~199 juta termasuk penutur bahasa kedua | Hanya model batch yang ditingkatkan (7 Agu) |
| Belarusia | be | ~7,6 juta | Hanya model streaming yang ditingkatkan (7 Agu) |
Angka penutur: hitungan Ethnologue sebagaimana diagregasi di Wikidata (properti P1098), diambil 31 Agustus 2026. Dibulatkan.
Itu kira-kira 430 juta orang yang bahasanya mendapat pengenalan suara yang terukur lebih baik dalam satu pekan, dan sekitar 148 juta di antaranya — penutur Punjabi, Nepali, dan Armenia — beralih dari sama sekali tidak punya opsi Nova-3 kelas satu menjadi punya opsi itu di batch sekaligus streaming.
Bayangkan apa artinya di dalam sebuah ruangan. Standup tim teknik di Chandigarh, yang sebelumnya entah dijalankan dalam bahasa kedua demi menyenangkan alat atau dibiarkan tanpa transkrip, kini menghasilkan transkrip real-time. Laporan lapangan sebuah LSM di Kathmandu menjadi catatan yang bisa dicari, bukan lagi tulisan tangan seseorang. Kesaksian hukum berbahasa Armenia bisa ditranskripsikan langsung alih-alih dikirim keluar untuk transkripsi manual dengan tarif per menit.
Ada efek lanjutan yang lebih penting daripada transkripnya sendiri. Begitu ucapan dalam suatu bahasa bisa dibaca mesin secara real-time, semua yang ada di hilir langsung terbuka sekaligus: terjemahan langsung untuk peserta jarak jauh, ringkasan otomatis, ekstraksi butir tindak lanjut, pencarian ke seluruh rapat selama setahun. Pengenalan suara adalah tahap yang menjadi leher botol. Setiap bahasa yang melewatinya langsung mewarisi seluruh alur kerja yang dulu dibangun untuk bahasa Inggris.
Kalau Anda ada di tim yang seseorangnya terbiasa beralih ke bahasa Inggris karena “alatnya tidak mendukung bahasa kita”, inilah pembaruan yang mengakhiri kompromi tersebut.
Cara memilih pengaturan bahasa untuk rapat multibahasa
Peningkatan mesin hanya membantu kalau Anda mengonfigurasi sesi dengan benar, dan pengaturan bawaan sering kali keliru untuk tim multibahasa. Lima langkah, berurutan:
- Tentukan dulu apakah rapat punya satu bahasa dominan atau benar-benar bercampur. Kata serapan Inggris sesekali dalam rapat berbahasa Tamil tetap satu bahasa. Bergantian kalimat penuh antara Spanyol dan Inggris berarti dua. Hanya kasus kedua yang membutuhkan code-switching.
- Kalau hanya satu bahasa, setel bahasa itu secara eksplisit. Gunakan
model=nova-3dengan kode spesifiknya —language=pauntuk Punjabi,language=neuntuk Nepali,language=hyuntuk Armenia. Jangan biarkan pada deteksi otomatis; Anda sudah tahu jawabannya, dan memberi tahu model tidak memakan biaya apa pun. - Kalau benar-benar bercampur, cocokkan bahasanya dengan daftar sepuluh itu. Setel
language=multihanya jika setiap bahasa di ruangan ada di dalam daftar Inggris, Spanyol, Prancis, Jerman, Hindi, Rusia, Portugis, Jepang, Italia, Belanda. Kalau ada satu saja yang tidak,multitidak akan menolong Anda, dan model bahasa dominan adalah pilihan terbaik yang tersedia. - Untuk sesi langsung yang memakai
multi, setelendpointing=100. Panduan code-switching milik Deepgram sendiri menyarankan 100 md khusus untuk code-switching, berbeda dari nilai bawaan yang lebih tinggi. Endpointing yang lebih panjang membuat frasa dalam bahasa yang baru berganti terserap ke segmen yang salah. - Verifikasi batch dan streaming secara terpisah sebelum Anda menjanjikan apa pun. Seperti dibuktikan 7 Agustus, peningkatan pada yang satu bukan peningkatan pada yang lain. Jalankan sampel 10 menit yang sama melalui kedua jalur lalu bandingkan, alih-alih mengasumsikan satu entri changelog berlaku untuk jalur Anda.
Kami membahas irisan lain dari topik ini pada Juni — pembaruan pertengahan tahun Deepgram tentang sesi langsung adaptif dan diarisasi, termasuk kontrol UpdateListen yang memungkinkan sesi berjalan mengubah petunjuk bahasanya tanpa menyambung ulang. Langkah 2 di atas dan kemampuan itu berpadu dengan baik: setel bahasa secara eksplisit di awal, lalu sesuaikan di tengah rapat kalau ruangannya memang bergeser.
Intinya: cakupan berhenti menjadi angka dan berubah menjadi matriks
Naluri pertama saat membandingkan mesin pengenalan suara adalah mencari angka terbesar. Tokenizer Whisper milik OpenAI sudah mendeklarasikan 100 token bahasa sejak 2022 — hampir dua kali lipat angka 58 milik Nova-3 — dan perbandingan itu nyaris tidak memberi tahu apa pun, karena Whisper tidak punya jalur streaming asli dan token yang dideklarasikan bukan model produksi yang tervalidasi. Nova-3 mencantumkan lebih sedikit bahasa tetapi benar-benar mengirimkannya, per bahasa, per mode, dengan bukti bertanggal.
Angka yang menggambarkan cakupan nyata sebuah mesin bukanlah sebuah hitungan. Ia sebuah matriks: bahasa × mode × tingkat kualitas. Lima puluh delapan bahasa satu per satu. Sepuluh di antaranya bisa dicampur. Satu bahasa membaik di batch tetapi tidak di streaming, satu lagi di streaming tetapi tidak di batch, dalam rilis yang sama, di hari yang sama.
Jadi pertanyaan yang perlu Anda bawa ke evaluasi vendor berikutnya bukan “berapa banyak bahasa yang Anda dukung.” Melainkan: untuk bahasa saya, di jalur saya, per tanggal berapa?
Posisi Telli.sh: semua yang di atas adalah detail lapisan mesin, dan kami rasa sebagian besar tim tidak seharusnya perlu tahu satu pun dari itu. Telli.sh duduk di atas lapisan tersebut dan mengambil keputusan-keputusan dalam daftar bernomor di atas untuk Anda — memilih model khusus ketika rapat hanya memakai satu bahasa, menjaga unggahan batch dan sesi langsung tetap di jalurnya masing-masing, serta mewarisi peningkatan mesin seperti yang terjadi di Agustus pada pekan rilisnya, bukan menunggu migrasi Anda berikutnya. Di atas transkrip itu kami menjalankan terjemahan langsung ke 44 bahasa target dan antarmuka dalam 15 bahasa, sehingga rekan yang bergabung ke standup berbahasa Punjabi Anda dari Warsawa membacanya dalam bahasa Polandia sementara rapat masih berlangsung.
Mulai catatan rapat dengan terjemahan langsung
Sumber
- Deepgram changelog, 4 Agustus 2026 — Nova-3 Model Update — Punjabi (
pa,pa-IN) dan Nepali (ne), batch dan streaming keduanya tersedia - Deepgram changelog, 7 Agustus 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — Armenia (
hy) baru; model batch yang ditingkatkan untuk Tamil dan Indonesia; model streaming yang ditingkatkan untuk Tamil dan Belarusia - Deepgram Models & Languages Overview — tabel bahasa lengkap Nova-3 dan Nova-2 serta daftar bahasa
multi, diambil 31 Agustus 2026 - Deepgram Multilingual Codeswitching guide — penggunaan
language=multidan rekomendasiendpointing=100, diambil 31 Agustus 2026 - Deepgram Self-Hosted release 251210, 10 Desember 2025 — “Nova-3 kini mendukung 31 bahasa secara total”; keyterm prompting multibahasa hingga 500 token
- Deepgram Self-Hosted release 251118, 18 November 2025 — 11 bahasa baru, plus model deteksi 36 bahasa
- Deepgram Self-Hosted release 260129, 29 Januari 2026 — 12 bahasa Nova-3 baru termasuk Belarusia, Bengali, Bosnia, Kroasia
- Deepgram Self-Hosted release 260319, 19 Maret 2026 — Thai dan Kanton
- Deepgram Self-Hosted release 260430, 30 April 2026 — Gujarat
- Deepgram Self-Hosted release 260812, 12 Agustus 2026 — paket self-hosted untuk Nepali dan Punjabi, delapan hari setelah entri cloud
- Tabel bahasa tokenizer OpenAI Whisper — 100 token bahasa yang dideklarasikan, diambil 31 Agustus 2026
- Properti Wikidata P1098 (jumlah penutur) — jumlah penutur turunan Ethnologue untuk
pa,ne,hy,ta,id,be, diambil 31 Agustus 2026 - Liputan kami pada Juni 2026 tentang pembaruan sesi langsung dan diarisasi Deepgram