[Блокнот идей ИИ 01] SlideOn: небольшая поисковая модель с двумя полезными настройками затрат
Знакомимся со SlideOn и mSlideOn от LightOn: моделями разреженного поиска по английским и многоязычным документам, первым практическим опытом и понятным сравнением качества, скорости и объема хранения.
«Блокнот идей ИИ» знакомит с идеями и практическими возможностями новых моделей и инструментов искусственного интеллекта.
Вы помните, что в документе объясняется, как отменить заказ. Поисковая строка помнит только слово отмена. К сожалению, в самом документе та же процедура называется отказом. Коллекция может содержать правильный ответ и при этом оставаться неудобной для поиска.
LightOn представила SlideOn и mSlideOn 19 октября 2026 года как две модели для поиска релевантных документов. SlideOn ориентирован на английский язык; mSlideOn распространяет подход на многоязычные тексты, длинные документы и код. Особенно интересны две независимые настройки: сколько признаков использует запрос и сколько сохраняется у каждого документа. Анонс LightOn
В этой статье разбираемся, где пригодятся модели, что меняют эти настройки и как провести небольшое сравнение до создания поискового сервиса. Чтобы понять идею, не нужно заводить новое приложение с чатом. Начните с вопроса, нескольких документов и определения полезного результата.
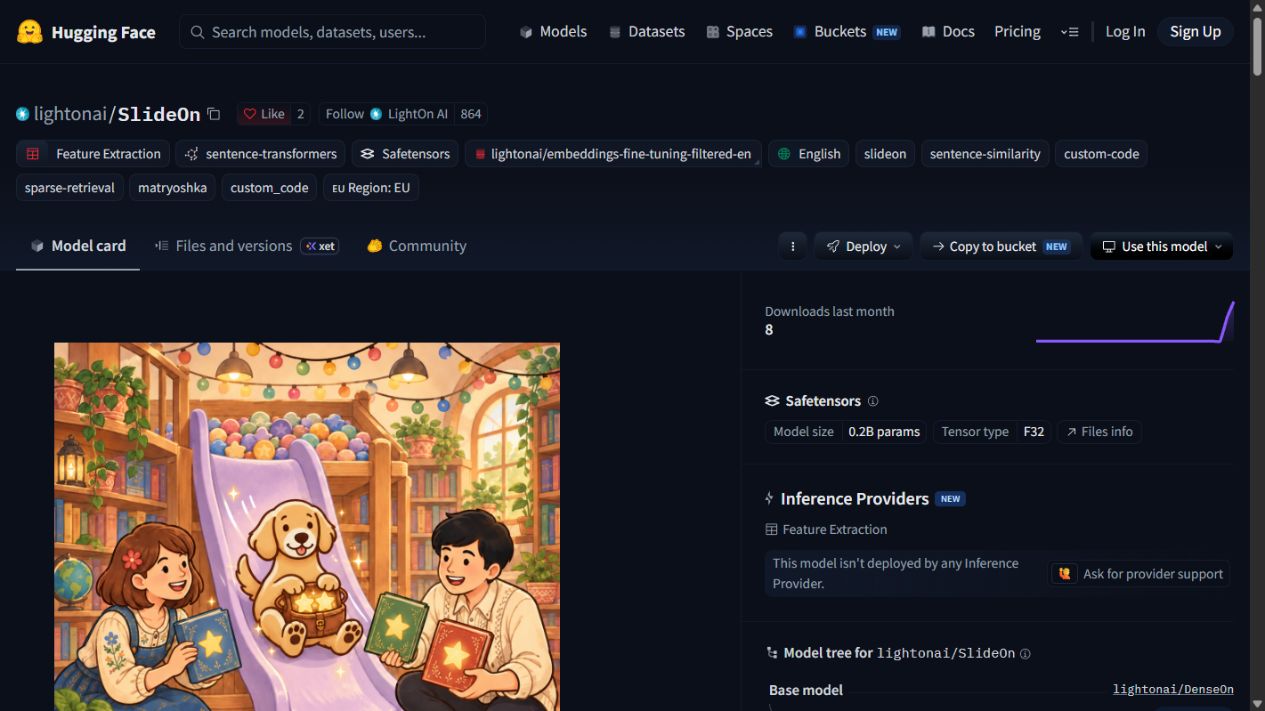 Публичная страница модели, снимок от 20 октября 2026 года. Источник: LightOn на Hugging Face. Это опубликованная страница, а не результат локального запуска; интерфейс также показывает, что у доступной для скачивания модели может не быть провайдера облачного инференса.
Прежде чем отвечать, поиск должен отобрать хорошие источники
Поисковая модель ранжирует документы относительно запроса. Ей не обязательно писать ответ, пересказывать файлы или решать, следует ли компании менять правила. Непосредственная задача уже: поднять наиболее релевантные материалы к началу списка.
Представьте внутренний справочник с тремя страницами: о возвратах, доставке и отпусках сотрудников. Вопрос о возврате поврежденного заказа должен выводить вперед страницу о возвратах. Если первым окажется календарь отпусков, генератор красивых ответов уже начнет с неверных свидетельств.
Это различие делает поиск полезным и без генеративного ИИ. Специалист поддержки может сразу открыть найденный документ. Исследователь — собрать фрагменты для сравнения. Инструмент программирования — найти вероятную реализацию до того, как ее изучит человек.
Есть и полезное разделение ответственности. Поиск помогает найти свидетельства; формулировки, даты и исключения по-прежнему проверяются в исходном документе. Хороший результат упрощает переход к источнику, а не подменяет его числом уверенности.
Разреженный поиск ведет избирательную адресную книгу
Представьте поисковый индекс в виде адресной книги. Обычный индекс ключевых слов записывает, в каких документах встречается термин. Обученная разреженная модель создает другую адресную книгу: присваивает веса сравнительно небольшому набору выученных признаков и оценивает соответствие запросов и документов по общим активным признакам.
Слово разреженный описывает эту избирательность. Представление может иметь множество возможных позиций, но задействовать для конкретного текста лишь их долю. Инвертированный индекс связывает активный признак с использующими его документами, позволяя поиску сосредоточиться на подходящих списках вхождений.
В карточке SlideOn указаны 32,768 возможных выученных признаков и независимые настройки прореживания запросов и документов. Это обученные латентные признаки, а не прозрачный словарь английских слов. Не стоит считать, что признак 100 обязательно означает синоним слова «возвраты». Карточка SlideOn
Последняя деталь важна при объяснении результатов. Разреженные представления могут удешевлять поиск, не делая каждое внутреннее решение понятным человеку. Практическим объяснением для пользователя все равно должен быть релевантный отрывок источника с достаточным контекстом для проверки совпадения.
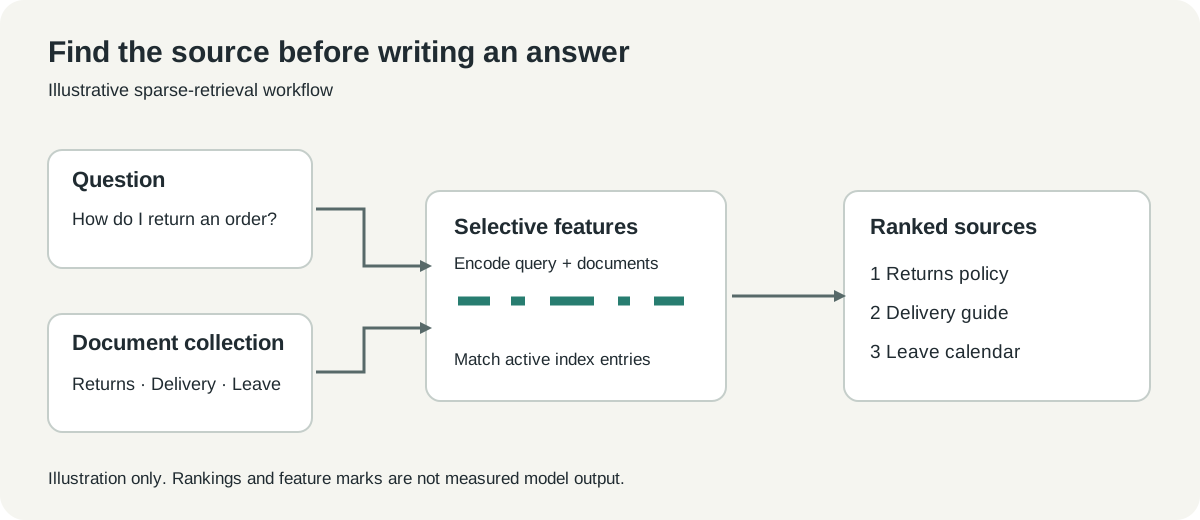 Оригинальная поясняющая схема. Метки признаков иллюстрируют процесс и не являются измеренными активациями SlideOn.
Выбирайте модель под свою реальную коллекцию
Два названия обозначают родственные исходные варианты, а не взаимозаменяемые языковые настройки. В анонсе LightOn указывает 174 миллиона параметров для SlideOn и 339 миллионов параметров для mSlideOn. Само по себе большее число не определяет, какая модель лучше подойдет вашей коллекции. Релиз от 19 октября
| Ваша коллекция | Разумный первый кандидат | Что выяснить в эксперименте |
|---|---|---|
| Статьи справки на английском | SlideOn | Находится ли нужная статья, когда запрос сформулирован иначе? |
| Документы на нескольких языках | mSlideOn | Работает ли каждый важный язык отдельно и соответствуют ли межъязыковые запросы вашим потребностям? |
| Длинные технические документы | mSlideOn с продуманным разбиением на фрагменты | Сохраняется ли нужный раздел после предобработки и ранжирования? |
| Исходный код вместе с обычным текстом | mSlideOn как кандидат | Полезны ли найденные файлы человеку, знакомому с репозиторием? |
Метка многоязычности — повод проверить модель, а не способ избежать оценки. В двуязычном каталоге могут быть переводы одного документа, различающиеся региональные правила и термины без единственного буквального эквивалента. Это разные поисковые задачи, даже если у документов одинаковая языковая метка.
Например, поиск французских правил возврата денег по английскому вопросу — межъязыковая задача. Поиск французского документа по французскому запросу — одноязыковая. Учитывайте их раздельно: общая оценка может скрыть плохой опыт отдельной группы читателей.
Тот же принцип действует для кода. Поиск файла о «восстановлении сессии» отличается от точного поиска имени функции. Оставьте в сравнении как точные идентификаторы, так и описательные вопросы: полезной поисковой системе часто нужны оба варианта.
Первый эксперимент поместится в ноутбуке
Начните с открытого или синтетического текста и чистого окружения Python. В опубликованном примере используется SparseEncoder из Sentence Transformers; это интерфейс загрузки модели, а не готовый поисковый сервер. Ниже приведена адаптация официального рецепта, проверенного 20 октября 2026 года. Документированный пример
- Откройте карточку модели и изучите собственный код инференса репозитория и зависимости. Загрузчик ниже использует
trust_remote_code=True, разрешающий выполнение Python-кода этого репозитория; для повторяемого эксперимента выбирайте проверенную ревизию. - Создайте изолированное окружение и установите документированные диапазоны версий библиотек.
- Закодируйте один запрос и несколько коротких документов. Используйте методы модели для запросов и документов, не добавляя префиксы вручную.
- Посмотрите на оценки рядом с самими текстами. Первая проверка касается порядка результатов, а не универсального порога оценки.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
Документы выше выдуманы для обучения. Код не сопровождается заявленным выводом или измеренной точностью. Проверьте, выходит ли документ о возвратах на первое место, затем попробуйте перефразировки и намеренно сложные альтернативы.
Не останавливайтесь после успеха самого простого запроса. Спросите об отмене до отправки, поврежденной посылке после доставки и возврате денег после указанного срока. Если в коллекции нет ответа, тест должен показать это отсутствие, а не наградить привлекательный, но нерелевантный результат.
Два ограничения отвечают на разные вопросы о затратах
Прореживание запроса ограничивает признаки, используемые при поиске. Прореживание документов ограничивает признаки, сохраняемые для каждого индексируемого элемента. В крупном сервисе первый лимит связан с работой при каждом поиске; второй влияет еще и на индекс, который хранится между запросами.
В полезном эксперименте меняют один лимит за раз. Сохраняйте представления документов неизменными, меняя прореживание запросов, затем повторите опыт с другими лимитами документов. Если менять оба одновременно, новый результат мало поможет понять причину изменения.
Универсальной настройки «достаточно мало» не существует. Короткий FAQ, многоязычный архив и репозиторий ПО различаются по языкам, длине и повторяемости. Настройка для широких вопросов может потерять редкую деталь, отличающую две почти одинаковые процедуры.
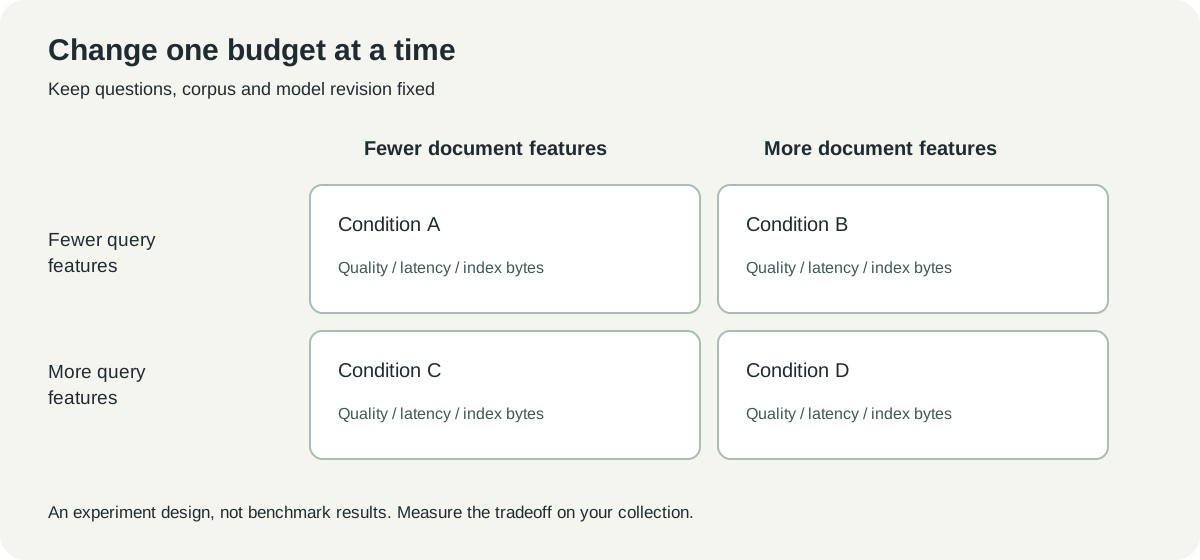 Оригинальный план эксперимента. Это условия сравнения, а не результаты бенчмарка или рекомендации для продакшена.
Разнесите качество, время и хранение по разным столбцам. Если поиск ускоряется, но нужная статья исчезает с первой страницы, выигрыш во времени не бесплатен. Если больший индекс не помогает на реальных вопросах, дополнительное место может не оправдаться.
Число из бенчмарка не измеряет время ответа
Карточка модели сообщает 56.68 nDCG@10 на BEIR-15 для SlideOn без прореживания. Это опубликованный результат качества ранжирования на наборах бенчмарка, а не вероятность правильности отдельного ответа. И это не количество миллисекунд. Опубликованная оценка
В обсуждении эффективности LightOn различает приближенный показатель FLOPS поиска и измеренную задержку, а также количество ненулевых элементов документов и размер индекса в байтах. Эти различия стоит сохранить в любой сравнительной таблице. Математический показатель объясняет механизм; эксплуатационное измерение показывает фактическое поведение системы.
Для небольшого исследования одного секундомера тоже недостаточно. Первичная загрузка модели, кодирование документов, построение индекса и повторные запросы — разные этапы. Отдельно сообщайте о холодном запуске и прогретом поиске, поясняя, входит ли кодирование запроса в измеренное время.
Та же аккуратность нужна с качеством. Поисковая модель может найти правильный документ, но поднять неверный фрагмент длинного файла. Укажите единицу оценки — файл, раздел или отрывок — и используйте ее для всех кандидатов.
Три практические коллекции показывают компромиссы
Справочник рабочих процедур — хороший первый пример, потому что желаемый результат часто понятен. Составьте вопросы о возвратах, задержках отправки и доступе к аккаунту, определив авторитетную страницу для каждого. Добавьте формулировки, отличающиеся от заголовков, чтобы проверять не только совпадение названий.
Многоязычный архив проекта добавляет сложность: одна тема встречается в протоколах встреч, переводе объявления и старом плане. Метаданные помогают отличить действующие правила от исторического обсуждения. Семантическая близость не определяет, какой версии должна следовать организация.
Документация для разработчиков добавляет точные строки и почти одинаковые документы. Вопрос о тайм-ауте может требовать и концептуального руководства, и ключа настройки. Сохраните лексический поиск как базовый вариант и проверьте, оправдывает ли гибридный подход свою сложность на ваших вопросах.
Это предлагаемые сценарии оценки, а не истории внедрения. Их цель — сделать критерии приемки конкретными. В каждом случае важен список вопросов, допустимых источников и наблюдавшихся ранжирований, который сможет проверить другой человек.
Пусть первое сравнение будет достаточно маленьким, чтобы его закончить
Возьмите, например, 30 характерных вопросов вместо бесконечной массы запросов. Разделите их на обычный поиск, перефразировки, неоднозначные случаи и вопросы без ответа в коллекции. Это предложение для начала, а не статистически репрезентативный бенчмарк.
Попросите эксперта определить ожидаемые результаты до настройки. Иначе каждый неожиданный порядок результатов провоцирует новое объяснение того, что вопрос «на самом деле означал». Оставьте отдельные нетронутые вопросы для финальной проверки, чтобы настройки не запомнили примеры разработки.
Запишите ревизию модели, предобработку, размер фрагмента, настройки прореживания и характеристики машины. Изменение любого пункта может повлиять на сравнение. Короткий повторяемый запуск полезнее большой оценки с исчезнувшими входными данными.
Наконец, посмотрите на экран результатов в реальном размере использования. Даже правильный первый ответ бесполезен, если заголовок обрезан до неузнаваемости или выдержка скрывает решающее предложение. Качество поиска встречается с качеством интерфейса в момент выбора документа.
Хороший поиск сокращает путь к источнику
На наш взгляд, полезная идея SlideOn — разделить качество и расход ресурсов на настройки, которые можно проверить. Это практичнее предположения, что любой поиск требует более крупной отвечающей модели. Подход предлагает скромный эксперимент: сохранить вопросы, менять представление и смотреть, что люди действительно находят.
Начните с документа, который ваша команда постоянно не может отыскать. Если новая модель стабильно поднимает его при разных формулировках, появится конкретное улучшение для дальнейшей работы. Конечная цель — читаемый источник; задача модели — сократить дорогу к нему.
Источники и изображения
Проверено 20 октября 2026 года. Пример настройки адаптирован из открытой карточки модели; установка, локальный инференс и независимый бенчмарк не заявляются. Скриншот открытой страницы LightOn на Hugging Face сделан автором. Обе схемы оригинальные. Источники файлов и уведомления о лицензиях находятся в реестре изображений.
- Релиз LightOn от 19 октября 2026 года
- Карточка SlideOn и примеры использования
- Карточка mSlideOn и сведения о языках
- Репозиторий обучения и оценки
Держите вопросы рядом со свидетельствами
Сохраняйте набор запросов, ссылки на источники и заметки проверки вместе, чтобы следующее сравнение отвечало на те же вопросы. Telli.sh поможет организовать такой исследовательский журнал. Создать аккаунт Telli.sh