Робот, победивший на демонстрации, может проиграть на вашем участке
Распределённые испытания RoboColosseum на физических роботах показывают, как результат зависит от оборудования, задач и дообучения. Постройте пилот вокруг работы, которую нужно выполнять.
Два робота-манипулятора одинаково убедительно выглядят на видео. Первый теряет захват незнакомой ёмкости. Второй захватывает её правильно, но кладёт не в тот ящик. Команде, которой предстоит выбор, важно понять, какие отказы произойдут на её линии и что потребуется для восстановления.
RoboColosseum — исследовательский проект для сравнения политик управления на физических роботах в разных местах. В версии на arXiv от 2 ноября авторы сообщают о 5 699 попарных сравнениях на 124 площадках. Они отмечают слабое согласие рейтингов между роботами с разной конструкцией и сообщают, что относительная эффективность может измениться после дообучения. Закупщики и исследователи могут использовать эти данные, чтобы спланировать более содержательную проверку до решения по демонстрационным роликам.
Unitree G1 слева, одна из испытанных платформ, на Japan Mobility Show 2025. Фото RuinDig/Yuki Uchida, размер изменён, CC BY 4.0. Источник изображения · Лицензия.

Рейтинг привязан к роботу, задаче и условиям
Оценка робота на месте. Оригинальная иллюстрация Telli.sh.
Политика может хорошо работать при определённом сочетании робота, расположения датчиков и задачи. Стоит заменить захват или изменить место поступления предметов, и успех может зависеть от другого навыка. Дообученная политика тоже отличается от версии, запущенной без адаптации. Её эффективность зависит от демонстраций и способа дообучения.
Авторы сравнивают политики в сопоставимых местных условиях. В открытом треке эксперты сравнивают попытки выполнить одну и ту же задачу, не зная, какая модель стоит за каждой попыткой. В треке дообучения используют более строго контролируемые задачи и демонстрации. Так можно отдельно выяснить, что происходит при новой инструкции и как политика приспосабливается, получив примеры.
| Что описывает результат | Что ещё нужно узнать команде внедрения |
|---|---|
| Одну конструкцию робота | Насколько её оборудование и датчики похожи на ваши |
| Одно распределение задач | Какие предметы, схемы размещения и исключения в нём есть |
| Дообученную политику | Какие демонстрации, время и вычисления потребовались |
| Оценку предпочтения или прогресса | Как часто полный цикл завершается без вмешательства |
| Период оценки | Совпадает ли конфигурация с той, которую вы будете внедрять |
Авторы сообщают о слабом согласии рейтингов для четырёх конструкций в исследовании. На сайте проекта может быть более широкий и свежий перечень действующих роботов. При объяснении цифр сохраняйте границы исследования. Текущий список публичной платформы говорит о том, что доступно сейчас, а статья описывает эксперимент на определённый момент.
Посмотрите, как развивается сбой
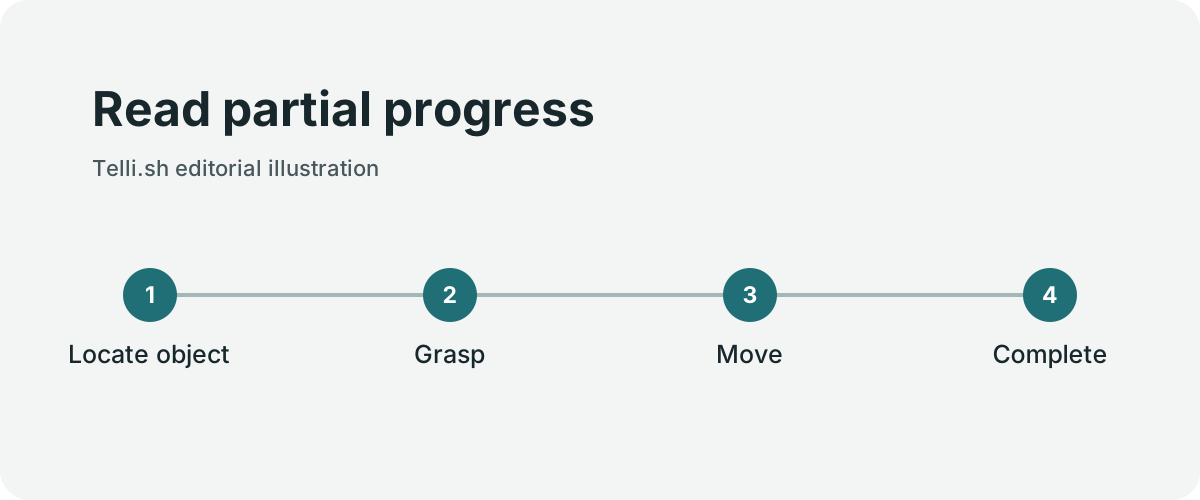
Оценка частичного прогресса. Оригинальная иллюстрация Telli.sh.
В исследовании говорится, что ни одна протестированная политика не завершила пять задач на конкретной конфигурации Unitree G1. Оценки прогресса при этом различались. Разница помогает выяснить, пропускает ли модель первый шаг или останавливается ближе к концу. Вывод касается этих задач и политик в условиях испытания.
Представьте сортировку из пяти этапов. Робот распознаёт предмет, приближается, захватывает его, перемещает и выпускает в нужном месте. Модель, которая стабильно доходит до выпуска, может стоить доработки, если последний шаг прост. Если при сбое падает тяжёлый предмет, высокий прогресс мало успокаивает оператора. Частичный результат показывает, где искать проблему. Физическое последствие показывает, допустимо ли поведение на рабочем месте.
В короткой демонстрации легко не заметить повторную попытку. На загруженной линии повтор занимает время и может потребовать, чтобы сотрудник восстановил обстановку. Успешное действие за десять секунд с минутой восстановления в части циклов может давать меньшую производительность, чем более медленная политика с редкими вмешательствами. Измеряйте долю успехов и время восстановления на таком числе циклов, чтобы увидеть важные сбои.
В этом помогает видеоразбор. Сохраняйте выборку полных успехов, частичных попыток и сбоев с разными причинами. Ролик, заканчивающийся сразу после захвата, может не показать выпуск. Эксперт, увидевший всю попытку, отличит завершённую работу от многообещающего движения.
Полевой пилот может взять за основу исследовательское сравнение
Начните с работы, которая действительно нужна площадке. Для склада это может быть контейнер с блестящими упаковками и редкими мятыми коробками. Для лаборатории — последовательная передача мелких инструментов. Точная задача, исходное состояние и ожидаемый итог делают испытание повторяемым и помогают поставщикам понять, что доработать.
- Выберите задачу с наблюдаемым критерием завершения. Запишите начальное расположение предметов и конечное условие. Включите типичные объекты и несколько сложных, но допустимых случаев.
- Зафиксируйте робота, датчики, рабочий орган, условия и версию политики. По возможности сравнивайте политики при одинаковой конфигурации и инструкциях.
- Отделяйте запуск без адаптации от запуска после неё. Записывайте число демонстраций, затраты на адаптацию и примеры, отложенные для проверки.
- Фиксируйте полное выполнение, частичный прогресс, время и вмешательства. Включайте попытки, прерванные при подготовке или потребовавшие сброса оператором.
- Повторите тест в смену или на площадке, где меняется существенное условие. Например, поменяйте набор входящих предметов или проверьте запуск с небольшим смещением.
- Проверяйте меры при вводе и физическую безопасность с квалифицированными специалистами по местным процедурам. Исследовательский тест измеряет поведение политики. Для рабочего места нужно учесть ещё людей и оборудование рядом с роботом.
Для качественных различий попробуйте попарный просмотр обезличенных роликов. Дайте экспертам письменное определение приемлемого поведения и способ отмечать опасные или непригодные попытки. Сохраните достаточно метаданных, чтобы позднее понять расхождения. Слепая проверка снижает влияние марки, а общая шкала помогает экспертам разных площадок одинаково оценивать одни и те же исходы.
Сравните треки, прежде чем сравнивать политики
Open Track и Fine-tune Track задают связанные вопросы, но устроены по-разному. Как указано в препринте, Open Track включает 5 699 попарных сравнений на 124 площадках. Попарная проверка показывает работу двух политик при сопоставимой задаче и площадке. Из этого числа не следует, что каждый робот выполнял каждую задачу на каждой площадке.
В оценке из статьи Fine-tune Track использует по 100 демонстраций для каждой из 20 задач. Авторы сообщают, что на Unitree G1 не завершилась ни одна из пяти оценённых задач, а средний прогресс находился в диапазоне от 13,3% до 23,2%. Частичные оценки говорят о разрыве больше, чем один ноль в итоговой графе. Политика может заметно продвинуться по шкале и всё же не завершить работу.
Авторы приводят коэффициент конкордации Кендалла 0,24 для рейтингов прогресса по четырём наборам задач, привязанным к оборудованию. Это мера согласия между рейтингами. Наборы различаются и конструкцией робота, и задачами, и условиями. Слабое согласие даёт повод проверить выбранную комбинацию на месте. Исследование не выделяет форму робота как самостоятельную причину отличий.
Сопоставьте две рабочие смены в полевом испытании
Представьте, что распределительный центр хочет перемещать одинаковый упаковочный вкладыш с лотка в коробку в течение двух смен. Сотрудники отмечают, что вечером приходит другой лоток и меньше естественного света. Запустите обе политики в обоих условиях на месте. Меняйте порядок в каждой смене, чтобы состояние батареи, сдвинутое крепление или опыт оператора не давали постоянного преимущества одному варианту.
Запишите исходное положение предмета, допустимые настройки датчиков и света, порядок вмешательства и критерий успешного размещения. Сохраните видео неудач и заметки о вмешательствах. Если политика становится лучше только после перемещения лотка, для внедрения это может быть важнее средней оценки. Наблюдение может привести к переделке крепления или лучшей подборке сценариев для следующей пробы.
Удобная шкала даёт частичные баллы за наблюдаемые этапы. Если захват находит нужный вкладыш, но не поднимает его, доработка будет иной, чем если он поднимает вкладыш и промахивается мимо коробки. Задайте простое определение этапа, чтобы два эксперта одинаково оценили попытку. Отдельно выделите безопасную остановку. Робот, остановившийся из-за входа человека в зону, мог повести себя правильно, хотя задача не завершилась.
Определите, какие данные оправдывают следующий шаг
Хорошая лабораторная демонстрация может обосновать полевой тест, а хороший полевой тест — более долгий пилот. У каждого решения свой порог приёмки. Закупщики могут потребовать повторяемости в двух распространённых сменах до обсуждения расширения в менее предсказуемую зону. Исследователь может запросить метки сбоев и повторение условий перед выводом о переносе политики.
Когда результаты расходятся, запишите, что изменилось в условиях и какое действие не получилось. Перестановка мест может обнаружить задачу, отсутствующую в исходном тесте. Это помогает выбрать между другим роботом, новой политикой, изменённой рабочей ячейкой и более представительной проверкой.
Посмотрите на перестановки в рейтинге из статьи
Fine-tune Track даёт конкретные примеры смены позиций между четырьмя наборами задач. π0.5 занимает первое место по прогрессу на Franka и Bimanual-YAM и четвёртое на G1. GR00T N1.7 лидирует на SO-101 и стоит четвёртой на Franka и Bimanual-YAM. Это результаты указанных наборов по выбранной мере прогресса. Для закупщика порядок показывает, как рейтинг меняется с сочетанием задач, условий и оборудования.
Авторы также изучают активный выбор сравнений. В их анализе около 400–500 адаптивно выбранных оценок дали примерно 90% согласия с рейтингом на полном наборе данных, по сравнению примерно с 1 000 при равномерном отборе. Результат относится к этому дизайну оценки. Идея для местного пилота — чаще повторять случаи, в которых лидеров трудно различить, сохраняя установленный минимум представительных примеров.
Площадка может провести начальный и адаптивный раунды. В первом дайте обоим кандидатам одинаковую работу с одним правилом вмешательства. Во втором повторите условия, где первые данные противоречивы. Критерий приёмки оставьте прежним. Если условие исключено из соображений безопасности или практичности, запишите причину. Итоговый отчёт должен показать, как дополнительные пробы изменили решение.
Собирайте сведения о самых важных работах
Распределённые испытания собирают условия, которые трудно воспроизвести в одной лаборатории. Местный пилот даёт подробности о работе вашей команды. Подходы хорошо сочетаются. Используйте широкую оценку, чтобы найти кандидатов, и собственную проверку, чтобы увидеть исключения, определяющие полезность системы.
Самое сильное сравнение команда может повторить после обновления политики или оборудования. Храните задачу, конфигурацию и примеры сбоев вместе с оценкой. Когда рейтинг изменится, у вас будут данные, чтобы решить, улучшает ли изменение работу.
Источники
Чтобы сохранять рабочие разговоры и решения и быстро находить их, создайте аккаунт Telli.sh.