[Блокнот идей ИИ 04] От решений в стиле Jev к изображениям: знакомьтесь, небольшая модель QEV на базе Qwen
Почему вокруг Qwen появляются модели визуальных решений, что меняет экспериментальная поддержка изображений Jev и какое место занимает локальный проект QEV класса 2B.
«Блокнот идей ИИ» знакомит с идеями и практическими возможностями новых моделей и инструментов искусственного интеллекта.
В процесс сортировки поступает фотография. Приложению нужно выбрать пластик, стекло или металл, проверить принадлежность предмета к заданной категории и вернуть значение, пригодное программе. Связный абзац о бутылке может быть интересен, но между моделью и решением остается еще шаг.
Jev привлек внимание к другому интерфейсу: передать модели ситуацию, вопрос и разрешенные ответы, а получить структурированное решение с вероятностями. Следующий вопрос естественен: может ли интерфейс работать не только с прочитанным, но и с увиденным?
Теперь может, причем в нескольких формах. TypeSafe представила экспериментальную поддержку изображений Jev 14 октября 2026 года. Независимые проекты тоже адаптируют визуально-языковые основы Qwen к решениям в стиле Jev. Среди них QEV — локальная модель на Qwen3.5-2B с выбором, упорядоченными оценками, булевыми решениями и воздержанием от ответа. Анонс Jev, репозиторий QEV
Раскрытие связи автора: QEV — независимый проект, который поддерживает автор этой статьи. Здесь опубликованный релиз отделен от функций, доступных только в исходниках; используются открытая документация и записанные примеры, а не новая независимая оценка модели.
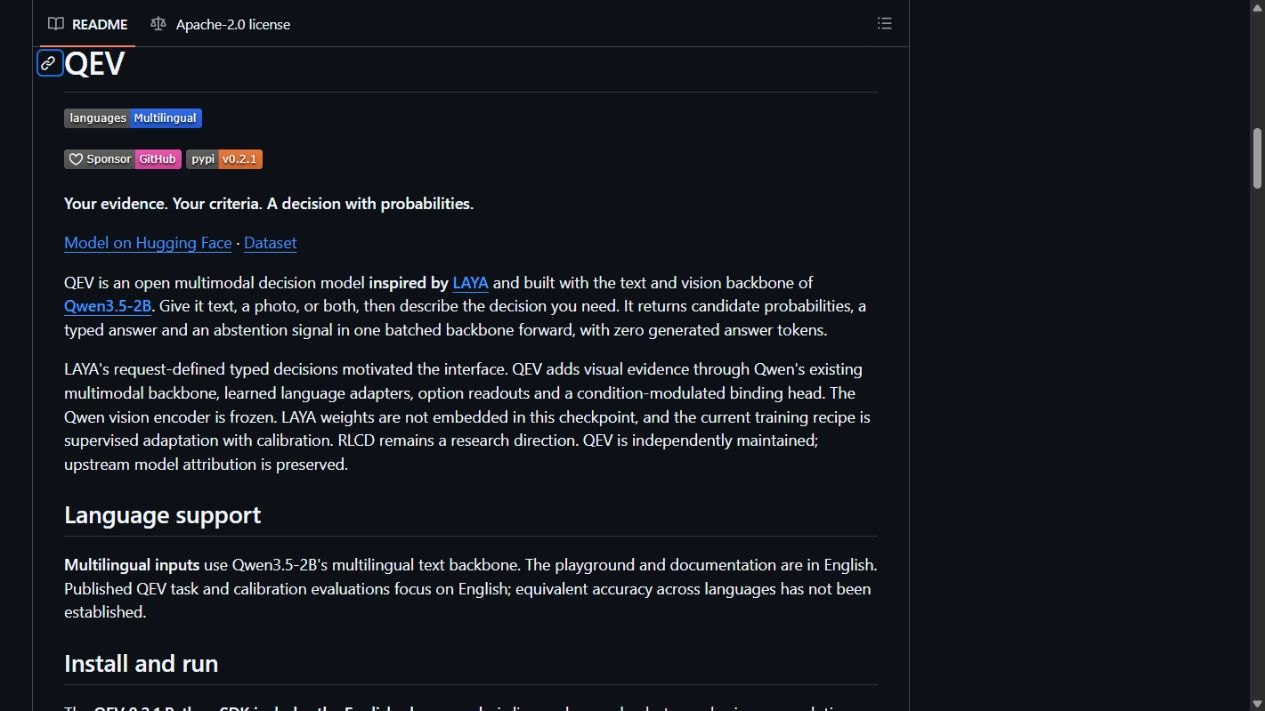 Открытый репозиторий QEV, снимок от 20 октября 2026 года. Это экран документации, не демонстрация локального инференса.
Почему модель решений ощущается иначе, чем чат-бот
Чат-бот обычно пишет ответ токен за токеном. Модель решений полезна, когда приложение уже знает форму ответа: выбрать направление, оценить условие по упорядоченной шкале или определить истинность утверждения.
Варианты могут меняться в каждом запросе. Сегодня поддержка предлагает платежный и технический отделы, завтра добавляет восстановление аккаунта. Визуальная сортировка передает шесть описаний материалов для одного вопроса и другой набор правил обработки для следующего. Модель должна соотнести текущие свидетельства с описаниями, а не выбирать из навсегда обученного списка меток.
Знакомые примитивы Jev — choice, score и noul. В QEV выбор возвращает распределение по заданным кандидатам. Оценка использует заданные упорядоченные уровни и возвращает вероятности вместе с ожидаемым уровнем. Вопрос noul использует критерии истины и лжи. Это разные выходные контракты, даже при общей базовой модели. Справочник API QEV
Вероятности делают границу видимой: небольшое преимущество одного кандидата может включить проверку вместо автоматического действия. Но они не делают решение правильным. Приложению по-прежнему нужна политика неопределенности, неподходящих входов и цены ошибки.
У Jev уже есть экспериментальный путь для изображений
Историческую мотивацию нужно обновить. Представлять QEV словами о том, что Jev сейчас не принимает изображения, было бы неверно. Октябрьский анонс TypeSafe включает экспериментальный визуальный ввод для Jev 1.13 и 1.14 через заголовок TypeSafe-Danger-Zone-Images. Jev 1.14 также добавляет пространственный примитив Box. В анонсе эти возможности названы экспериментальными. Анонс Jev 1.14
Это меняет сравнение. Полезнее спросить, какие развертывание, входной контракт и поведение подходят конкретному процессу. Облачный эксперимент Jev, исследовательская модель и локальная адаптация Qwen могут разделять идею ограниченных решений, сильно различаясь упаковкой и поддерживаемыми операциями.
Документированного аналога Box у QEV нет. Это независимая реализация, а не веса TypeSafe или официальный релиз Jev. Общие названия примитивов и endpoint в стиле SystemOne — начало интеграции, но не доказательство переноса любого запроса без изменений.
Почему в этих проектах встречается Qwen
Визуально-языковая основа уже объединяет текст и изображение в одной модели. Это практическая отправная точка: сохранить визуальное понимание и адаптировать связь свидетельств с ответами, которые задает приложение.
Два публичных примера показывают более широкое направление, чем один репозиторий:
| Проект | Публично описанный подход | Как понимать его статус |
|---|---|---|
| PixelJev | Исследует визуальный выбор в стиле Jev на небольших Qwen3.5, включая варианты 2B и 4B | Исследовательская статья о визуальном выборе, не свидетельство полной облачной замены Jev |
| AutoTrust JEV-27B-VL | Использует Qwen3.8-27B с решающей головой и адаптерами | Независимая крупная модель; карточка различает обученные на тексте решения и zero-shot работу с изображениями |
| QEV | Адаптирует Qwen3.5-2B для choice, score и noul | Локальный проект класса 2B с выпущенным SDK и отдельно описанными расширениями исходников |
Статья PixelJev помогает понять архитектурную идею: связать изображения и задаваемых во время исполнения кандидатов с решающим считыванием. Карточка AutoTrust показывает другой масштаб и отмечает отсутствие установленной систематической визуальной калибровки. Это примеры нового шаблона проектирования, а не рейтинг бенчмарков и не список одинаково совместимых продуктов. Статья PixelJev, карточка AutoTrust
Место QEV — компактное локальное развертывание. «Небольшой» означает класс основы относительно гораздо более крупных визуально-языковых моделей, а не установку на несколько мегабайт или мгновенную работу на любом устройстве.
Как QEV превращает изображение в решение
QEV использует единую текстово-визуальную основу Qwen3.5-2B. Опубликованная архитектура добавляет адаптацию языковой части и считывание, связывающее ситуацию и вопрос с описаниями кандидатов. Модель оценивает кандидатов напрямую вместо генерации предложения и последующего извлечения метки другим парсером. Публичная карточка модели
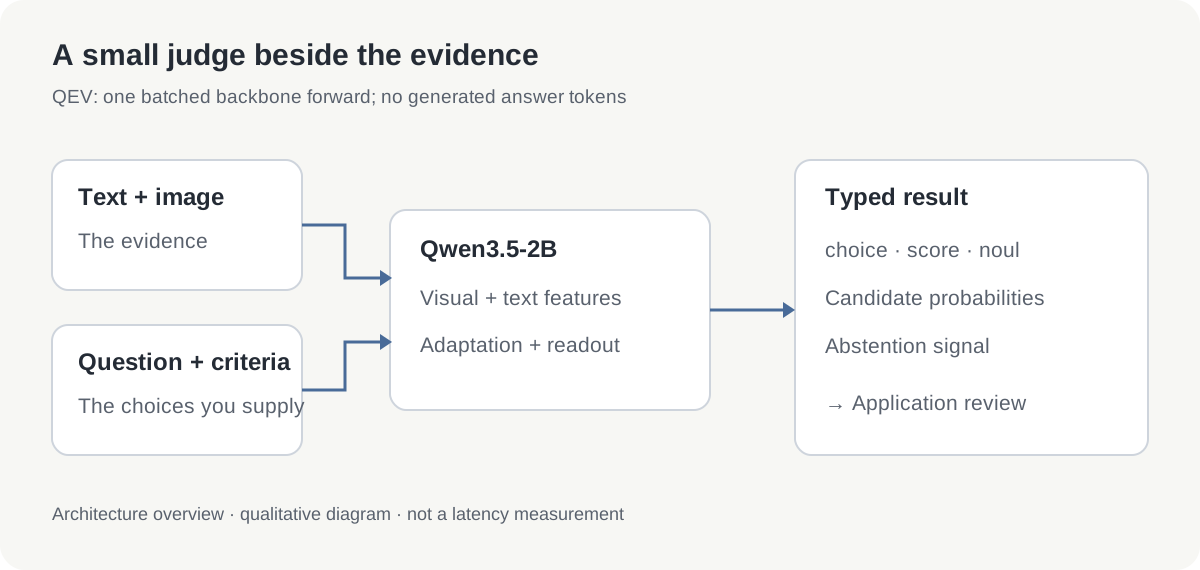 Оригинальная поясняющая схема. Стрелки описывают документированный путь решения, а не измеренное сравнение скорости.
В выпущенном SDK запрос содержит текст, одно изображение или оба вида данных. Поддерживаются от одного до четырех вопросов, от двух до шестнадцати кандидатов для choice и столько же упорядоченных уровней для score. Можно объединять связанные решения, не превращая каждый вопрос в отдельный чат. Справочник API
Представьте фотографию с короткой инструкцией: «Выберите материал по этим описаниям». Второй вопрос определяет группу правил, третий — соответствие заданному булевому условию. Фотография служит общим свидетельством, критерии задают смысл каждого решения.
Документированный инференс генерирует ноль токенов ответа. Это убирает источник нестабильного форматирования, но не визуальный энкодер, вычисления основы, предобработку картинки и расходы приложения. «Нет генерируемого ответа» и «нет вычислительных затрат» — разные утверждения.
Рассматривайте пример с бутылкой именно как пример
В репозитории есть лицензированная фотография пластиковой бутылки и записанный вывод. Это удобный способ увидеть структуру ответа до установки.
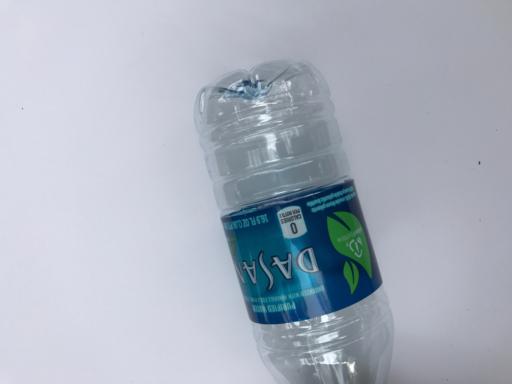 Опубликованный входной пример из фотографического набора QEV, первоначально из TrashNet. Copyright 2017 Gary Thung, лицензия MIT; уведомление о лицензии сохранено.
| Вопрос опубликованного примера | Записанный результат | Значение |
|---|---|---|
| Выбрать один из шести материалов | Пластик, вероятность около 0.9361 | Пластик получает наибольшую долю среди заданных кандидатов |
| Выбрать упорядоченную группу правил | Ожидаемый уровень около 0.4254 на шкале 0–2 | Взвешенное среднее трех заданных индексов групп |
| Относится ли предмет к стеклу, бумаге или пластику? | Истина, вероятность около 0.7903 | Истинный критерий предпочтительнее ложной альтернативы |
Оценка требует особого внимания. Здесь группа 0 объединяет стекло и пластик, группа 1 — металл и мусор, группа 2 — картон и бумагу. Порядок задан для примера. Число 0.4254 — не оценка безопасности, не стандарт переработки и не уверенность выбора материала.
Вероятность пластика тоже описывает конкретный запрос и его кандидатов. Она не доказывает правильную классификацию 93.61% всех фотографий бутылок. Это ранее изученный релизный пример, не новый отложенный тест; вывод записан проектом, а не воспроизведен для статьи.
Что здесь должно означать «совместимость с Jev»
Совместимость проще понимать слоями. Есть общая идея решений, определяемых запросом, точная схема JSON, допустимые входы и поведение каждого выхода. Совпадение одного слоя автоматически не дает остальные.
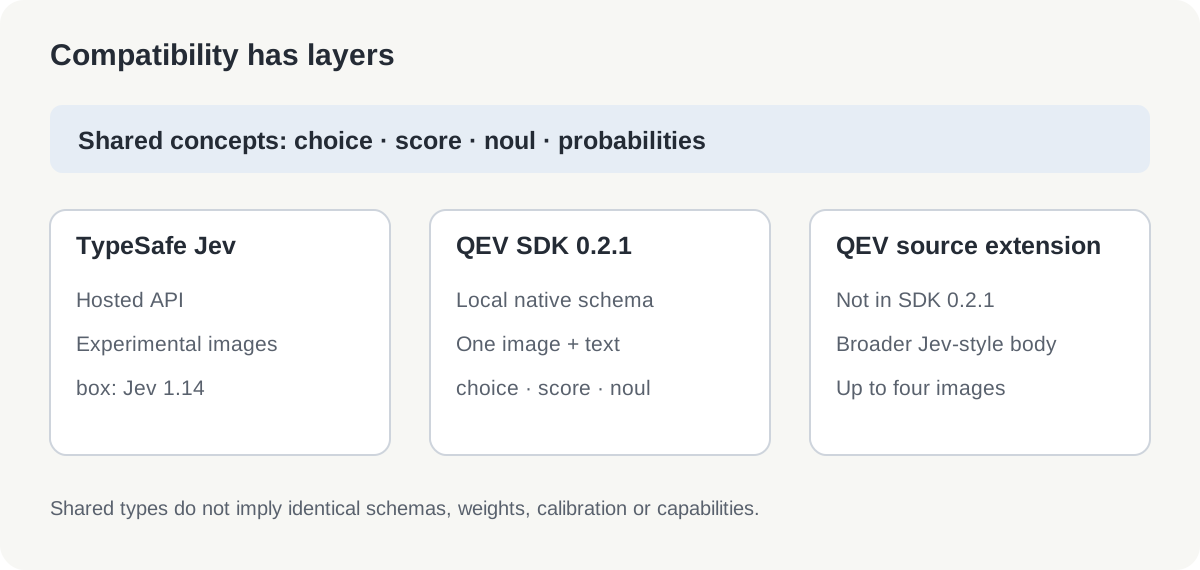 Оригинальная карта совместимости, проверена 20 октября 2026 года. Расширения исходников отделены от контракта упакованного SDK.
Упакованный SDK QEV 0.2.1 использует родную схему QEV и одно необязательное изображение. Публичные исходники также описывают более широкий прием запросов в стиле Jev/SystemOne и до четырех упорядоченных изображений. Не следует считать эти расширения частью опубликованного пакета 0.2.1. API и заметки релиза, релиз 0.2.1
Для интеграции начните с известного запроса и сравните валидацию, поля ответов, порядок кандидатов и неопределенность. Один знакомый маршрут /v1/systemone не доказывает универсальную прямую замену сервиса или SDK TypeSafe.
Первый практический взгляд
Для знакомства локальная площадка playground проще интеграции в приложение.
- Подготовьте и активируйте окружение Python 3.12.
- Установите закрепленный релиз и запустите playground командами ниже.
- Откройте
http://127.0.0.1:7860, выберите пример, изучите вероятности кандидатов и воздержание.
python -m pip install qev==0.2.1
qev playground
Документированная площадка работает локально по http://127.0.0.1:7860. Она содержит примеры фотографий и показывает вероятности, воздержание и структурированный вывод. Интерфейс и документация англоязычные. Это инструкции релиза, а не заявление об установке или измерении модели для статьи. Руководство playground
Небольшой текстовый запрос показывает форму родного SDK:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Начните с двух-трех явно различающихся кандидатов. Затем попробуйте неоднозначный случай и случай, не принадлежащий ни одному. Проверьте полезность воздержания вместе с политикой приложения. Для визуальных тестов используйте фотографии, которые вправе обрабатывать, и критерии видимых свидетельств, а не фактов, которые картинка не подтверждает.
Закладывайте ресурсы на основу, а не только адаптер
Для старого варианта SDK 0.2.1 выше чекпойнт адаптации QEV занимает примерно 32.01 MB, а отдельно скачиваемая основа Qwen — около 4.55 GB. Опубликованная разбивка указывает примерно 2.213 миллиарда параметров основы и 7.992 миллиона параметров адаптации и считывания. Октябрьские QEV-0.8B и QEV-2B ниже используют другой способ загрузки релиза. Разбивка размера модели SDK
Итак, первичная настройка требует гигабайтов. Последующая работа может использовать кэш, но память исполнения включает активации, обработку изображений и буферы. Документированные GPU- и CPU-пути имеют разную числовую точность. Размер чекпойнта полезен для хранения, но не обещает конкретных памяти, пропускной способности или расхода батареи.
Если 2B тяжело для компьютера, попробуйте QEV-0.8B
Октябрьский релиз включает QEV-0.8B на основе Qwen3.5-0.8B, дистиллированный от того же учителя, что и новый QEV-2B. Это практичный старт, если память GPU или время отклика делают 2B неудобным. Маленькая модель сохраняет задаваемые запросом решения, меняя часть качества визуальных суждений на меньший расход ресурсов. Карточка 0.8B, карточка 2B
| Опубликованное измерение | QEV-0.8B | Октябрьский QEV-2B | Разница |
|---|---|---|---|
| Публичный визуальный Decision Index, режим accurate | 53.02 | 61.99 | 2B впереди на 8.97 пункта индекса |
| Пиковое выделение памяти GPU, accurate | 1.86 GiB | 4.44 GiB | 0.8B использует примерно на 58% меньше |
| Медиана задержек p50 по профилям запросов | 66.0 ms | 135.3 ms | У 0.8B примерно на 51% ниже |
| Наибольшая задержка p95 среди профилей | 377.3 ms | 738.6 ms | У 0.8B примерно на 49% ниже |
| Пиковое выделение памяти GPU, fast | 1.60 GiB | 4.13 GiB | 0.8B экономит 2.53 GiB |
| Оценка RealWorldQA | 39.2 | 56.2 | 2B впереди на 17.0 пункта |
| Оценка Winoground | 47.5 | 65.5 | 2B впереди на 18.0 пункта |
| Оценка InfographicVQA | 75.4 | 83.1 | 2B впереди на 7.7 пункта |
Это измерения разработчика, проверенные 20 октября 2026 года. Индекс рассчитан самим проектом на публичном визуальном наборе версии 0.3.2 и ожидает официального прогона; это не общий процент точности. Парный бутстрэп-интервал разрыва 8.97 пункта составляет 7.39–10.48 пункта. Отдельные бенчмарки показывают зависимость разницы от задачи.
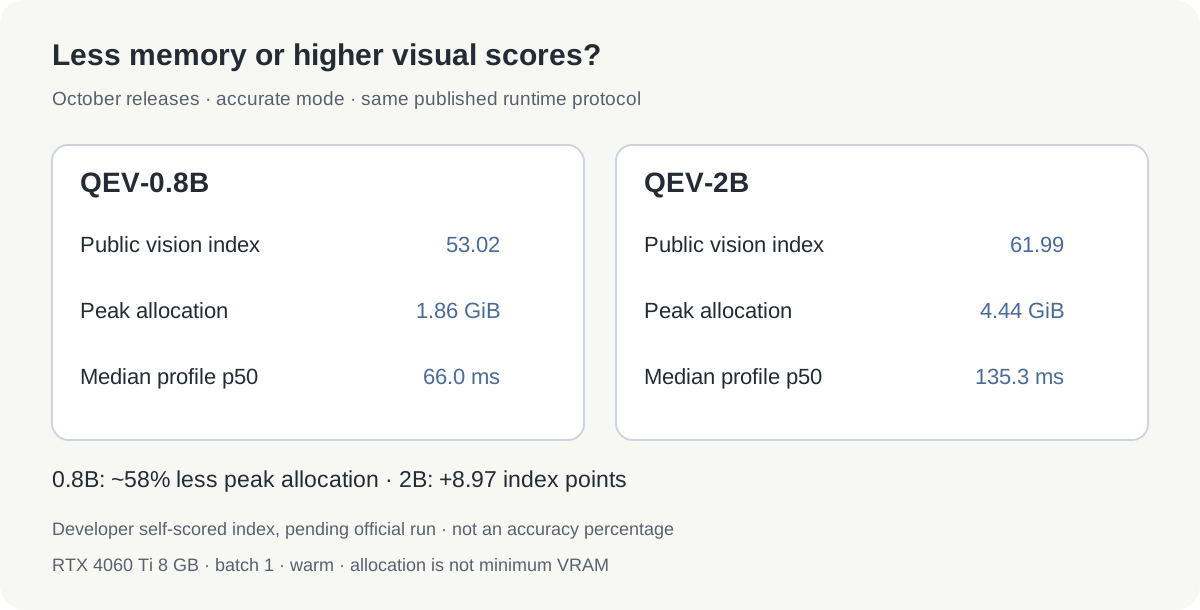 Оригинальная сравнительная инфографика по двум закрепленным карточкам. Индекс рассчитан самим проектом; память и время относятся к accurate на измеренном GPU.
Измерения выполнены на RTX 4060 Ti 8 GB, с пакетом 1, прогретой моделью и 47 профилями, по три прогрева и 30 измеренных запусков на профиль. Accurate допускает до 1.6 MP на изображение. Память — пиковое выделение PyTorch, а не минимальная емкость видеокарты: место нужно драйверам, другим приложениям и иным входам. Время исключает скачивание и загрузку модели и не предсказывает скорость CPU.
Fast ограничивает изображения до 0.26 MP и завершает вычисление на слое 16 из 24. Для 0.8B медиана p50 падает до 44.6 ms, худший p95 — до 123.2 ms. Внутренняя точность DEV снижается с 86.0% в accurate до 82.0%, особенно на документах, диаграммах и экранах. Публичный Decision Index для fast не опубликован; 53.02 относится к accurate.
Используйте отдельное окружение Python 3.12 для этих чекпойнтов. Старый пакет qev==0.2.1 не загружает релиз 0.8B:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Передавайте DecisionRequest через model.predict(request), как в предыдущем примере. Начните с 0.8B accurate, затем попробуйте fast при нехватке ресурсов. Переходите к 2B, если ошибки на характерных входах оправдывают дополнительную память и время, сохраняя для сравнения те же данные и описания кандидатов.
Где пробовать и где заканчиваются свидетельства
Хорошие первые эксперименты имеют видимые свидетельства и ограниченные последствия: направить изображение документа в очередь проверки, определить категорию фотографии предмета или выбрать подходящее описание обработки. Сохраните путь человеческой проверки, измеряя полезность модели.
До настройки запросов выберите небольшой характерный набор. Записывайте точность принятых решений, долю воздержаний и ошибки, которые все же проходят. Повторяйте при разном освещении, качестве изображения и языке. QEV наследует многоязычный ввод основы, но опубликованные свидетельства точности и калибровки ориентированы на английский; равенство корейского и других языков требует теста, а не предположения. Публичная карточка модели
Оценки старой модели SDK тоже ограничивают обещания. В сравнении на 2,000 вопросах типизированных решений QEV получил 77.00%, текстовый специалист LAYA — 76.95%: разница в один вопрос с парным доверительным интервалом, пересекающим ноль. Это не доказательство общего преимущества точности и не прямое сравнение с облачным Jev. Старые результаты отделены от октябрьского сравнения чекпойнтов выше. Текстовая специализация также бывает быстрее в собственных условиях. Методика и результаты сравнения
Визуальные рассуждения остаются неоднородными. Исследовательская оценка игры 2048 сообщает о нуле успешных игр за 72 попытки. Компактная модель, определяющая материал на фото, не становится автоматически надежным пространственным планировщиком. Заметки оценки
QEV стоит исследовать, когда одновременно важны локальная работа, небольшая основа и явные решения. Экспериментальный визуальный путь Jev и другие Qwen-проекты показывают общее направление: все больше приложений могут просить ограниченное суждение об изображении и обычным программным кодом решать, что с ним делать.
Источники
Источники проверены 20 октября 2026 года. Архитектура, примеры и границы релизов относятся к закрепленным открытым исходникам QEV и SDK 0.2.1. Более широкий контекст взят из анонса Jev от TypeSafe, статьи PixelJev и карточки AutoTrust. Главная иллюстрация — редакционный снимок публичного README QEV; источники изображений и права записаны отдельно.
Храните исходные свидетельства рядом с решением, чтобы можно было вернуться к ошибочной классификации или изменившимся правилам. Создайте аккаунт Telli.sh, чтобы собирать источники, заметки и последующие исследования в одном доступном для поиска пространстве.