Почему PFN хочет разместить память слоями на своём следующем ИИ-чипе
Совместная разработка MN-Core L2000 компаниями PFN и SEMIFIVE нацелена на ограничение пропускной способности памяти при инференсе ИИ. Что план развития означает для агентов, частных ИИ-систем и будущих закупок оборудования.
У ИИ-ассистента может быть достаточно памяти для загрузки модели, но каждый ответ всё равно будет казаться медленным. Вычислительные блоки готовы к работе, однако полезные вычисления зависят от того, поступят ли к ним нужные данные в нужный момент. Для компании, обслуживающей несколько частных ассистентов, эта разница способна превратить впечатляющие характеристики чипа в неприятное ожидание между словами.
Preferred Networks и SEMIFIVE делают ставку на решение этой проблемы на уровне разработки. В объявлении от 16 ноября 2026 года описана серия MN-Core L2000 — процессор для инференса с вертикальным размещением логики и DRAM. Заявленная цель — более чем вдвое увеличить пропускную способность памяти по сравнению с предыдущей серией L1000. PFN разместила объявление на своём сайте 17 ноября. Объявление PFN
Интересно, что такая конструкция могла бы изменить для тех, кто в будущем будет эксплуатировать ИИ-сервисы. Более быстрое перемещение данных может оказаться не менее важным, чем дополнительные вычислительные мощности, а корпусирование, программная поддержка и готовый сервер определят, дойдёт ли преимущество до экрана пользователя. Объявление L2000 помогает осмыслить эти решения ещё до того, как придёт время закупки.
Компания, создавшая PLaMo, проектирует и оборудование для ИИ
Preferred Networks — токийская ИИ-компания, работающая над процессорами, вычислительной инфраструктурой и семейством моделей PLaMo. В рамках сотрудничества PFN отвечает за архитектуру процессора и проектирование логики; SEMIFIVE обеспечивает реализацию проекта и услуги цепочки поставок, используя платформу Samsung Foundry и инфраструктуру проектирования 3D-IC. О компании PFN и распределении работ
Такое распределение важно, потому что полезный ускоритель — не просто набор инструкций или рисунок чипа. Логический проект должен превратиться в пригодный к производству кристалл, к нему необходимо подключить память, а корпусированные устройства должны стабильно работать. В конечном итоге заказчику нужна воспроизводимая конфигурация сервера и программный путь от модели к приложению. Каждая передача работ между участниками может повлиять на стоимость готового продукта и сроки его поставки.
Связь с PLaMo даёт читателям знакомый ориентир, но не означает, что каждое развёртывание PLaMo перейдёт на это оборудование. Разработчик модели и покупатель инфраструктуры задают разные вопросы. Разработчика интересует, можно ли эффективно выразить нужную нагрузку; покупателя — сможет ли поддерживаемая реализация выполнять требования сервиса в течение всего срока эксплуатации установки.
Для корейских читателей участие SEMIFIVE — конкретный пример того, как местные компетенции в проектировании полупроводников используются в инфраструктуре инференса. Следующий полезный вопрос — как эти компетенции преобразуются в серийные устройства и поддерживаемые системы. Объявление о сотрудничестве называет участников и направление, а продукты следующих этапов определят реальные варианты для заказчиков.
Ёмкость и пропускная способность памяти отвечают на разные вопросы
Ёмкость показывает, сколько данных способна хранить система памяти. Пропускная способность — сколько данных она может передать за определённый промежуток времени. Модель может укладываться в первый предел, тогда как второй ограничивает скорость работы процессора. Одно лишь увеличение ёмкости не гарантирует, что приложение станет отзывчивее.
Простой расчёт для планирования делает первое различие наглядным. Гипотетической плотной модели с 30 миллиардами параметров при хранении по два байта на параметр потребуется около 60 миллиардов байт только для параметров. Расчёт не включает рабочую память среды выполнения, кэшированные данные механизма внимания и другие накладные расходы. Это иллюстрация расчёта объёма хранения, а не утверждение о ёмкости L2000 или поддерживаемых им моделях.
Далее важно понять, как нагрузка использует сохранённые данные. Обработка входящего запроса и генерация последовательных выходных токенов предъявляют разные требования к системе. В объяснении оптимизации инференса от NVIDIA разделены параллельная обработка запроса и авторегрессионное декодирование, при котором перемещение данных из памяти может стать ограничением. Там также показано, почему пакетная обработка и управление кэшем внимания меняют баланс. Руководство NVIDIA по оптимизации инференса, 17 ноября 2023 года
Представьте память как кладовую, соединённую с кухней. Более вместительная кладовая позволяет держать ингредиенты на месте; более широкий проход помогает доставлять их на кухню. Ни то ни другое не говорит, сколько времени займёт конкретное блюдо: важны ещё приготовление и остальные этапы работы. Сравнение оборудования становится полезнее, когда эти отдельные задачи остаются видимыми.
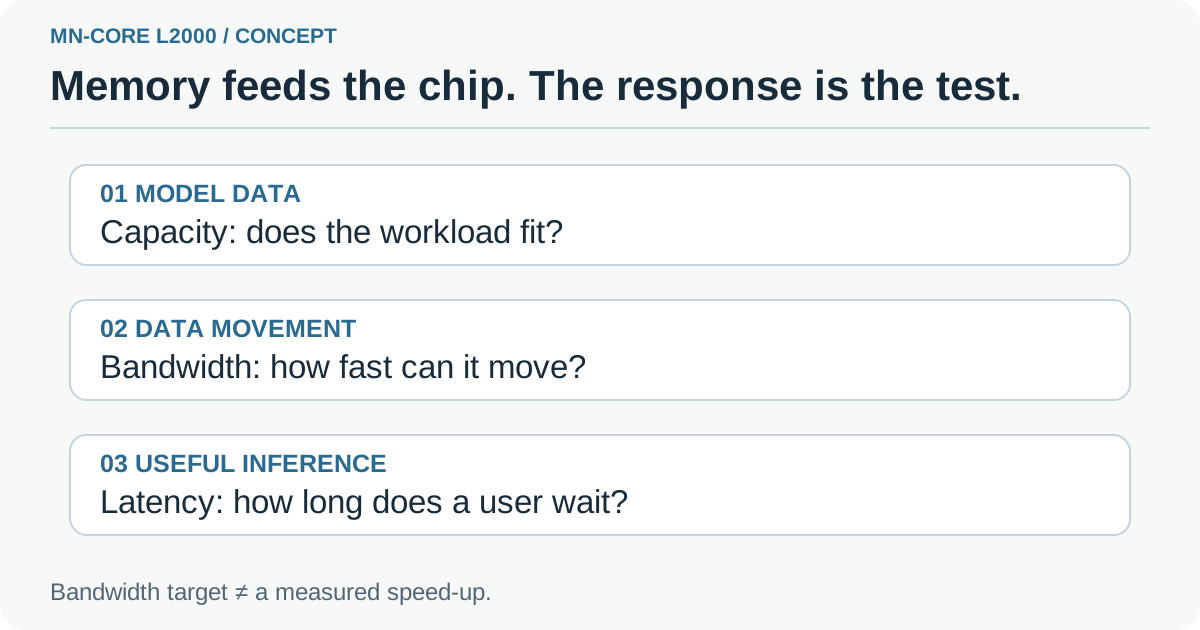
Авторская поясняющая схема, разделяющая хранение, перемещение данных и отклик приложения. Она иллюстрирует выбор, а не изображает неопубликованную компоновку корпуса L2000.
Вертикальная компоновка меняет не только путь данных, но и инженерную задачу
В официальном объявлении PFN есть схема вертикального размещения логики и DRAM в серии MN-Core L. Она помогает увидеть предлагаемое направление. При этом схема не показывает целый сервер, который установит заказчик, и не подтверждает производительность готового приложения.
Объединение компонентов в стек означает, что конструкция должна работать как физическая система. Электропитание, отвод тепла и стабильность производства нужно обсуждать вместе с перемещением данных. Это не второстепенные детали, к которым можно вернуться после того, как архитектура красиво выглядит на слайде. Они влияют на возможность производить, корпусировать, охлаждать и поддерживать устройства при приемлемой стоимости.
Для оператора конструкция корпуса — начало изучения, а не его конец. У стойки есть предел энергопотребления, у площадки — система охлаждения, у сервиса — требования доступности. Предлагаемый ускоритель в конечном счёте должен соответствовать всем трём. Экономическая выгода зависит от всей установки, включая оборудование и труд, необходимые для её эксплуатации.
Поэтому рассказ об эффективности должен сопровождаться условиями измерений. Хороший результат для одной модели, точности и числа одновременных запросов не описывает все нагрузки. Заказчику нужно видеть, где система эффективна, где заканчивается запас ресурсов и сколько энергии потребляет весь сервис для получения полезных ответов.
Три нагрузки зададут три разных вопроса
Рассмотрим частного ассистента по документам для юридической или инженерной команды. В этом условном сервисе запросы поступают неравномерно, а пользователи замечают задержку до начала ответа. В оценку следует включить характерные документы, время поиска и первый ответ модели. Ускоритель может улучшить часть этого пути, пока поиск документа или проверка прав доступа остаются более длительными этапами.
Второй пример — внутренний агент, который многократно вызывает модель при выполнении задачи. Здесь одна медленная генерация может задержать несколько зависимых шагов. Полезный показатель — время завершения правильно авторизованной задачи, включая результаты инструментов и необходимое подтверждение человека. Увеличение скорости выдачи токенов помогает только той части процесса, которая действительно ждёт генерацию.
Третий пример — ночная очередь обработки, классифицирующая или суммирующая большую коллекцию записей. Она допускает более крупные пакеты и больше ориентируется на объём работы, завершённой к сроку. Такой нагрузке может подойти другая конфигурация, чем интерактивному ассистенту, даже при одинаковой модели. При рассмотрении закупки стоит сохранить это различие, а не выбирать демонстрацию с самым большим числом в заголовке.
Эти сценарии — планы оценки, а не испытания L2000. Они показывают, почему за архитектурой с акцентом на память стоит следить, не предполагая заранее единый результат производительности. Лучший пилот начинается с нагрузки, которую команда уже понимает, и результата, который можно сравнить с текущей системой.
| Решение | Что должна подготовить команда | Что должен показать результат |
|---|---|---|
| Частный ассистент по документам | Характерные вопросы, документы и правила доступа | Полезные ответы поступают в пределах согласованного времени отклика |
| Многошаговый внутренний агент | Полные задачи, вызовы инструментов и точки подтверждения | Полное выполнение ускоряется без потери корректности |
| Ночная очередь обработки | Фиксированный набор записей и срок завершения | Нужная работа надёжно завершается в рамках эксплуатационного бюджета |
Целевая пропускная способность — лишь один входной параметр оценки сервиса
На наш взгляд, самое полезное сравнение начинается с покупаемой работы. Команда приобретает не пропускную способность саму по себе, а возможность выполнять задачи с учётом ограничений. Для этого нужна цепочка доказательств от модели и среды выполнения до сервера и приложения.
Начните с поддержки моделей. Конкретная архитектура, точность и необходимые операторы должны работать в поддерживаемом программном стеке. Компилятор или среда выполнения, способные запустить демонстрацию, могут всё ещё требовать интеграционной работы для производственного сервиса. Уточните поддерживаемые версии, операции, требующие преобразования, и того, кто будет сопровождать этот путь после изменения модели.
Затем разделите показатели отклика. Время до первого полезного ответа, скорость генерации и общее число завершённых запросов описывают разный пользовательский опыт. Фиксируйте их при одинаковых размерах входных данных и числе одновременных запросов, включая ошибочные и незавершённые ответы. Более быстрый запуск, меняющий качество вывода или незаметно отбрасывающий запросы, — иной результат, чем улучшение сервиса.
Наконец, верните вокруг модели само приложение. Поиск, модерация, доступ к инструментам, очереди и сетевой обмен тоже занимают время. Аппаратный пилот должен показать, какая доля всей задачи ждёт инференс. Это даёт команде разумную оценку преимуществ, которых действительно можно ожидать от более быстрого выполнения модели.
Следующая видимая веха — передача проекта в производство
Заявленный срок tape-out — первый квартал 2027 года: момент передачи окончательных проектных данных для изготовления. Это этап разработки, а не дата доставки готового сервера. План развития PFN
Производство, корпусирование, первое включение и валидация ещё должны связать проект с пригодным к использованию продуктом. Затем квалификация программного обеспечения и системная интеграция определят, что смогут развёртывать заказчики. Прохождение этих этапов может давать важные новости задолго до начала общих продаж, но каждый этап отвечает на свой вопрос.
То же правило относится к базе сравнения. Выпуск L1000 также запланирован на 2027 год, поэтому объявление сравнивает поколения в разработке, а не две системы, доступные для покупки сегодня. В нём нет опубликованной розничной цены L2000, графика поставок в Корею или тестов готовой системы. Сроки закупки должны опираться на будущую поддерживаемую конфигурацию и условия поставки от поставщика.
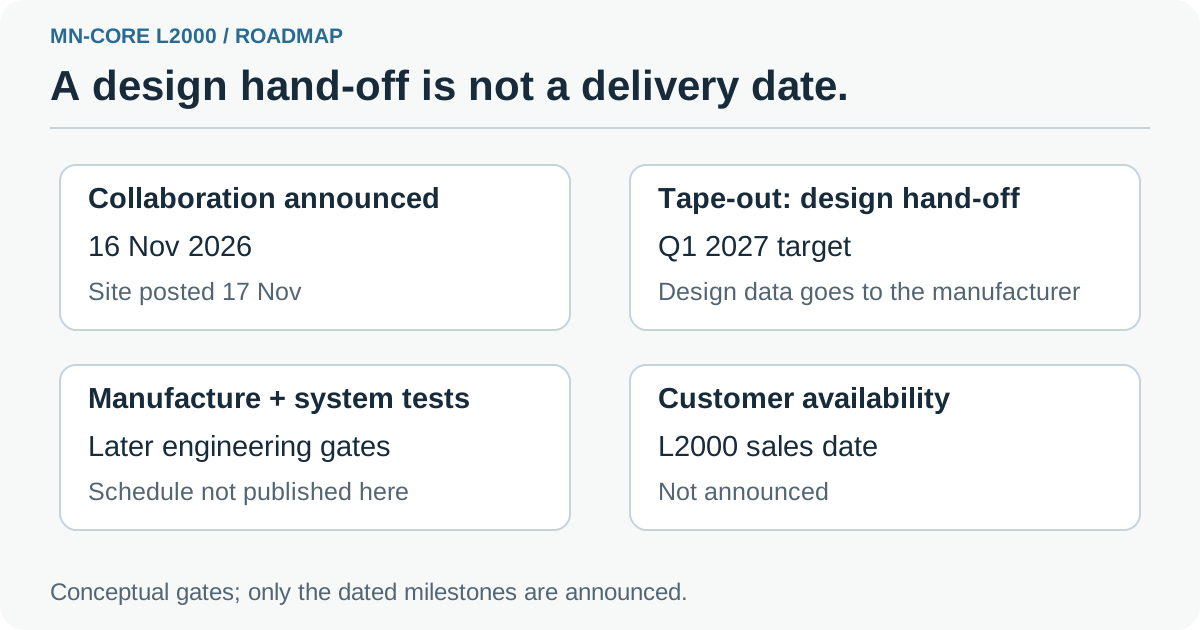
Авторская схема этапов разработки. Заявленный срок tape-out показан отдельно от последующих изготовления, квалификации и доставки заказчикам; даты этих дальнейших этапов остаются открытыми.
Что должно быть в практическом комплекте для оценки
Следя за планом развития, команда уже может выполнить полезную работу. Стоит подготовить компактную базу сравнения, которая сохранит ценность независимо от будущего выбора: системы MN-Core, GPU-сервера или размещённого у провайдера сервиса. Цель — сделать последующие аппаратные сравнения дешевле и содержательнее.
- Выберите полную задачу. Определите одну интерактивную задачу и, если нужно, одну пакетную. Запишите критерий корректного завершения и целевое время ответа или срок окончания.
- Зафиксируйте тестовые материалы и версии ПО. Храните вместе запросы, входные документы, ревизию модели, точность и настройки среды выполнения. Используйте материалы, на обработку которых у команды есть разрешение.
- Измерьте текущий путь. Запишите время ответа модели, время всей задачи, ошибки и использование ресурсов при ожидаемой нагрузке. Отметьте, когда сервис ждёт поиск или инструменты, а не генерацию.
- Запросите сопоставимую поддерживаемую конфигурацию. Будущее испытание у поставщика должно указывать ускоритель, конфигурацию памяти, хост, среду выполнения и поддержку моделей. Сделайте любые изменения качества или точности явными.
- Сравните эксплуатационное решение. Учтите приобретение, интеграцию ПО, электричество, охлаждение, поддержку и восстановление. Оцените, решает ли улучшение исходную задачу при приемлемых затратах.
Такой комплект полезнее набора несвязанных скриншотов с показателями пропускной способности. Он не даёт команде менять нагрузку при появлении каждой новой системы. Также становится проще заметить реальное улучшение: та же задача выполнена хорошо, с меньшей задержкой или меньшей эксплуатационной нагрузкой.
Для небольшой команды ближайшим решением может стать сохранение нынешнего оборудования и улучшение приложения. Если время ответа в основном уходит на поиск, ускорение одного инференса даст ограниченный эффект. Если же при нужной нагрузке сервис постоянно ждёт генерацию, новый ускоритель становится более подходящим кандидатом для испытаний. Оба вывода помогают направить расходы на узкое место, которое влияет на пользователей.
Развитие оборудования приближается к памяти
За сотрудничеством по L2000 стоит следить, потому что оно связывает проблему инференса с физической конструкцией и производственной работой, необходимыми для её решения. Следующими полезными доказательствами станут продвижение изготовления и квалификации программного обеспечения, а затем измерения на поддерживаемых системах. Результаты покажут, какие нагрузки выигрывают и что оператор должен вложить, чтобы получить эту пользу.
Практический вывод доступен уже сейчас. При сравнении ИИ-оборудования разделяйте объём хранения модели, перемещение данных и результаты приложения. То, что модель помещается в память, — начало разговора; надёжный сервис — результат, который нужен покупателю.
Источники
- Preferred Networks, PFN and SEMIFIVE Collaborate to Develop the MN-Core L2000 Series, дата в объявлении — 16 ноября 2026 года; публикация на сайте — 17 ноября 2026 года. Включает официальную структурную схему и график разработки.
- Preferred Networks, объявление на японском языке, соответствующий релиз компании.
- Shashank Verma и Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17 ноября 2023 года. Материал об этапах инференса, пакетной обработке и использовании памяти, а не тест оборудования MN-Core.
Храните вместе нагрузку, настройки модели и ответы поставщиков, чтобы следующая оценка начиналась с сопоставимой базы. Создайте первую заметку в Telli.sh.