Một mô hình ẩn danh đốt 26 nghìn tỷ token trong bốn ngày. Bảng giá đến sau: 24 xu.
Ngày 20/8/2026, một mô hình không phòng thí nghiệm, không thẻ mô tả, không giá xuất hiện trên OpenRouter với tên stealth/ox-alpha. Bốn ngày sau, người dùng OpenCode đã đẩy qua nó 26 nghìn tỷ token. Sáu ngày sau, Z.AI nhận đó là của mình: GLM-5.3-Flash, 320 tỷ tham số, giấy phép MIT, 0,15 đô la mỗi triệu token đầu vào. Vì sao các phòng thí nghiệm nay phát hành mô hình mà không gắn tên mình, những con số lưu lượng đó thực sự đo cái gì, và mức giá pha trộn 24 xu làm gì với kinh tế của các pipeline giọng nói.
Ngày 20 tháng 8 năm 2026, một mô hình xuất hiện trên OpenRouter dưới slug stealth/ox-alpha. Không có phòng thí nghiệm nào đứng tên. Không thẻ mô tả, không bảng benchmark, không bài công bố. Ô giá ghi 0 đô la đầu vào, 0 đô la đầu ra. Thứ nó có là cửa sổ ngữ cảnh 1.048.576 token, đầu vào văn bản, hình ảnh và video, cùng một dòng mô tả về kỹ thuật phần mềm dài hơi.
Bốn ngày sau, OpenCode cho biết người dùng của họ đã đẩy qua nó 26 nghìn tỷ token.
Sáu ngày sau, Z.AI xác nhận với Bloomberg rằng đó là mô hình của họ, phát hành trọng số theo giấy phép MIT và gắn kèm bảng giá: mười lăm xu mỗi triệu token đầu vào, năm mươi xu mỗi triệu token đầu ra. Tên của nó là GLM-5.3-Flash. Chữ "Flash" trong câu đó đang gánh một khối lượng ý nghĩa khổng lồ, và đó chính là lý do chúng tôi viết bài này.
Đây là một bài bình luận, không phải tin bài phát hành. Phần tiếp theo gồm: dòng thời gian sáu ngày kèm các con số lưu lượng và những lưu ý cần thiết, một lập luận về lý do các phòng thí nghiệm ngày càng phát hành mô hình mà không gắn tên ai, thông số kỹ thuật và điểm đánh giá độc lập sau khi danh tính được công bố, một danh sách rõ ràng những khẳng định chúng tôi không kiểm chứng được, và một phép tính chi tiết về việc mức giá pha trộn 24 xu tác động thế nào đến chi phí xử lý giọng nói. Đây là phần tiếp nối trực tiếp của bài so sánh trước và sau về cuộc trở lại của mô hình chạy cục bộ, và kết luận đi cùng một hướng: giá của trí tuệ máy có năng lực vẫn đang giảm, nhanh hơn mức mà phần lớn lộ trình sản phẩm giả định.
Tóm tắt:
- Lưu lượng là thật và lập kỷ lục. 26 nghìn tỷ token trên OpenCode trong bốn ngày với 327.000 người dùng duy nhất, và 11,6 nghìn tỷ trên OpenRouter trong ba ngày — đợt ra mắt mô hình lớn nhất trong lịch sử OpenRouter, so với kỷ lục trước đó là 4,4 nghìn tỷ.
- Danh tính đã được xác nhận từ nguồn gốc. Ngày 26/8/2026, Z.AI nói với Bloomberg rằng Ox Alpha là một mô hình thuộc dòng GLM; trang của chính OpenRouter nay ghi rằng mô hình ẩn này "được phát triển và vận hành bởi ZAI, được tiết lộ là ZAI GLM-5.3-Flash".
- Giá mới là điểm mấu chốt. 320 tỷ tham số tổng với 18 tỷ tham số hoạt động, giấy phép MIT, 0,15 đô la đầu vào và 0,50 đô la đầu ra mỗi triệu token — pha trộn lại là 0,24 đô la, so với 10,00 đô la của mô hình đầu bảng đóng cách đây sáu tháng mà nó vượt 12,1 điểm trên Intelligence Index của Artificial Analysis.
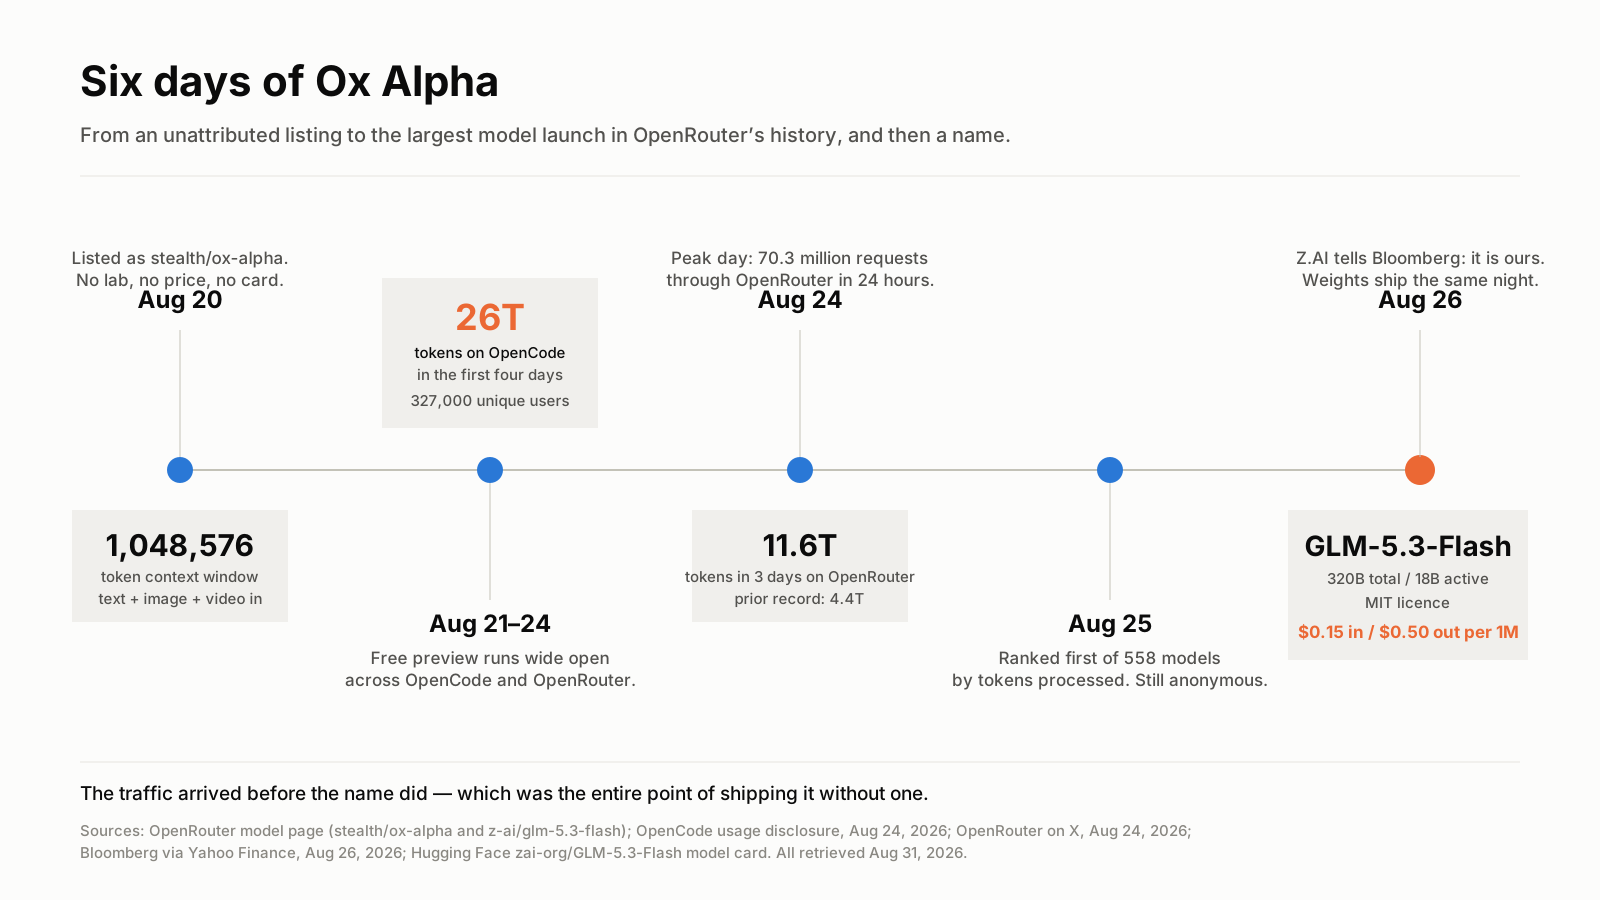
Toàn bộ sự việc, từ đầu đến cuối, kéo dài chưa tới một tuần. Nguồn ở cuối bài.
Sáu ngày, theo đúng thứ tự đã diễn ra
Ngày 20/8: mô hình lên sóng trên OpenRouter, đồng thời xuất hiện bên trong OpenCode — tác nhân lập trình chạy trên terminal, mã nguồn mở, do Dax Raad xây dựng. OpenCode giới thiệu nó là miễn phí, gần như không giới hạn, không lưu dữ liệu qua tuyến của họ, và tuyên bố đã bảo đảm được năng lực lên tới 100 nghìn tỷ token mỗi ngày.
Từ 21 đến 24/8: mức sử dụng tăng mỗi ngày, không sót ngày nào. Endpoint hoạt động mô hình của OpenRouter ghi nhận 27,0 triệu yêu cầu ngày 21/8, 54,4 triệu ngày 22/8 (tăng 101,2%), 63,9 triệu ngày 23/8 và 70,3 triệu ngày 24/8.
Ngày 24/8: OpenCode công bố các con số. 26 nghìn tỷ token trong bốn ngày đầu, với 327.000 người dùng duy nhất và 8.328.244 phiên hoàn tất — trung bình 3,2 triệu token mỗi phiên và khoảng 25 phiên trên mỗi người dùng. Con số đó đưa Ox Alpha lên vị trí thứ hai trong số các mô hình OpenCode theo dõi, sau DeepSeek V4 Flash với 33 nghìn tỷ và trên MiMo-V2.5 của Xiaomi với 12 nghìn tỷ. OpenRouter công bố riêng 11,6 nghìn tỷ token trong ba ngày trọn vẹn đầu tiên, gọi đó là đợt ra mắt mô hình lớn nhất lịch sử nền tảng; kỷ lục trước đó là 4,4 nghìn tỷ trong cùng khung thời gian mở màn.
Ngày 25/8: API mô hình của OpenRouter, sắp xếp theo số token xử lý trong tuần vừa qua, đặt Ox Alpha ở vị trí số một trong 558 mô hình được trả về. Ngoài phòng thí nghiệm, không ai biết ai đã tạo ra nó.
Ngày 26/8: Z.AI xác nhận với Bloomberg rằng Ox Alpha là mô hình mới thuộc dòng GLM của họ. Trọng số được phát hành ngay trong đêm. Bài công bố của chính công ty ghi rằng họ đã thử nghiệm GLM-5.3-Flash ẩn danh dưới tên ox-alpha trên OpenCode và OpenRouter "để thu thập phản hồi người dùng", còn trang mô hình ẩn trên OpenRouter được sửa lại thành: mô hình "được phát triển và vận hành bởi ZAI, được tiết lộ là ZAI GLM-5.3-Flash".
Con số lưu lượng là thật. Nhưng nó không phải phán quyết về chất lượng.
Đây là chỗ phần lớn bài viết đưa tin đã đi chệch, nên hãy nói cho chính xác: 26 nghìn tỷ token đo cái gì.
Nó đo thông lượng của một endpoint miễn phí có cửa sổ một triệu token, chủ yếu bị tiêu thụ bởi các tác nhân lập trình. Bảng điều khiển của chính OpenCode cho biết 93% token đầu vào được phục vụ từ bộ nhớ đệm — cùng một ngữ cảnh kho mã, được đọc đi đọc lại suốt một phiên dài. Bảng xếp hạng sắp theo số token xử lý trao lợi thế cơ học khổng lồ cho bất kỳ mô hình nào miễn phí và có cửa sổ khổng lồ, bởi các khung tác nhân liên tục nạp lại ngữ cảnh, thử lại các lệnh gọi công cụ thất bại và đẩy đầu ra công cụ ngược vào prompt. Phiên càng dài thì con số càng phồng lên, đó là bản chất thiết kế.
Con số 100 nghìn tỷ token mỗi ngày cũng cần được xử lý y hệt. Đó là OpenCode mô tả năng lực phục vụ tổng hợp, không phải mức sử dụng đã giao và cũng không phải hạn mức cho từng người dùng. Mức sử dụng thực tế trung bình khoảng 6,5 nghìn tỷ token mỗi ngày trong bốn ngày đầu — 6,5% mức trần được quảng bá. Nhà phân tích Teortaxes lưu ý rằng tạo ra 100 nghìn tỷ token đầu ra mỗi ngày ở tốc độ 80 token mỗi giây sẽ cần khoảng 580.000 GPU quy đổi, và đó đúng là loại con số khiến bạn nên hỏi người ta đang đếm cái gì trước khi dẫn lại.
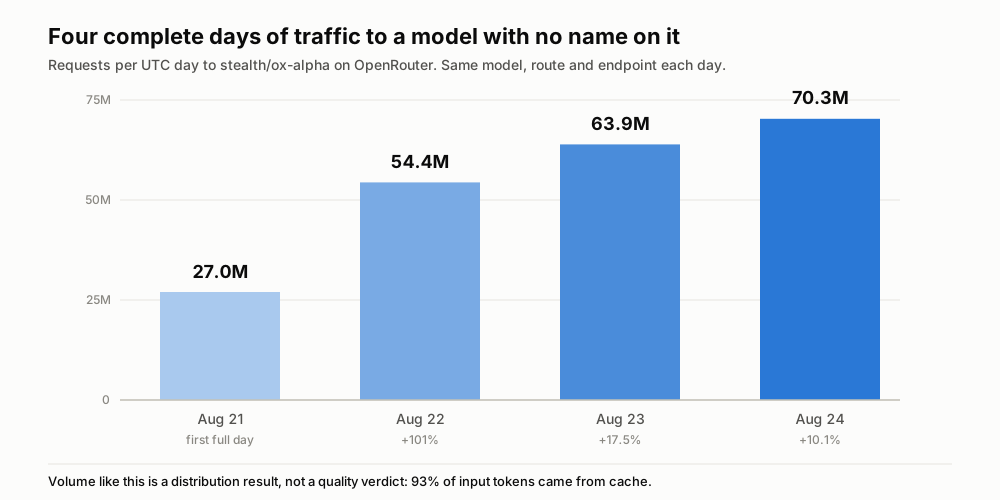
Số yêu cầu hằng ngày từ endpoint hoạt động mô hình của OpenRouter, ảnh chụp bộ nhớ đệm ngày 25/8/2026. Nền tảng có thể điều chỉnh lại các giá trị này.
Vậy lưu lượng thực sự chứng minh điều gì? Rằng một mô hình miễn phí ở tầm frontier với cửa sổ một triệu token, được thả vào đúng hai nơi mà các tác nhân lập trình vốn đã sinh sống, sẽ bão hòa nhu cầu trong 24 giờ. Đó là kết quả của phân phối, và kết quả phân phối tự nó đáng nghiên cứu. Nó không nói gì về việc mô hình có tốt trên kho mã của bạn hay không.
Vì sao một phòng thí nghiệm ngày nay phát hành mô hình mà không gắn tên mình
Đây là chỗ chuyển hướng, và chúng tôi đánh dấu rõ: mọi thứ ở trên là đo đạc, phần tiếp theo là cách chúng tôi đọc nó.
Phát hành ẩn danh mua cho một phòng thí nghiệm ba thứ mà không cách nào khác mua được. Hãy gọi tổ hợp đó là cổ tức của sự ẩn danh.
Thứ nhất là một đánh giá sạch. Mọi bản phát hành có tên đều đáp xuống bên trong một định kiến. Mô hình từ phòng thí nghiệm Trung Quốc bị chấm theo thang "tốt đến bất ngờ so với một mô hình mở"; mô hình từ phòng thí nghiệm frontier của Mỹ bị chấm theo thang "có đáng với mức tăng giá không". Gỡ cái tên đi, thứ duy nhất còn lại để lập trình viên phản ứng là đầu ra. Những đánh giá quay về trong tuần lễ ẩn danh được thực hiện bởi những người hoàn toàn không biết họ đang khen mô hình của ai — thứ đắt đỏ nhất để chế tạo trong tiếp thị AI, và rẻ nhất để có được bằng cách đơn giản là không nói.
Thứ hai là bánh đà. Bí ẩn chính là chiến dịch. Không ai viết một bài phân tích pháp y về một lần nâng phiên bản thông thường, nhưng một tuần lấy dấu vân tay tokenizer, mổ xẻ tầng phục vụ và suy đoán tạo ra một khối lượng bài vở khổng lồ mà phòng thí nghiệm không phải bỏ tiền mua. Rồi màn tiết lộ đáp xuống một công chúng đã đầu tư cảm xúc vào câu trả lời. Z.AI có một tuần được chú ý miễn phí, sau đó là một ngày ra mắt với cú chốt đã cài sẵn.
Thứ ba là dữ liệu vận hành ở quy mô mà tiền khó mua nổi. 8,3 triệu phiên tác nhân hoàn tất từ công việc thật, lộn xộn, mang hình dạng sản xuất, chính là một tập dữ liệu. Trang OpenRouter của Ox Alpha ghi rằng prompt và phản hồi được nhà cung cấp lưu giữ và không dùng để huấn luyện — chúng ta sẽ quay lại điểm này ngay sau đây — nhưng chỉ riêng việc lưu giữ đã cho ra các dạng lỗi, phân bố độ trễ, tỷ lệ lỗi khi gọi công cụ và đường cong suy giảm ở ngữ cảnh dài, trải trên hàng trăm nghìn kho mã thật. Bộ đánh giá nội bộ không đem lại được điều đó.
Dòng điều khoản dữ liệu ấy xứng đáng có ghi chú riêng, vì đó là điều thực sự bất thường duy nhất trong câu chuyện này. Trong mười bốn mục ẩn mà OpenRouter đã vận hành từ tháng 4/2025, mười ba mục mang một biến thể của câu "prompt và phản hồi được nhà cung cấp ghi nhật ký và có thể được dùng để cải thiện mô hình". Chỉ Ox Alpha ghi khác đi: được lưu giữ, không dùng để huấn luyện. Chuyện đó có làm bạn yên tâm hay không phụ thuộc vào việc bạn đặt bao nhiêu trọng lượng lên một dòng chữ trên trang mô hình của một nền tảng định tuyến. Ít nhất, đó là một lựa chọn có chủ ý, và là lần đầu tiên một mục ẩn làm vậy.
Tên mã giờ đã thành một thể loại riêng
Đây không phải nước cờ mới. Đó là một khuôn mẫu với năm lần được xác nhận từ nguồn gốc, và biết được lịch sử ấy chính là điều giúp bạn hiệu chỉnh cho lần tiếp theo.
| Tên mã | Hóa ra là | Được xác nhận bởi | Ngày | Bằng chứng |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, ảnh chụp trước phát hành của OpenAI | Blog của chính OpenRouter | 14/04/2025 | Nguồn gốc |
| Optimus Alpha | GPT-4.1, ảnh chụp gần bản cuối hơn | Blog của chính OpenRouter | 14/04/2025 | Nguồn gốc |
| Horizon Alpha / Horizon Beta | Các checkpoint đầu của GPT-5 | OpenRouter, bài "GPT-5 is now live" | 07/08/2025 | Nguồn gốc |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, bản không và có suy luận | Chỉ là suy đoán cộng đồng | — | Có đưa tin, chưa xác nhận |
| Hunter Alpha / Healer Alpha | Xiaomi MiMo | Chính đội MiMo của Xiaomi | 18/03/2026 | Nguồn gốc |
| Owl Alpha | Meituan LongCat-2.0-Preview | Blog Meituan và @Meituan_LongCat | 30/06/2026 | Nguồn gốc |
| Cypher Alpha / Aurora Alpha | Không bao giờ được làm rõ | — | — | Không có |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI nói với Bloomberg; trang OpenRouter được sửa | 26/08/2026 | Nguồn gốc |
Hai điều rút ra từ bảng này. Bảy trong mười ba mục lịch sử cuối cùng đã được xác nhận bằng tuyên bố từ nguồn gốc — tỷ lệ làm rõ tốt hơn nhiều so với những gì truyền miệng gợi ý — và ba trong số các xác nhận đó đến từ phòng thí nghiệm, chứ không phải OpenRouter, đó là lý do những bản tổng hợp chỉ theo dõi blog OpenRouter cứ đếm thiếu. Điều thứ hai: thể loại này đã đổi sân khấu. Các dòng năm 2025 là OpenAI và xAI. Các dòng năm 2026 là Xiaomi, Meituan và Z.AI. Các phòng thí nghiệm Trung Quốc không phát minh ra kiểu phát hành ẩn danh; họ công nghiệp hóa nó.
Màn tiết lộ: 320 tỷ tổng, 18 tỷ hoạt động, giấy phép MIT
Giờ là thông số kỹ thuật, lấy từ chính thẻ mô hình của Z.AI chứ không phải bản tóm tắt của ai khác.
GLM-5.3-Flash được các tác giả mô tả là "mô hình đa phương thức nguyên bản đầu tiên trong dòng GLM-5", với 320 tỷ tham số tổng và 18 tỷ tham số hoạt động theo cấu hình hỗn hợp chuyên gia, huấn luyện trên kho ngữ liệu đa phương thức 30 nghìn tỷ token. Kiến trúc lần đầu tiên trong dòng này kết hợp attention thưa và attention tuyến tính, cùng một kỹ thuật mà bài báo gọi là Manifold-Constrained Hyper-Connections. Cửa sổ ngữ cảnh là 1.048.576 token, phản hồi đơn tối đa 131.072 token. Độ sâu suy luận được phơi ra qua tham số reasoning_effort với ba mức low, high và max, mặc định là max. Giấy phép là MIT — không phải một giấy phép cộng đồng may đo có ngưỡng số người dùng, mà đúng là MIT.
Tuyên bố về năng lực của chính Z.AI đáng được trích nguyên văn, vì nó dè dặt hơn nhiều so với các bài viết xung quanh: mô hình "vượt GLM-5.2 trên các benchmark và khối lượng công việc thực tế với một phần mười mức giá, đồng thời tiệm cận Claude Opus 4.8 ở các benchmark lập trình và tác nhân". Tiệm cận. Không phải vượt.
Về đánh giá độc lập, Artificial Analysis đã chạy thử. GLM-5.3-Flash đạt 57 điểm trên Artificial Analysis Intelligence Index, so với trung vị 29 của các mô hình trọng số mở tương đương. Chạy trọn bộ đánh giá đó tốn 138,02 đô la chi phí API — con số chúng tôi trích dẫn vì đó là dữ liệu đơn lẻ trung thực nhất trong toàn bài về việc dùng trí tuệ cận frontier hôm nay tốn bao nhiêu. Cùng bộ đánh giá đó chỉ ra hai điểm yếu thật: ở 45 token đầu ra mỗi giây, mô hình chậm; và nó tạo ra 150 triệu token để hoàn tất chỉ số so với trung vị 110 triệu, tức là dài dòng. Dài dòng vẫn là một hóa đơn, kể cả khi giá mỗi token rất nhỏ.
Tin thật sự là một mô hình hạng Flash đạt 57 điểm
Đặt các con số cạnh nhau, dùng cùng quy ước pha trộn 3:1 giữa đầu vào và đầu ra mà Epoch AI dùng khi so sánh giá.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| Phát hành | 05/02/2026 | 14/08/2026 | 26/08/2026 |
| Trọng số | Đóng | Apache 2.0 | MIT |
| Intelligence Index | 44,9 | 52,0 | 57 |
| Giá mỗi triệu token vào | 5,00 $ | 0,45 $ | 0,15 $ |
| Giá mỗi triệu token ra | 25,00 $ | 3,20 $ | 0,50 $ |
| Pha trộn (3:1) | 10,00 $ | 1,09 $ | 0,24 $ |
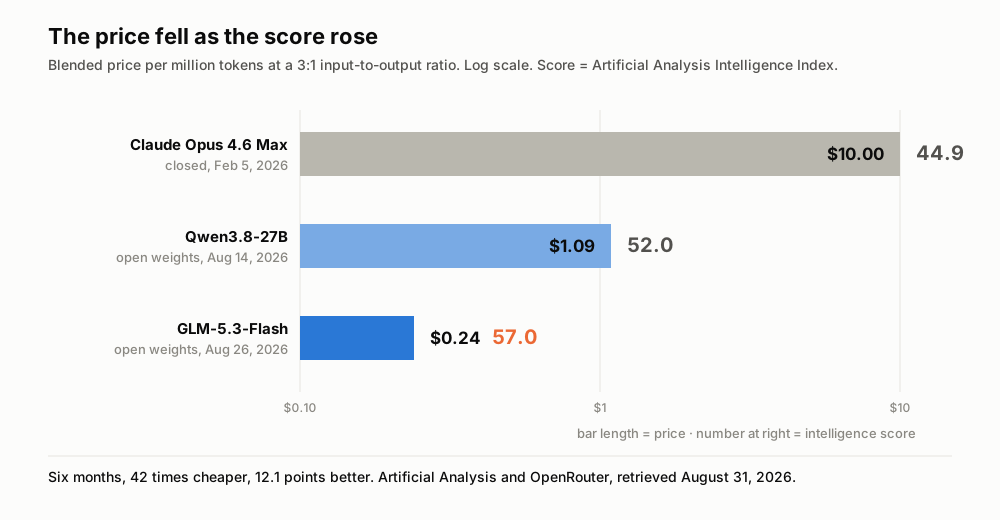
Độ dài cột là giá; con số bên phải mỗi cột là điểm trí tuệ. Artificial Analysis và OpenRouter, truy xuất ngày 31/8/2026.
GLM-5.3-Flash rẻ hơn 42 lần so với mô hình đầu bảng đóng hồi tháng Hai và cao hơn 12,1 điểm trên cùng một chỉ số độc lập. So với mô hình mở 27B mà chúng tôi viết cách đây mười ngày, nó rẻ hơn 4,6 lần và cao hơn 5 điểm. Cả hai khoảng cách đó đều hình thành trong vòng sáu tháng.
Đó cũng chính là đường cong mà bài viết về Qwen3.8 của chúng tôi đo từ đầu bên kia: chuỗi số liệu ngưỡng cố định của Epoch AI, giữ nguyên một điểm benchmark rồi theo dõi mô hình rẻ nhất đạt được nó, cho thấy hiệu năng cấp GPT-4 giảm từ 37,50 đô la mỗi triệu token vào tháng 3/2023 xuống 0,18 đô la vào tháng 2/2025 — rẻ đi 208 lần trong 23 tháng. GLM-5.3-Flash chính là dáng vẻ của đường cong ấy khi nó chạm tới frontier hiện tại thay vì frontier của ba năm trước.
Và hãy để ý tới hạng. Đây không phải mô hình đầu bảng. "Flash", trong quy ước đặt tên của mọi phòng thí nghiệm, chỉ người anh em rẻ tiền, nhanh, dành cho khối lượng lớn của mô hình mà họ thật sự muốn bạn trầm trồ. Điều thú vị không phải là một phòng thí nghiệm Trung Quốc đã ra một mô hình mạnh. Mà là bản giá rẻ giờ đã đủ gần frontier đến mức một tuần đối đầu trực tiếp trong ẩn danh vẫn chưa lộ bài ngay.
Bốn điều chúng tôi không kiểm chứng được, và ghi rõ như vậy
Sự phấn khích quanh bản phát hành này chạy trước bằng chứng ở vài chỗ cụ thể. Đây là những chỗ đó.
Khẳng định rằng Ox Alpha "vượt GPT-5.6" trong các bài kiểm tra ngữ cảnh một triệu token đến từ các bài viết của bên thứ ba, không phải từ một phương pháp luận công bố mà chúng tôi có thể soi xét; hơn nữa, đối tượng so sánh của chính Z.AI là Claude Opus 4.8, không phải GPT-5.6. Hãy xem so sánh với GPT-5.6 là khẳng định cộng đồng chưa được kiểm chứng.
Điểm 80% pass@1 trên DeepSWE được trích dẫn rộng rãi không thể so sánh với các con số trên 96% ở SWE-bench Verified thường được đặt ngay bên cạnh trong cùng bảng. Khung chạy khác, tập nhiệm vụ khác, độ khó khác. Mọi bảng đặt chúng ở hai dòng liền kề đều đang tạo ra một thứ hạng không tồn tại.
Khẳng định của Z.AI rằng toàn bộ tuần lễ ẩn danh được phục vụ trên các bộ tăng tốc nội địa Trung Quốc, với hiệu năng phục vụ đầu-cuối cải thiện gấp 3 lần và chi phí mỗi token ngang với phần cứng NVIDIA, là tuyên bố của nhà cung cấp và chưa được kiểm toán độc lập. Nếu đúng, đó là chi tiết có sức nặng nhất trong toàn bộ câu chuyện; còn hiện tại nó là một khẳng định trong thông cáo.
Và bản dùng thử miễn phí là một khoản trợ giá, không phải một bậc giá. Nó đã kết thúc. Giá hiện hành là 0,15 và 0,50 đô la, kèm ưu đãi giảm 50% có hiệu lực đến 16:00 UTC ngày 9/9/2026 — nghĩa là con số trung thực ở trạng thái ổn định là con số chưa giảm giá, và bạn nên lập ngân sách theo mức 0,15 / 0,50 đô la thay vì theo giá của tuần này.
24 xu làm gì với một pipeline vừa nghe, vừa dịch, vừa tóm tắt
Các sản phẩm giọng nói chịu tác động bất thường từ giá token, bởi chúng tạo ra bản ghi rồi đọc lại bản ghi đó nhiều lần. Mọi bước phía sau — làm sạch, dịch, tóm tắt, hỏi đáp — đều nạp lại cùng một đoạn văn bản. Đây là phép tính, với mọi giả định đặt hết lên bàn.
- Bắt đầu từ một đơn vị công việc thật. Một cuộc họp 60 phút giữa hai người, ở tốc độ khoảng 130 từ mỗi phút, tạo ra chừng 7.800 từ. Cộng thêm nhãn người nói và mốc thời gian, hãy tính bản ghi là 12.000 token.
- Thêm lượt tóm tắt. Đưa toàn bộ bản ghi vào, nhận ghi chú có cấu trúc ra: 12.000 token vào, khoảng 800 token ra.
- Thêm dịch trực tiếp sang ba ngôn ngữ đích. Mỗi lượt đọc bản ghi và viết ra khối lượng tương đương: 12.000 vào và 12.000 ra, lặp ba lần.
- Cộng cả cuộc họp. 48.000 token vào và 36.800 token ra.
- Định giá hai lần. Ở mức 0,15 / 0,50 đô la của GLM-5.3-Flash, cuộc họp đó tốn 2,6 xu. Ở mức 5,00 / 25,00 đô la của Claude Opus 4.6, cùng cuộc họp đó tốn 1,16 đô la.
Chênh lệch 45 lần trên một giờ âm thanh không phải là tối ưu một dòng chi phí. Đó là khác biệt giữa một tính năng bạn phải đo đếm cẩn thận và một tính năng bạn để bật mặc định. Ở mức 1,16 đô la mỗi cuộc họp, dịch sang ba ngôn ngữ cho mọi người dùng là quyết định cần ai đó bên tài chính phê duyệt. Ở mức 2,6 xu, đó là một ô đánh dấu.
Đó chính là phần của câu chuyện sống lâu hơn cái tên mã. Màn phát hành ẩn danh là một nước cờ tiếp thị, và là nước cờ hay. Sự thật bền vững hơn là: bậc rẻ trong danh mục của một phòng thí nghiệm tầm trung giờ mang lại 57 điểm chỉ số với giá pha trộn 24 xu, kèm giấy phép MIT để bạn có thể tự chạy nếu giá có ngày đi sai hướng.
Chốt lại: frontier không còn là nơi có những mức giá đáng chú ý
Suốt ba năm, câu hỏi về chọn mô hình là "bạn đủ sức đứng gần frontier tới đâu". Sáu ngày của Ox Alpha trả lời một câu hỏi khác: hiện có bao nhiêu năng lực đang nằm dưới hạng đầu bảng, được định giá như hàng hóa phổ thông, và được phát hành bởi những phòng thí nghiệm đủ tự tin để thử nghiệm nó sau khi gỡ tên mình đi.
Cổ tức của sự ẩn danh chỉ được trả nếu mô hình đủ tốt để sống sót qua một tuần không thương hiệu. Z.AI đã thu được. Cái tên mã tiếp theo xuất hiện trên một nền tảng định tuyến xứng đáng được đối xử y như Ox Alpha: hãy chạy nó trên chính các tác vụ của bạn trước khi có ai đó nói cho bạn biết nó là của ai — bởi trong đúng tuần đó, đấy là đánh giá trung thực duy nhất mà bất kỳ ai có được.
Telli.sh đứng ở đâu trong chuyện này: đường cong này chính là lý do chúng tôi xây pipeline giọng nói trên một lớp nhà cung cấp engine thay vì xoay quanh API của một hãng duy nhất. Telli.sh định tuyến phiên âm, dịch và tóm tắt qua các engine có thể thay thế, nên một bậc đi xuống trên đường cong giá này đến với bạn dưới dạng ghi chú tốt hơn ở cùng mức giá, chứ không phải một thông báo đổi giá. Phần mà không bản phát hành mô hình nào lo hộ là phần còn lại của công việc: thu trọn một giờ âm thanh mà không rớt, tách bạch người nói, dịch trực tiếp qua 15 ngôn ngữ, và để lại những ghi chú mà quý sau bạn vẫn tìm được.
Nguồn
- Trang mô hình
stealth/ox-alphatrên OpenRouter — ngày niêm yết 20/8/2026, ngữ cảnh một triệu token và dòng bổ sung xác nhận ZAI GLM-5.3-Flash; truy xuất ngày 31/8/2026 - Trang mô hình
z-ai/glm-5.3-flashtrên OpenRouter — giá hiện hành và khung ưu đãi khuyến mại đến 9/9/2026; truy xuất ngày 31/8/2026 - Thẻ mô hình Hugging Face, zai-org/GLM-5.3-Flash — 320 tỷ tham số tổng / 18 tỷ hoạt động, kho ngữ liệu đa phương thức 30 nghìn tỷ token, giấy phép MIT, các mức
reasoning_effortvà câu về việc tiệm cận Claude Opus 4.8 - Ox Alpha ẩn danh xử lý 26 nghìn tỷ token trên OpenCode, phá kỷ lục ra mắt của OpenRouter — RuntimeWire, 26/8/2026 — 26 nghìn tỷ token, 327.000 người dùng, 8.328.244 phiên, con số 93% từ bộ nhớ đệm và kỷ lục 11,6 nghìn tỷ token của OpenRouter
- Mức sử dụng, thông số và manh mối danh tính của Ox Alpha — LLM Rumors, 25/8/2026 — số yêu cầu hằng ngày và vị trí số một trong 558 mô hình
- Mô hình ẩn tầm frontier Ox Alpha xuất hiện miễn phí trên OpenRouter và OpenCode — WinBuzzer, 24/8/2026 — tuyên bố năng lực 100 nghìn tỷ token mỗi ngày và ước tính GPU của Teortaxes
- Z.AI của Trung Quốc tạo ra mô hình ẩn Ox Alpha cạnh tranh với DeepSeek — Bloomberg qua Yahoo Finance, 26/8/2026 — xác nhận danh tính từ nguồn gốc
- Mô hình ẩn đánh bại DeepSeek thuộc về Zhipu — The Next Web — tường thuật màn tiết lộ và cam kết trọng số mở
- Các mô hình ẩn của OpenRouter: rốt cuộc chúng là ai — Digital Applied, 22/8/2026 — bản kiểm kê mười bốn mục, ngày tiết lộ, mức độ bằng chứng và so sánh điều khoản dữ liệu
- Artificial Analysis: phân tích trí tuệ, hiệu năng và giá của GLM-5.3-Flash — Intelligence Index 57, chi phí đánh giá 138,02 đô la, 45 token mỗi giây, 150 triệu token được tạo; truy xuất ngày 31/8/2026
- Epoch AI, "LLM inference prices have fallen rapidly but unequally across tasks", 12/3/2025 — thang giá ngưỡng cố định đứng sau con số 208 lần
- Bài so sánh trước và sau của chúng tôi về cuộc trở lại của mô hình chạy cục bộ — các con số của Qwen3.8-27B, đường cong giá và độ trễ đuổi kịp