Может ли OpenRE-Bench проверить, превратил ли ИИ задачу на GitHub в пригодное требование?
Набор из десяти сценариев сравнивает, как агентные системы превращают запросы функций в требования. На примере разберём, что оценивать до начала разработки.
В задаче на GitHub написано: «Сохраняйте мои фильтры, когда я возвращаюсь». Агент для программирования может сразу взяться за реализацию. При этом он может выбрать неверное толкование. «Возвращаюсь» означает снова открыть список после просмотра элемента, обновить страницу, войти завтра или перейти в другое рабочее пространство? Каждый ответ ведёт к другой функции и другому набору приёмочных тестов.
OpenRE-Bench изучает, что происходит между постановкой задачи и её реализацией. Препринт, отправленный на arXiv 10 ноября 2026 года, представляет общую испытательную среду для агентных систем, составляющих требования. В первом наборе десять сценариев. Пять получены из открытых запросов функций на GitHub, ещё пять написали исследователи. Авторы приводят три примера адаптеров, чтобы применять одинаковые входные данные и правила оценки к разным системам. Препринт OpenRE-Bench
С помощью бенчмарка можно точнее спросить о результате работы агента. Два человека, прочитавшие предложенные требования, реализуют и проверят одно и то же поведение? Пример с фильтрами показывает, почему история решений так же важна, как итоговый текст, и как команда может проверить собственный процесс подготовки требований из задач.
Сделайте решения видимыми до написания кода
Инженерия требований — работа по уточнению целей, ограничений и наблюдаемого поведения, чтобы люди могли договориться. Задача может хорошо объяснять проблему пользователя и всё же оставлять открытыми несколько вопросов реализации. Два заинтересованных сотрудника могут согласиться, что навигация должна сохранять результаты работы, но разойтись во мнениях о синхронизации настроек между устройствами. Полезный черновик фиксирует это различие, чтобы решение приняли ответственные за него люди.
Вот одно возможное толкование запроса о фильтрах. Когда пользователь, вошедший в систему, открывает элемент и возвращается к списку в том же рабочем пространстве, список восстанавливает предыдущие значения фильтров. Изменения настроек в других рабочих пространствах пока остаются за пределами задачи. Приёмочная проверка задаёт исходное состояние, действие и наблюдаемый результат. Её можно выполнить на прототипе или в готовой функции.
При другом толковании фильтры сохраняются после выхода из системы и на другом устройстве. В этом варианте надо решить, где хранить настройки аккаунта и что делать, если на двух устройствах сохранены разные фильтры. В однострочной задаче эти правила не указаны. Агент, который добавит их ради удобства, может превратить небольшое исправление навигации в изменение продукта с другой стоимостью и последствиями для конфиденциальности.
| Часть запроса | Черновик для обсуждения | Что ещё надо решить |
|---|---|---|
| Вернуться от элемента к списку | Восстановить видимые фильтры в том же рабочем пространстве | Нужно ли возвращать и позицию в списке |
| Обновить страницу или войти снова | Записать вопрос как открытый | Сколько хранить настройки и где |
| Переключить рабочее пространство | Не показывать фильтры одного пространства в другом | Нужна ли каждому пространству собственная история |
| Поделиться отфильтрованным списком по ссылке | Рассмотреть общий доступ как отдельный сценарий | Какие значения могут появляться в общей ссылке |
Пример проверки сгенерированных требований до реализации. Иллюстрация Telli.sh.
Первую строку можно проверить без технического описания слоя хранения. Тот, кто проверяет черновик, увидит и строки, в которых ещё нужны решения. Полезное требование конкретно описывает обещанное поведение и оставляет видимыми вопросы, за которые отвечает команда.
Бенчмарк сохраняет единый формат входов и доказательств
В препринте OpenRE-Bench описан общий CaseInput, который содержит название сценария, описание и текст требования. Адаптер переводит этот контракт в формат каждой участвующей системы. Его задача — сохранить сведения, необходимые для сравнения, и дать системе свободу организовать взаимодействие агентов. В набор входят MARE, iReDev и QUARE. Авторы называют MARE и iReDev повторными реализациями по исходным статьям. Статья OpenRE-Bench, раздел II
Испытательная среда собирает результаты четырёх фаз. Она записывает начальные модели, историю согласования, объединённую модель и результат верификации. Каждая фаза отвечает на свой вопрос. Что агенты видели сначала? В чём они разошлись? Какие решения вошли в итоговую модель? На чём можно проверить результат? Общая структура помогает проследить решение, даже когда разные системы по-разному называют свои внутренние роли.
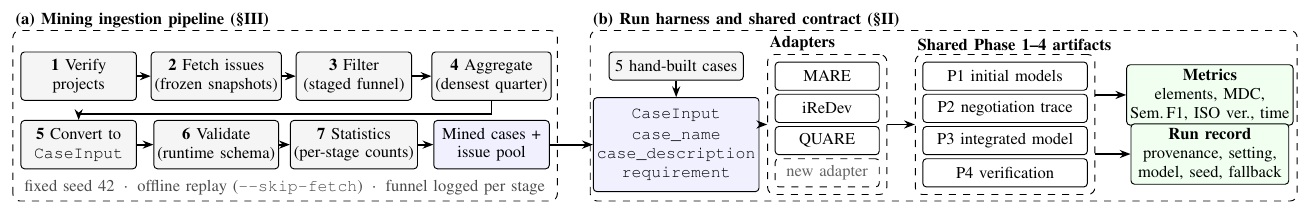
Рисунок 1 из Cheng et al., OpenRE-Bench, 10 ноября 2026 года. Изображение кадрировано из PDF авторов и уменьшено для публикации. Исходный рисунок · CC BY 4.0.
В примере с фильтрами результат первой фазы мог бы предложить и «сохранять текущий список при возврате», и «запоминать настройки на всех устройствах». Вторая фаза могла бы записать их как два возможных объёма задачи. Объединённый артефакт мог бы сохранить первый и оставить второй открытым. Последняя фаза проверила бы выбранное поведение. Просмотр всех четырёх фаз помогает отличить осознанное ограничение задачи от случайного пропуска.
Для тех, кто сравнивает агентные системы, адаптеры также помогают обозначить границы сравнения. Система со сложной внутренней моделью может потерять часть деталей при экспорте в общую схему. Храните исходные артефакты, если они помогают объяснить результат. Стандартизированные выходы дают общую основу для сравнения, а исходные артефакты помогают понять, почему системы сработали по-разному.
Десять сценариев позволяют оценить процесс
Cheng и соавторы сообщают, что сначала собрали 3 000 задач из пяти проектов на Python, TypeScript и Java. После фильтрации остались 1 396 задач. Из них 18 вошли в пять сценариев, основанных на репозиториях. Вместе с пятью сценариями, составленными вручную, они образовали набор версии 1.0. Объём исходного корпуса и число проверяемых сценариев различаются. В комплектном наборе за один прогон оцениваются десять сценариев, хотя сбор начинается с тысяч записей. Статья OpenRE-Bench, таблица I
Одна из частей работы — сам процесс подготовки. История сбора и фильтрации показывает, как задача реального проекта превратилась в проверочный сценарий. Это помогает сопоставить новый прогон с опубликованным результатом. Она также позволяет увидеть, какие запросы склонен отбирать корпус и как на выбор влияют метки, комментарии, интервалы объединения и другие фильтры.
От выбора зависят проблемы, представленные в бенчмарке. В открытом репозитории объём функции часто обсуждают там, где любой человек может прочитать обсуждение. Если команда планирует изменить внутренние права доступа, значительную часть требований она может согласовать с клиентом по телефону или на закрытом обсуждении проекта. Модель, которая хорошо справляется с публичными задачами, в такой среде может потребовать предметных проверок. Добавьте случаи с неполным контекстом, требованиями в нескольких документах или противоречивыми комментариями, если они часто встречаются в вашем списке задач.
Пять сценариев, написанных вручную, дают другой исходный материал. Подготовленный случай помогает выделить конкретную неоднозначность. Случай из репозитория сохраняет то, как поступил настоящий запрос. Сообщайте результаты для каждой группы отдельно. Если система лучше справляется с чётко подготовленным сценарием, но теряет решения в реальном обсуждении, до использования в сортировке задач ей могут понадобиться другие инструкции или дополнительные источники.
Общий прогон даёт стабильную основу для сравнения и место для проверок, важных вашей команде. Иллюстрация Telli.sh.
Оценку проверяемости стоит сопоставить с источником
В статье описана воспроизводимая структурная оценка проверяемости от 1 до 5 на основе признаков соответствия ISO/IEC/IEEE 29148. Авторы также сообщают число элементов, степень смыслового сходства начального и объединённого выходов одного прогона и затраченное время. Вместе показатели помогают понять, стабильно ли система создаёт структурированные артефакты и сохраняет ли идеи в ходе работы. Если все фазы унаследовали одно предположение о бизнесе, показатели не определяют, было ли оно верным. Статья OpenRE-Bench, метрики
Допустим, первая модель истолковала «вернуться» как «войти на следующей неделе». Если объединённый выход повторяет это толкование, метрика смыслового сходства может отразить согласованность фаз. Человек, прочитавший задачу, всё равно может отметить, что текст не даёт оснований для такого вывода. Метрика и чтение источника отвечают на разные вопросы. Оба способа полезны, когда понятны их границы.
Составьте небольшой эталонный набор для проверки опоры на источник. Для каждой задачи выделите фразы, прямо подтверждающие требование, и варианты, которые исходный текст оставляет открытыми. Попросите проверяющего отмечать потерянные ограничения, правдоподобные предположения, выданные за факты, и противоречия между предложенным тестом и задачей. Пять точных вопросов могут рассказать о вашем внедрении больше, чем среднее по множеству разных случаев.
Рассмотрим вымышленную функцию экспорта. В задаче просят сохранить читаемость отчёта в электронной таблице после изменения регионального формата дат. Один черновик определяет участника, ресурс данных, последовательность и запись верификации. Инструкция гласит: «Убедитесь, что дата экспортируется правильно». Другой черновик говорит: «Выберите региональный формат с днём на первом месте, экспортируйте строку от 4 марта 2026 года и проверьте, что после открытия в регионе с месяцем на первом месте таблица по-прежнему хранит 4 марта 2026 года». Второе предложение легко превратить в тест. В первом черновике больше формальных элементов, но его инструкция допускает разные представления о правильном результате.
Можно проверить и сам процесс рецензирования. Попросите двух человек подготовить минимальный набор данных для одного предложенного теста. Если один выберет неоднозначную дату, а другой возьмёт 28-е число, данные могут выявить разные классы проблем. Хорошая приёмочная проверка называет данные, обнаруживающие ошибку. Агент может помочь составить такую проверку, если ему известна причина появления задачи.
Стоимость и время тоже заслуживают внимания. Некоторые системы делают больше вызовов, когда согласуют разные позиции. Более медленный процесс может оправдать затраты, если выявляет конфликты, которые команда регулярно пропускает. Если система принимает те же решения, что и простой базовый метод, но создаёт многословные промежуточные артефакты, учтите это при сравнении стоимости. Запустите базовый метод и выбранную систему на одном сценарии, прежде чем оценивать пользу дополнительных шагов.
Проведите небольшое сравнение на понятных требованиях
- Начните с зафиксированной версии артефакта из статьи и короткого локального прогона. Авторы описывают режим
single_agent, который работает без ключа и позволяет проверить выполнение и расположение артефактов до платного сравнения с моделями. Инструкция к артефакту OpenRE-Bench - Выберите несколько публичных задач или задач, на использование которых у вас есть разрешение. Возьмите простой запрос, обсуждение с противоречивыми комментариями и случай с открытым решением о правилах. Запишите ожидаемое поведение и открытые вопросы до просмотра ответа агента.
- Запустите каждого кандидата на одинаковом входе и запишите версию системы, настройки модели и режим запуска. Сохраните промежуточные артефакты. Используйте одинаковые критерии для пропущенных требований и неподтверждённых допущений.
- Сравнивайте результаты на уровне решений. Спросите, что можно проверить наблюдением за продуктом и какой текст задачи обосновывает решение. Запишите, должен ли человек уточнить объём до начала разработки.
- По результатам определите, где агент поможет. Для одних запросов можно сразу набросать приёмочный тест. Для других полезнее список вопросов автору. Оставьте оба вида результата видимыми в процессе.
Следующим шагом можно взять требование на настоящее обсуждение. Сравните черновик агента с поведением, которое команда в итоге согласилась выпустить. Если рецензенты каждый раз переписывают один тип утверждений, добавьте проверку этого типа. Требование с точным ожидаемым результатом и прослеживаемым источником полезно и тогда, когда остальная часть документа ещё правится.
OpenRE-Bench позволяет провести сравнение до первого изменения кода. Стоит проверить, видит ли следующий участник процесса согласованное поведение, происхождение доказательств и вопросы, которые ещё предстоит кому-то решить.
Источники
- Cheng et al., препринт OpenRE-Bench, 10 ноября 2026 года
- Полная статья с методами, данными и исходным рисунком 1
- Версионный артефакт от авторов
- Creative Commons Attribution 4.0 International
Чтобы находить решения, принятые при обсуждении функций и проверке требований, создайте аккаунт Telli.sh.