NVIDIA Speech Skills: покажите процессу ASR, где он ошибается в терминах
Введение в навыки адаптации речи NVIDIA: как агент программирования помогает исследовать специальную лексику, готовить данные, избирательно обучать модель и оценивать улучшения.
Транскрипция правильно передает структуру предложения, но ошибается в важном имени. Специалист сразу узнает нужное выражение, а речевая модель подставляет обычное слово. Улучшение начинается с вопроса конкретнее, чем «какая модель лучше?».
Руководство NVIDIA по Speech Agent Skills от 13 октября 2026 года описывает адаптацию автоматического распознавания речи, или ASR, к предметной области. Высокоуровневый навык помогает определить проблему и согласовать работу; специалист по NeMo выполняет совместимые обучение и оценку. Разобранный пример — речь авиадиспетчеров. Руководство NVIDIA
В статье объясняется, что добавляют навыки, когда стоит рассматривать обучение и как спланировать первый эксперимент. Начинать с большого обучения необязательно. Полезным первым результатом станет ясное описание ошибочных слов, их значения для задачи и вмешательства, заслуживающего проверки.
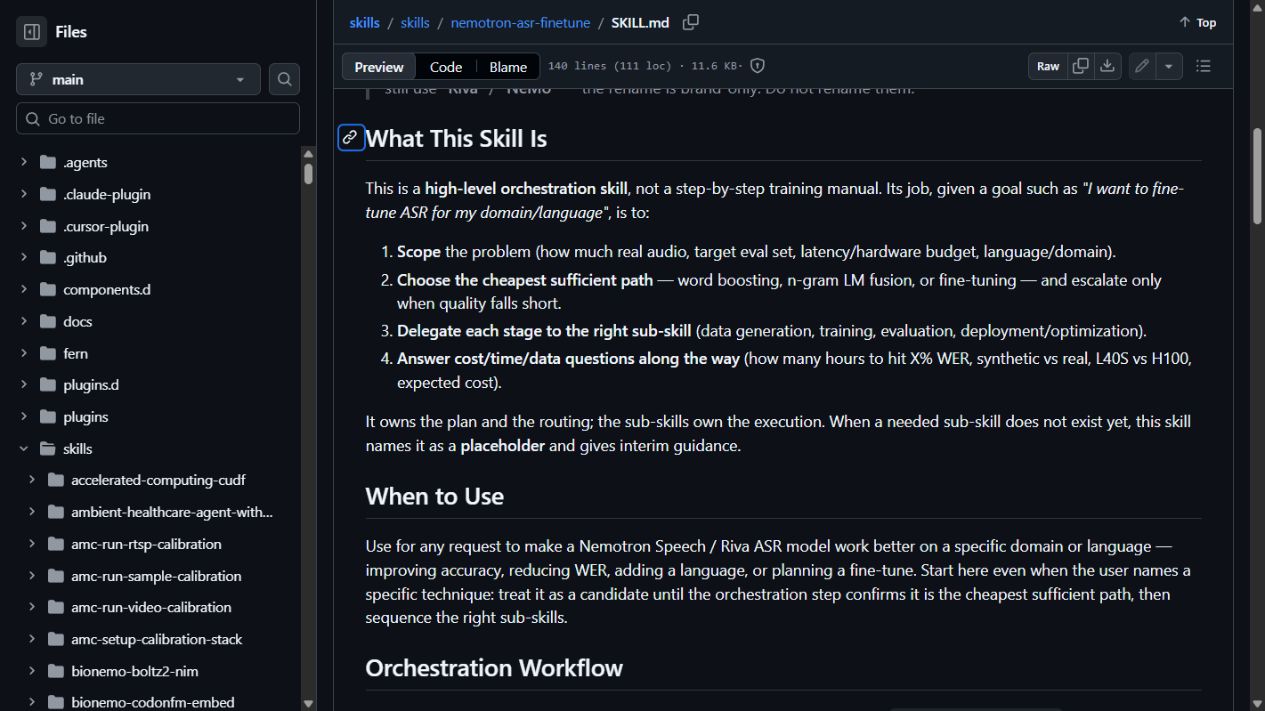 Публичная документация навыка, снимок от 20 октября 2026 года. Документация © NVIDIA, атрибуция по CC BY 4.0. Показаны инструкции навыка, а не запуск обучения.
Навык организует работу вокруг модели
Модель содержит обученные параметры. Обучающий фреймворк дает механизмы их обновления. Навык агента содержит инструкции, помогающие помощнику выбрать и выполнить процесс. Установка инструкций не устанавливает все фреймворки, не скачивает все чекпойнты и не доказывает, что GPU справится с экспериментом.
В руководстве NVIDIA разделяет оркестратор nemotron-asr-finetune и специалиста nemo-speech-asr-finetune. Первый формулирует цель и направляет работу. Второй отвечает за исполнение в NeMo, когда уместны обучение или офлайн-оценка. Описание процесса
Разделение полезно, поскольку «улучшить распознавание» означает разные задачи. Проблеме словаря может помочь поддержка декодирования. Несоответствие манеры речи или условий записи способно оправдать адаптацию. Ошибочную предобработку нужно исправить до того, как оба варианта станут осмысленными.
Представьте навык координатором эксперимента. Он согласует цель, входные данные и сравнение, но критерий успеха все равно определяет человек. Итогом должны быть проверяемые свидетельства, а не простое сообщение помощника об окончании обучения.
Начните с ошибки, меняющей смысл
Допустим, компания учит сотрудников произносить небольшой набор кодов продукции при проверках. Распознаватель хорошо передает обычный разговор, но постоянно путает два похожих кода. Первый полезный набор — такие путаницы вместе с исходным аудио и проверенной эталонной расшифровкой.
Второй случай — архив интервью с именами и специальной терминологией. Сложность меняется в зависимости от говорящего, микрофона и темы. Отделяйте правила написания от акустических ошибок: две письменные формы одной аббревиатуры не следует автоматически считать разными ошибками распознавания.
Третий случай — аудиоподдержка оборудования по шумному каналу. Список терминов поможет отдельным словам, но не восстановит отсутствующие слоги. Адаптация становится полезнее, когда различает языковые ожидания и звук, действительно доступный модели.
Это предложенные применения процесса, а не отчеты о внедрении. Они показывают, почему нужны примеры, а не только формулировка цели. Дюжина понятных ошибок способна показать следующий шаг: очистку данных, словарную поддержку или более серьезное исследование адаптации.
Выбирайте наименее требовательный способ устранить сбой
Открытый навык оркестрации описывает движение от усиления слов через языковую модель к дообучению, предлагая сначала выбрать достаточный способ. Это принцип планирования, а не гарантия одинаковых настроек у всех моделей и runtime. Документация навыка
| Наблюдаемая проблема | Возможное вмешательство | Что сравнивать |
|---|---|---|
| Известный термин проигрывает обычному слову | Поддерживаемый словарь или механизм усиления слов | Точность целевых терминов и нежелательные вставки |
| Типичные фразы области постоянно считаются маловероятными | Совместимая языковая модель или поддержка декодирования | Точность в области вместе с обычной речью |
| Модели трудно с речью или каналом области | Адаптация акустической модели | Отложенное аудио области и набор обычной речи |
| Точность резко упала после изменения настройки | Восстановление и проверка совместимости предобработки | Один чекпойнт и аудио в обеих конфигурациях |
Таблица помогает выбрать направление, но не ставит диагноз. Добавление терминов порождает новые ошибки, если похожие обычные слова встречаются часто. Дообучение улучшает специальную задачу, но может ухудшить другой тип речи. Измеряйте нужный эффект и побочные последствия, которых следует избежать.
Также отделяйте распознавание от последующей очистки текста. Языковая модель перепишет неправдоподобную фразу в убедительную, но это не свидетельствует о восстановлении произнесенных слов. Сохраняйте исходный выход распознавателя, чтобы оценивать акустическую задачу отдельно.
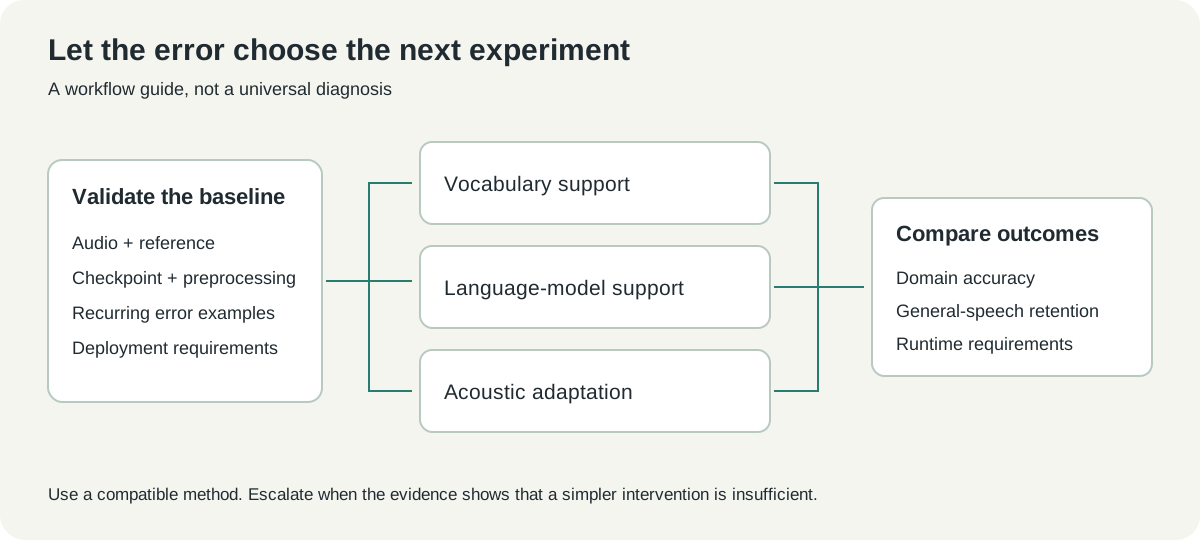 Оригинальная схема решений по документированному процессу. Она знакомит с возможными путями, не утверждая универсальность одного из них.
У опубликованного улучшения есть точный знаменатель
В разобранном исследовании NVIDIA сообщает о падении частоты ошибок по словам Nemotron с 77.00% до 22.46% на двухчасовом тестовом наборе ATCO2 с ручной разметкой, что означает относительное снижение на 70.8%. WER на общем английском изменился с 3.50% до 3.63%. Это результаты разработчика в условиях того исследования. Руководство от 13 октября
WER учитывает замены, удаления и вставки относительно слов эталона. Это не доля предложений хотя бы с одной ошибкой, а относительное снижение не равно изменению в процентных пунктах. Разделение величин делает честное сравнение проще.
Пример полезен тем, что показывает и целевую, и другую область. Один специальный результат не говорит, сохранилась ли способность распознавать нужную обычную речь. Даже небольшое изменение общего домена стоит читать рядом с улучшением, а не исключать из рассказа.
Другой микрофон, язык или правило транскрипции даст совсем иной результат. Поэтому число должно мотивировать метод: измерить исходный уровень, адаптировать в контролируемых условиях и оценить отложенный набор. Оно не обещает убрать такую же долю ошибок из звонков конкретной компании.
Отделяйте материал для обучения от материала для оценки
В наборе адаптации нужны разные роли. Обучающие примеры меняют модель. Примеры разработки помогают выбирать чекпойнты и декодирование. Тестовые оценивают выбранную систему после принятия решений.
Случайное разбиение коротких отрезков создает обманчивую независимость. Два клипа одной записи могут иметь общего говорящего, канал, фразу и фон. По возможности разделяйте по единице, важной при внедрении: целым записям, говорящим или сессиям сбора.
Явно задайте правила эталона. До оценки решите, как записывать числа, сокращения, пунктуацию и звуки заминки. Если вывод пишет “twenty one”, а эталон — “21”, нормализация меняет оценку, не меняя понятого слушателем.
Для начала подготовьте небольшой реестр вместо гонки за большим корпусом. Запишите происхождение аудио, разрешенное использование, проверившего расшифровку и роль элемента. Понятный реестр легче проверить, чем папку, где единственная история происхождения заключена в именах файлов.
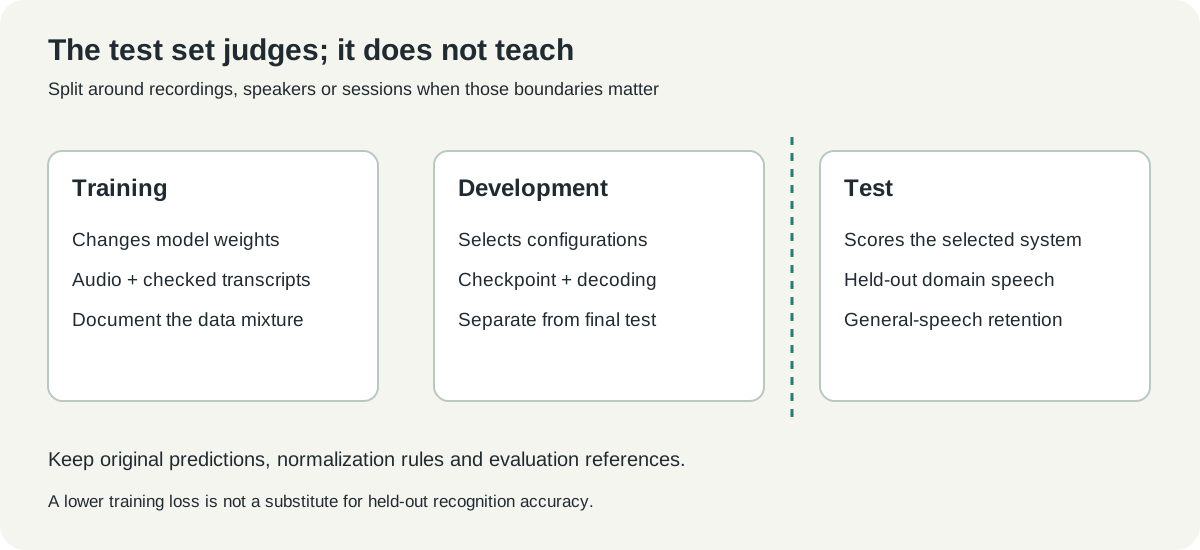 Оригинальная поясняющая схема. Тестовые данные остаются вне обучения и выбора чекпойнта; сохранение обычной речи оценивается вместе с целевой задачей.
Первый запрос должен просить план и исходную оценку
Навык полезнее, когда запрос содержит наблюдаемую цель. «Помогите с транскрипциями проверок» — начало, но распознаватель, язык, режим внедрения и цена ошибки остаются неясными. Добавьте детали и попросите ограниченный первый этап.
Например, предлагаемый запрос может выглядеть так:
Изучите небольшой лицензированный набор записей проверок и эталонных расшифровок. Найдите повторяющиеся путаницы терминов, проверьте текущий распознаватель и предобработку, измерьте исходный уровень. Сравните словарную поддержку с предложением обучения. Сохраните отложенный тест и до длительного запуска сообщите точность в предметной области, сохранение обычной речи и требования к ресурсам.
Пример определяет свидетельства, которые должен вернуть агент. При этом метод остается открытым до выбора на основании данных. Обычно это продуктивнее команды дообучить конкретный чекпойнт произвольное число шагов.
Полезный первый отчет называет точный чекпойнт, конфигурацию исполнения, набор оценки и повторяющиеся ошибки. Он объясняет, какой участок ограничивает продвижение. Неверная настройка частоты дискретизации требует иного исправления, чем действительно незнакомая речь.
Осознанно устанавливайте и инструкции, и зависимости исполнения
Руководство NVIDIA дает отдельные команды установки оркестратора и специалиста. Второй не устанавливается автоматически лишь потому, что первый на него ссылается. Команды ниже повторяют выбор навыков из руководства; изучите репозитории и выберите нужный охват установки при запросе.
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
После установки начните новую сессию агента и убедитесь, что ожидаемые навыки доступны. Это подтверждает обнаружение инструкций агентом. Пока это ничего не говорит о загрузке чекпойнта или возможности обучения на машине.
В документированной конфигурации используются Linux-хост с GPU и закрепленный контейнер NeMo Speech 26.07.00. Перед подготовкой машины проверьте требования актуального образа к драйверу, GPU и фреймворку. Навык на ноутбуке не заменяет среду исполнения. Подготовка окружения
Сузьте первую проверку окружения. До выделения бюджета обучения проверьте импорты, видимость GPU, загрузку чекпойнта и короткий инференс. Запишите версии и идентификатор контейнера, чтобы связать последующий результат с создавшим его ПО.
Потоковое и офлайн-распознавание требуют отдельных сравнений
Потоковый распознаватель выдает текст по мере поступления звука. Офлайн-распознаватель может работать иначе, когда запись уже доступна. Оба распознают речь, но задержка, контекст и декодирование различаются настолько, что одной оценки недостаточно.
Для живого приложения фиксируйте появление частичных результатов, момент стабилизации и выдачу финального текста. Более точная, но запоздалая расшифровка может не подойти для прямых субтитров. В архиве допустим более медленный офлайн-процесс с лучшим итоговым текстом.
Сохраняйте одинаковый режим до и после адаптации в главном сравнении. Если одновременно менять разбиение, декодирование, чекпойнт и нормализацию, улучшенная оценка не покажет важное изменение. Для полного альтернативного процесса заведите отдельный эксперимент.
Такая дисциплина помогает и последующей оценке. Метки говорящих, временные метки и распознанные слова — разные выходы. Хороший WER может сопровождаться приписыванием важной фразы не тому человеку, поэтому проверяйте нужные приложению способности отдельно.
Оцененный чекпойнт — больше, чем успешный журнал обучения
Убывающая функция потерь показывает подгонку оптимизации к цели. Она не доказывает лучшего распознавания нового говорящего. Полезный артефакт — выбранный чекпойнт с конфигурацией, предсказаниями и результатами оценки.
Сохраните исходную модель и оцените ее тем же протоколом. Включите характерные ошибки, чтобы специалист понял оставшийся разрыв. Таблица средних должна вести к примерам, а не прятать их.
Развертывание добавляет вопросы. Загрузит ли целевая машина артефакт? Поддерживает ли runtime обслуживания его архитектуру и токенизатор? Сохранит ли вывод соглашения, ожидаемые следующим ПО? Среды обучения и приложения могут расходиться, даже если обе поддерживают «распознавание речи».
Руководство NVIDIA отделяет выпущенные инструменты от доработанных с Gold чекпойнтов, описанных как предстоящие. Различайте доступность кода, демонстрационные результаты и скачиваемые адаптированные веса. Публичного руководства достаточно для планирования, но не все показанные артефакты уже упакованы для внедрения.
Лучшая адаптация начинается с меньшего и ясного вопроса
На наш взгляд, Speech Skills особенно полезен как способ сделать специальный ASR проверяемым. Он превращает открытый запрос на точность в последовательность решений об ошибках, данных, совместимых методах и оценке. Это помогает не превратить эксперимент в долгое обучение без согласованной финишной черты.
Начните с важных слов и записей, доказывающих проблему. Сначала спросите, работает ли более простое вмешательство, затем усложняйте на основании свидетельств. Чекпойнт ценен, когда улучшает транскрипцию в условиях, с которыми действительно сталкиваются читатели или слушатели.
Источники и изображения
Проверено 20 октября 2026 года. Численные результаты относятся к исследованию NVIDIA; обучение, инференс и демонстрации для статьи не воспроизводились. Скриншот открытой документации NVIDIA сделан автором с атрибуцией CC BY 4.0. Схемы оригинальные. См. реестр изображений.
- Руководство NVIDIA от 13 октября 2026 года
- Навык оркестрации
- Специализированный навык NeMo
- Фреймворк NeMo Speech
- Лицензии документации и кода NVIDIA
Держите аудиосвидетельства рядом с проверкой
Храните ссылки на источники, решения по терминологии и заметки оценки вместе, чтобы следующий эксперимент начинался с понятной записи. Telli.sh поможет организовать такое исследование. Создать аккаунт Telli.sh