Модель на 24GB — это ещё не компьютер на 24GB: бюджет памяти Nemotron Bolt
Разберитесь в 74B общих и 9B активных параметрах Nemotron Bolt, нативных 2-битных весах и требованиях к памяти для контекста, зрения, черновой модели и среды выполнения в локальных конфигурациях.
У вас видеокарта с 24GB памяти. У новой модели в названии есть «24GB». Неужели этих двух чисел достаточно, чтобы решить вопрос о покупке?
Для полноценной локальной нагрузки ИИ — нет. В анонсе от 15 октября NVIDIA представила Nemotron 3.5 Bolt 74B-A9B 24GB — развёртываемую локально модель «зрение-язык» с нативным 2-битным квантованием. Название обозначает цель оптимизации, а не обещает, что любая длина контекста, запрос с изображением и конфигурация агента поместятся на видеокарте с 24GB памяти. Анонс NVIDIA, 15 октября 2026 года.
Полезно спросить, что остаётся после загрузки модели. Это руководство отделяет хранимые параметры от активных вычислений, объясняет прочие потребители памяти и описывает настройку только на loopback-интерфейсе по фактической инструкции карточки модели. Сначала определите нужную нагрузку, затем решайте, сможет ли компьютер её выдержать.
Главное изображение: оригинальная редакционная схема бюджета всей нагрузки, а не официальный снимок экрана или измеренная раскладка памяти. Размеры компонентов не показаны.
Меньшее число активных параметров не означает загрузку модели на 9B
В Bolt всего 74 миллиарда параметров, из которых на каждом токене активны примерно 9 миллиардов. Маршрутизатор смеси экспертов выбирает часть хранимой сети. Это сжатый потомок Super VL 120B-A12B, а не плотная модель на 9B. Обзор исследований NVIDIA Bolt, 15 октября 2026 года.
Запомните различие: активные параметры помогают понять вычисления для токена, а общее число параметров — объём данных, который нужно хранить. Ни одно из этих чисел само по себе не определяет скорость приложения. На результат влияют размещение данных, пропускная способность памяти, ядра, длина входа и окружающее приложение.
Агенту, проверяющему код, всё равно нужны эксперты, не выбранные для предыдущего токена. Перемещение данных между хранилищем, системной памятью и памятью GPU не равно наличию всех данных на ускорителе. Поэтому меньшее число активных параметров не позволяет рассчитывать требования к оборудованию так, будто остальные параметры вообще не существуют.
Названия моделей семейства тоже стоит сравнить точно:
| Модель | Что означает название | Статус на 16 октября |
|---|---|---|
| Nemotron 3.5 Super VL | Отдельная модель 120B | Выпущена |
| Nemotron 3.5 Bolt 74B-A9B 24GB | Обсуждаемый здесь сжатый вариант локальной модели | Выпущена |
| Nemotron 3.5 Bolt E4B 4GB | Отдельная меньшая модель для периферии и диалогов | Анонсирована на 23 октября |
Статусы выпуска взяты из анонса от 15 октября. На дату этой статьи E4B ещё только должна появиться; команды ниже её не демонстрируют и она не является доступной заменой. Результаты корпоративного развёртывания Super VL также нельзя считать результатами Bolt на настольном компьютере.
Нативные 2-битные веса решают лишь часть задачи с бюджетом
«Нативные 2 бита» имеют значение, потому что агрессивное сжатие заложено в разработку этой модели, а не просто выбрано пользователем при последующем экспорте меньшей версии. NVIDIA использует дистилляцию с учётом квантования, чтобы восстановить возможности после снижения точности. Для весов экспертов используется IQ2_XXS с точностью 2.0625 бита на элемент, а другие компоненты сохраняют иные форматы. Сеть имеет смешанную точность, а не равномерные два бита во всех частях. Объяснение квантования и сжатия NVIDIA, 15 октября 2026 года.
Для намеренно нереалистичной арифметической проверки представим, что 74 миллиарда значений занимают ровно по два бита: получилось бы 18.5 миллиарда байт. Это иллюстрация, а не размер файла Bolt и не требование к запуску: расчёт не учитывает фактическую смесь точностей, метаданные и состояние выполнения. Умножение громкого числа параметров на громкую разрядность не заменяет изучение конкретного чекпойнта.
GGUF отвечает на другой вопрос. Это формат файлов модели, используемый экосистемой llama.cpp; он содержит тензоры и связанные сведения. Это не дополнительное обещание сжатия поверх «2 бит», и одна загрузка GGUF не доказывает, что конкретная среда выполнения понимает модель. Документация по инструментам GGUF в llama.cpp, проверена 16 октября 2026 года.
Оценка памяти самой NVIDIA помогает сделать различие конкретным: в таблице 2 указано 22.01GB для весов, 23.83GB суммарно без зрения и ещё 1.68GB для энкодера зрения и проектора. Это оценки поставщика для конфигурации в отчёте, а не измерения памяти в этой статье. В том же отчёте описана цель менее 24GB при размере пакета один и контексте 128K. Технический отчёт Bolt, таблица 2 и раздел 2.3, опубликован 15 октября 2026 года.
Вывод не в том, что название тайком обозначает только веса. У целевой конфигурации развёртывания есть предположения. Измените их — изменится и требуемая память.
Планируйте весь рабочий набор, а не только веса
Представьте развёртывание как налог на контекст, начисляемый поверх хранимой модели: для удержания и обработки нужной системе информации тоже требуется место. При планировании разделяйте веса, состояние последовательности, обработку изображений, спекулятивное декодирование и рабочую память среды выполнения. Оставьте запас для рабочего стола и приложений, которые собираетесь держать открытыми.
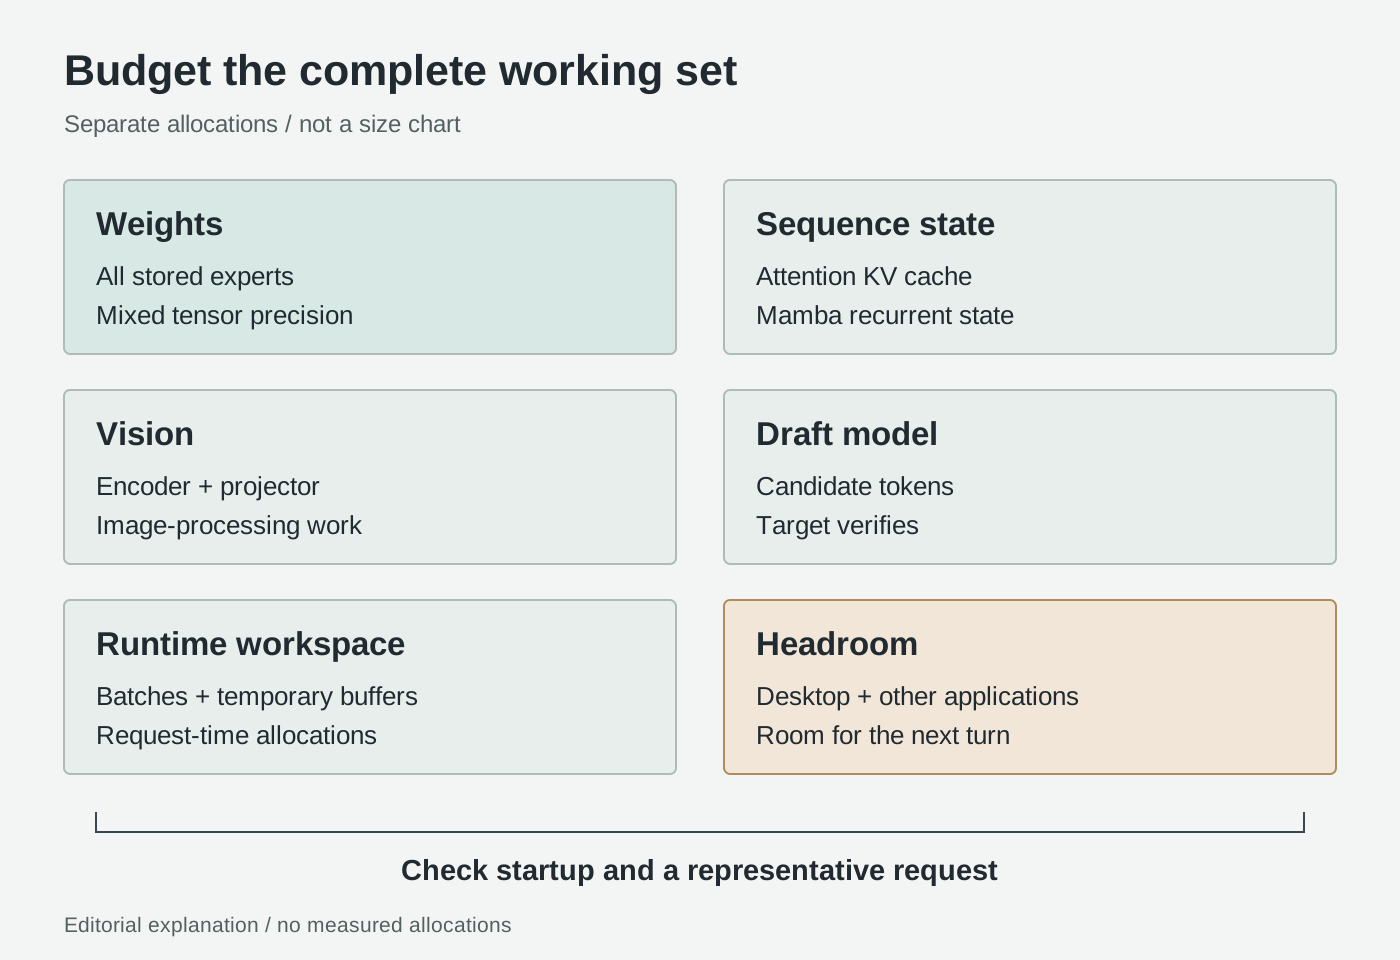
Оригинальная редакционная схема, не показывающая измеренные пропорции. Механизмы описаны в документации кэширования Hugging Face, руководстве по мультимодальности llama.cpp и отчёте NVIDIA Bolt; проверено 16 октября 2026 года.
Состояние последовательности — не ещё одна копия весов. Авторегрессионная модель внимания кэширует ключи и значения прежних токенов, чтобы повторно использовать их при генерации. Для более длинных сохраняемых последовательностей нужно больше места под кэш внимания; детали зависят от архитектуры и представления кэша. Hugging Face, «Как работает кэширование», проверено 16 октября 2026 года.
Bolt — гибридная модель со слоями Mamba и внимания, поэтому стандартная оценка кэша для модели, целиком основанной на Transformer, не может полностью рассчитать её требования. Рекуррентное состояние и кэши внимания занимают разные области; проверьте, что именно создаёт среда выполнения. Архитектурное различие описано в таблице 1 отчёта Bolt, проверено 16 октября 2026 года.
Для агента сохраняемый контекст — это не только введённый вами вопрос. Системные инструкции, схемы инструментов, история беседы, извлечённые фрагменты и ответы инструментов конкурируют за место, нужное для ответа. Транскрипт с повторяющимися списками файлов репозитория может исчерпать полезный бюджет и не добавить доказательств. Краткое состояние задачи — решение рабочего процесса, а не просто обходное решение для оборудования.
Зрение добавляет отдельный путь обработки. llama.cpp связывает языковую модель с файлом мультимодального проектора через --mmproj; в документации сказано, что этот компонент по умолчанию выгружается на GPU. Руководство по мультимодальности llama.cpp, проверено 16 октября 2026 года. Поэтому загрузка только файла языковой модели не равна полной конфигурации с поддержкой изображений.
В задаче с документом отличайте чтение извлечённого текста от интерпретации отрисованной страницы. В обычном текстовом абзаце нет визуальной связи между заголовком столбца и ячейками под ним. И наоборот, отправка изображений страниц, где макет не важен, увеличивает нагрузку, не обязательно улучшая ответ. Выберите представление, сохраняющее доказательства, нужные для вопроса.
Черновая спекулятивная модель — это ещё одна модель. Черновая модель LiLiCorr для Bolt предлагает кандидаты токенов, которые проверяет целевая модель. Она предназначена для ускорения декодирования, но дополнительный чекпойнт и его состояние выполнения тоже требуют памяти. Объяснение LiLiCorr от NVIDIA, 15 октября 2026 года. Наличие черновой модели не гарантирует более быстрого выполнения ваших задач.
Рабочая область среды выполнения — ещё одна отдельная составляющая. Пакеты обработки запросов и временные буферы вычислений нужно учитывать вместе с постоянным состоянием. Сервер предоставляет логический размер пакета и физический размер микропакета; их нельзя приравнивать к числу одновременных бесед. Справочник параметров сервера llama.cpp, проверен 16 октября 2026 года. Даже успешно запустившуюся конфигурацию нужно проверить на репрезентативном запросе.
Официальная таблица оборудования полезнее суффикса в названии продукта
Опубликованные NVIDIA конфигурации:
| Вариант | Оборудование | Контекст | Последовательности |
|---|---|---|---|
| 28GB | RTX Spark 64GB или отдельная RTX 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB или отдельная RTX 48GB+ | 262,144 | 1 |
Источник: краткое руководство NVIDIA, проверено 16 октября 2026 года.
Эти строки не охватывают отдельную видеокарту с 24GB памяти и не подтверждают поддержку Mac. Оперативная память хоста не добавляет видеопамять отдельной видеокарте.
Наш вывод: выбирайте воспроизводимую конфигурацию, а не удачный снимок экрана загрузки. Если покупка зависит от этой модели, потребуйте демонстрацию на ваших входных данных и обычных фоновых приложениях. Особенно важно это для изображений документов и долго работающих агентов, у которых первый запрос может быть намного меньше последующих.
Подбирайте контекст под задачу, а не под максимум
Рассмотрим три стартовые задачи для иллюстрации, а не как результаты испытаний.
Разработчик просит объяснить сбойный тест и предоставляет ошибку, нужную функцию и одну соседнюю зависимость. Полезный результат — диагноз со ссылками на конкретные строки и затем предлагаемое изменение. Прежде чем добавлять весь репозиторий, проверьте, не хватает ли одной конкретной интерфейсной декларации или ещё одного кадра стека вызовов. Так вопрос легче проверить, а неверные предположения проще заметить.
Исследователь сопоставляет таблицу на двух страницах документа. Здесь проверяется, правильно ли модель связывает заголовки, единицы, сноски и значения. Если эти связи важны, используйте изображения самих страниц, просите подтверждение с указанием страницы и сверяйте выборку ячеек с оригиналом. Беглое резюме, в котором переставлены два столбца, — неудачный результат, даже если оно появилось быстро.
Локальный помощник ищет в одобренной папке и готовит черновик отчёта. Из-за извлечённых материалов и повторных ответов инструментов потребность в памяти может расти. Сначала дайте ему задачу только на чтение, ограничьте поиск и потребуйте назвать файлы, подтверждающие каждый вывод. Не выдавайте право на запись или оболочку только для проверки того, способен ли модель составить полезный план.
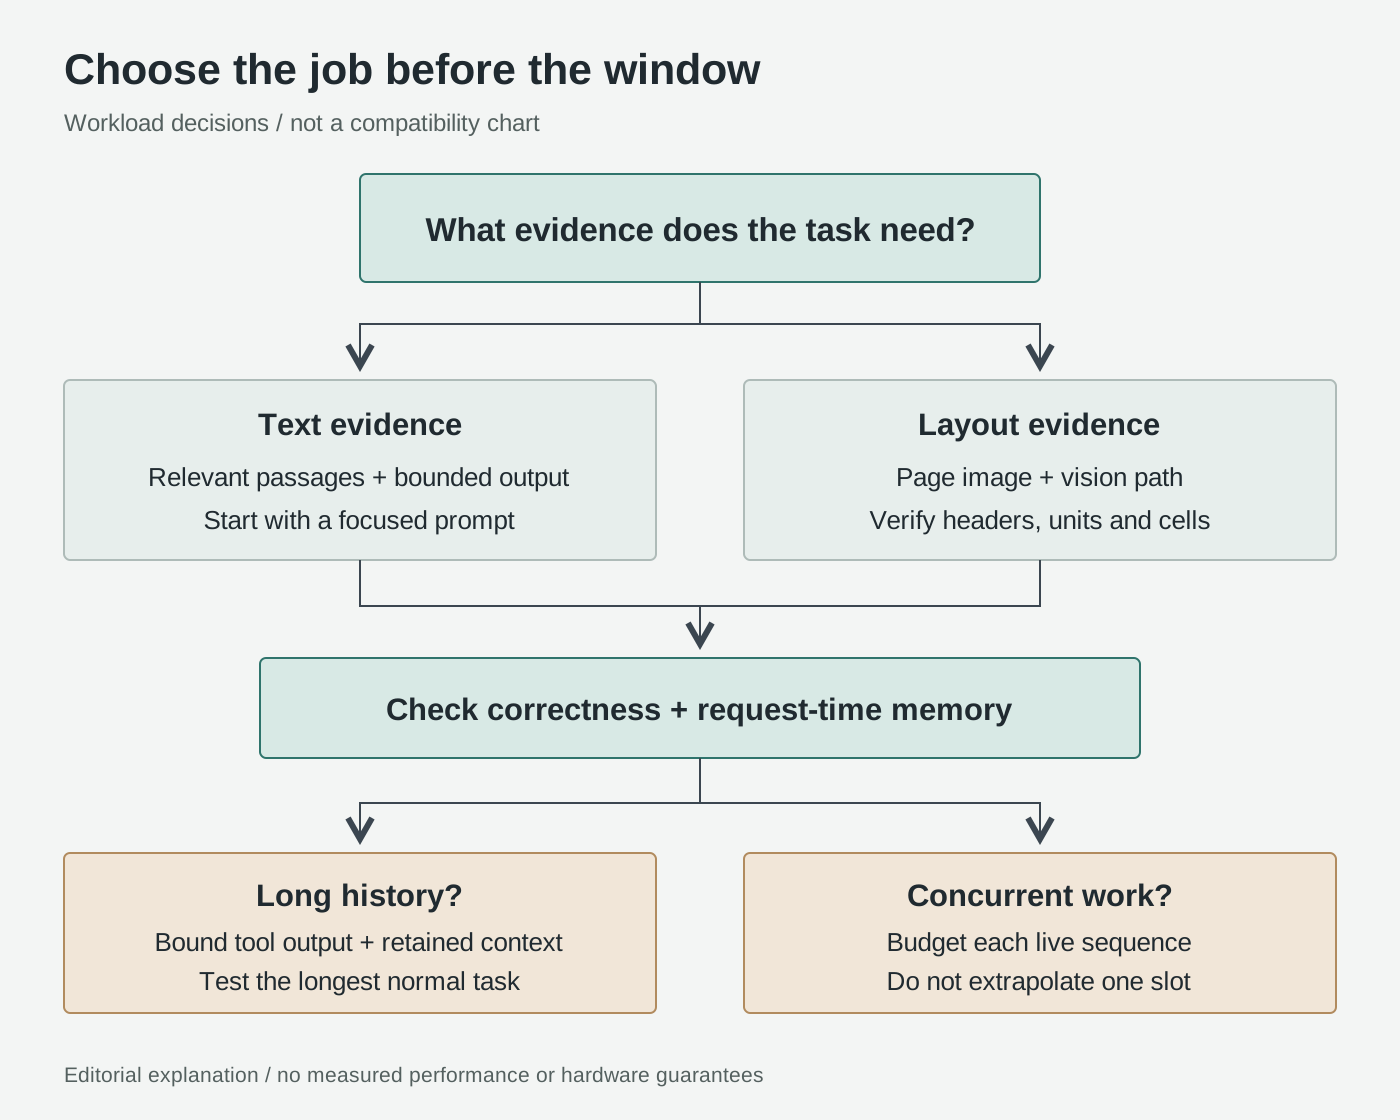
Оригинальная редакционная схема выбора нагрузки, не бенчмарк и не таблица совместимости. См. стратегии кэширования Hugging Face и мультимодальную обработку llama.cpp, проверено 16 октября 2026 года.
Квантованные кэши могут занимать меньше места по сравнению с кэшами высокой точности, а выгрузка переносит нагрузку на другой уровень памяти, иногда обменивая пропускную способность на ёмкость. Это общие компромиссы, а не доказательство, что каждая стратегия кэширования Transformers доступна для этого развёртывания GGUF. Стратегии кэширования Hugging Face, проверены 16 октября 2026 года.
Практический приоритет — плотность доказательств: сохраняйте материалы, нужные для ответа, храните оригиналы отдельно и удаляйте повторяющиеся вспомогательные данные. Оставляйте место и для ответа. Большое настроенное окно не делает историю, не относящуюся к делу, полезной.
Начните локально, затем проверьте нужную вам нагрузку
Следующий пример для Linux Bash предназначен для поддерживаемой конфигурации с отдельной видеокартой NVIDIA. Предполагается, что Git, Python, CMake, набор инструментов C++, совместимый драйвер NVIDIA и CUDA toolkit уже установлены. Это инструкция для запуска на вашем компьютере, а не отчёт о завершённой установке.
- Соберите нужную среду выполнения и проверьте её параметры. Используйте сборку из исходников, а не универсальную однострочную команду со страницы модели. Следуйте руководству по сборке llama.cpp с CUDA, проверено 16 октября 2026 года. Сохраните указанные ревизию коммита и версию двоичного файла вместе с конфигурацией.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Убедитесь, что в справке есть draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn и --jinja. Одной метки версии пакета недостаточно, чтобы подтвердить поддержку. Если двоичный файл не принимает параметры, сначала устраните несоответствие сборки и лишь потом загружайте большие чекпойнты; не подменяйте эту инструкцию старыми флагами спекулятивного декодирования без пояснений. Названия параметров приведены в актуальном справочнике сервера, проверено 16 октября 2026 года.
- Загрузите три файла из краткого руководства NVIDIA, проверено 16 октября 2026 года. Синтаксис загрузки описан в руководстве Hugging Face CLI, проверено 16 октября 2026 года. Сначала проверьте свободное место.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Прежде чем использовать эту конфигурацию как базу сравнения, запишите ревизии репозиториев и локальные хеши файлов. Последующее обновление файла или среды выполнения должно быть осознанным изменением, а не необъяснимым различием между двумя запусками.
- Используйте вариант NVIDIA на 28GB с явной привязкой к loopback.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Если нужно, выберите свободный порт и измените соответствующую проверку ниже. Для первого запуска не создавайте правило перенаправления на маршрутизаторе, публичный туннель или прослушиватель на внешнем интерфейсе. Loopback ограничивает доступ по сети, но не делает безопасными инструменты подключённого агента.
- Проверьте готовность до подключения чего-либо ещё. Выполните в другом терминале:
curl --fail http://127.0.0.1:8080/health
Сервер отдельно документирует состояние загрузки и готовности. После готовности локально откройте http://127.0.0.1:8080 и сначала задайте короткий текстовый вопрос, а затем попробуйте изображение. Документация по проверке состояния и веб-интерфейсу сервера llama.cpp, проверено 16 октября 2026 года. Не подключайте внешние инструменты, пока не заработают базовые ответы.
- Перед расширением измерьте задачу целиком. На системе с отдельной видеокартой проверьте память до запуска и во время репрезентативных запросов:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Это наблюдения за устройством, а не полный пик памяти процесса и не способ учёта объединённой памяти. NVIDIA описывает зависимость отображения памяти от платформы в справочнике NVIDIA System Management Interface. Сохраняйте также журналы выделения памяти среды выполнения и отдельно проверяйте системную память.
Сравните короткий запрос, самый длинный из обычных и репрезентативное изображение документа. Зафиксируйте корректность, время выполнения, наблюдения за памятью и любые ошибки выделения. Повторите проверку с открытыми обычными редактором и браузером. Если конфигурация работает лишь после закрытия остальной рабочей среды, исходное требование не выполнено.
При сбое меняйте по одному фактору и называйте новую конфигурацию. Сокращение контекста, размера микропакета или объёма истории инструментов отвечает на разные вопросы; удаление черновой модели — отдельный эксперимент, а не опубликованная конфигурация. Сохраните ошибку и вызвавший её вход, чтобы поздний успешный короткий запрос не стёр проблему с нужной нагрузкой.
Главное: покупайте под весь рабочий набор
Интересное предложение Bolt — большая модель с редкой активацией, сжатая для локальной работы. Практическая ценность зависит от того, что помещается рядом с ней: доказательств, визуальных входных данных, состояния последовательности и приложений, необходимых для выполнения задачи.
Правильный вопрос приёмки не «Загрузилась ли модель на 24GB?», а «Может ли именно этот компьютер выполнять мои обычные задачи, давать надёжные ответы и оставлять место для следующего шага?» Вот под какой бюджет памяти стоит покупать оборудование.
Источники
Информация о выпуске датирована 15 октября 2026 года; связанные карточки моделей и обновляемая документация проверены 16 октября 2026 года. Инструкции адаптированы из документации и не являются результатами практического тестирования. Оригинальные схемы поясняют устройство и не являются официальными материалами или графиками производительности.
- Анонс выпуска NVIDIA — три названия моделей и сроки выпуска.
- Обзор исследований NVIDIA Bolt и технический отчёт — сжатие, точность и оценка распределения памяти.
- Карточка модели NVIDIA GGUF — фактическая таблица оборудования, имена файлов чекпойнтов и инструкция запуска.
- Документация сборки llama.cpp, сервера, мультимодальности и инструментов GGUF — поведение среды выполнения.
- Объяснение кэширования Hugging Face, стратегии кэширования, руководство CLI и справочник NVIDIA SMI — конкретные механизмы и команды проверки.
Не теряйте источники, на которых основаны решения
Сравнивать агентов проще, когда исходные материалы, ваши заметки и результаты собственных испытаний хранятся вместе. Создать учётную запись Telli.sh, чтобы собирать эти материалы в справочник, к которому можно вернуться по мере изменения продуктов.